

Python数据分析该看什么书?Pandas与NumPy专项教材指南
针对Python数据分析核心库Pandas与NumPy的专项教材选书指南。梳理经典书籍定位、版本差异、底层原理与工程进阶路径,帮助学习者避开选书误区,快速建立扎实的数据分析能力。
学习 Python 数据分析最常遇到的瓶颈,往往不是语法记不住,而是把时间浪费在泛泛罗列基础语法的入门大部头上,等到面对几十万行杂乱业务表格时,依然不知道如何高效索引、分组计算和优化内存。NumPy 是 Python 数值计算的底层阵地,Pandas 则是结构化数据清洗与分析的事实标准。想要真正掌握这两个核心库,关键在于“区分底层存储与上层接口、区分语法套用与工程调优”。本文系统梳理市面上经过实践检验的经典专项教材,拆解各书定位与版本差异,为不同阶段的学习者提供清晰的选书路线。
一、首选奠基之作:《利用Python进行数据分析》
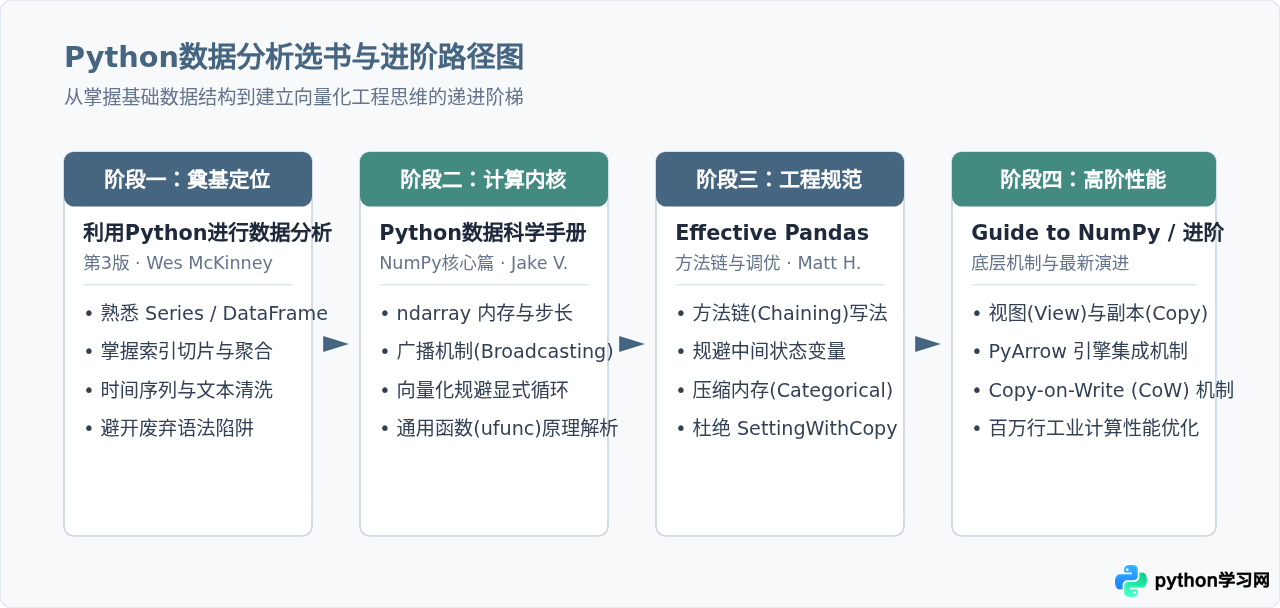
如果只选一本作为日常数据分析操作的手头教材,《利用Python进行数据分析》(Python for Data Analysis)是避不开的权威起点。这本书的作者 Wes McKinney 既是 Pandas 项目的创建者,也是 Apache Arrow 的联合发起人。书中直接展现了设计 Pandas 时的原始思路:解决 Python 原生列表与字典在处理表格数据时的性能低下、索引缺失以及结构不直观等痛点。
1. 版本选购的关键注意事项
目前市面上流通着第 1 版、第 2 版与第 3 版,务必认准第 3 版。Pandas 历经 1.x 到 2.x 的大幅迭代,废弃了大量早期方法,例如过时的 .ix 混合索引、已被取代的矩阵重塑参数。第 3 版基于 Python 3.10 与更新的 Pandas 特性全面重构,并免费提供了在线开源网页版,避免了读者敲入书中旧代码却在终端收获一屏 FutureWarning 或 AttributeError 的挫败感。
2. 阅读方法与精读章节
全书篇幅较大,切忌平均用力:
- 跳过铺垫内容:前两章介绍的 Python 语法(如列表、字典、循环等)如果已经掌握,直接跳过,不要在此消耗精力。
- 重点精读第 5、7、8、10 章:分别对应 Essential Functionality(核心功能)、Data Cleaning and Preparation(数据清洗与预处理)、Data Wrangling(数据规整:连接与合并)、Data Aggregation and Group Operations(数据聚合与分组运算)。
- 时间序列专项:第 11 章的时间序列是金融、传感器与电商数据分析的重头戏,书中对重采样(
resample)和移动窗口(rolling)的推演非常清晰。
二、理解计算内核:NumPy 专项教材该怎么选?
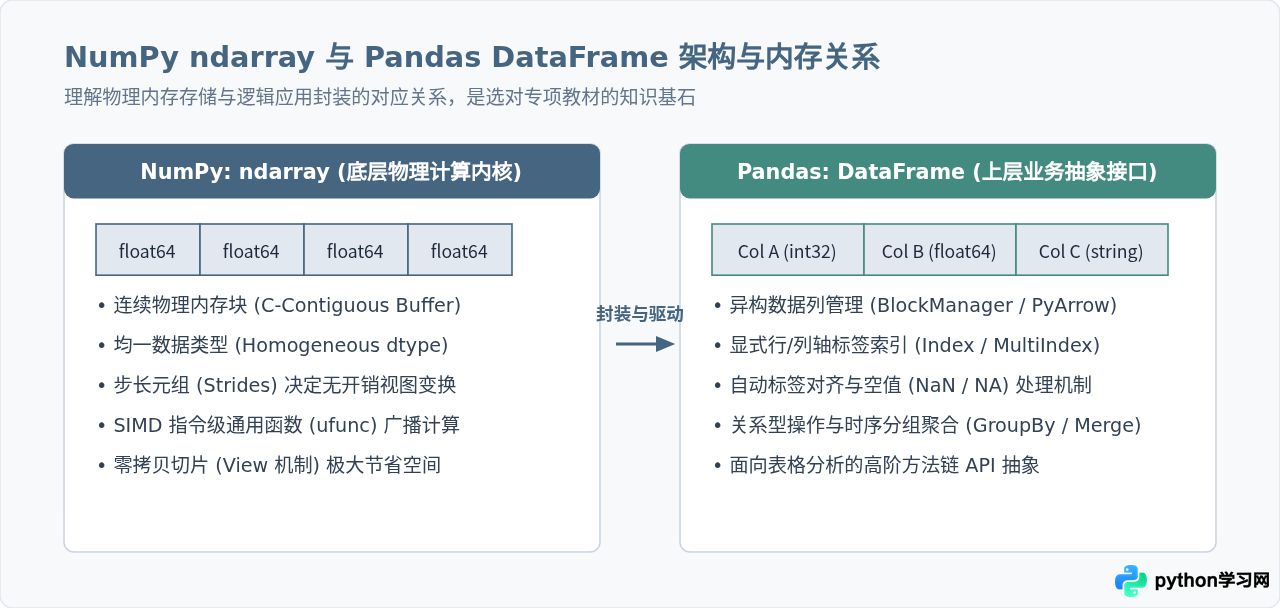
很多分析人员虽然能熟练调用 pd.read_csv(),但遇到高维转换、距离计算或算法实现时就会卡壳,直接写出运行奇慢的 Python 双重 for 循环。根源在于没有搞清楚 Pandas 底层正是由 NumPy 数组支撑的。NumPy 的核心是 ndarray 对象,它在内存中开辟了一段紧凑的连续内存空间,通过固定步长(Strides)与单一数据类型(dtype)实现 C 语言级别的执行效率。
1. 最佳入门透析:《Python数据科学手册》(Python Data Science Handbook)
作者 Jake VanderPlas 是一名资深天体物理学家与核心开源贡献者。这本书的第 2 章专门讲解 NumPy,被业内公认为讲解 NumPy 底层原理最清晰的教材之一。它不罗列杂乱的函数表,而是用非常具体的几何图解展示以下三大核心要素:
- 广播规则(Broadcasting Rules):彻底讲清形状不同(例如一个
(3, 1)数组与(1, 3)数组相加)时,NumPy 是如何不复制实际数据而在虚拟维度上自动对齐计算的。 - 通用函数(ufunc):解释为什么向量化加减乘除比原生 Python 循环快两个数量级。
- 花式索引与掩码(Masking & Fancy Indexing):展示如何使用布尔条件提取多维数组子集,这构成了 Pandas 数据过滤的根基。
2. 深度进阶之作:《Guide to NumPy》
对于需要从事科学计算、量化金融底层模型构建或算法库开发的读者,NumPy 核心创建者 Travis Oliphant 所著的《Guide to NumPy》是真正的底层权威。书中深入探讨了 C 语言内存布局、步长计算公式、Fortran 顺序(列主序)与 C 顺序(行主序)的缓存命中率差异,以及如何通过 C-API 扩展加速数值计算。
三、进阶与工程实践:《Effective Pandas》打破语法碎片
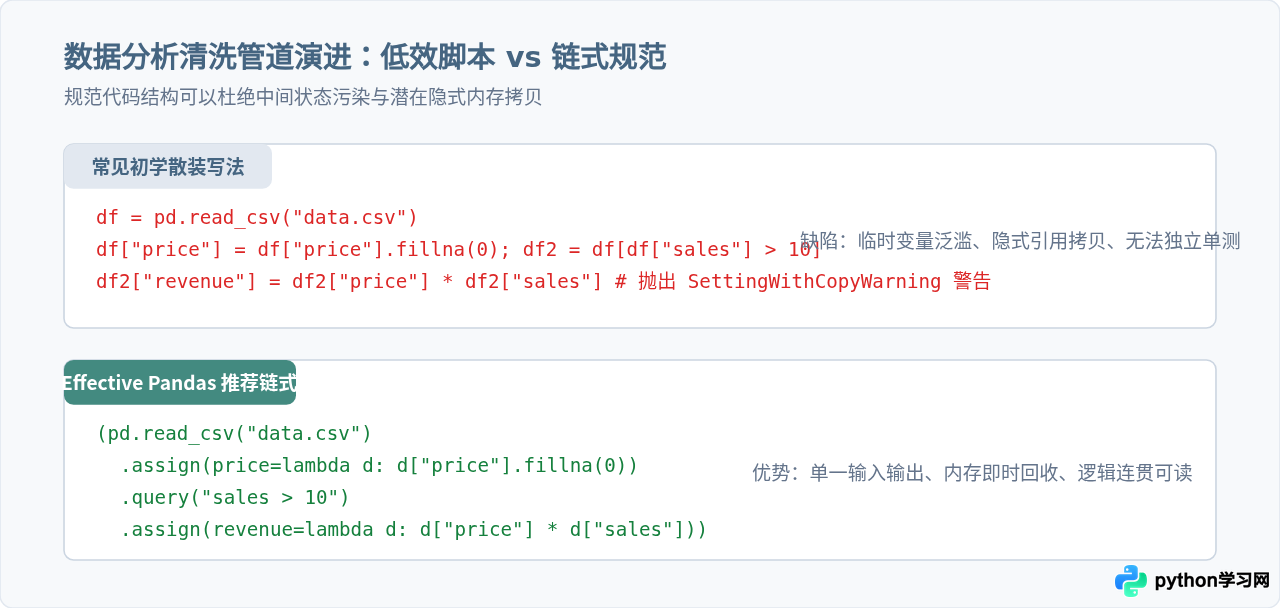
学完前两阶段的读者常会陷入“散装脚本”怪圈:从数据读入开始,不断定义 df1、df2、df_temp,并在各种列上直接赋值,导致代码冗长、测试困难,并且经常弹出令人困惑的 SettingWithCopyWarning。
Matt Harrison 所著的《Effective Pandas》(中文常译为《Pandas进阶修炼》或直接阅读英文最新版)是专门医治这种代码风格的专项好书。作者的核心观点是:在生产环境中处理数据,应当全盘拥抱“方法链(Method Chaining)”。
《Effective Pandas》带来的三大认知转变
- 拥抱
.assign()与.pipe():放弃原地修改(Inplace),通过纯函数管道将一系列清洗动作组合成一个无副作用的单向数据流。 - 内存极致压缩(Type Optimization):详细演示如何通过
Categorical类型将重复文本列从几百兆压缩到几兆,利用可空整数(Int64代替包含 NaN 的float64)保持数据类型一致性。 - 清晰排查报警:深入剖析 Pandas 内部的索引切片机制,彻底弄清何时返回的是底层数组的视图(View),何时触发了数据复制(Copy),从根源上消灭
SettingWithCopyWarning。
四、专项教材选书与进阶全景速查
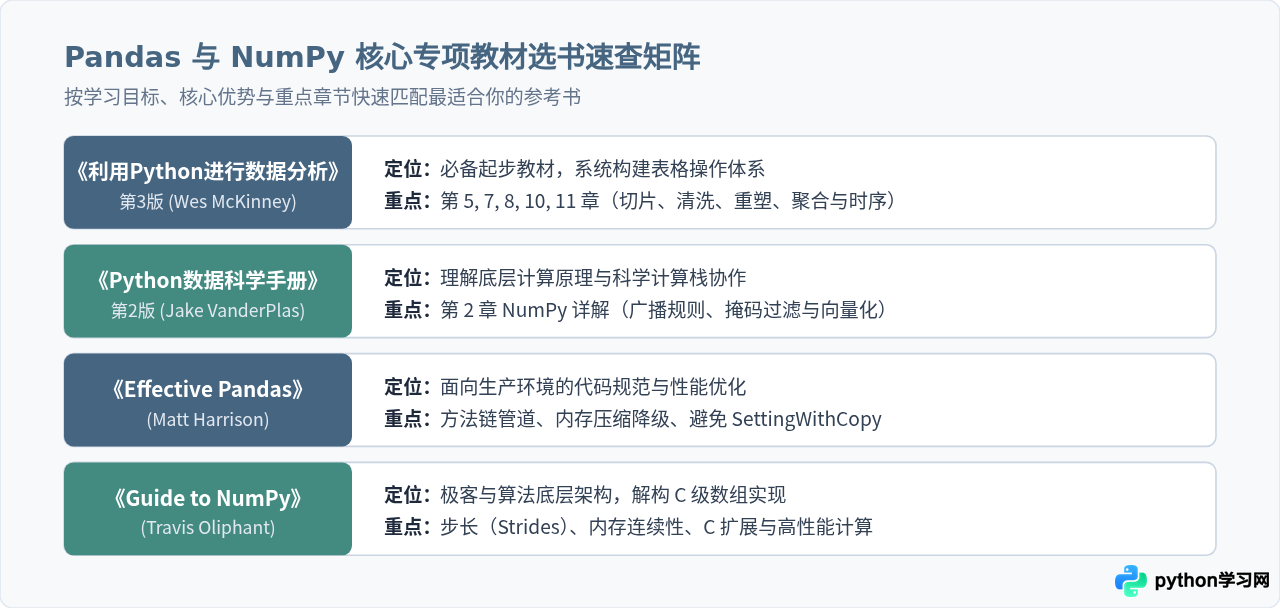
为了让不同基础与目标的读者能够立刻对号入座,下表与结构矩阵将前述书目的核心要点进行了横向对比:
五、避开选书与学习的三大误区
误区一:试图通过一本厚书把所有 API 全部背下来
Pandas 拥有上百个方法和参数,死记硬背效率极低。阅读经典教材的目的不是记住每一个语法细节,而是建立“数据结构直觉”:明确 Series 和 DataFrame 如何管理行标签与列标签、聚合时 split-apply-combine 是如何运转的。具体参数细节随查随用即可。
误区二:无视版本变迁,依然在使用被弃用的习惯
以 Pandas 2.0+ 为例,底层引入了 Apache Arrow 支持(engine="pyarrow"),并推出了全局写入时复制机制(Copy-on-Write, CoW)。旧教材中频繁推荐的 inplace=True 在很多场景下不仅无法提高性能,反而在未来的版本中已被逐步淘汰。因此选书一定要认准近两年的最新修订版。
最佳学习策略:以《利用Python进行数据分析》(第3版)为主线,配合《Python数据科学手册》搞懂 NumPy 原理,在实战项目中参考《Effective Pandas》重构代码。
按照这条路径,你将不仅能高效完成日常业务数据的清洗与分析,更能编写出可维护、低内存占用、高执行效率的工业级 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









