

python必背源代码集合交集并集差集代码
全面讲解Python集合交集、并集、差集与对称差集的必背核心代码。包含运算符语法与内置方法对比、多数据源比对实操步骤、内存就地修改机制及三大高频避坑指南。
一、核心必背源代码模板
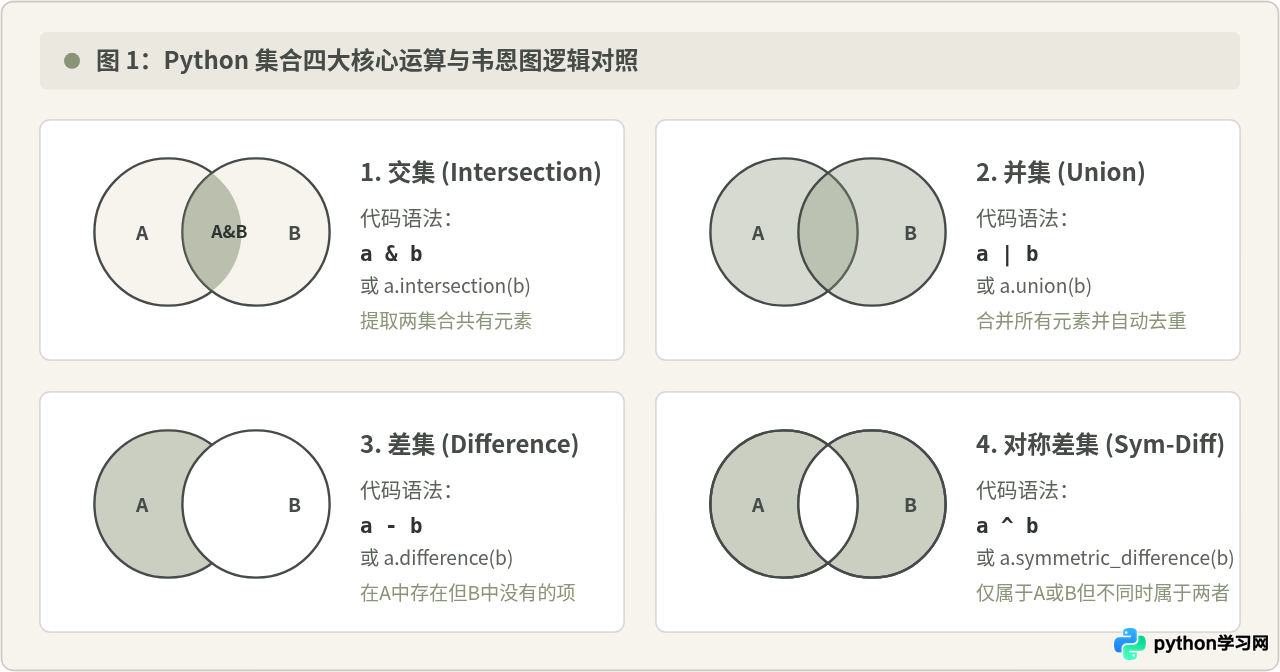
Python 集合提供了两套语法体系来完成运算:一套是直观的数学符号运算符(如 &、|、-、^),另一套是语义明确的内置方法(如 intersection()、union()、difference()、symmetric_difference())。以下代码展示了最基础、最关键的调用格式。
# 示例基础数据(执行环境:Python 3.6+)
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

# 1. 交集(Intersection):获取两集合共同包含的元素
inter_res1 = set_a & set_b               # 运算符形式
inter_res2 = set_a.intersection(set_b)  # 方法形式
# 输出结果均为: {3, 4}

# 2. 并集(Union):合并所有不重复元素
union_res1 = set_a | set_b               # 运算符形式
union_res2 = set_a.union(set_b)         # 方法形式
# 输出结果均为: {1, 2, 3, 4, 5, 6}

# 3. 差集(Difference):存在于左侧集合但在右侧集合中不存在的元素
diff_a = set_a - set_b                  # A中有但B中没有: {1, 2}
diff_b = set_b - set_a                  # B中有但A中没有: {5, 6}
diff_a_method = set_a.difference(set_b) # 方法形式

# 4. 对称差集(Symmetric Difference):只属于A或只属于B,但不同时属于两者的元素
sym_res1 = set_a ^ set_b                # 运算符形式
sym_res2 = set_a.symmetric_difference(set_b)
# 输出结果均为: {1, 2, 5, 6}
上述四种运算构成了集合处理的主干逻辑。需要注意,这些操作均会生成并返回一个全新的集合对象,不会修改原始的 set_a 与 set_b。
二、四类运算的逻辑语义与应用场景
集合运算之所以被列为必背代码,是因为它们直接映射了日常业务开发中的常见判断场景:
-
交集(
&/intersection):常用于权限校验与公共标签筛选。例如:判断当前登录用户所拥有的角色列表与接口所需角色列表是否存在重叠;求两个商品分类的重合标签。 -
并集(
|/union):常用于多源数据汇总与去重。例如:从数据库导出用户列表与从日志采集活跃用户,快速汇总所有不重复的用户 ID 集合。 -
差集(
-/difference):常用于增量同步与缺失项检测。例如:计算“应同步数据”减去“已入库数据”,得到“待新增插入的数据”;或者“原有权限”减去“新权限”,得到“待收回的权限”。 -
对称差集(
^/symmetric_difference):常用于数据版本变动对账。对称差集提取出发生了新增或删除但未保持不变的孤立项,非常适合双向差异审计。
三、实际业务落地:标准四步操作步骤
在实际生产代码中,原始数据通常来自接口 JSON、数据库查询列表或文本文件,并非一开始就是 set。规范的集合处理流程通常分为数据准备、类型转换、执行运算和结果消费四个阶段。
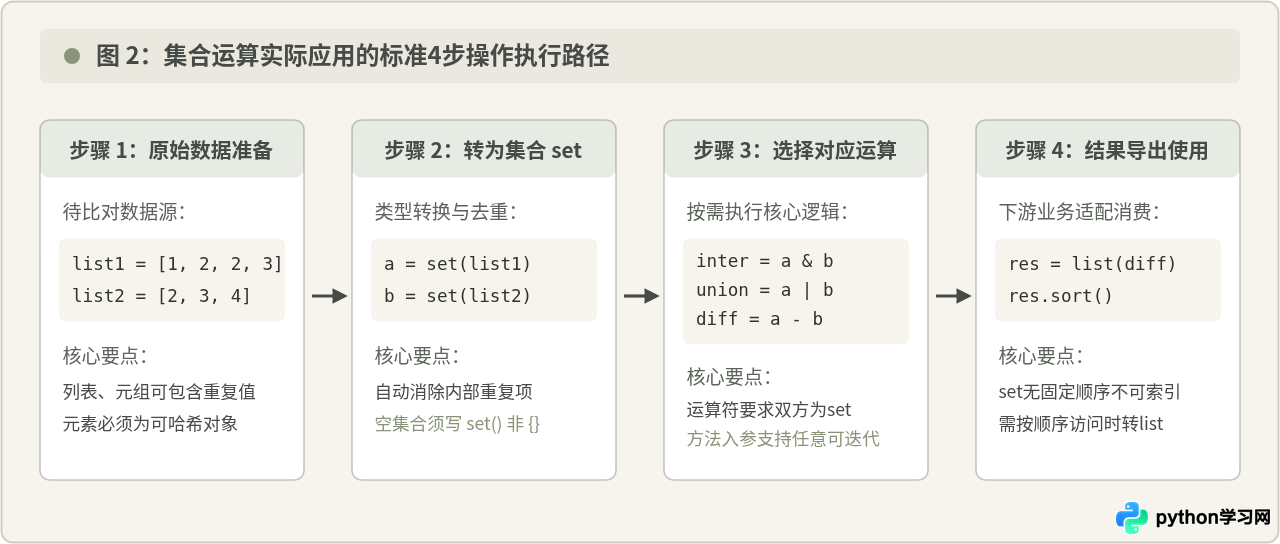
以下为一个完整的业务场景代码示例:对比系统旧权限列表与管理员提交的新权限列表,分别计算出需要新增授权的权限、需要撤销回收的权限以及保持不变的权限。
# 业务实战:用户权限变更比对
old_permissions = ["read", "write", "upload", "write"]  # 包含冗余重复数据
new_permissions = ["read", "upload", "audit", "admin"]

# 步骤1 & 步骤2:数据清洗与集合初始化
set_old = set(old_permissions)  # 得到 {'read', 'write', 'upload'}
set_new = set(new_permissions)  # 得到 {'read', 'upload', 'audit', 'admin'}

# 步骤3:执行集合运算
keep_perms = set_old & set_new     # 交集:保持不变的权限 -> {'read', 'upload'}
add_perms  = set_new - set_old     # 差集:需要新增的权限 -> {'audit', 'admin'}
del_perms  = set_old - set_new     # 差集:需要撤回的权限 -> {'write'}

# 步骤4:转换为下游所需的排序列表并执行业务
result_add = sorted(list(add_perms))
result_del = sorted(list(del_perms))

print("待新增权限:", result_add)  # 示例输出: 待新增权限: ['admin', 'audit']
print("待删除权限:", result_del)  # 示例输出: 待删除权限: ['write']
四、机制辨析:运算符(&、|、-)与内置方法的差异
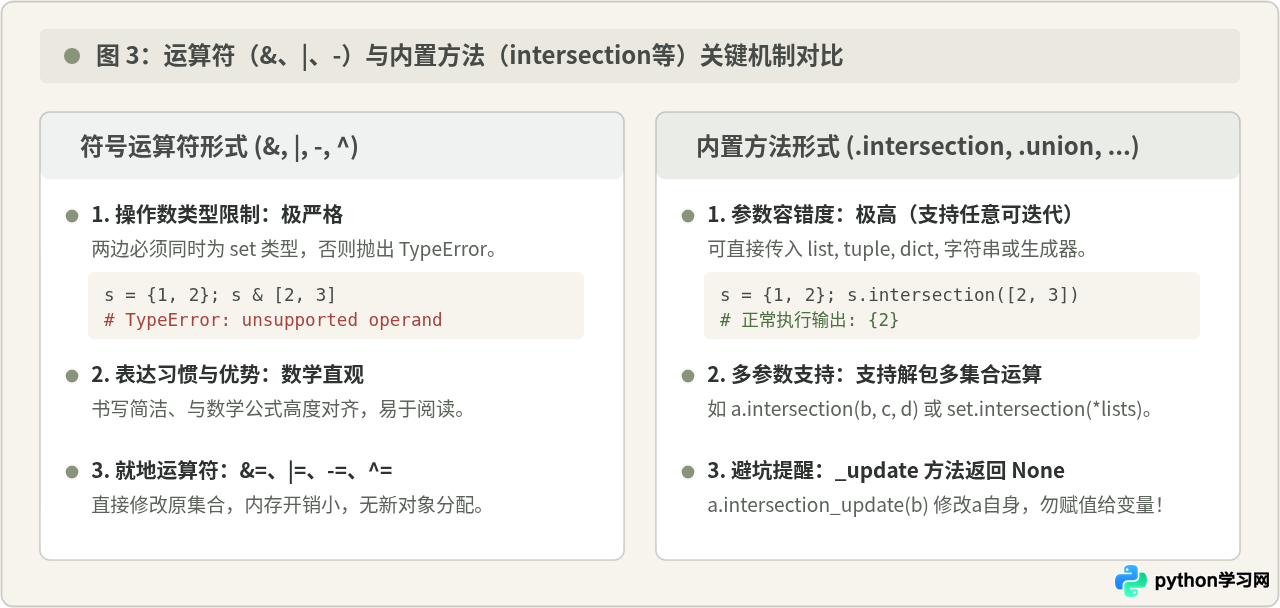
许多初学者认为 a & b 与 a.intersection(b) 只是写法不同,可以完全互换。这种看法在双方均为集合时成立,但在混合数据类型或多参数场景下,两者存在本质区别。
1. 参数类型的灵活性差异
运算符(&, |, -, ^)严格要求两边都必须是集合对象。如果尝试对集合和列表使用运算符,Python 会直接抛出 TypeError:
s = {1, 2, 3}
target_list = [2, 3, 4]

# 错误用法:运算符不支持非集合类型
# res = s & target_list
# TypeError: unsupported operand type(s) for &: 'set' and 'list'

# 正确用法:内置方法会自动将可迭代对象作为集合处理
res = s.intersection(target_list)  # 正常执行,输出: {2, 3}
当数据源已经存储在列表、元组或字典键中时,直接调用方法可以省略外层的 set() 显式转换,代码更为精炼。
2. 多集合运算与函数式解包
当需要同时求多个数据集的交集或并集时,内置方法支持接收任意数量的位置参数,甚至支持解包传参:
list_a = {1, 2, 3, 4}
list_b = [2, 3, 5]
list_c = (3, 4, 6)

# 一次性求解多个对象的交集
multi_inter = list_a.intersection(list_b, list_c)  # 结果: {3}

# 针对动态列表集合,可使用类方法与解包运算符
many_sources = [[1, 2, 3], [2, 3, 4], [3, 4, 5]]
common_items = set.intersection(*(set(item) for item in many_sources))  # 结果: {3}
五、就地修改方法(In-place Update)
当处理海量数据时,如果每次运算都创建新的集合对象,会带来显著的内存分配与垃圾回收开销。Python 提供了对应的高性能“就地修改”语法:
| 运算类型 | 创建新集合语法 | 就地修改运算符 | 就地修改内置方法 |
|---|---|---|---|
| 交集更新 | a & b / a.intersection(b) |
a &= b |
a.intersection_update(b) |
| 并集更新 | a | b / a.union(b) |
a |= b |
a.update(b) |
| 差集更新 | a - b / a.difference(b) |
a -= b |
a.difference_update(b) |
| 对称差更新 | a ^ b / a.symmetric_diff... |
a ^= b |
a.symmetric_difference_update(b) |
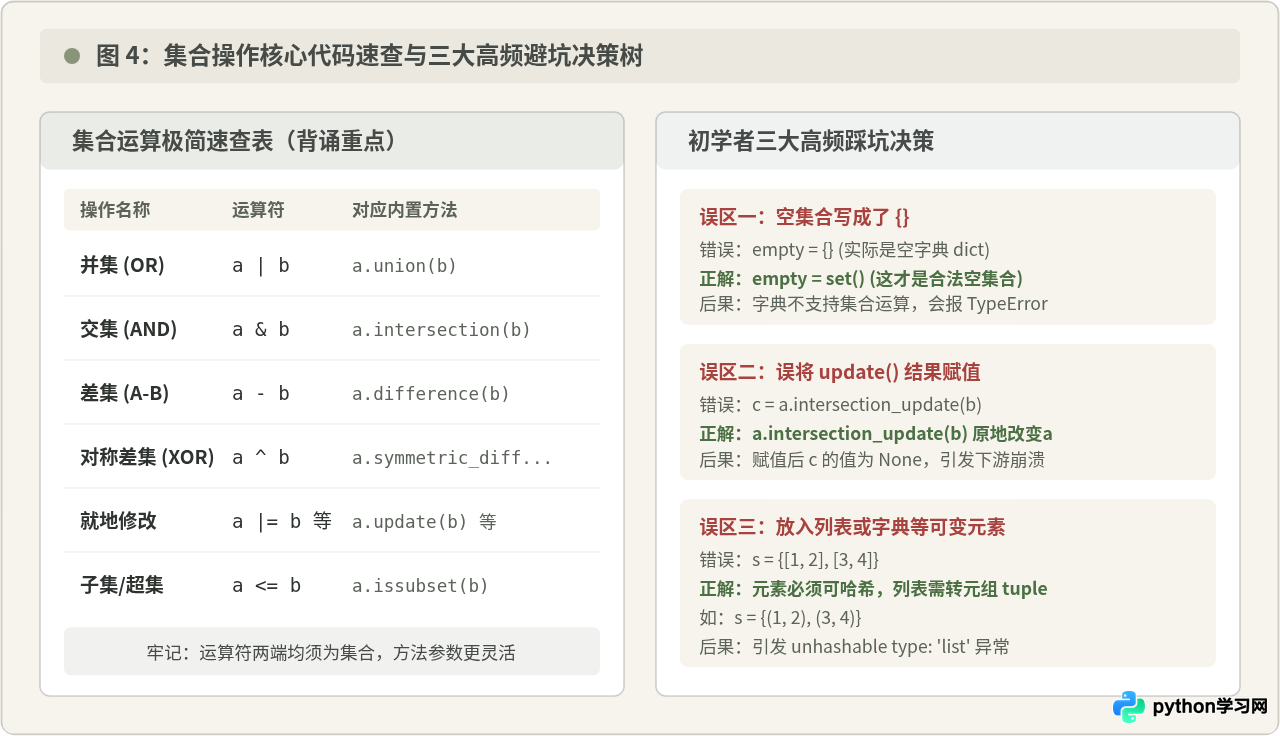
a.update(b)、a.intersection_update(b))返回值均为 None!切勿将其赋值给新变量,否则会导致变量丢失原集合对象变为空值。
六、高频误区排查与速查决策
集合代码虽短,但因其底层基于哈希表实现,在基础语法上存在几个极具迷惑性的典型陷阱:
-
空集合创建误区:很多初学者习惯用
empty = {}初始化空集合。在 Python 中,一对花括号{}默认表示空字典(dict)而非集合。创建空集合必须使用显式构造器empty = set()。 -
不可哈希对象陷阱:集合要求所有元素必须是可哈希(hashable)且不可变的对象。因此,不能将列表(
list)或字典(dict)直接作为集合元素放入。如果需要存储多维数据组合,应使用不可变的元组(tuple)代替列表。 -
集合无序性与索引陷阱:集合是基于哈希桶实现的无序结构,不支持下标切片访问(如
s[0]会报错TypeError: 'set' object is not subscriptable)。如需按特定顺序提取或索引首项元素,必须先通过list(s)或sorted(s)进行有序转换。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









