

Python数据分析面试常见案例题整理(Word可编辑)
本文系统整理Python数据分析面试高频业务案例题,包含指标异动归因、留存漏斗、RFM用户分层与A/B测试验证等完整解题思路与Python代码,并提供标准Word排版规范与整理指南。
在数据分析求职面试中,单纯考查语法死记硬背的题目正逐渐减少,取而代之的是结合实际业务场景的综合案例题。这类题目往往给出一批结构化日志或业务表,要求候选人在限定时间内完成数据清洗、指标拆解、根因下钻、统计检验并输出业务建议。本文梳理大厂与成长型企业中最高频出现的Python数据分析案例题型,提炼出可落地的标准答题逻辑与Pandas代码实现,并提供规整的Word可编辑题集排版规范,帮助读者建立系统化的复习底稿。
一、业务案例题的标准解题框架
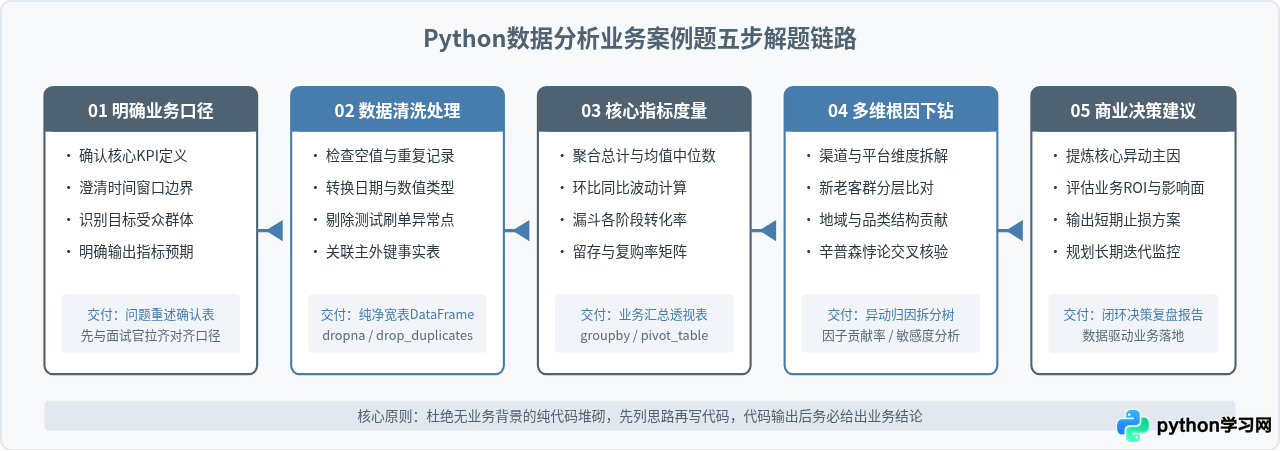
面对业务案例题,许多候选人容易立即开始写代码,导致缺乏整体思考,最终分析结论偏离题意。成熟的数据分析师通常按照“定义目标-数据清洗-指标度量-深度下钻-行动建议”的五步标准化框架开展工作。在面试作答时,将这一框架先口述或在笔记中列出要点,能显著展现严谨的结构化思维。
二、高频案例题一:次日/7日留存率计算与指标异常排查
题目背景:面试官提供一张用户登录行为日志表 user_log,字段包含 user_id(用户ID)与 action_time(登录时间)。要求计算某自然周内每日新增用户的次日留存率,并假设某天留存率突然下跌25%,给出Python排查代码和排查思路。
1. 次日留存率核心代码实现
留存率计算的核心是构建两张子表:新增用户的首登日期表(Cohort),以及用户的后续活跃日期表。通过内连接(merge)计算间隔天数为1的用户数占首登总人数的比例。
import pandas as pd
import numpy as np

# 1. 模拟用户登录明细数据
raw_data = {
    'user_id': [101, 102, 103, 101, 102, 104, 101, 105, 104],
    'action_time': [
        '2026-03-01 09:12:00', '2026-03-01 10:00:00', '2026-03-01 11:30:00',
        '2026-03-02 08:20:00', '2026-03-02 14:10:00', '2026-03-02 16:00:00',
        '2026-03-03 09:00:00', '2026-03-03 10:15:00', '2026-03-03 11:00:00'
    ]
}
df = pd.DataFrame(raw_data)
df['action_date'] = pd.to_datetime(df['action_time']).dt.date

# 2. 提取每个用户的首登日期
first_login = df.groupby('user_id')['action_date'].min().reset_index()
first_login.rename(columns={'action_date': 'first_date'}, inplace=True)

# 3. 关联活跃记录并计算日期差
merged = pd.merge(df[['user_id', 'action_date']].drop_duplicates(), first_login, on='user_id')
merged['day_diff'] = (merged['action_date'] - merged['first_date']).apply(lambda x: x.days)

# 4. 透视生成留存统计表
retention_pivot = merged.pivot_table(
    index='first_date',
    columns='day_diff',
    values='user_id',
    aggfunc='count',
    fill_value=0
)

# 5. 计算留存率百分比
retention_rate = retention_pivot.divide(retention_pivot[0], axis=0).round(4)
print("--- 留存人数透视表 ---")
print(retention_pivot)
print("\n--- 留存率透视表 ---")
print(retention_rate)
2. 留存异常波动的多维排查逻辑
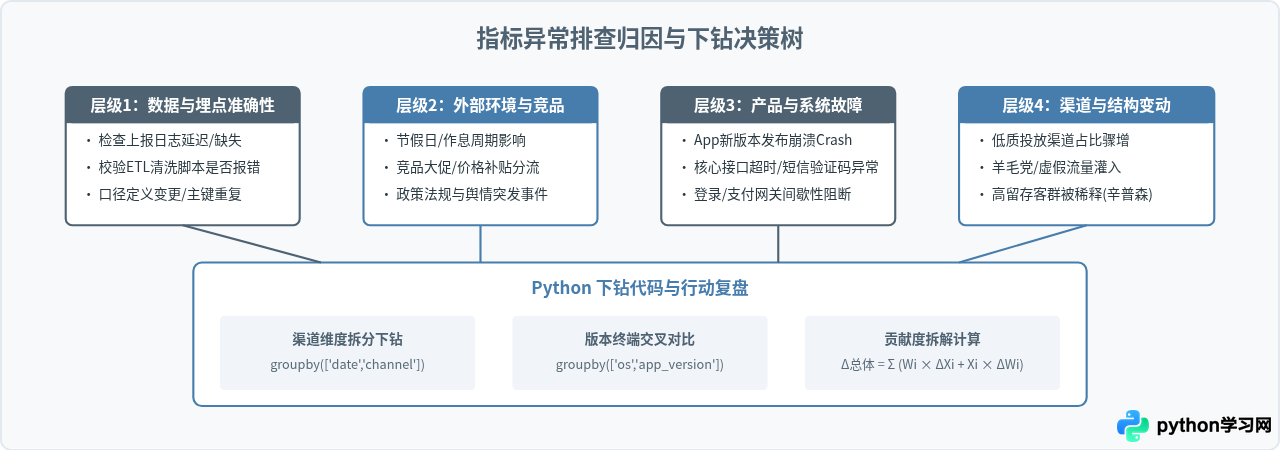
当次日留存发生暴跌时,不能盲目猜测,必须按照“外部环境 > 内部系统 > 渠道来源 > 版本终端 > 用户行为”的逻辑层级排查。
三、高频案例题二:电商RFM用户分层与复购周期分析
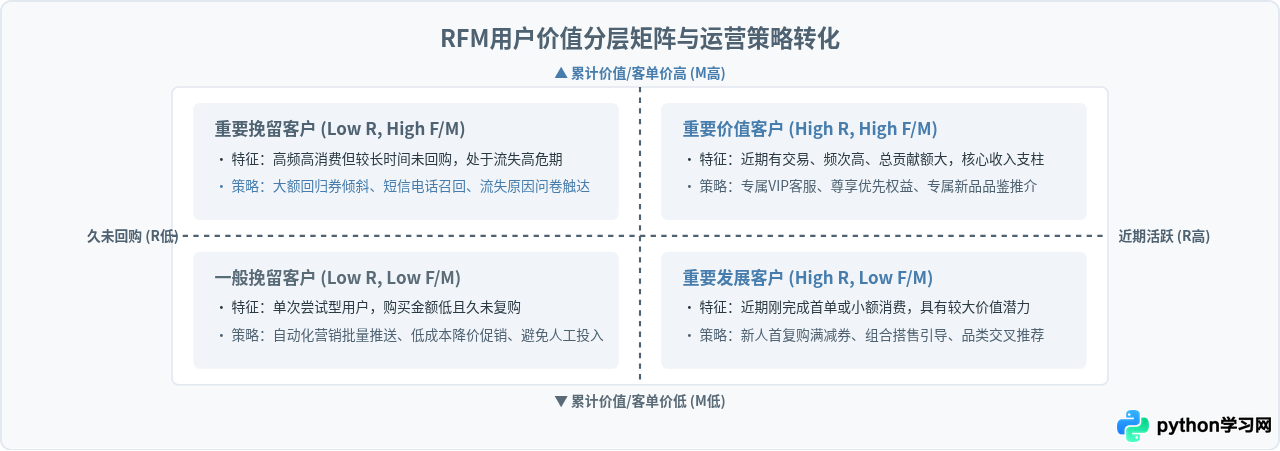
题目背景:给定订单交易表 orders,字段包含 order_id、user_id、order_date、payment_amount。要求利用Python计算RFM分值(最近消费时间间隔Recency、消费频次Frequency、消费金额Monetary),并将用户分为8类人群(如重要价值客户、重要挽留客户等),同时计算用户的复购周期分布。
1. RFM 分层模型代码
import pandas as pd
import datetime as dt

# 模拟订单数据
orders_data = {
    'order_id': ['O1', 'O2', 'O3', 'O4', 'O5', 'O6', 'O7'],
    'user_id': ['U1', 'U2', 'U1', 'U3', 'U2', 'U4', 'U1'],
    'order_date': ['2026-01-05', '2026-01-15', '2026-02-10', '2026-02-20', '2026-03-01', '2026-03-10', '2026-03-25'],
    'payment_amount': [120.0, 350.0, 99.0, 800.0, 210.0, 45.0, 300.0]
}
df_order = pd.DataFrame(orders_data)
df_order['order_date'] = pd.to_datetime(df_order['order_date'])

# 设定分析基准时间(最后一次订单时间的次日)
snapshot_date = df_order['order_date'].max() + dt.timedelta(days=1)

# 聚合计算 R、F、M 原始数值
rfm = df_order.groupby('user_id').agg({
    'order_date': lambda x: (snapshot_date - x.max()).days, # Recency
    'order_id': 'count',                                   # Frequency
    'payment_amount': 'sum'                                 # Monetary
}).reset_index()

rfm.columns = ['user_id', 'Recency', 'Frequency', 'Monetary']

# 基于均值或中位数进行二值化打分 (1表示优于平均, 0表示低于平均)
rfm['R_score'] = (rfm['Recency'] < rfm['Recency'].mean()).astype(int)
rfm['F_score'] = (rfm['Frequency'] >= rfm['Frequency'].mean()).astype(int)
rfm['M_score'] = (rfm['Monetary'] >= rfm['Monetary'].mean()).astype(int)

# 客户类型标签映射
def classify_user(row):
    score = f"{row['R_score']}{row['F_score']}{row['M_score']}"
    mapping = {
        '111': '重要价值客户',
        '011': '重要保持客户',
        '101': '重要发展客户',
        '001': '重要挽留客户',
        '110': '一般价值客户',
        '010': '一般保持客户',
        '100': '一般发展客户',
        '000': '一般挽留客户'
    }
    return mapping.get(score, '其他客群')

rfm['customer_segment'] = rfm.apply(classify_user, axis=1)
print(rfm[['user_id', 'Recency', 'Frequency', 'Monetary', 'customer_segment']])
四、高频案例题三:A/B 测试效果评估与置信度检验
题目背景:产品团队上线了新版结算详情页(B组),希望验证其是否显著提升了支付转化率。实验运行14天后,A组(对照组)进组100,000人,转化4,200人;B组(实验组)进组100,000人,转化4,500人。请用Python进行假设检验,判断改版效果是否在统计学上显著,并评估能否全量推上线。
1. 双样本比例Z检验(Two-Sample Z-Test)实现
import numpy as np
from scipy import stats

def two_proportion_z_test(n1, x1, n2, x2, alpha=0.05):
    """
    n1, n2: 两组进组总样本量
    x1, x2: 两组目标转化样本量
    """
    p1 = x1 / n1
    p2 = x2 / n2

    # 综合合并转化率
    p_pool = (x1 + x2) / (n1 + n2)
    # 计算标准误
    se = np.sqrt(p_pool * (1 - p_pool) * (1/n1 + 1/n2))
    # 计算 Z 统计量
    z_score = (p2 - p1) / se
    # 计算双尾 P 值
    p_value = (1 - stats.norm.cdf(abs(z_score))) * 2

    # 计算相对提升率 (Lift)
    lift = (p2 - p1) / p1

    return {
        'p1(对照组)': f"{p1:.4%}",
        'p2(实验组)': f"{p2:.4%}",
        '相对提升(Lift)': f"{lift:.2%}",
        'Z-Score': round(z_score, 4),
        'P-Value': round(p_value, 5),
        '统计显著(alpha=0.05)': p_value < alpha
    }

# 运行案例数据
result = two_proportion_z_test(n1=100000, x1=4200, n2=100000, x2=4500)
for k, v in result.items():
    print(f"{k}: {v}")
- 统计显著 ≠ 商业显著:虽然 P-Value < 0.05 证明实验提升不是随机波动引起的,但还需计算边际收益是否覆盖改版开发和服务器维护成本。
- AA测试校验:上线实验前需确认分流引擎的随机性,AA空跑两组转化差异应处于置信区间内。
- 新奇效应(Novelty Effect):老用户对新界面感到新鲜可能短期刺激转化,需观察次周留存是否衰减。
五、Word可编辑面试题集的排版组织与规范
很多求职者下载或整理的资料格式混乱,代码与解释混作一团,打印复习或二次修改十分不便。要打造一份高效、清晰、便于在Microsoft Word或WPS中随意编辑的题集文档,建议遵循以下四大排版标准:
| 文档模块 | Word排版样式推荐 | 内容规范与注意事项 |
|---|---|---|
| 题目标题区 | 标题2 / 微软雅黑 16pt / 加粗 / 深灰色(#333333) | 包含题号、涉及业务领域(电商/社交/金融)、考查核心知识点标签。 |
| 业务背景与数据字典 | 正文 / 10.5pt (五号) / 浅灰色背景单行表格 | 明确字段名、数据类型、主键、物理含义,避免口径歧义。 |
| 解题逻辑与思路 | 项目符号列表 / 1.25倍行距 / 段前段后2磅 | 按“1.指标定义 2.异常定位 3.下钻拆分”分点陈述,便于口试快速回忆。 |
| Python代码区 | Consolas字体 / 9.5pt / 底色设为 #F4F6F8 表格单元格 | 必须包含完整的模拟数据构造代码与核心函数,关键行配简短中文注释。 |
| 面试官追问与避坑 | 左侧带4pt强调色框线的引用段落 | 记录辛普森悖论、数据偏斜、样本不足等常设陷阱与破解话术。 |
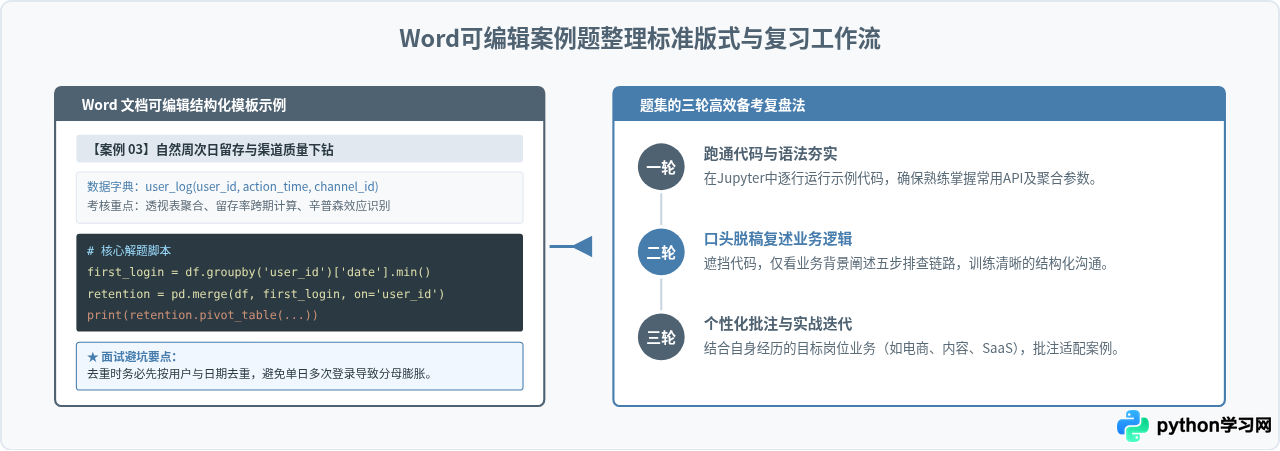
六、总结与面试备考建议
Python数据分析面试案例题的本质,是在模拟真实职场中的业务沟通与数据解决过程。通过建立Word可编辑的专属案例题集,求职者不仅能够保留高质量代码模板,更能在每一次面试复盘后,随时补充面试官的新追问、新指标定义与业务场景。
在日常复习时,建议把精力从“死记硬背复杂函数”转向“理解指标背后的商业价值”,牢牢掌握五步解题主线,做到“看到题目有框架、动手写码不卡壳、输出结论懂业务”,从而在激烈的求职竞争中展现成熟专业的数据分析素养。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









