

Python数据分析常用库对比:Pandas、NumPy与Matplotlib怎么选
全面对比Python数据分析三大基础库Pandas、NumPy与Matplotlib的核心定位、数据模型、性能差异与适用场景,提供清晰的选型决策路径与协同实战代码。
在Python数据分析技术栈中,NumPy、Pandas与Matplotlib分别承担底层数值计算、表格化数据处理以及数据可视化的职责。面对具体分析任务时,选择的核心依据在于当前处理数据的结构形态与所处的工作阶段:处理同构高维数值阵列选NumPy,处理异构表格与带标签时序选Pandas,需要将分析结果呈现为图表时选Matplotlib。本文将从核心定位、底层数据结构、典型操作对比、选型决策路径以及三者协同工作流展开系统讲解,帮助你在实际开发中做出准确选择。
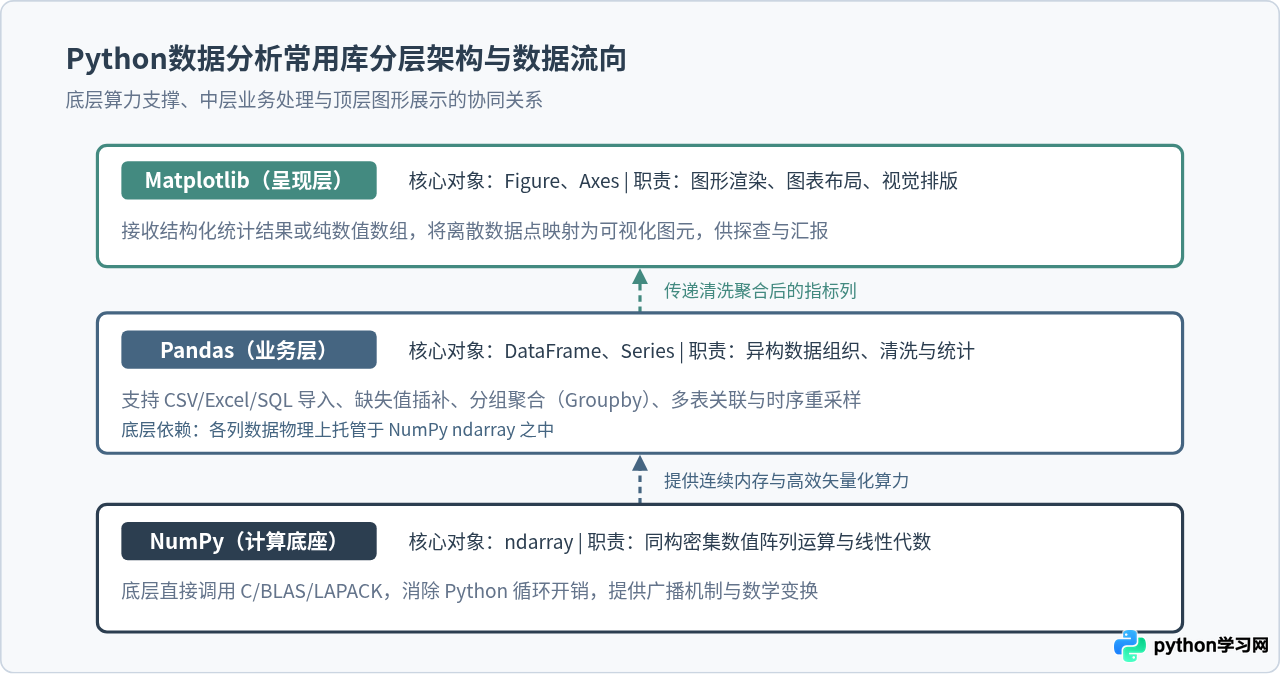
一、核心定位与底层数据结构:三个库的本质差异
理解这三个库的第一步,是认清它们各自解决的问题和底层数据模型。虽然它们经常一起出现,但设计哲学截然不同:
- NumPy(数值基石):核心对象是
ndarray(N-dimensional Array)。它要求数组内的元素必须是同构数据类型(如全为float64或int32),并在内存中占用连续的存储块。NumPy依靠C语言底层实现与SIMD矢量化指令,大幅消除了Python原生列表的指针寻址开销,专为高维数值计算、线性代数和矩阵变换而生。 - Pandas(业务与表格):核心对象是
Series(一维带标签数组)和DataFrame(二维异构数据表)。Pandas建立在NumPy的基础之上,其列底层往往就是NumPy数组,但它允许不同列具有不同的数据类型(如文本、数值、布尔、时间戳)。Pandas引入了显式索引(Index)、对齐机制以及自动缺失值标记,专为应对现实中不规范、带表头的复杂业务数据。 - Matplotlib(视觉呈现):核心对象是
Figure(画布顶层容器)与Axes(具有坐标系的具体绘图区)。它不承担深度数据清洗或矩阵运算功能,而是作为专业绘图引擎,负责将NumPy数组或Pandas序列中的数值映射为坐标系内的线条、散点、柱块等几何实体。
二、典型操作与代码表现对比:同一任务下的写法差异
在面对同样的数据过滤、计算与绘图任务时,不同库的代码范式与关注点有明显差异。以下通过对比代码展示各自的典型用法:
1. 数据创建与条件过滤
假设我们有一组气温观测数据,需要过滤出大于25度的样本并计算平均温差:
import numpy as np
import pandas as pd

# --- 使用 NumPy 方式 ---
# 创建纯数值一维数组
temps_np = np.array([23.5, 26.1, 28.4, 21.8, 27.5, 29.2])
# 条件布尔索引与向量化减法
mask_np = temps_np > 25.0
filtered_np = temps_np[mask_np]
diff_mean_np = np.mean(filtered_np - 25.0)

# --- 使用 Pandas 方式 ---
# 创建带日期索引的 Series,模拟真实业务场景
dates = pd.date_range("2026-06-01", periods=6)
temps_pd = pd.Series([23.5, 26.1, 28.4, 21.8, 27.5, 29.2], index=dates, name="Temperature")
# 支持基于标签或条件的切片,保留元数据信息
filtered_pd = temps_pd[temps_pd > 25.0]
diff_mean_pd = (filtered_pd - 25.0).mean()
从代码可见,NumPy关注纯数值和内存数组的高效切片;Pandas则保留了时间戳索引和字段名,使分析结果始终带有业务语境。
2. 数据输入与绘图输出
Matplotlib能够无缝接收来自NumPy数组或Pandas Series的数据。推荐使用面向对象的 fig, ax = plt.subplots() 规范接口:
import matplotlib.pyplot as plt

# 构造画布与子图坐标系
fig, ax = plt.subplots(figsize=(8, 4))

# 既可以直接传入 NumPy 数组
# ax.plot(np.arange(6), temps_np, color="#456581", marker="o", label="NumPy Array")

# 也可以直接传入 Pandas Series,x 轴会自动使用 Series 的时间索引
ax.plot(temps_pd.index, temps_pd.values, color="#438A80", marker="s", label="Pandas Series")
ax.axhline(25.0, color="#E2E8F0", linestyle="--", label="Threshold (25°C)")

ax.set_title("Temperature Trend (June 2026)")
ax.set_ylabel("Celsius (°C)")
ax.legend()
plt.tight_layout()
# plt.show() # 在本地或笔记本中显示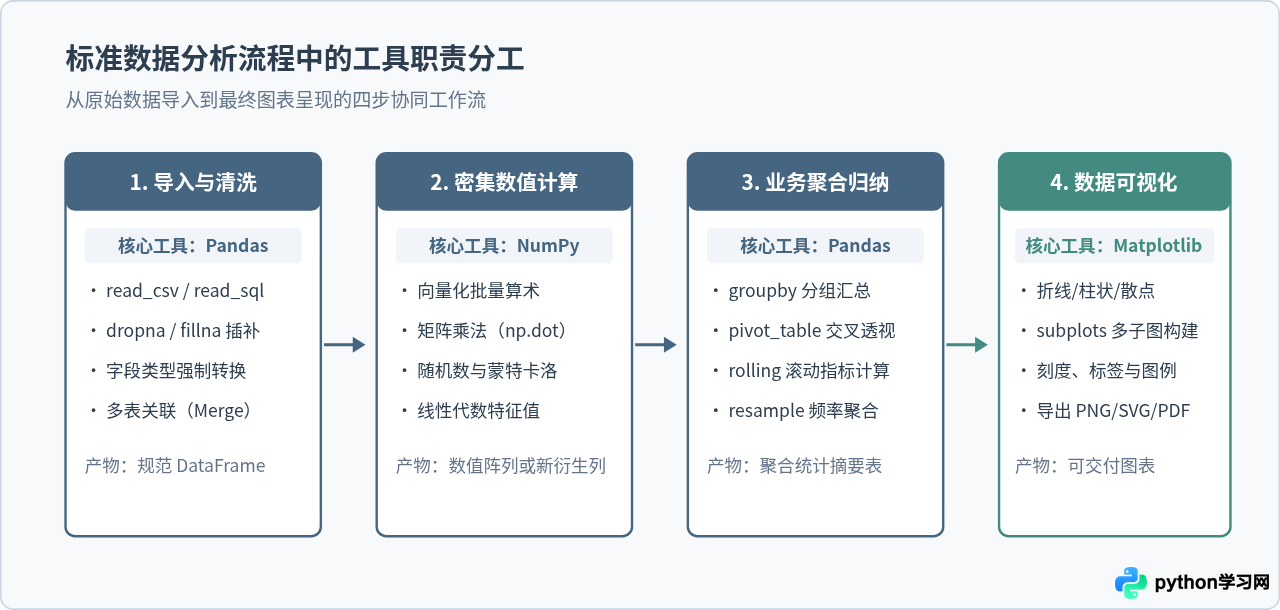
三、关键场景选型决策:怎么选与什么时候不用
在工程实践中,判断该选用哪个库可以遵循以下具体边界条件:
1. 什么时候必须选 NumPy?
- 数据形态为同构密集矩阵:例如图像像素数据(三维矩阵
H x W x C)、音频波形数据、物理仿真网格点。 - 涉及深度学习特征运算与线性代数:如矩阵乘法、奇异值分解(SVD)、傅里叶变换、向量夹角计算等。
- 内存敏感与极限速度要求:当数据量达到千万级且数据类型统一时,Pandas的索引和对象封装会带来额外的内存负担(通常比同等NumPy数组大2到5倍),此时直接使用NumPy可降低内存占用并提升处理速度。
2. 什么时候必须选 Pandas?
- 数据来自外部文件或数据库:读取 CSV、TSV、Parquet、Excel、SQL 查询结果时,必须依靠 Pandas 强大的
read_*生态。 - 数据存在列异构与缺失值:某列是用户ID(整数),某列是注册时间(日期),某列是金额(浮点),且存在空值。NumPy无法优雅支持这种混合表。
- 需要复杂的统计切片与时序处理:如“按月统计每类商品的复购率”、“计算过去30天的滚动加权均值”,Pandas内置的
groupby、rolling、resample函数是最高效的选择。
3. 什么时候必须选 Matplotlib?
- 需要直观探查数据分布与异常值:绘制直方图、箱线图、散点矩阵以判断数据偏态或离群点。
- 业务成果与科研报告交付:需要精细定制图表尺寸、分辨率(DPI)、坐标轴刻度、图例字体及多子图复合排版。
- 注:虽然 Pandas 自带
df.plot()便捷绘图方法,但其底层正是封装了 Matplotlib。对于简单的快速预览,可以直接调用df.plot();若要完成多图组合、自定义标注和发布级排版,仍需使用 Matplotlib 原生接口。
四、综合实战:三库协同的标准工作流
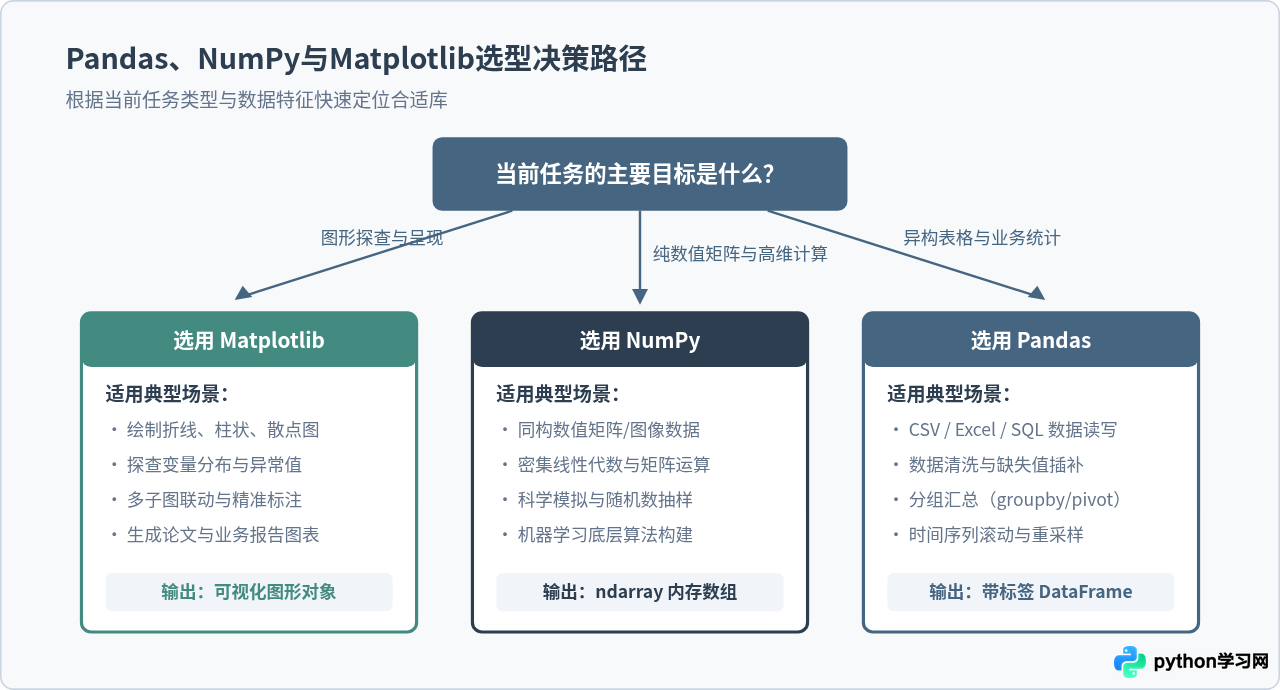
在工业级数据分析项目中,很少孤立地只用某一个库,最常见的做法是三者协同配合。下面通过一段完整的模拟分析示例,演示从数据生成(NumPy)、时序构建与衍生指标计算(Pandas)到双子图可视化呈现(Matplotlib)的全过程:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# -------------------------------------------------------------
# 1. 使用 NumPy 模拟生成具有随机漫步特性的股票收盘价格
# -------------------------------------------------------------
np.random.seed(42)
n_days = 120
daily_returns = np.random.normal(loc=0.001, scale=0.02, size=n_days)
price_paths = 100.0 * np.cumprod(1.0 + daily_returns)
volumes = np.random.randint(10000, 50000, size=n_days)

# -------------------------------------------------------------
# 2. 使用 Pandas 构建带日期索引的 DataFrame,并计算技术指标
# -------------------------------------------------------------
trading_days = pd.date_range("2026-01-01", periods=n_days, freq="B")
df = pd.DataFrame({
    "Close": price_paths,
    "Volume": volumes
}, index=trading_days)

# 利用 Pandas 窗口函数计算 10 日移动平均线与波动率
df["MA10"] = df["Close"].rolling(window=10).mean()
df["Daily_Return"] = df["Close"].pct_change()

# -------------------------------------------------------------
# 3. 使用 Matplotlib 面向对象接口绘制价格与成交量双子图
# -------------------------------------------------------------
fig, (ax_price, ax_vol) = plt.subplots(
    nrows=2,
    ncols=1,
    figsize=(10, 6),
    sharex=True,
    gridspec_kw={"height_ratios": [3, 1]}
)

# 绘制主图:收盘价与移动均线
ax_price.plot(df.index, df["Close"], label="Daily Close", color="#456581", linewidth=1.5)
ax_price.plot(df.index, df["MA10"], label="10-Day Moving Average", color="#438A80", linestyle="--")
ax_price.set_ylabel("Price ($)")
ax_price.set_title("Stock Price Trend & Volume Analysis (2026)")
ax_price.legend(loc="upper left")
ax_price.grid(True, linestyle=":", alpha=0.6)

# 绘制附图:每日成交量
ax_vol.bar(df.index, df["Volume"], color="#94A3B8", width=1.0)
ax_vol.set_ylabel("Volume")
ax_vol.set_xlabel("Date")
ax_vol.grid(True, linestyle=":", alpha=0.6)

plt.tight_layout()
# plt.savefig("stock_analysis.png", dpi=300)
# plt.show()
在上述工作流中:
np.random.normal与np.cumprod负责高效率地生成服从特定统计分布的浮点数组;pd.DataFrame与rolling(10).mean()负责将数据与交易日历对齐,以声明式语法快速提取时间序列特征;fig, (ax_price, ax_vol) = plt.subplots(...)提供了对画布高度比例、坐标轴共享与网格样式的精细控制,实现了专业的数据呈现。
五、三库全维度对比与避坑指南
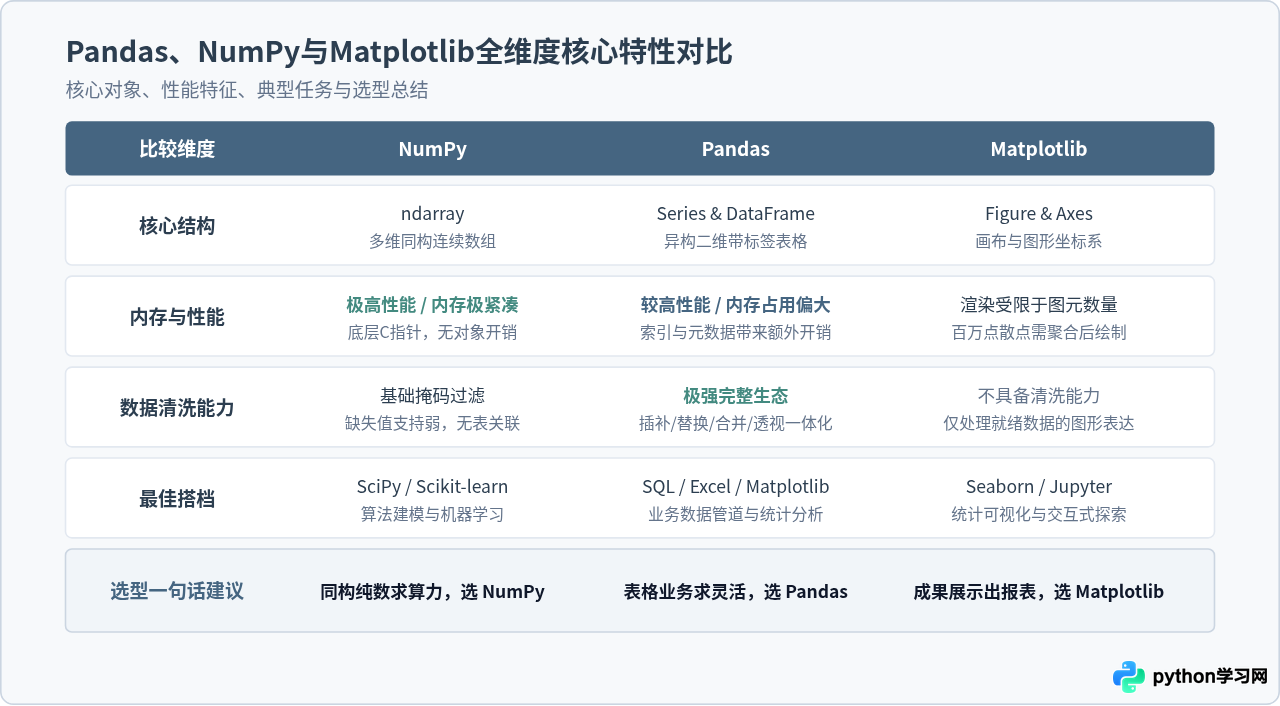
为了便于在日常开发中随时查阅,以下将三个库的核心特性归纳为全景对比图:
开发实践避坑指南:
- 切勿在 Pandas 中使用
for循环或iterrows():逐行迭代会破坏底层向量化加速机制,导致百万行数据耗时数分钟。应优先使用矢量化算术表达式或.apply(),必要时提取df['col'].values转换为 NumPy 数组完成批量计算。 - 绘图时坚持使用面向对象接口:避免混用
plt.plot()与ax.plot()。在多子图排版与复杂标注场景中,始终先使用fig, ax = plt.subplots()声明对象,可以彻底杜绝坐标轴指向混乱的问题。 - 警惕内存膨胀:当单机处理接近内存上限(如 8GB 以上)的 CSV 数据时,不要盲目使用
pd.read_csv一次性读取。应指定dtype参数(如将float64降为float32)、使用usecols只加载必要字段,或使用chunksize分块读取并转入 NumPy 完成局部聚合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









