

Python怎么用encode和decode处理字符串编码
深入讲解 Python 中使用 encode 和 decode 方法进行字符串编码与解码的完整流程,剖析 str 与 bytes 的本质区别、常见编码集转换、errors 异常处理机制与排查要点。
str.encode() 将内存中的文本字符串转化为可供存储或传输的二进制字节串(bytes),使用 bytes.decode() 将接收到的二进制字节串重新解析还原为人类可读的字符串(str)。本文将以清晰的步骤、对照示例与实战场景,完整拆解这两个方法的工作原理与具体操作细节。
一、核心认知:理解 str 与 bytes 的本质区别
很多刚接触 Python 编码的开发者容易将“编码”与“加密”混淆,或者认为同一个变量既是文字又是字节。在 Python 3 中,这两者在底层有着严格且清晰的分工:
- str(字符串对象):是 Unicode 字符序列,表示抽象的人类语言文字(如汉字、字母、标点、Emoji 等)。在 Python 内存中,开发者无需也不应该关心它究竟占几个物理字节,它只代表字符本身。
- bytes(字节串对象):是 8 位无符号整数(0~255)组成的二进制字节流,通常以十六进制形式展示(形如
b'\xe4\xbd\xa0')。它是计算机硬件在磁盘存储、网络数据包传输或跨进程通信时所使用的真正格式。
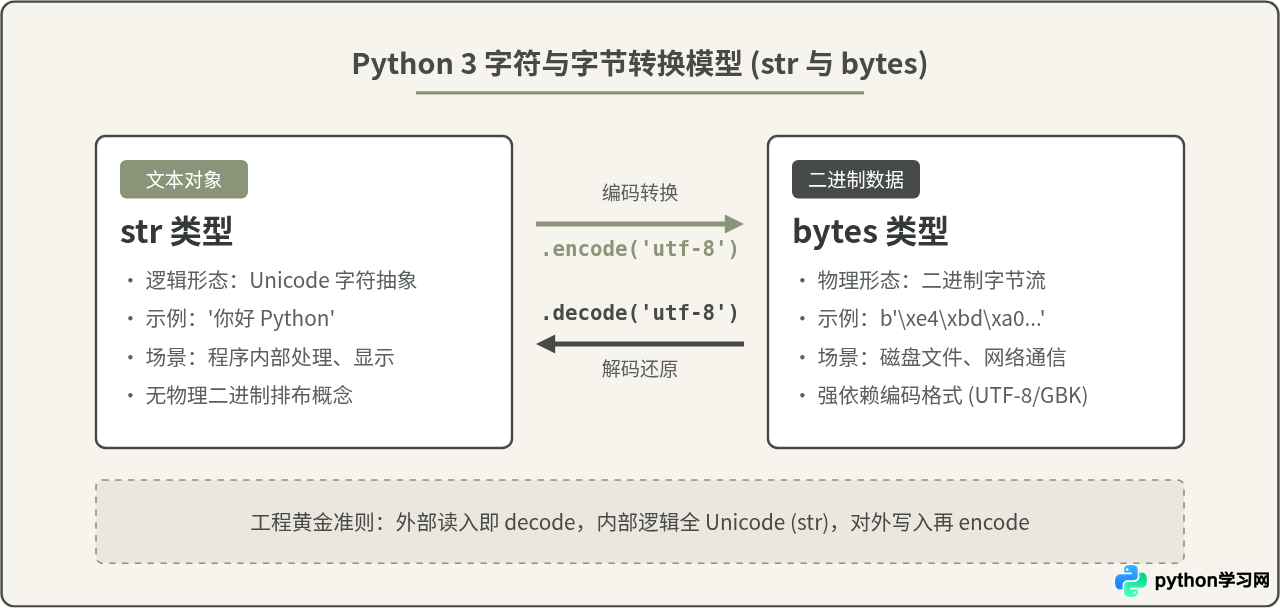
字符与字节之间并不是直接等价的,它们需要依据特定的“编码规则”(如 UTF-8、GBK、ASCII 等)建立双向映射。encode 就是从字符到字节的映射过程,而 decode 则是从字节到字符的还原过程。
二、具体操作:encode 与 decode 的使用步骤
掌握两个方法的基本语法与返回类型,是进行字符编解码操作的第一步。
1. 使用 encode 将字符串转换为字节串
encode 是定义在 str 类上的方法。其完整签名如下:
str.encode(encoding='utf-8', errors='strict')参数说明:
encoding:目标字符编码格式,默认值为'utf-8'。常用的还有'gbk'、'ascii'、'utf-16'等。errors:指定当字符无法按目标编码进行转换时的异常处理策略,默认为'strict'(严格模式,抛出异常)。
【基础示例】将中文文本编码为 UTF-8 与 GBK 字节流:
# 准备原始字符串
text = "中国"

# 1. 默认或显式使用 UTF-8 编码
bytes_utf8 = text.encode("utf-8")
print(bytes_utf8)
# 输出示例:b'\xe4\xb8\xad\xe5\x9b\xbd'
print(type(bytes_utf8))
# 输出示例:<class 'bytes'>
print("UTF-8 字节长度:", len(bytes_utf8))
# 输出示例:UTF-8 字节长度: 6(UTF-8 中常见汉字通常占 3 字节)

# 2. 使用 GBK 编码
bytes_gbk = text.encode("gbk")
print(bytes_gbk)
# 输出示例:b'\xd6\xd0\xb9\xfa'
print("GBK 字节长度:", len(bytes_gbk))
# 输出示例:GBK 字节长度: 4(GBK 中常见汉字占 2 字节)
2. 使用 decode 将字节串还原为字符串
decode 是定义在 bytes 类上的方法,用于将底层的二进制流解析回 Python 字符串:
bytes.decode(encoding='utf-8', errors='strict')【基础示例】用正确的规则解码字节串:
# 获得前一步生成的 UTF-8 字节串
raw_bytes = b'\xe4\xb8\xad\xe5\x9b\xbd'

# 使用对应的 utf-8 解码
recovered_text = raw_bytes.decode("utf-8")
print(recovered_text)
# 输出示例:中国
print(type(recovered_text))
# 输出示例:<class 'str'>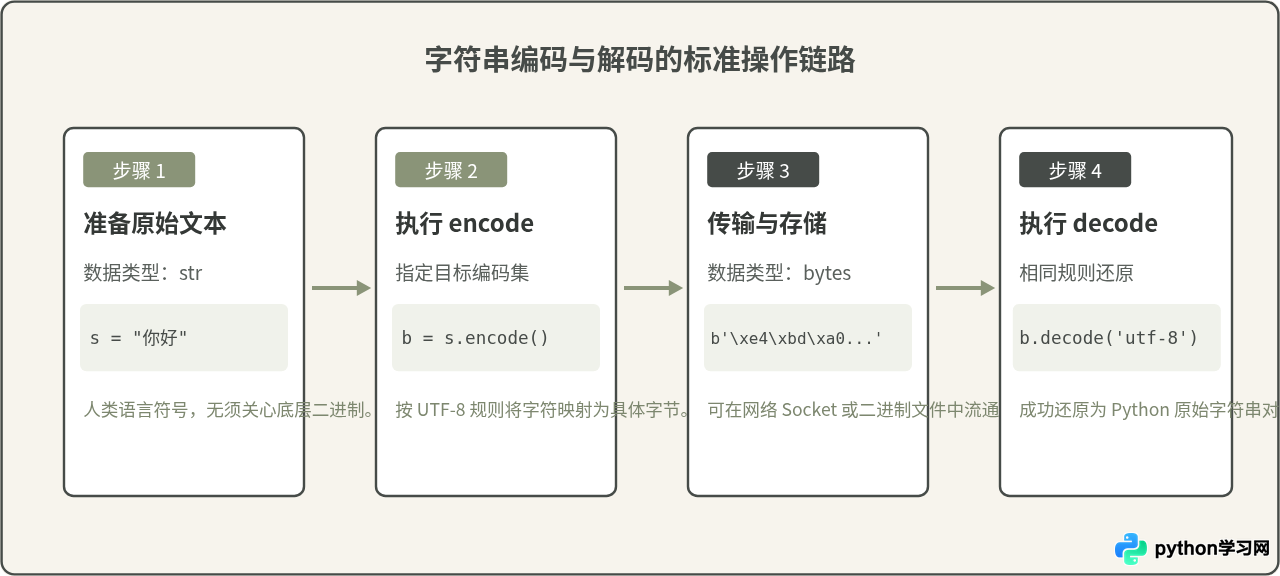
三、异常处理:errors 参数的四种策略
在实际生产环境中,外部输入的数据往往不纯净,可能夹杂损坏的字节、截断的数据包或混合编码。当解析遇到非法字节时,默认的 errors='strict' 会触发 UnicodeDecodeError 并中断程序。
Python 为 encode 和 decode 提供了灵活的 errors 参数,支持以下四种主要处理策略:
| 策略值 | 行为说明 | 适用场景 |
|---|---|---|
'strict'(默认) |
遇到非法字符或字节时立即抛出异常(如 UnicodeDecodeError) | 对数据完整性要求极高、不允许任何静默丢失的场景 |
'ignore' |
静默跳过并丢弃无法识别的字符或字节 | 抓取网络爬虫日志、粗粒度清洗文本、允许少量丢字 |
'replace' |
用特定的占位字符替代异常部分(解码时用 ?) |
展示不确定编码的外部日志、网页内容排版兼容 |
'backslashreplace' |
保留转义序列(形如 \x.. 或 \u....),不丢失原始字节信息 |
调试排错、底层协议分析、追踪异常字节位置 |
【代码示例】处理损坏字节流时的不同策略行为:
# 构造一个损坏的字节串:合法字母 'A' + 畸变不完整字节 0xff + 合法字母 'B'
corrupted_bytes = b'A\xffB'

# 1. 默认 strict 模式:报错
try:
    corrupted_bytes.decode('utf-8')
except UnicodeDecodeError as err:
    print("strict 模式捕获异常:", err)
    # 输出示例: strict 模式捕获异常: 'utf-8' codec can't decode byte 0xff in position 1: invalid start byte

# 2. ignore 模式:静默忽略非法字节
res_ignore = corrupted_bytes.decode('utf-8', errors='ignore')
print("ignore 结果:", res_ignore)
# 输出示例: ignore 结果: AB

# 3. replace 模式:用替换符  占位
res_replace = corrupted_bytes.decode('utf-8', errors='replace')
print("replace 结果:", res_replace)
# 输出示例: replace 结果: AB

# 4. backslashreplace 模式:保留转义符
res_backslash = corrupted_bytes.decode('utf-8', errors='backslashreplace')
print("backslashreplace 结果:", res_backslash)
# 输出示例: backslashreplace 结果: A\xffB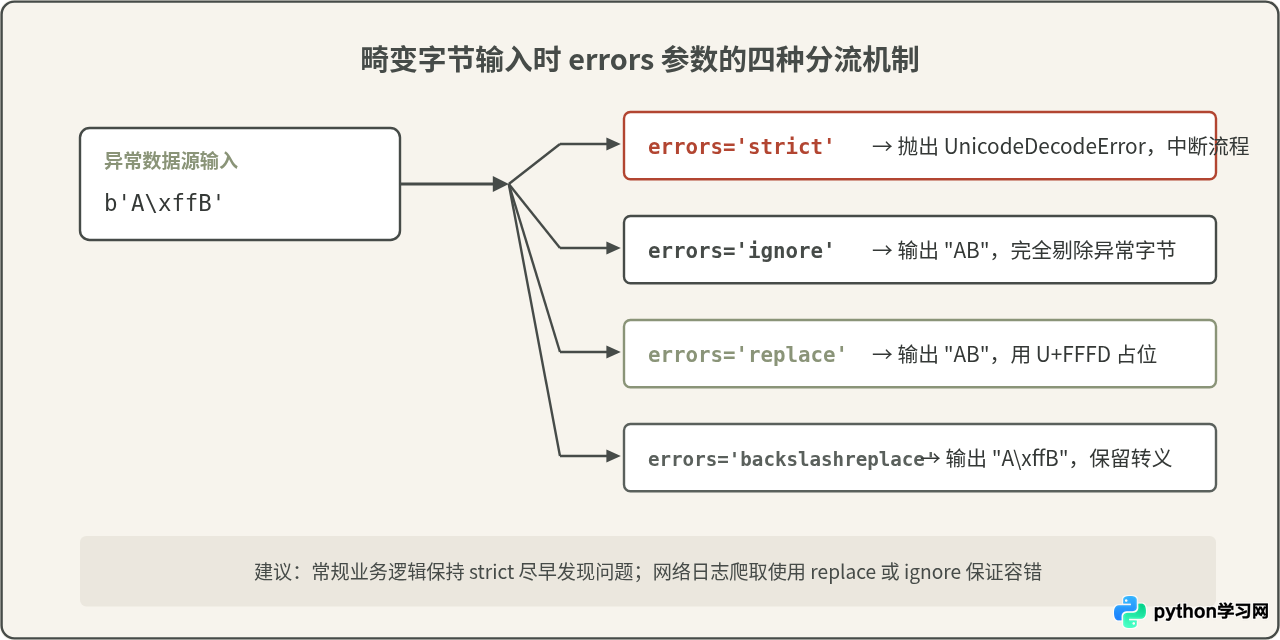
四、容易混淆的认知误区与排查清单
在实际编写 Python 脚本时,有几个关于编解码的常见说法和操作陷阱,经常困扰新手:
1. 误区辨析:“能否对字符串直接调用 decode()?”
现象:在 Python 2 中,str 既可以 encode() 也可以 decode(),因为 Python 2 的默认字符串其实就是字节序列。但在 Python 3 中,尝试对 str 对象调用 decode() 会直接引发属性错误:
s = "测试"
s.decode('utf-8')
# AttributeError: 'str' object has no attribute 'decode'
修正认知:在 Python 3 中,decode 只属于 bytes 对象,encode 只属于 str 对象。字符串已经是解码后的形态,不能也不需要再次解码。
2. 误区辨析:“乱码是因为 Python 内部出了 bug?”
现象:在 Windows 中读取 GBK 编码的文件或控制台输出时,常出现类似 æµè¯ 或 的字符。
根本原因:乱码本质是编码器与解码器协商不一致。例如用 UTF-8 的规则去解析 GBK 生成的两个字节,或者把一个字节集误当成了 Latin-1。只要统一输入输出通道的编码声明(优先使用 UTF-8),乱码问题自然迎刃而解。
3. 文件读写中的“隐式编解码”
在处理文本文件时,很多人并不知道 open() 函数在底层自动替我们完成了 encode 和 decode:
# 写入文本文件时,系统自动将 str 进行 encode('utf-8')
with open("example.txt", "w", encoding="utf-8") as f:
    f.write("保存一段文本")

# 读取文本文件时,系统自动将 bytes 进行 decode('utf-8')
with open("example.txt", "r", encoding="utf-8") as f:
    content = f.read()  # 读取到的是 str 类型

# 如果以二进制模式读取 ("rb"),拿到的是原始 bytes,此时需要手动 decode
with open("example.txt", "rb") as f:
    raw_data = f.read()  # 得到 bytes
    manual_str = raw_data.decode("utf-8")
五、全景速查与总结
为了在日常开发中随时查阅,以下总结了 Python 字符串与字节编解码的核心对照知识体系:
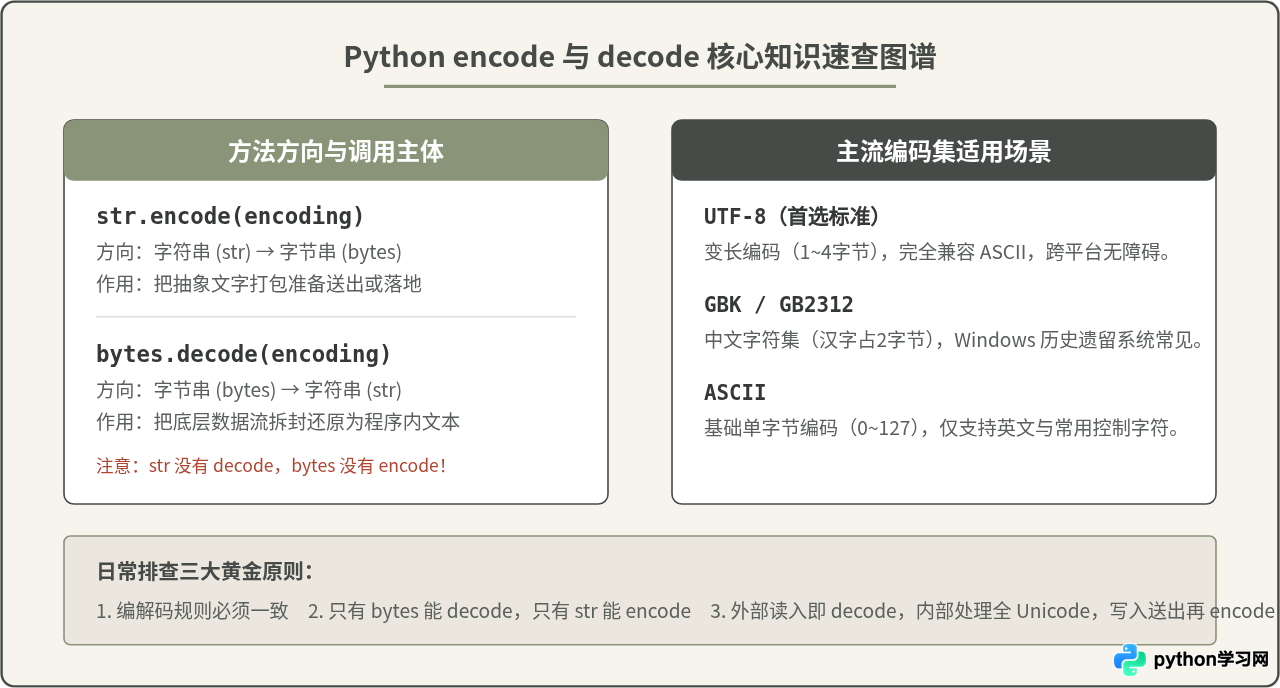
总结而言,在 Python 中处理字符编码的核心,在于理清当前操作的对象究竟是逻辑上的字符(str)还是物理上的字节(bytes)。牢记“字符串用 encode() 变成字节,字节用 decode() 还原为字符串”,并在出入口处保持编码格式一致,就能彻底规避绝大多数编码报错与乱码问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









