

Python数据分析库怎么选?NumPy、Pandas与Matplotlib功能区别解析
深入解析Python数据分析三大核心库NumPy、Pandas与Matplotlib的功能定位、底层数据结构差异与选型决策逻辑,帮助开发者根据实际场景高效组合使用。
在Python数据科学体系中,选择NumPy、Pandas还是Matplotlib并非互斥的“三选一”,而是取决于任务在数据流水线中所处的环节:NumPy提供底层多维同构数组与高速数值计算,Pandas负责异构表格数据的清洗、变形与对齐统计,Matplotlib则承担探索性分析与最终报表的数据可视化呈现。理解三者的分工边界与协作关系,是构建高效分析工作流的前提。
一、三大核心库的分工定位与协作架构
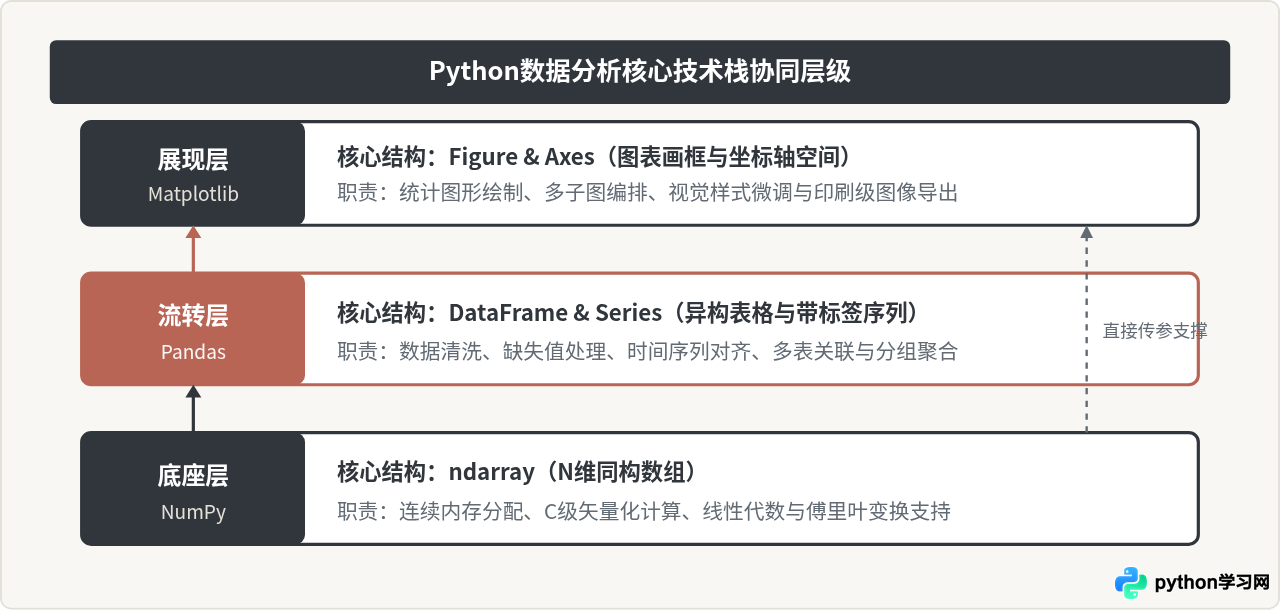
许多初学者容易产生困惑,认为三个库都在处理数据,功能存在大量重叠。实际上,它们各自解决的是数据处理链条上不同抽象层级的问题:
- NumPy(底层计算引擎):核心对象是
ndarray。它使用连续的C语言内存块存储单一数据类型(同构数据),绕过了Python原生对象的额外内存开销,通过预编译的C函数实现高效的向量化与广播运算。它是科学计算、机器学习与高维矩阵运算的基础基石。 - Pandas(业务数据处理枢纽):核心对象是
Series(单列带索引数据)与DataFrame(二维表格数据)。Pandas在内部直接以NumPy数组作为底层存储介质,但向上封装了灵活的行列标签、自动对齐机制、缺失值处理以及强大的分组聚合(Split-Apply-Combine)能力,专为处理现实中常见的异构业务数据而设计。 - Matplotlib(可视化表达层):核心对象是
Figure(画布)与Axes(坐标系图表)。它接受NumPy数组或Pandas序列作为数据输入,负责将数值映射为折线、散点、柱状图或热力图等视觉几何图元,为分析结论提供清晰直观的表达形式。
二、核心特性与数据模型对比
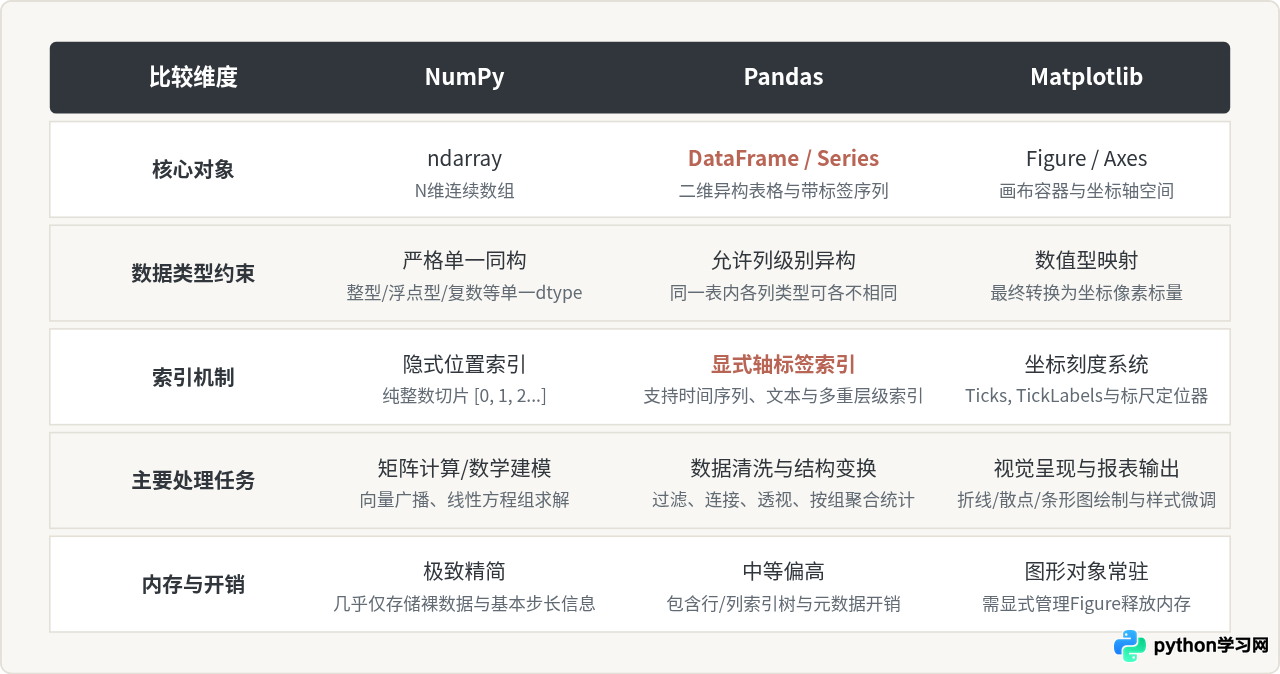
为了精准区分何时采用哪个库,需要从数据结构、数据类型要求、索引支持以及性能开销等维度进行细致比对:
- 数据齐次性(Homogeneity):NumPy数组要求同一个
ndarray内的所有元素必须是完全相同的数据类型(如统一的float64或int32)。这种约束使得NumPy可以直接计算内存步长(strides),实现极速步进切片。而Pandas的DataFrame每列可以拥有独立的类型(一列为时间戳,一列为文本,一列为浮点数),天然契合关系型数据库和电子表格模型。 - 显式索引与对齐能力:NumPy依靠隐式的从零递增的整数位置下标进行索引。Pandas则引入了显式轴标签(
Index),两张表在进行加减乘除时,Pandas会自动根据标签对齐数据,不存在对应标签的位置自动填充NaN,避免了位置错位导致的运算灾难。 - 内存占用与运行效率:处理相同的纯数值矩阵时,NumPy占用的内存通常比Pandas低20%到40%,且由于没有标签维护和元数据检查,数值纯运算耗时显著低于Pandas。但在做非数值列筛选、字符串清洗和条件聚合时,Pandas的内置矢量化方法开发效率和运行效率兼顾得更好。
三、具体代码范式与执行示例
通过一段典型的业务场景,可以直观观察三个库在代码层面的配合方式。假设我们有一批每日销售数据,需要完成:数值标准化计算、按分类聚合销售总额,以及绘制趋势柱状图。
1. 完整配合工作流示例
# 执行环境:Python 3.9+,已安装 numpy, pandas, matplotlib
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 步骤一:使用 Pandas 构建结构化异构数据表
raw_data = {
    'date': pd.date_range(start='2026-10-01', periods=5, freq='D'),
    'category': ['电子', '家居', '电子', '办公', '家居'],
    'sales_volume': [120, 85, 140, 60, 95],
    'unit_price': [199.0, 49.5, 299.0, 15.0, 89.0]
}
df = pd.DataFrame(raw_data)

# 步骤二:利用 NumPy 向量化底层能力快速计算营收总额及对数收益
# 底层直接以向量化广播完成乘法,无需 Python for 循环
df['revenue'] = df['sales_volume'].to_numpy() * df['unit_price'].to_numpy()
df['log_revenue'] = np.log1p(df['revenue'])

# 步骤三:利用 Pandas 进行业务聚合计算
summary = df.groupby('category')['revenue'].sum().reset_index()

# 步骤四:利用 Matplotlib 将统计结果可视化
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.bar(summary['category'], summary['revenue'], color='#B96555', width=0.5)

ax.set_title('各品类总营收统计', fontsize=14, pad=12)
ax.set_xlabel('商品分类', fontsize=12)
ax.set_ylabel('营收金额 (元)', fontsize=12)
ax.grid(axis='y', linestyle='--', alpha=0.6)

# 保存图形为图片文件或在交互式环境中呈现
plt.tight_layout()
plt.savefig('category_revenue.png', dpi=150)
plt.close()
示例输出结果如下:
# 终端输出 summary 的计算结果(示例):
  category  revenue
0       家居   12662.5
1       办公     900.0
2       电子   65740.0
四、场景选型决策指南
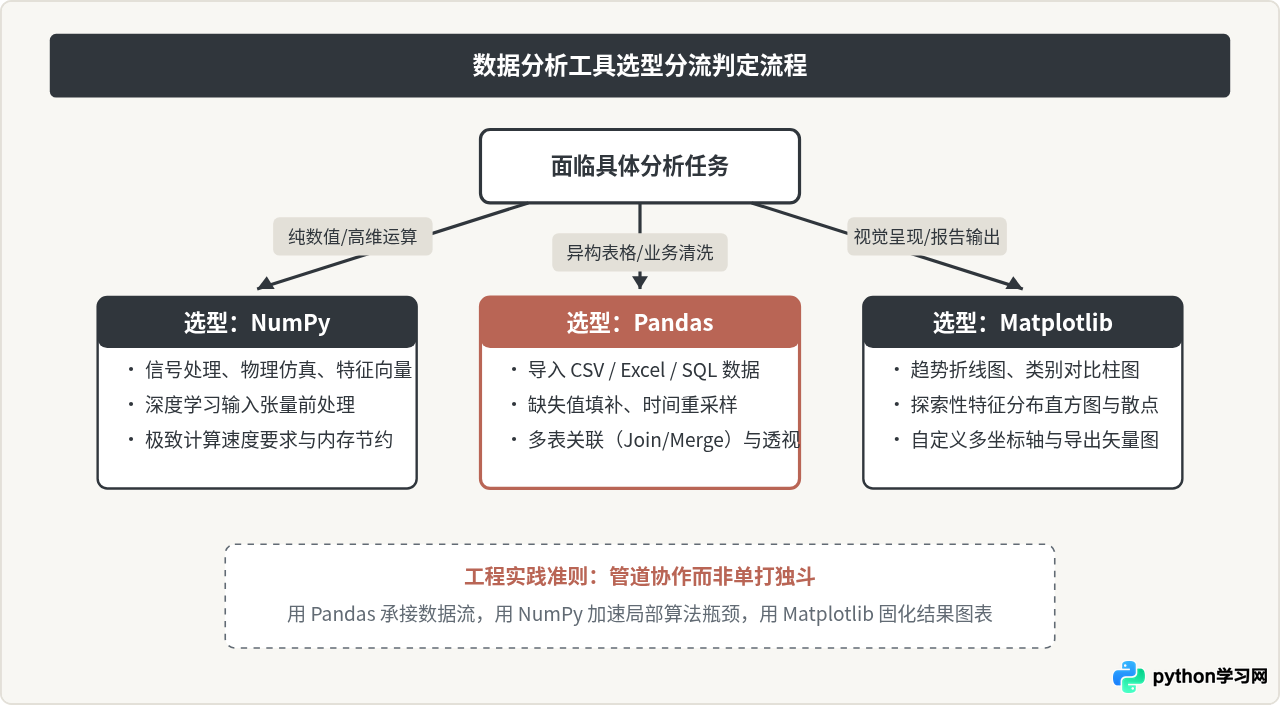
面对具体的数据分析任务时,遵循以下判断路径,可以快速锁定应当主要使用的工具库:
- 若任务输入为纯数值高维张量、信号采样点或图像矩阵:直接选 NumPy。例如图像滤波(三维RGB矩阵切片运算)、线性回归公式推导 $\beta = (X^T X)^{-1} X^T y$、快速傅里叶变换(FFT)或蒙特卡洛随机模拟。引入Pandas只会徒增内存消耗与索引寻址延迟。
- 若任务输入包含表格文件(CSV、Excel、SQL查询结果),且包含字符串、时间戳、缺失值:首选 Pandas。它提供了高效的
read_csv()、read_sql()接口,以及专用的日期解析器。数据清洗中的fillna()、drop_duplicates()、merge()、pivot_table()均能在几行内稳定完成。 - 若任务目标是输出可交付的图表、探索特征分布或撰写报告:使用 Matplotlib。尽管Pandas提供了
df.plot()便捷包装方法,但底层调用的依旧是Matplotlib。对于多图联动、自定义图例位置、双Y轴展示、精确网格控制等精细化排版需求,必须直接使用Matplotlib的对象式API(fig, ax = plt.subplots())。
五、常见开发误区与性能排坑
无论是使用NumPy还是Pandas,最忌讳使用 for row in df.iterrows(): 或 for i in range(len(arr)): 进行逐行计算。逐行遍历会使每次操作都回退到Python虚拟机的动态类型检查,运算速度相差数十至上百倍。应始终坚持向量化操作(Vectorization)或调用 np.where() 等内置分支函数。
在日常开发中,以下误区同样值得重视:
- 误区一:把纯数值的密集型运算硬塞入 Pandas。当处理十亿次浮点矩阵乘法或频繁小切片时,Pandas维护的索引结构会带来不可忽视的时间和内存负担。此时应调用
df.to_numpy()剥离外壳,下沉到纯NumPy层完成计算,计算完毕后再挂载回DataFrame。 - 误区二:在 Matplotlib 中进行复杂数据清洗。Matplotlib是纯粹的渲染引擎,不负责数据对齐和缺失值智能过滤。如果在传给
ax.plot()的数据中包含未清洗的脏数据或未排序的时间戳,图形会出现严重飞线或刻度混乱。正确做法是在Pandas中完成sort_values()和dropna()后再传入绘图。 - 误区三:忽略 Matplotlib 的内存清理。在批量循环生成大量图表并保存时,若只调用
plt.savefig()而未调用plt.close(fig),已生成的Figure对象会持续驻留在内存中,最终导致内存溢出。
六、选型原则总结
综上所述,Python数据分析三大库并不是竞争对手,而是高度互补的生态拼图:
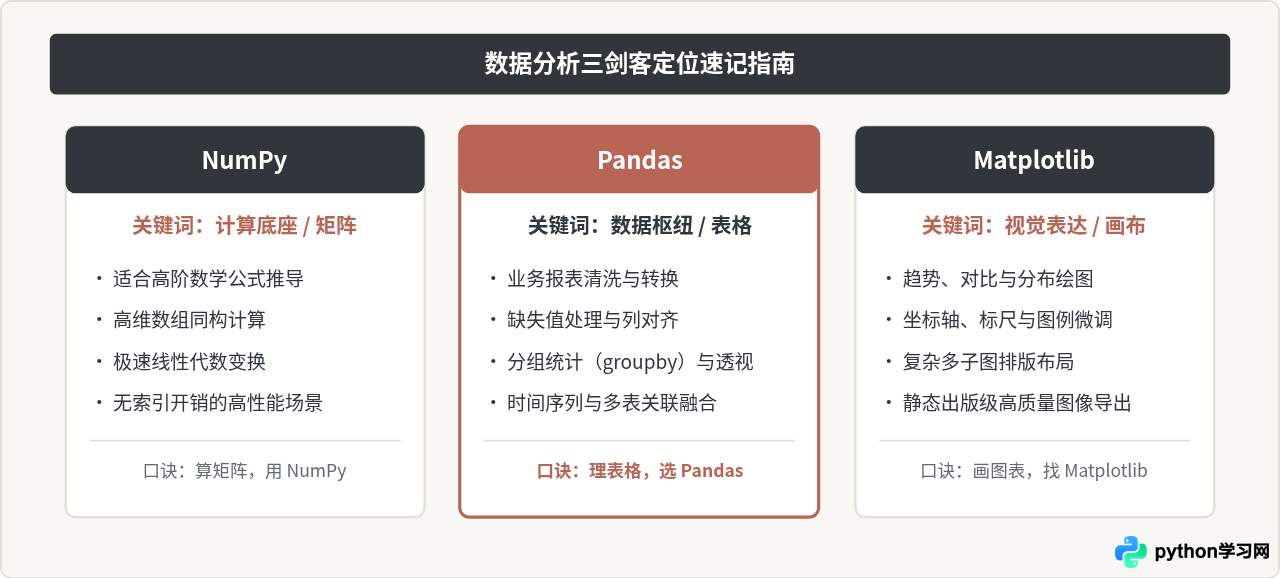
在实际工程中,最合理的架构往往是将三者结合:以 Pandas 承接外部数据并完成业务级清洗,在遇到计算密集型算法时将列提取为 NumPy 数组享受底层加速,最后通过 Matplotlib 将核心指标生成可视化报表。明确每个库的能力边界,才能写出既简洁又高效的分析代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









