

Python数据分析常用库清单:NumPy、Pandas与Matplotlib
系统梳理Python数据分析中最核心的三大基础库:NumPy、Pandas与Matplotlib,深入讲解各自职责边界、核心数据结构、典型操作语法及协同工作流。
在Python数据分析技术体系中,NumPy、Pandas与Matplotlib被并称为最基础且不可或缺的核心三件套。无论处理科研实验数据、金融交易流水还是互联网用户行为日志,几乎所有高阶算法框架与业务分析平台都建立在它们之上。本文逐一解析这三个库的定位边界、核心数据结构与高频用法,并通过可复现的完整代码演示它们如何分工协作完成一次标准的数据分析任务。
一、三大核心库的定位与协作关系
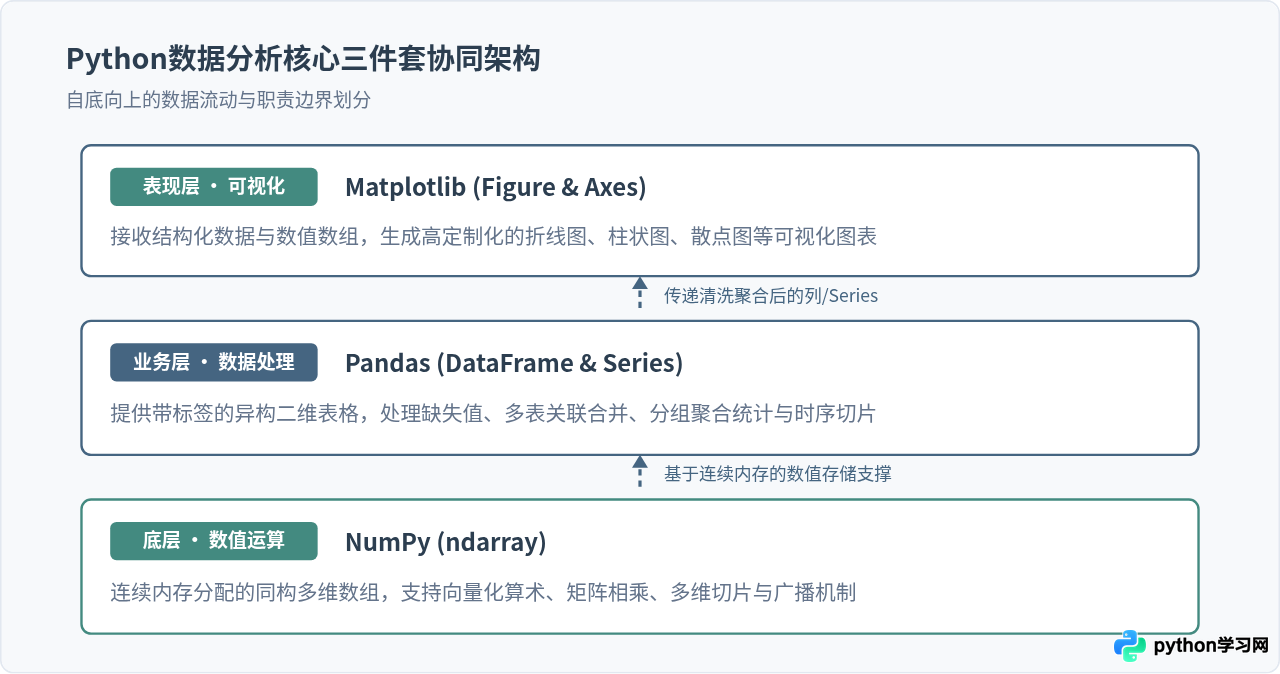
进行数据分析时,面对的数据形式各异,处理阶段也各不相同。三者有着清晰的分工:NumPy提供底层紧凑的多维数组和快速数值运算;Pandas在上层提供面向业务的表格型数据结构与丰富清洗工具;Matplotlib则负责将最终的数值或聚合结果转换为直观图表。
二、NumPy:高性能数值计算基石
NumPy(Numerical Python)是Python数值计算生态的基石。Python原生列表虽然灵活,但内部保存的是指向对象的指针引用,内存分布散乱且计算时存在动态类型检查开销。NumPy的核心创新在于引入了 ndarray(N-dimensional Array,N维数组)。
1. 核心特性
- 连续内存排布:ndarray中的所有元素必须是相同数据类型(如 float64 或 int32),元素紧凑存放在一块连续物理内存中。
- 向量化计算(Vectorization):无需编写显式 Python
for循环,直接对整个数组执行算术运算,底层由高度优化的C语言循环实现。 - 广播机制(Broadcasting):在符合维度对齐规则的前提下,允许不同形状的数组直接进行数学运算。
2. 典型操作示例
import numpy as np

# 1. 数组创建
data = np.array([12.5, 18.2, 14.8, 22.0, 19.6], dtype=np.float64)
grid = np.arange(1, 10).reshape((3, 3))

# 2. 向量化算术计算(所有元素统一换算并增加基准值)
adjusted = (data * 1.05) + 2.0

# 3. 统计计算
mean_val = np.mean(adjusted)
std_val = np.std(adjusted)

print("原始网格矩阵:\n", grid)
print("换算后数组:", np.round(adjusted, 2))
print("均值:", round(mean_val, 2), "标准差:", round(std_val, 2))[[1 2 3]
[4 5 6]
[7 8 9]]
换算后数组: [15.12 21.11 17.54 25.1 22.58]
均值: 20.29 标准差: 3.49
NumPy数组创建后,其长度是固定的。频繁使用 np.append() 或 np.concatenate() 会导致整个数组被反复重新分配和拷贝,严重拖慢执行速度。如果需要动态扩充元素,应优先使用原生Python列表收集完成后一次性转为ndarray。
三、Pandas:结构化表格数据清洗与分析
NumPy非常适合纯数值矩阵,但现实世界的数据往往包含文本、日期、类别等多种异构类型,且每行每列需要有明确的业务名称。Pandas正是为解决这类表格化数据处理而生,提供了 Series 与 DataFrame 两个核心数据结构。
1. 核心数据结构
- Series:带标签的一维同构数组,类似于带自定义索引的字典或单列数据。
- DataFrame:由多个共享相同行索引的 Series 组成的二维表格,每一列可以有不同的数据类型。
2. 典型操作示例
import pandas as pd
import numpy as np

# 1. 构建示例销售明细表
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "category": ["电子", "家居", "电子", "办公", "家居"],
    "sales": [2999.0, np.nan, 4599.0, 320.0, 1280.0],
    "quantity": [1, 2, 3, 5, 2]
}
df = pd.DataFrame(raw_data)

# 2. 缺失值填充(使用该分类中位数值或固定值修复)
df["sales"] = df["sales"].fillna(df["sales"].median())

# 3. 衍生计算:计算单笔总金额
df["total_amount"] = df["sales"] * df["quantity"]

# 4. 分组聚合统计(Group By)
summary = df.groupby("category").agg(
    total_sales=("total_amount", "sum"),
    avg_quantity=("quantity", "mean")
).reset_index()

print("清洗后订单表:\n", df[["order_id", "category", "sales", "total_amount"]])
print("\n品类汇总统计:\n", summary)order_id category sales total_amount
0 1001 电子 2999.0 2999.0
1 1002 家居 2139.5 4279.0
2 1003 电子 4599.0 13797.0
3 1004 办公 320.0 1600.0
4 1005 家居 1280.0 2560.0
品类汇总统计:
category total_sales avg_quantity
0 办公 1600.0 5.0
1 家居 6839.0 2.0
2 电子 16796.0 2.0
在对筛选切片后的DataFrame进行修改时,容易触发 SettingWithCopyWarning 警告。这是由于操作对象可能是原数据视图(View)而非独立副本(Copy)。应当显式使用 .loc[row_indexer, col_indexer] = value 进行按标签赋值,或在筛选后调用 .copy() 创建独立对象。
四、Matplotlib:数据可视化呈现
数据经过清洗与统计后,图表是传达结论最直观的载体。Matplotlib是Python中最经典的2D绘图库,几乎所有更高级的可视化库(如Seaborn)都在底层对其进行了封装。掌握Matplotlib的对象模型,能够实现对画布各细节的精准控制。
1. 核心绘图模型
Matplotlib有两种编程范式:一种是类似MATLAB的状态机范式(通过 plt.plot() 直接绘图);另一种是推荐在工程项目中使用的面向对象范式:
- Figure(画布):整个可视区域的顶级容器,包含所有的子图坐标系、图例和总标题。
- Axes(子图/坐标系):真正用于绘制线条、柱子、标记及刻度轴的矩形区域。一个Figure中可以包含一个或多个Axes。
2. 面向对象绘图示例
import matplotlib.pyplot as plt

# 解决中文显示与负号正常显示问题
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 1. 准备数据
months = ["1月", "2月", "3月", "4月", "5月"]
sales_a = [35, 42, 48, 55, 68]
sales_b = [28, 30, 36, 42, 50]

# 2. 面向对象创建画布与子图
fig, ax = plt.subplots(figsize=(8, 4), dpi=100)

# 3. 绘制折线与样式配置
ax.plot(months, sales_a, marker="o", color="#456581", label="产品A销量")
ax.plot(months, sales_b, marker="s", color="#438A80", linestyle="--", label="产品B销量")

# 4. 设置轴标签、标题与网格
ax.set_title("上半年产品月度销量对比", fontsize=14, pad=12)
ax.set_xlabel("月份")
ax.set_ylabel("销售额 (万元)")
ax.grid(True, linestyle=":", alpha=0.6)
ax.legend(frameon=True)

# 5. 调整布局并导出/展示
plt.tight_layout()
# plt.savefig("sales_comparison.png")
plt.show()
五、三库协同实战流水线:从原始数据到分析看板
在实际业务工程中,数据分析不是孤立使用某个库,而是按照流水线规范依次流转。下图清晰展示了端到端处理的标准四步工序及各库的参与环节:
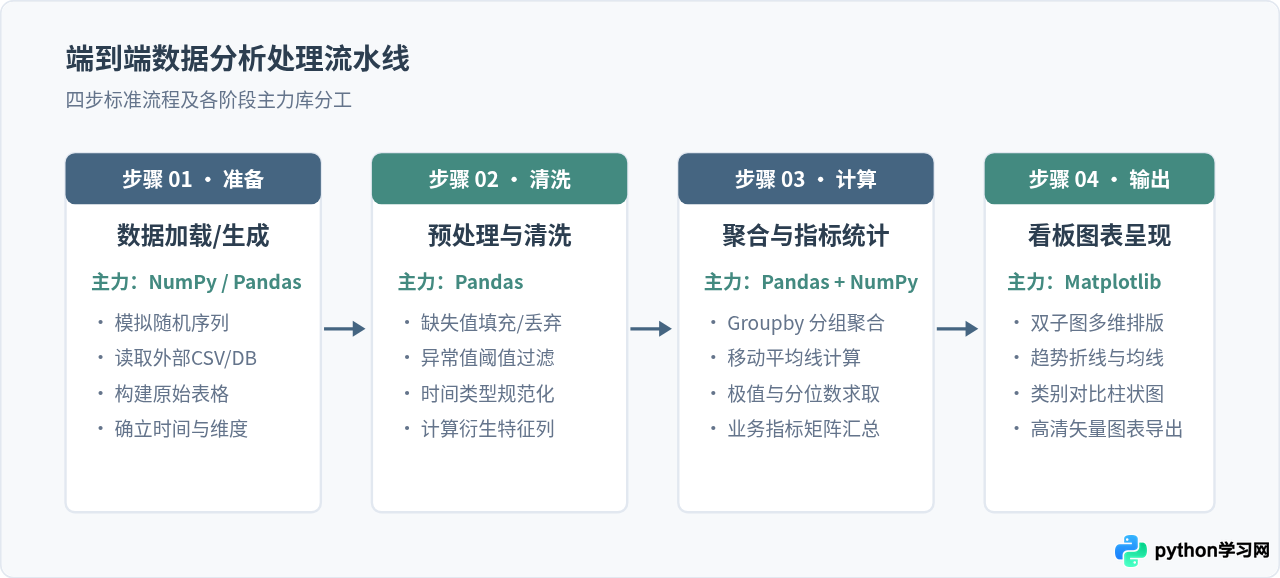
下面给出一个能够直接运行的完整实战脚本,串联从模拟生成、清洗平滑到双子图可视化的完整链路:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# -------------------------------------------------------------
# 步骤 1:利用 NumPy 生成模拟时序数据(包含趋势、正弦周期与随机噪声)
# -------------------------------------------------------------
np.random.seed(42)
days = 90
dates = pd.date_range(start="2024-01-01", periods=days, freq="D")

trend = np.linspace(50, 120, days)
seasonality = 15 * np.sin(np.linspace(0, 4 * np.pi, days))
noise = np.random.normal(0, 5, days)
sales_values = trend + seasonality + noise

# 构造人为缺失值与异常点以测试清洗能力
sales_values[15] = np.nan
sales_values[45] = 250.0  # 明显偏离常态的偶发异常录入

# -------------------------------------------------------------
# 步骤 2:利用 Pandas 封装为 DataFrame 并执行清洗与特征工程
# -------------------------------------------------------------
df = pd.DataFrame({"date": dates, "raw_sales": sales_values})
df.set_index("date", inplace=True)

# 修复缺失值:使用前后线性插值
df["cleaned_sales"] = df["raw_sales"].interpolate(method="linear")

# 剔除超限异常值并平滑处理
threshold = df["cleaned_sales"].quantile(0.98)
df.loc[df["cleaned_sales"] > threshold, "cleaned_sales"] = threshold

# 计算 7 日移动平滑均线 (Rolling Mean)
df["rolling_7d"] = df["cleaned_sales"].rolling(window=7, min_periods=1).mean()

# 按月份重采样统计月度汇总指标
monthly_summary = df["cleaned_sales"].resample("ME").agg(
    total_sales="sum",
    avg_sales="mean"
)
monthly_summary.index = monthly_summary.index.strftime("%Y年%m月")

# -------------------------------------------------------------
# 步骤 3:利用 Matplotlib 面向对象机制绘制双子图分析看板
# -------------------------------------------------------------
fig, (ax1, ax2) = plt.subplots(nrows=2, ncols=1, figsize=(10, 8), dpi=100)

# 子图 1:日销售趋势与平滑均线
ax1.plot(df.index, df["cleaned_sales"], label="日销售额 (实际清洗后)", color="#64748B", alpha=0.6, linewidth=1.2)
ax1.plot(df.index, df["rolling_7d"], label="7日移动平均线", color="#456581", linewidth=2.0)
ax1.set_title("季度日销售额走势与趋势平滑线", fontsize=13)
ax1.set_ylabel("销售额 (千元)")
ax1.grid(True, linestyle=":", alpha=0.6)
ax1.legend(loc="upper left")

# 子图 2:月度总额对比柱状图
bars = ax2.bar(monthly_summary.index, monthly_summary["total_sales"] / 1000, color="#438A80", width=0.45)
ax2.set_title("月度累计销售总额对比", fontsize=13)
ax2.set_ylabel("累计总额 (百万元)")
ax2.grid(True, axis="y", linestyle=":", alpha=0.6)

# 为柱状图添加数值标签
for bar in bars:
    height = bar.get_height()
    ax2.annotate(f"{height:.2f}",
                 xy=(bar.get_x() + bar.get_width() / 2, height),
                 xytext=(0, 3), textcoords="offset points",
                 ha="center", va="bottom", fontsize=10)

plt.tight_layout()
plt.show()
六、核心数据结构与应用场景深度对比
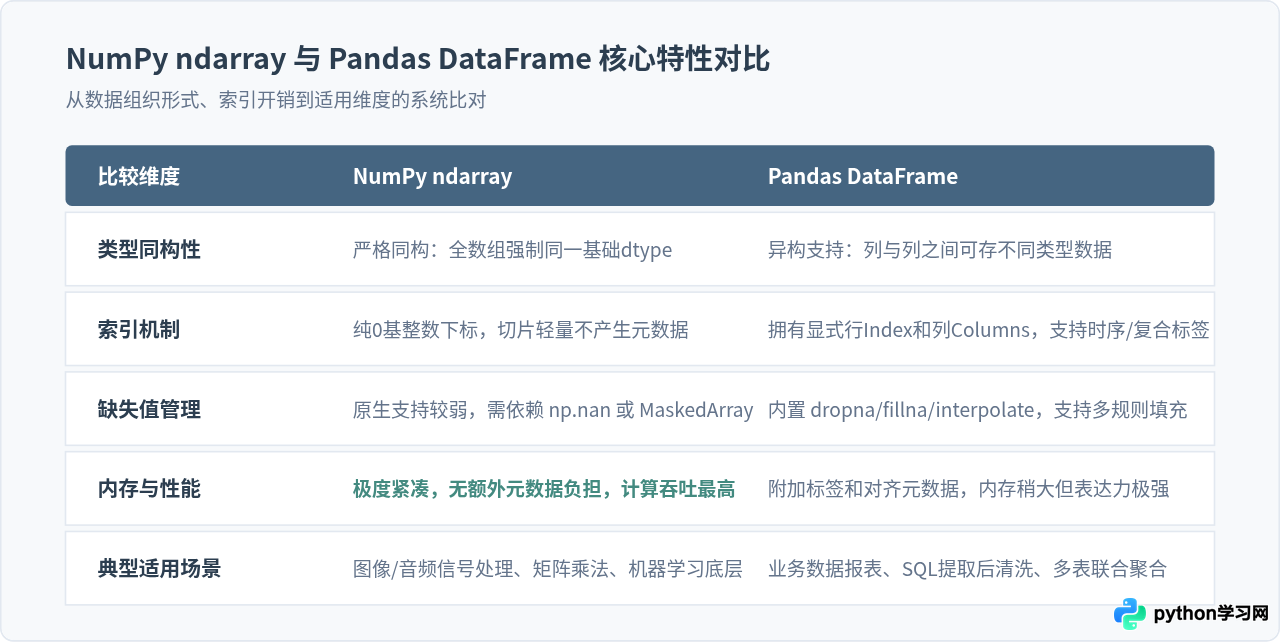
理解这三个库最关键的是看清底层存储与表现特性的异同。在选型时,切忌盲目将所有任务都交给某一个工具,而应依据内存占用、数据异构度与计算形态做出权衡:
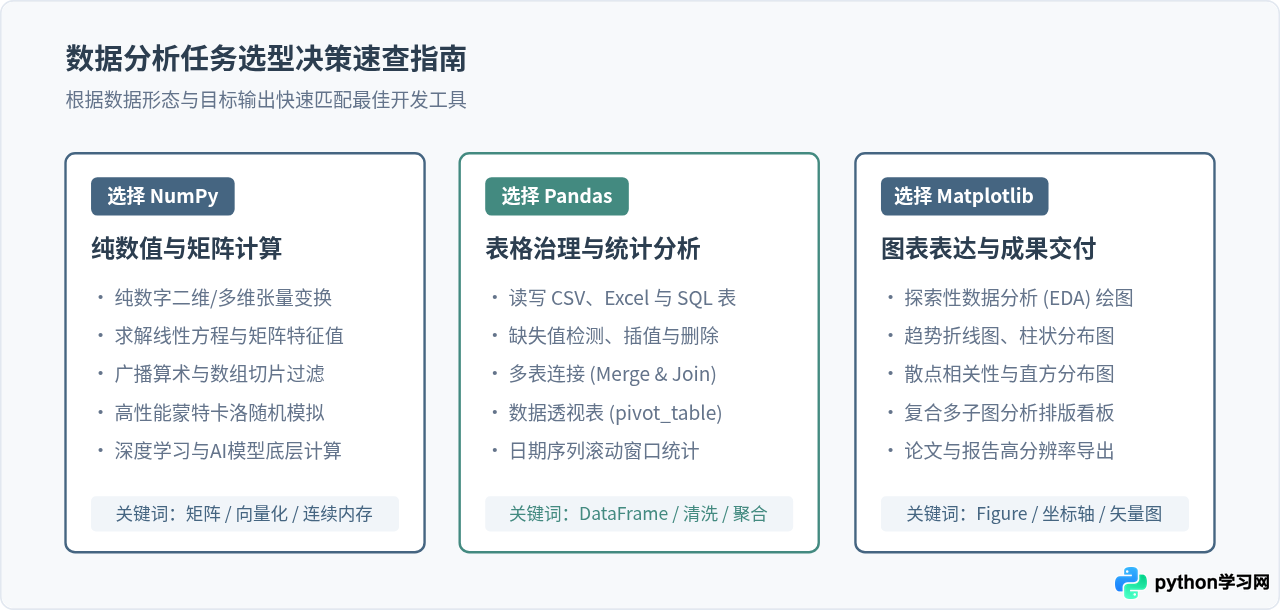
七、日常任务技术选型与操作速查
在面对具体的数据分析任务时,通过下述速查逻辑可以快速决策主力库的使用方案:
总结
NumPy、Pandas与Matplotlib分别占据了数据分析中“底座计算”、“结构清洗”与“视觉呈现”三个核心生态位。在日常分析工作中,遵循“NumPy负责密集计算与底座承载、Pandas负责多源汇聚与规则清洗、Matplotlib负责终态刻画与结论展示”的配合模式,能够以最高的执行效率与清晰的代码逻辑,高质量地推进各项数据分析项目。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









