

网页版Python能运行第三方库吗?在线编程的局限性解析
深入解析网页版Python运行第三方库的底层运行机制、浏览器沙箱与云端容器的架构差异,以及在线编程在数据持久化、系统底层交互与算力配额上的局限性与实用建议。
一、核心判定:两种截然不同的网页版运行架构
很多初学者在使用网页版 Python 时会产生困惑:为什么有的在线编辑器输入 pip install 就能立刻下载使用,而有的平台却直接提示命令不存在,或者在安装某些科学计算库时持续报错?这种差异的根本原因在于,“网页版”仅仅是前端交互界面,其底层的 Python 解释器运行在两个完全不同的位置。
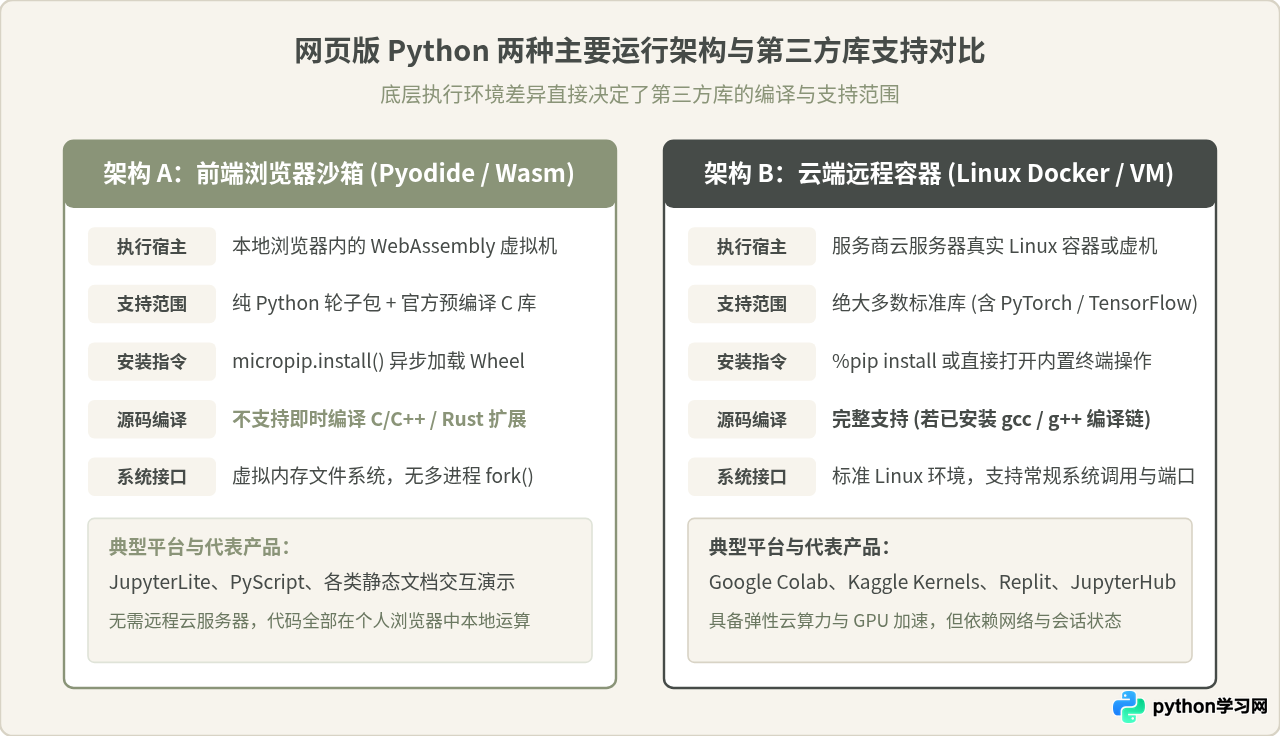
1. 前端浏览器沙箱架构(基于 WebAssembly)
这种架构以 Pyodide 和 JupyterLite 为典型代表。在这种模式下,网页服务器仅负责提供静态 HTML、JavaScript 和编译为 WebAssembly(Wasm)格式的 Python 解释器核心。当你在浏览器中打开网页后,解释器会被整体加载进浏览器的标签页进程中运行。
因为整个运行过程发生在你自己的电脑浏览器内,所以不需要消耗远端服务器的算力。然而,浏览器本身是一个高度受限的安全沙箱:
- 纯 Python 库可以良好运行:只要某个第三方库是用纯 Python 编写的(即在 PyPI 上提供标准的
.whl纯 Python 安装包),就可以被平滑加载。 - 依赖 C/C++ 扩展的库需要特殊预编译:像 NumPy、Pandas、Matplotlib 这类包含底层 C 代码的库,无法在浏览器中即时调用 gcc 进行编译,必须依赖 Pyodide 官方预先用 Emscripten 工具链针对 WebAssembly 架构编译好的专用轮子包。
- 不支持未编译的原生扩展与特定系统库:如果某个库依赖未被预编译的底层 C 库(例如特殊的音频驱动、图形底层库或特定的密码学硬件加速),它就无法在前端浏览器中直接安装使用。
2. 云端远程容器架构(基于 Docker / Linux 虚拟机)
以 Google Colab、Kaggle Kernels 以及国内各类在线 Jupyter 平台为代表。在这类平台中,浏览器仅仅是一个远程展示与交互终端,代码输入后被发送到数据中心的 Linux 容器(如 Docker)中执行,运算完成后再将结果返回给浏览器渲染。
在云端容器架构中,由于底层拥有完整的 Linux 操作系统、GNU 编译工具链以及网络栈,因此它对第三方库的支持能力与在一台本地 Ubuntu 电脑上安装 Python 几乎没有区别,绝大部分标准库都能通过命令行直接下载并编译运行。
二、具体操作:如何在网页版中正确安装与验证第三方库
为了正确安装第三方库,第一步是明确当前所在的环境类型。可以通过在交互单元格中执行平台识别代码来判断:
import sys
print("运行平台平台标识:", sys.platform)
# 若输出为 'emscripten',表明为浏览器本地 WebAssembly 沙箱
# 若输出为 'linux',表明为后端远程 Linux 容器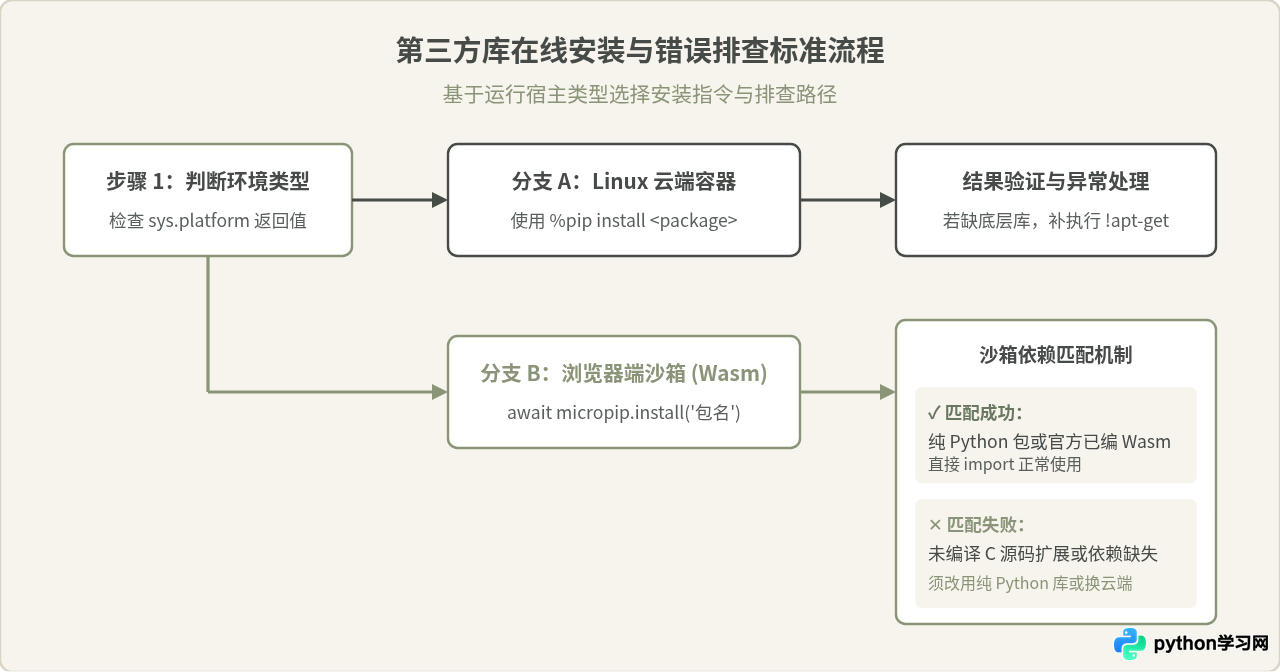
1. 云端容器环境下的安装操作
在以 Notebook 格式呈现的云端环境中(如 Google Colab),最稳妥的安装方式是在代码单元格中使用 %pip 魔法命令:
# 推荐使用 %pip 而非 !pip,确保库安装到当前内核绑定的 Python 环境中
%pip install jieba requests

# 验证安装结果
import jieba
import requests

words = list(jieba.cut("网页版编程环境支持常用分词与网络请求"))
print("分词测试结果示例:", words)
print("Requests 版本号:", requests.__version__)注意区别:虽然输入 !pip install 也可以执行,但感叹号前缀是作为子进程启动系统终端,在某些存在多个 Python 版本并存的容器中,可能导致安装路径与当前执行 Notebook 的内核不一致。因此推荐统一使用 %pip。
2. 浏览器沙箱环境下的安装操作
如果使用的是基于 Pyodide 的轻量环境,传统的 pip 命令行无法直接工作,必须使用专用的包管理工具 micropip 进行异步加载:
import micropip
# 使用 await 异步下载并挂载远端纯 Python 轮子包
await micropip.install('snowballstemmer')

# 导入并验证
import snowballstemmer
stemmer = snowballstemmer.stemmer('english')
print("提取词干测试:", stemmer.stemWords(['running', 'jumps']))
三、常见认知混淆:为什么有些库“能装却不能用”?
在实际操作中,读者往往会遇到一些看似矛盾的现象。理清这些混淆有助于建立对在线编程环境的清晰认识:
原因剖析:很多高级科学计算库、音视频处理库(如特定版本的 OpenCV、FFmpeg 绑定库或 C++ 科学计算库)不仅需要 Python 头文件,还需要系统级的依赖动态库(例如 libgl1-mesa-glx、cmake 或专用的 Fortran 编译器)。如果云端镜像没有提前预装这些底层库,单纯执行 pip install 就会在编译阶段报错中断。在云端环境中,通常需要先在终端或通过 !apt-get update && !apt-get install -y <依赖包> 补齐系统依赖,才能完成构建。
原因剖析:这是由在线容器的“无状态”设计决定的。服务商为了合理分配算力,当你关闭网页或连续一段时间没有交互时,分配给你的容器实例就会被系统自动销毁回收。下次重新连接时,平台会重新启动一个全新的初始镜像。除非你将安装脚本写入初始化引导文件,或者使用支持持久化环境存储的付费工作区,否则所有临时安装的库都会在会话结束时被重置。
open('data.csv') 找不到我电脑桌面上的文件?”原因剖析:不论是浏览器沙箱还是远端容器,Python 脚本都无法穿透安全边界去自由遍历用户物理电脑的本地磁盘。在浏览器端,脚本只能访问基于内存模拟的虚构文件树;在云端,脚本访问的是远程服务器上的临时目录。要读取本地数据,必须先通过网页界面的“上传”按钮将文件推送到在线工作区中,或者通过网盘/对象存储挂载接口加载。
四、在线编程的四大核心局限性深度解析
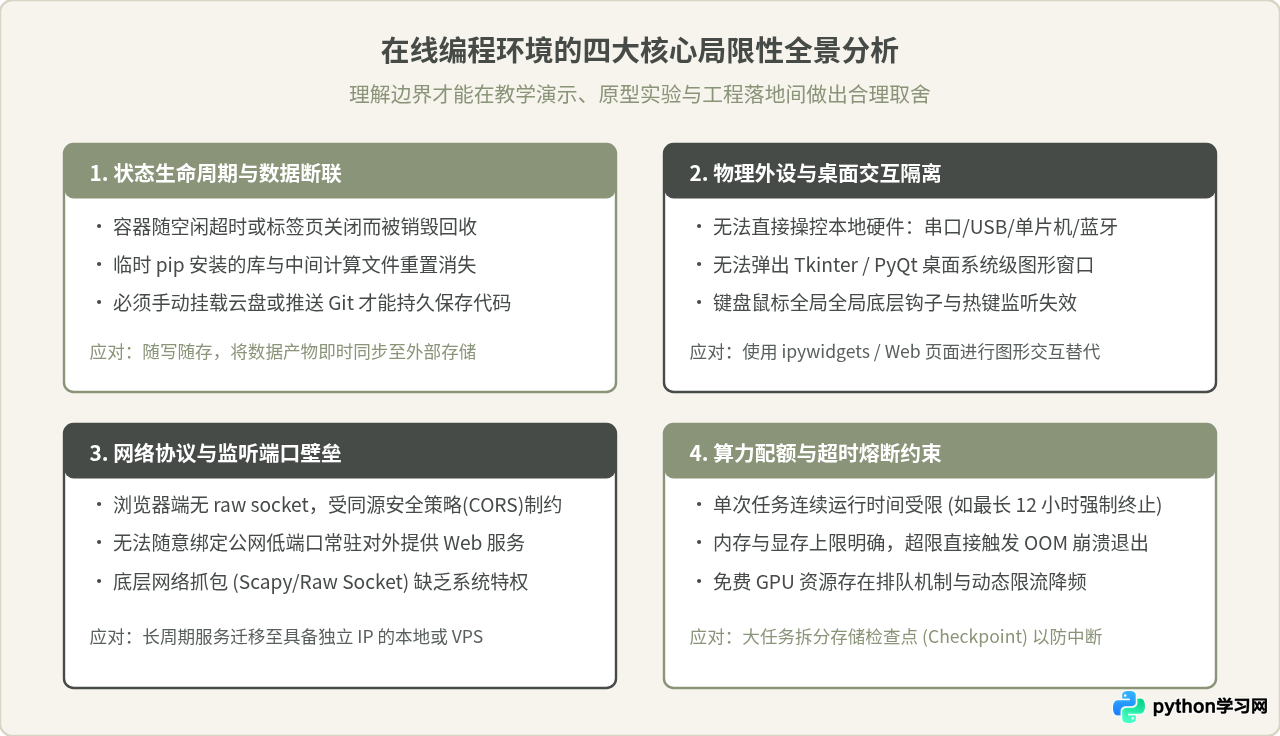
网页版 Python 极大地降低了编程门槛,无需配置本地环境变量,随时随地打开浏览器即可开始编写代码。然而,受限于技术架构与安全模型,在线编程无法完全取代本地开发环境,其核心局限体现在以下四个维度:
1. 文件系统临时性与数据持久化风险
绝大多数公有在线编程环境均采用“按需分配、即用即弃”的虚拟化策略。免费分配的虚拟空间不会长期占用物理存储。一旦用户断网、连续数十分钟未敲击代码,或者总会话达到上限时间,整个容器实例就会被回收清空。这意味着:
- 保存在当前工作目录中的临时脚本、日志或中间模型权重如果不及时同步,将面临永久丢失的风险。
- 每次重新开启实验,通常需要重新跑一遍环境初始化脚本,增加了流程的重复成本。
2. 本地物理硬件与操作系统级交互缺失
Python 在工业自动化、物联网开发、桌面端应用等领域应用广泛,但这些应用严重依赖物理主机接口:
- 外设与端口隔离:无法直接连接插在个人电脑上的 Arduino、树莓派串口或通过 USB 调试 Android 设备。
- 桌面图形界面阻塞:使用
tkinter.Tk()或PyQt5.QtWidgets时,由于在线环境中没有可供弹出的物理显示器 X11/Wayland 窗口句柄,程序会直接报错或假死。 - 系统全局事件不可达:类似
pyautogui控制鼠标连点、监听全局键盘按键等自动化脚本,在线环境无法跨出浏览器容器去操纵用户的本地操作系统。
3. 网络栈限制与安全策略壁垒
在前端浏览器沙箱中,所有的网络请求都必须遵守浏览器的安全规范(同源策略 CORS)。如果你的 Python 代码试图通过 requests.get() 访问一个未开放跨域权限的外部接口,浏览器就会直接在底层拦截,导致请求失败;此外,沙箱内部不支持原始套接字(Raw Socket),无法开发底层网络嗅探或端口扫描工具。
而在云端容器中,虽然容器自身可以主动向外发起 HTTP 请求,但由于处于服务商的 NAT 内网与严格的防火墙安全组之后,你通常无法随意开放 80、8080 等端口来部署长期常驻的对外 Web 服务,必须依赖特定的隧道代理工具。
4. 算力配额硬限制与空闲超时断开
在线平台为了防范滥用,均对资源使用做出了严苛的硬性配额限制:
- 内存上限(OOM):当数据分析任务加载了超过系统上限的超大 CSV 文件时,Linux 内核的 OOM-Killer 会立刻强行终止 Python 进程,导致工作全部丢失。
- 单次执行时长截断:大多数平台限定单次连续运行不得超过一定时长(例如 6 到 12 小时),对于需要跑数天的深度学习预训练或大规模网格搜索任务而言并不适用。
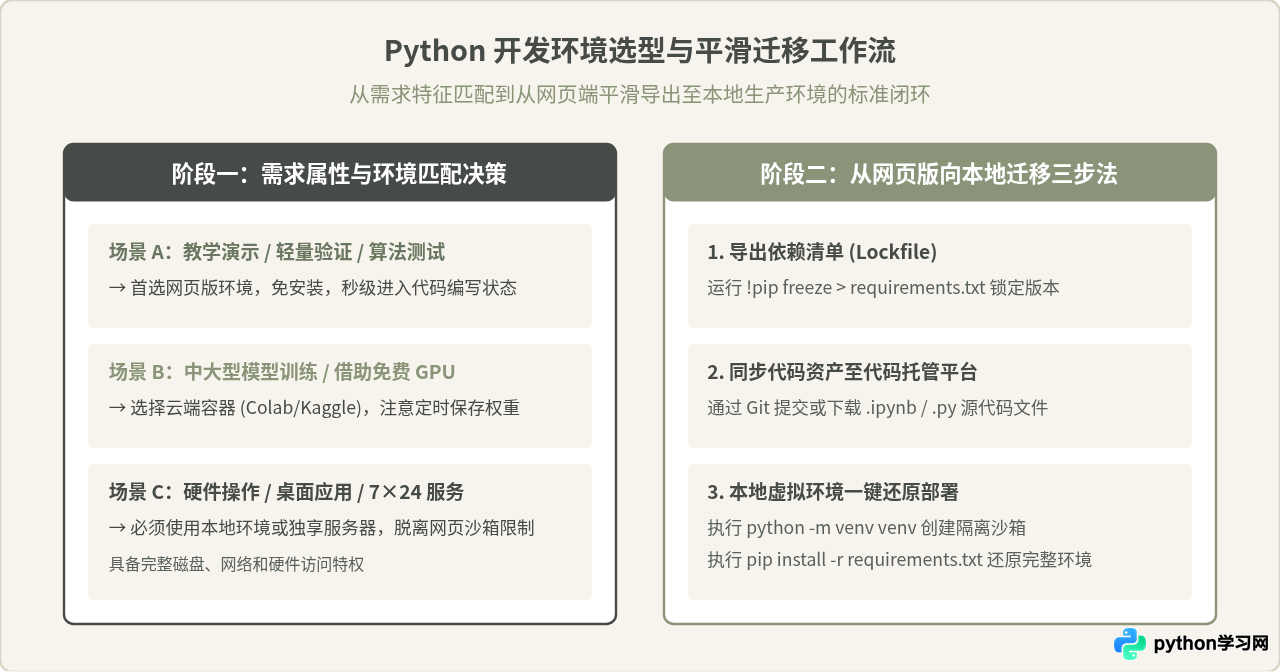
五、选型建议:何时选择在线版,何时必须转回本地开发?
明确了网页版 Python 的运行机制与局限性后,就可以根据具体需求做出科学的技术选型:
| 开发场景 | 推荐环境 | 选择理由与核心优势 |
|---|---|---|
| 初学者语法练习、算法题测试 | 网页版 (Wasm / 简单云端) | 即开即用,零配置负担,免去排查环境变量与安装路径之苦 |
| 团队协作教学、数据分析报表交互 | 在线 Jupyter (如 Colab / Binder) | 富文本与图表直观展示,可一键分享复现他人分析代码 |
| 短期借助 GPU 运行轻量模型实验 | 云端 GPU 容器 (如 Kaggle / Colab) | 利用免费的高性能显卡资源加速短期验证,性价比高 |
| 硬件通信、单片机、物联网开发 | 本地 Python 环境 | 必须通过系统底层驱动直接操作串口、USB 和物理总线 |
| 桌面软件开发 (Tkinter / PyQt) | 本地 Python 环境 | 需要本地操作系统的图形渲染引擎与窗口管理器交互 |
| 长周期常驻服务 (爬虫后台、WebAPI) | 本地电脑或独立 VPS 服务器 | 具备固定公网 IP、7×24 小时不间断运行及稳定的磁盘持久化 |
如何平滑迁移:从网页探索到本地工程化
最推荐的高效实践是将两者结合:在项目的早期构想和探索阶段,利用网页版在线环境快速导入数据、验证算法逻辑、尝试各种轻量第三方库;一旦代码逻辑理顺,准备进入长期运行、工程化部署或涉及硬件对接时,遵循以下步骤平滑迁回本地:
- 导出依赖清单:在网页环境中执行
!pip freeze > requirements.txt,将验证通过的库及其具体版本号导出为文本文件。 - 导出代码:将在线 Notebook 导出为标准的
.py脚本或通过 Git 仓库同步到本地工作区。 - 构建本地隔离环境:在本地终端执行
python -m venv myenv创建独立的虚拟环境,激活后执行pip install -r requirements.txt,即可在本地完全还原在线运行环境,继续完成工业级开发与部署。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









