

Python if语句实战:用户输入验证与数据过滤示例
深入讲解如何在Python中使用if条件语句进行严谨的用户输入验证与高效的数据过滤,包含守卫子句、列表推导式、异常防御与多场景实战代码。
在编写业务程序时,直接信任外部输入或未经清洗的数据往往是引发运行时异常和安全漏洞的主要原因。利用 Python 的 if 条件分支语句,可以在数据进入计算逻辑前设立严密的“前置守卫”,并在处理批量数据时高效剔除异常项。本文将通过两个核心实战场景——控制台用户输入的多级校验与列表集合的数据清洗过滤,拆解具体实现步骤、代码范式以及常见陷阱。
一、用户输入验证的核心逻辑与执行流程
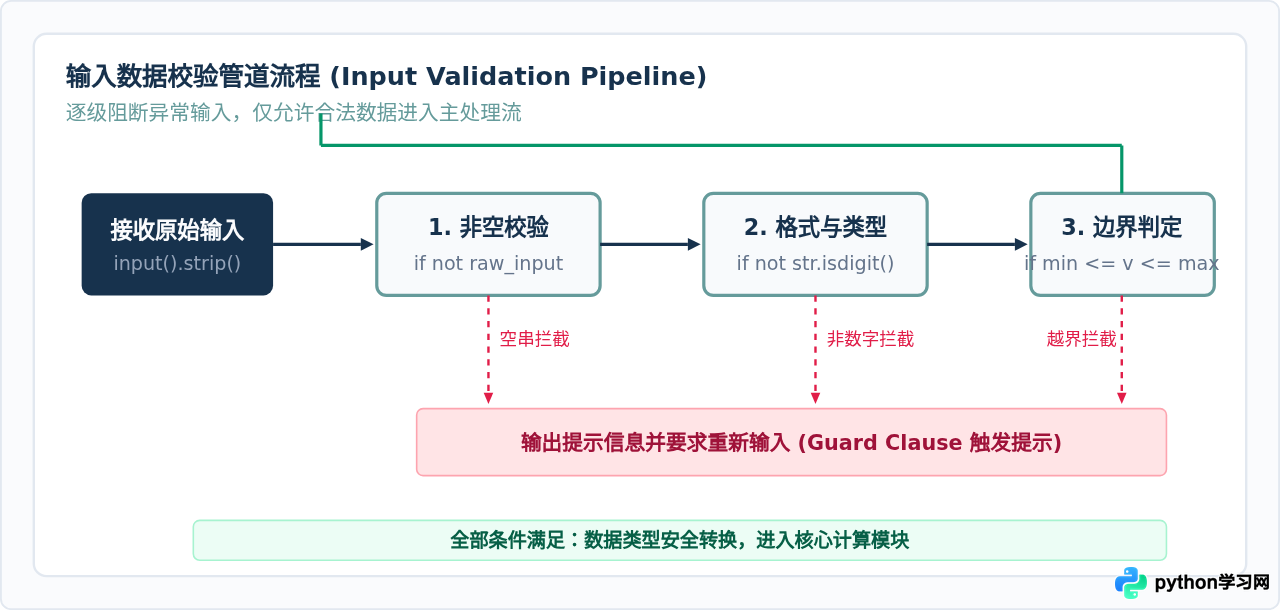
外部用户输入通常具有不可控性,例如空输入、空格占位、非法字符类型或超出合理业务范围的数值。若直接对输入结果调用类型转换函数(如 int() 或 float()),极易直接抛出 ValueError 导致程序崩溃。标准的验证逻辑应当由浅入深分为三个层次:第一层判断是否为空或仅有空白;第二层判断格式或类型是否满足预期;第三层判断业务数值边界是否合规。
二、实战演练:终端用户输入的多层级验证
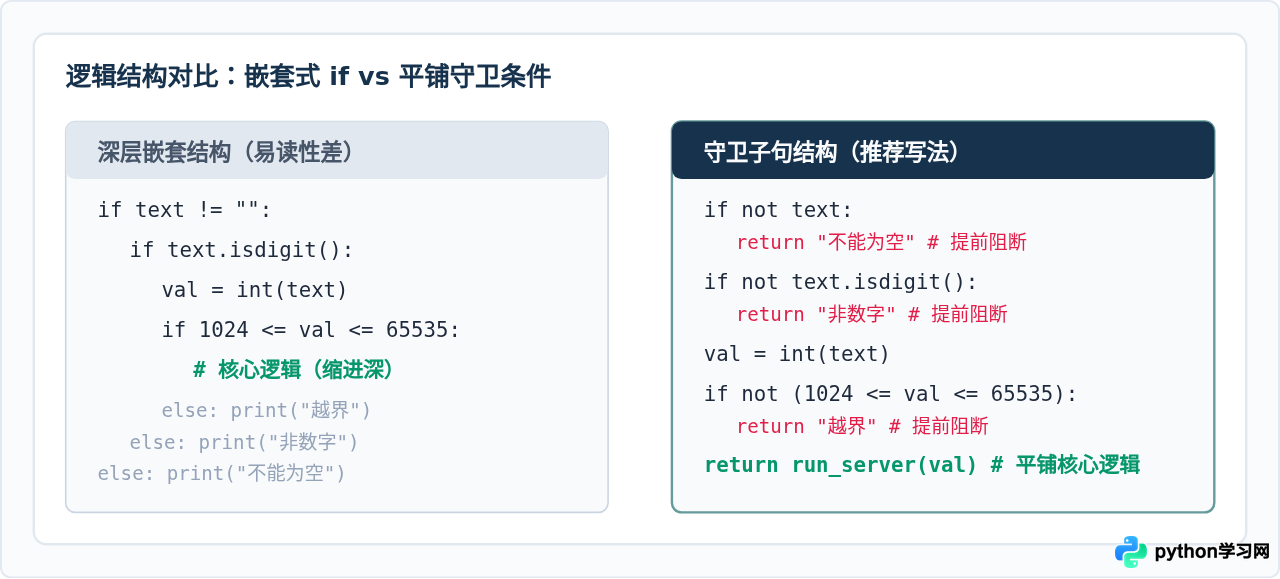
假设我们正在开发一个系统配置向导,需要用户输入端口号(Port)。系统规则要求:输入不能为空,必须全为阿拉伯数字,且端口范围必须在 1024 至 65535 之间。下面我们分别对比“深层嵌套”与“守卫子句(平铺判定)”两种编写模式。
1. 模式对比:避免嵌套陷阱
初学者容易将每一个条件写进 else 分支中,形成多层缩进的“金字塔结构”。这种结构不仅阅读困难,当增加更多验证条件时极难维护。推荐采用守卫子句(Guard Clauses):一旦发现条件不满足,立即输出错误并退出或继续下一次循环(continue / return),保持主流程平铺于最外层。
2. 完整验证代码示例
以下为一个可直接执行的控制台输入校验循环函数。通过 while True 搭配守卫 if,在用户输入非法内容时明确提示错误原因,只有当所有条件均满足时才返回合法的整数结果。
def get_valid_port() -> int:
    """提示用户输入端口号,并完成非空、纯数字与数值区间验证"""
    while True:
        raw_text = input("请输入服务端口号 (1024-65535): ").strip()

        # 条件1:检测空字符串或纯空白输入
        if not raw_text:
            print("【错误】输入不能为空,请重新输入。")
            continue

        # 条件2:检测字符组成是否全为十进制数字
        if not raw_text.isdigit():
            print("【错误】端口号必须是纯正整数,请重新输入。")
            continue

        port = int(raw_text)

        # 条件3:业务边界区间检测
        if port < 1024 or port > 65535:
            print("【错误】端口号超出有效范围 (必须在 1024 到 65535 之间)。")
            continue

        # 所有前置条件全部通过
        print(f"【成功】有效端口号确认: {port}")
        return port

# 模拟调用
if __name__ == "__main__":
    valid_port = get_valid_port()
三、数据集过滤实战:批量清洗与提取
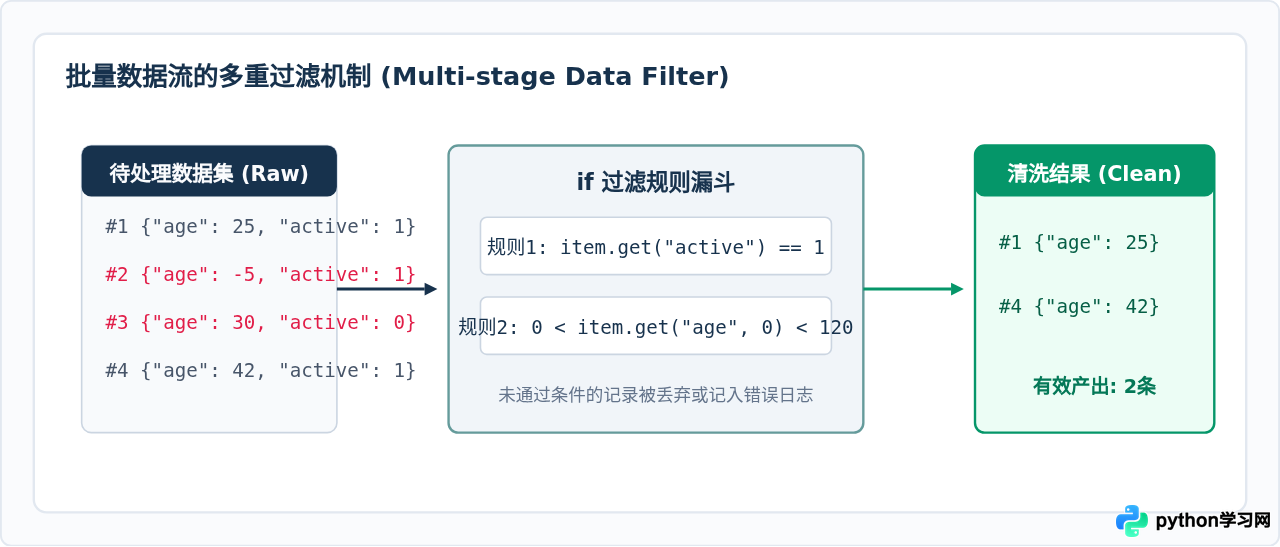
除了单独的单项交互输入,if 语句在处理从文件读取或网络接口返回的批量数据记录时同样至关重要。数据集中常常夹杂着空字典、缺少必要键值的脏数据或不符合统计范围的异常记录。
1. 列表遍历过滤:基础与进阶语法
在 Python 中,常见的数据过滤方式有两种:一种是传统的 for 循环搭配 if 条件追加,另一种是语法更为紧凑的列表推导式(List Comprehension)。在只需要筛选元素的场景下,推导式末尾追加 if 能够显著提高代码执行效率与可读性。
# 原始传感器读数(包含负数错误读数、超温异常值及缺失标识 None)
raw_temperatures = [21.5, -99.0, 23.8, None, 25.1, 150.0, 22.4]

# 方式一:传统 for 循环结合 if 过滤
clean_data_loop = []
for temp in raw_temperatures:
    # 步骤1:排除 None
    if temp is None:
        continue
    # 步骤2:排除传感器故障标识与超常规气温物理极值 (-40 到 60 摄氏度)
    if -40.0 <= temp <= 60.0:
        clean_data_loop.append(temp)

# 方式二:使用带 if 条件的列表推导式完成一步过滤
clean_data_comp = [
    temp for temp in raw_temperatures
    if temp is not None and -40.0 <= temp <= 60.0
]

print("for循环清洗结果:", clean_data_loop)
print("推导式清洗结果: ", clean_data_comp)
很多初学者会混淆两个位置的 if:
- 纯过滤(Filtering):
[x for x in data if 条件]。这里的if写在最右侧,没有else,作用是决定元素“要还是不要”。 - 条件映射(Ternary Mapping):
[x if 条件 else 替代值 for x in data]。这里的if-else写在for左侧,作用是不改变列表长度,而是对符合/不符合条件的元素做数值替换。
四、综合案例:带审计日志的字典流水线过滤
在实际生产中,被过滤掉的数据通常不能直接静默抛弃,而是需要输出被丢弃的原因以便业务排查。以下示例展示了一个完整的用户信息流水线清洗函数:
from typing import List, Dict, Any, Tuple

def filter_user_records(raw_records: List[Dict[str, Any]]) -> Tuple[List[Dict[str, Any]], List[str]]:
    """对批量用户数据进行完整性验证与规则过滤,输出清洗后的合规数据与丢弃原因日志"""
    cleaned_records = []
    discard_logs = []

    for idx, item in enumerate(raw_records, start=1):
        # 1. 验证基础字典结构与必要键
        if not isinstance(item, dict):
            discard_logs.append(f"第 {idx} 项丢弃:记录格式必须为字典。")
            continue

        username = item.get("username")
        age = item.get("age")
        email = item.get("email")

        # 2. 用户名合法性验证
        if not username or not isinstance(username, str) or len(username.strip()) < 3:
            discard_logs.append(f"第 {idx} 项丢弃:username 缺失或长度不足3字符。")
            continue

        # 3. 年龄类型与区间验证
        if not isinstance(age, int) or not (0 < age < 120):
            discard_logs.append(f"第 {idx} 项 ({username}) 丢弃:age 必须为 1-119 之间的整数。")
            continue

        # 4. 邮箱字符特征验证
        if not isinstance(email, str) or "@" not in email or "." not in email:
            discard_logs.append(f"第 {idx} 项 ({username}) 丢弃:email 格式不正确。")
            continue

        # 全部通过验证,规范化后存入结果集
        cleaned_records.append({
            "username": username.strip(),
            "age": age,
            "email": email.strip().lower()
        })

    return cleaned_records, discard_logs

# 测试数据
test_users = [
    {"username": "alice", "age": 28, "email": "alice@example.com"},
    "invalid_string_item",
    {"username": "  ", "age": 20, "email": "test@demo.com"},
    {"username": "bob", "age": -3, "email": "bob@domain.com"},
    {"username": "charlie", "age": 35, "email": "charlie_at_domain.com"},
    {"username": "david", "age": 31, "email": "david@corp.org"}
]

valid_list, logs = filter_user_records(test_users)

print(f"清洗完毕,保留有效记录数: {len(valid_list)}")
for record in valid_list:
    print("  -> 合规记录:", record)

print("\n审计排查日志:")
for log in logs:
    print("  [DISCARD]", log)
五、核心实践准则与避坑指南
编写高质量的条件判断代码,关键在于深刻理解 Python 语言的真值测试(Truthy/Falsy)规则与运算符语义差异。总结以下四个高频场景的最佳实践:
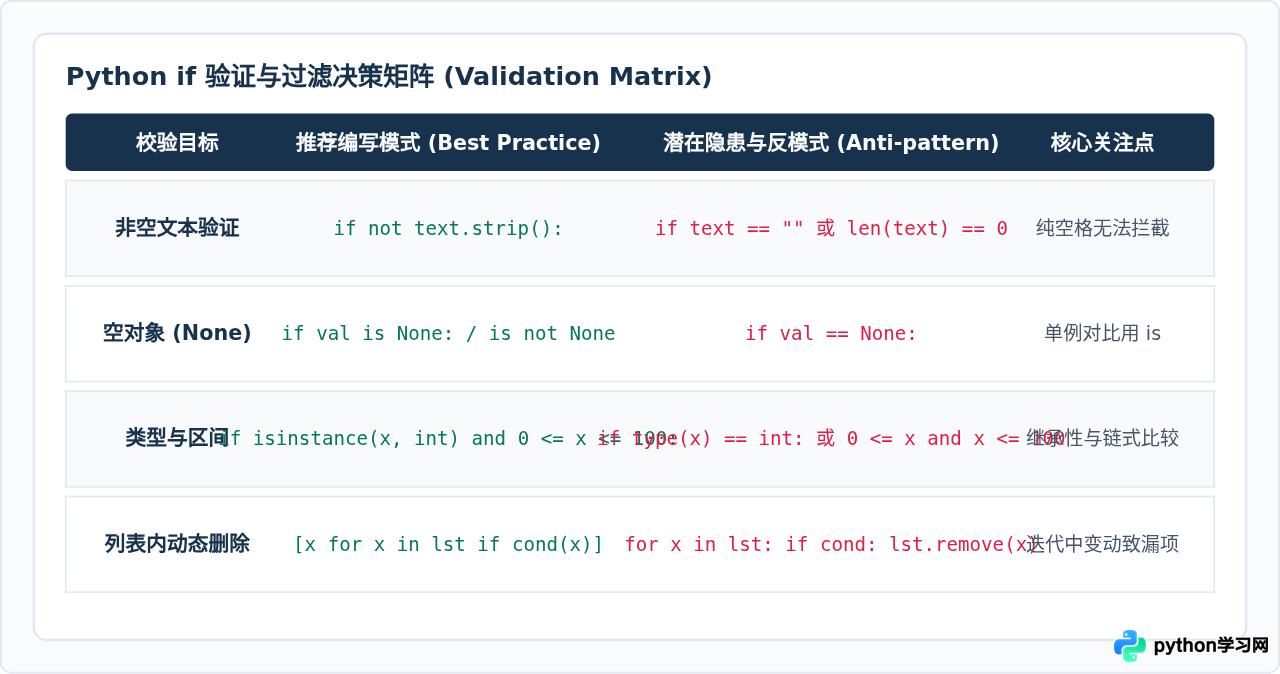
结合上述总结,在日常编写判断逻辑时建议重点遵循以下原则:
- 慎用弱真值判断数字:在验证数字输入时,切勿直接写
if not count:来判断是否未输入,因为当count = 0时其布尔值同样为False,极易误伤合法的零值输入。应显式使用if count is None:。 - 充分利用链式比较:Python 原生支持如
1024 <= port <= 65535的链式条件写法,这比使用port >= 1024 and port <= 65535更加自然直观,运算效率也更高。 - 避免边迭代边修改:在对列表进行条件过滤时,绝不要在
for item in my_list:循环体内直接执行my_list.remove(item)或del。列表下标在删除后会即时前移,导致紧随其后的下一个元素被跳过。正确做法始终是生成新的过滤列表,或使用倒序索引删除。
掌握清晰的 if 语句前置拦截与守卫式设计,能够让代码在面对各类不确定、不规范的用户输入和外界脏数据时具备极强的健壮性与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









