

Python多进程join()的作用:为什么主进程需要等待子进程
深入解析Python多进程编程中join()的核心作用与底层机制,阐述为什么主进程必须等待子进程,分析业务时序依赖、操作系统资源回收、僵尸进程防范及超时控制等最佳实践。
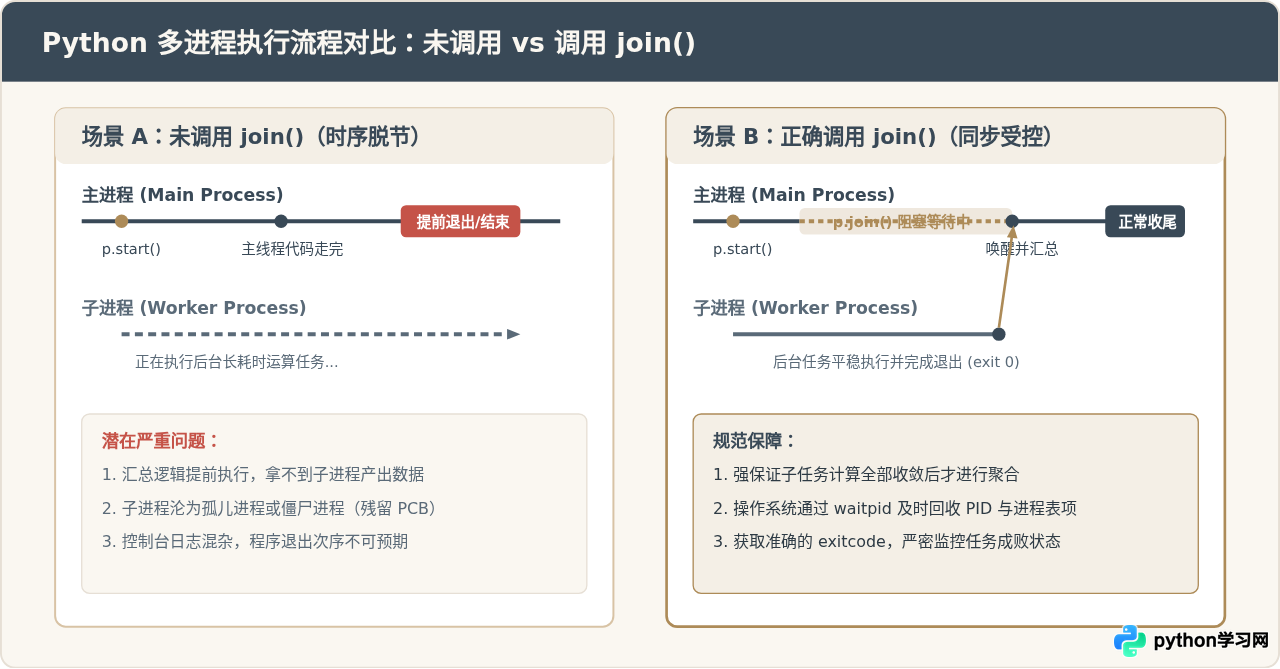
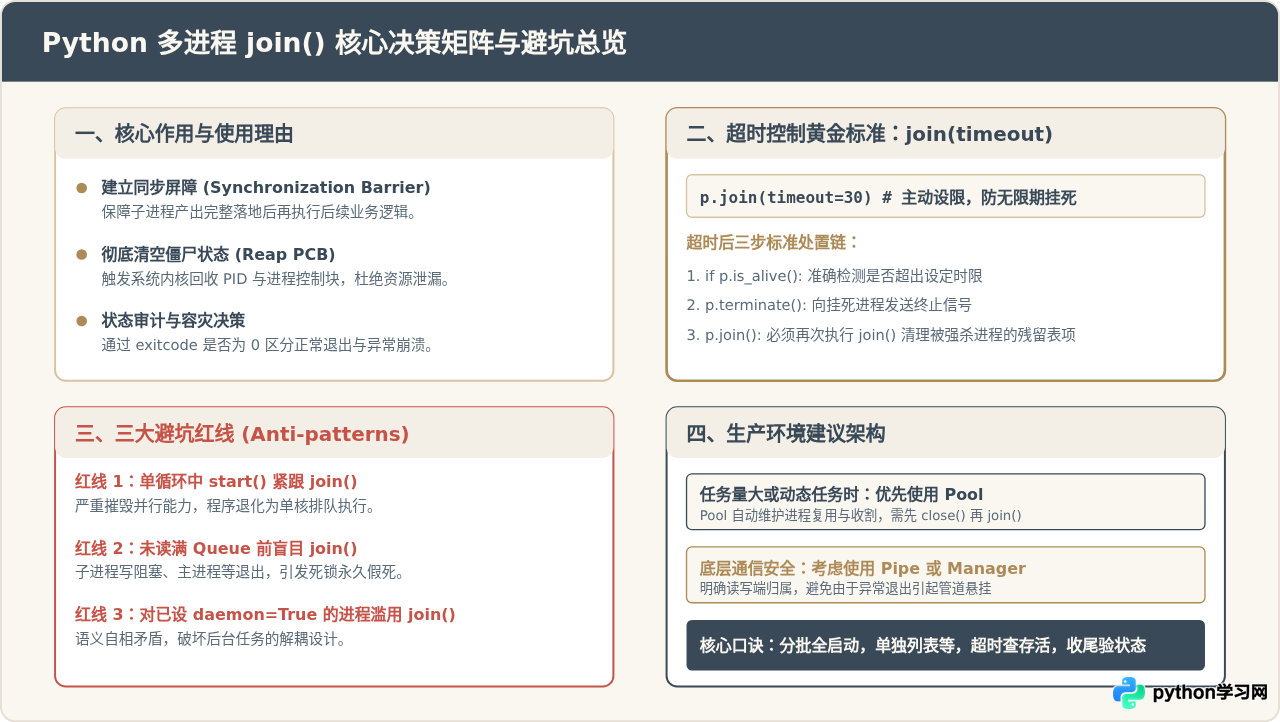
在 Python 的 multiprocessing 模块中,join() 方法的核心作用是让当前主进程进入阻塞状态,主动暂停后续代码的执行,直到被调用的子进程执行完毕并退出。主进程之所以需要显式等待子进程,核心在于解决两个根本问题:第一是控制任务的时序协同,确保子进程处理完所有数据后,主进程才进入结果汇总、持久化或收尾阶段;第二是履行操作系统的资源回收责任,通过底层系统调用获取子进程的退出状态,防止子进程终止后在内核中沦为残留的僵尸进程。
一、深入理解 join():主进程为什么必须等待子进程
多进程编程与单线程线性执行截然不同。当主进程调用 p.start() 时,操作系统内核会通过系统调用(在 POSIX 系统上为 fork,在 Windows 上为 CreateProcess)创建一个全新的独立子进程。创建完毕后,子进程拥有属于自己的独立内存空间、代码段与全局解释器锁(GIL),并与主进程并发交替运行。
此时,主进程并不会自动等待子进程完成,而是会继续向下执行后续指令。主进程如果不通过 join() 显式挂起等待,就会引发两类关键问题:
1. 业务逻辑上的时序依赖与数据完整性
在绝大多数多进程应用中,主进程派发子任务的目的都是“分而治之”。例如:将 10 个大型数据文件分配给 10 个子进程并行解析,主进程负责收集解析出的中间指标并计算最终平均值;或者子进程负责下载资源,主进程负责打包压缩。如果主进程不调用 join(),主进程代码会在子进程刚刚启动后立刻执行汇总结算逻辑,此时子进程往往连前几个字节的数据都还没有写完,导致汇总结果直接为空或数据残缺。
2. 操作系统层面的进程回收与僵尸进程防御
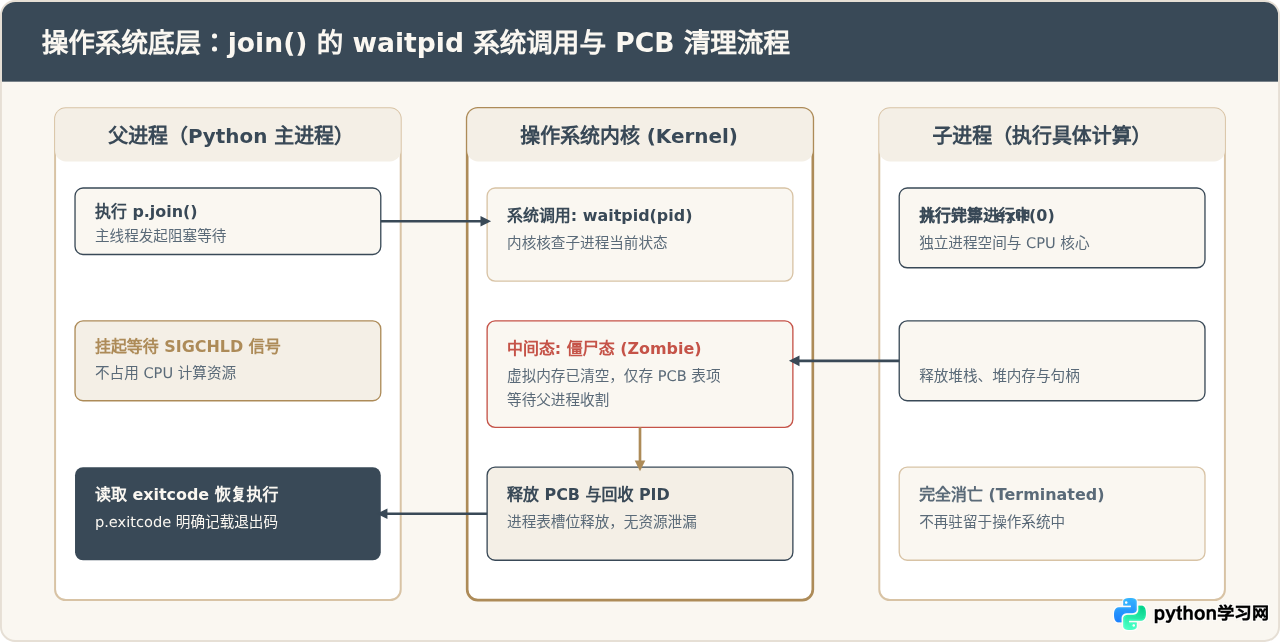
从操作系统的进程模型来看,当一个子进程执行完毕调用 exit() 退出时,该进程的大部分内存资源、打开的文件描述符会被内核自动释放。但是,内核会在进程控制块(PCB, Process Control Block)中保留一段信息(包括 PID、退出状态码、CPU 耗时统计等),以便其父进程随时查询。此时,该子进程已经死亡,但仍占用着系统的进程表项,被称为僵尸进程(Zombie Process)。
如果父进程调用了 join(),Python 底层会发起操作系统的 waitpid() 系统调用。这一调用会取出子进程的退出码并告知内核清理对应的 PCB 项,完成彻底的资源回收。若父进程长时间常驻(如 Web 服务、后台调度器)且频繁创建子进程而不调用 join(),系统中残存的僵尸进程会持续累积,最终耗尽系统的进程号(PID)配额,导致整机无法创建任何新进程。
二、标准调用步骤与代码实战
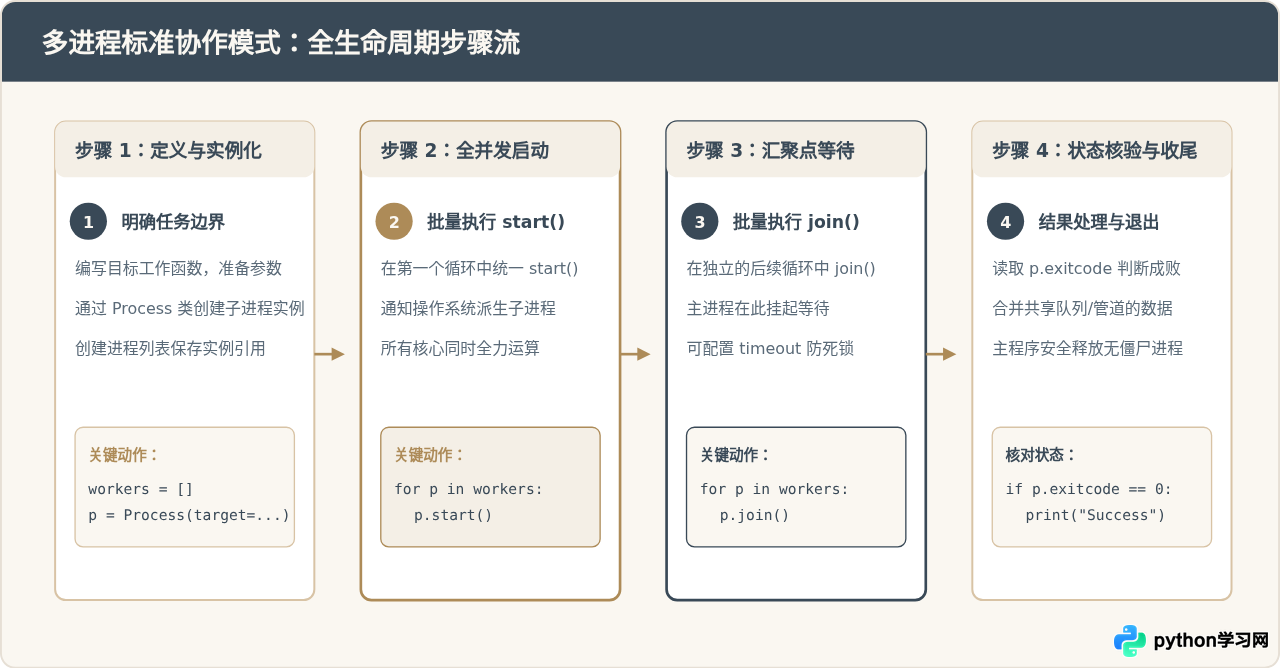
使用多进程时,最关键的操作法则是:“先统一启动所有子进程,再统一等待所有子进程结束”。如果启动一个紧接着等待一个,多进程就会退化为单进程串行执行。以下是标准规范的操作步骤与完整示例代码:
完整代码示例
import multiprocessing
import time
import os

def worker_task(task_id, duration):
    """子进程执行的具体工作函数"""
    print(f"[子进程 {task_id}] (PID: {os.getpid()}) 开始执行,预计耗时 {duration} 秒")
    time.sleep(duration)
    print(f"[子进程 {task_id}] (PID: {os.getpid()}) 执行完毕")

if __name__ == "__main__":
    print(f"[主进程] (PID: {os.getpid()}) 准备创建子进程...")

    # 模拟 3 个不同耗时的子任务
    tasks = [(1, 2), (2, 3), (3, 1)]
    processes = []

    # 第一步:先遍历创建并启动所有子进程
    for task_id, duration in tasks:
        p = multiprocessing.Process(
            target=worker_task,
            args=(task_id, duration),
            name=f"Worker-{task_id}"
        )
        processes.append(p)
        p.start()  # 触发操作系统创建子进程,立刻返回

    print("[主进程] 所有子进程已启动,主进程开始执行 join() 等待...")

    # 第二步:统一遍历等待所有子进程完成
    for p in processes:
        p.join()  # 阻塞主进程,直到当前 p 退出
        print(f"[主进程] 子进程 {p.name} 已归并退出,状态码 exitcode={p.exitcode}")

    # 第三步:所有子进程确认退出后,进行安全汇总结算
print("[主进程] 全部子任务已完成,开始进行最终数据聚合与收尾工作。")示例输出说明:运行上述代码时,可以看到控制台先打印三个子进程的启动信息,随后主进程进入等待。耗时 1 秒的子进程 3 先完成,耗时 2 秒的子进程 1 其次,耗时 3 秒的子进程 2 最后完成。主进程在所有子进程全部安全退出且 exitcode 均为 0 后,才打印最后一行聚合收尾日志,保证了业务时序的严密一致。
三、进阶控制:join(timeout) 防范无限挂死
在实际生产环境中,子进程执行的计算可能会因为网络阻塞、第三方依赖锁死或死循环而无法正常退出。如果主进程直接无参调用 p.join(),主进程将会无限期挂起(Hang),导致整个服务失去响应。
为此,join() 提供了 timeout 参数(单位为秒)。其运作特性如下:
- 等待上限:
p.join(timeout=5)表示主进程最多只等待 5 秒钟。 - 非抛出设计:当等待超时后,
join()不会抛出异常,而是直接解除主进程的阻塞,继续向下执行。 - 存活状态判定:在解除阻塞后,主进程必须调用
p.is_alive()判断子进程是否仍在运行。如果返回True,说明该子进程已超出预期处理时限,需要主动介入。
import multiprocessing
import time

def slow_worker():
    print("[子任务] 开始执行复杂计算...")
    time.sleep(10)  # 模拟耗时极长的任务
    print("[子任务] 计算完成")

if __name__ == "__main__":
    p = multiprocessing.Process(target=slow_worker)
    p.start()

    # 主进程最多等待 3 秒
    timeout_seconds = 3
    print(f"[主进程] 等待子进程结束,最大等待上限: {timeout_seconds} 秒")
    p.join(timeout=timeout_seconds)

    # 检查是否超时
    if p.is_alive():
        print(f"[警告] 子进程运行超过 {timeout_seconds} 秒仍未完成,执行强制终止!")
        p.terminate()  # 发送 SIGTERM 强制终止子进程
        p.join()       # 再次 join,确保终止后的僵尸表项被内核彻底回收
        print(f"[主进程] 子进程已被回收,终结状态码 exitcode={p.exitcode}")
    else:
        print(f"[主进程] 子进程正常按时结束,exitcode={p.exitcode}")
四、高频误区与深坑排查
在多进程编程中,许多开发者由于对 join() 的机制理解不深,容易踩入以下三个常见误区:
误区 1:在同一个循环中连续 start() 和 join()
这是初学者最容易犯的逻辑错误。许多人写出如下代码:
# 错误示范:并发降级为串行
for task in tasks:
    p = Process(target=worker, args=(task,))
    p.start()
p.join() # 错误!主进程在这里立即等待当前子进程结束后果:主进程启动子进程 1 后立刻在 join() 处阻塞,直到子进程 1 跑完才循环到下一个,这直接摧毁了并行性,多核机器的利用率直接降为单核串行。
误区 2:在消费 Queue 缓冲区满之前调用 join() 导致相互死锁
当子进程向 multiprocessing.Queue 写入大量数据(超过系统底层的管道缓冲区容量)时,如果主进程先调用了 join(),就会引发经典的父子互锁死锁:
- 子进程在执行
queue.put()时,由于队列缓冲区已满且未被主进程消费,进入写等待阻塞; - 主进程在执行
p.join()时,正在等待子进程退出,进入等待退出阻塞; - 两者相互等待,程序彻底假死。
规避方案:必须先读取消费队列中的数据,或者使用 join_thread(),确保队列内容清空后,再调用 p.join()。
误区 3:对守护进程(daemon=True)滥用 join()
如果设置了 p.daemon = True,意味着该进程是后台守护进程,主进程退出时会自动强行杀掉所有守护子进程。守护进程本身的设计意图就是“不影响主程序退出”,但如果在代码中又写了 p.join(),就会强行把主进程重新拉入阻塞等待,这与守护进程的初衷相悖,违背了架构分工。
五、总结
在 Python 多进程并发体系中,join() 绝非可有可无的代码装饰,而是保障时序确定性与系统资源健康的关键机制。主进程之所以必须等待子进程,根本上是因为:
- 时序把控:主进程必须等所有子任务运算落地,后续的指标聚合与业务收敛才有据可依。
- 系统清理:操作系统需要父进程通过
join()(底层waitpid)读取状态并释放残留的 PCB,杜绝僵尸进程占用系统配额。 - 健壮防守:合理使用
join(timeout)配合terminate(),能够有效防止生产环境因个别子任务异常挂死而导致整体服务瘫痪。
遵循“批量启动、独立等待、超时防御、状态核验”的工程规范,即可充分发挥多核 CPU 的计算潜能,写出高效且稳定的多进程程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









