

浏览器前端运行Python的原理:Pyodide与WebAssembly
深入解析在现代浏览器中直接运行Python代码的核心底层原理,涵盖WebAssembly虚拟机沙箱机制、Emscripten交叉编译体系、Pyodide架构设计、内存映射与JavaScript双向互操作。
一、为什么原本无法在浏览器中运行 Python
长久以来,Web 浏览器内部的原生执行引擎(如 Chrome 的 V8、Firefox 的 SpiderMonkey、Safari 的 JavaScriptCore)只为执行 JavaScript 设计。浏览器并不包含 Python 虚拟机,更无法直接识别 Python 的 .py 脚本或底层字节码。
官方最主流的 Python 实现是 CPython。CPython 是用 C 语言编写的程序,在传统使用场景下,它会被编译为适配特定操作系统(Windows、macOS、Linux)和特定 CPU 架构(x86-64、ARM64)的本地机器码。运行 CPython 依赖操作系统内核提供的系统调用(POSIX API),例如打开本地磁盘文件(open/read/write)、创建网络套接字(socket)、分配原生系统内存(malloc)以及管理多进程与多线程。
而 Web 浏览器出于安全性考虑,构建了一个与宿主操作系统隔离的严格安全沙箱。网页前端脚本既无法直接访问本地操作系统的磁盘文件,也无法自由发起原始 TCP 连接,更不能直接寻址操作系统的物理内存。这种“平台机器指令不兼容”与“操作系统系统调用缺失”的双重鸿沟,使得传统的 CPython 可执行文件无法直接放入浏览器运行。
二、核心架构基石:WebAssembly 与 Emscripten
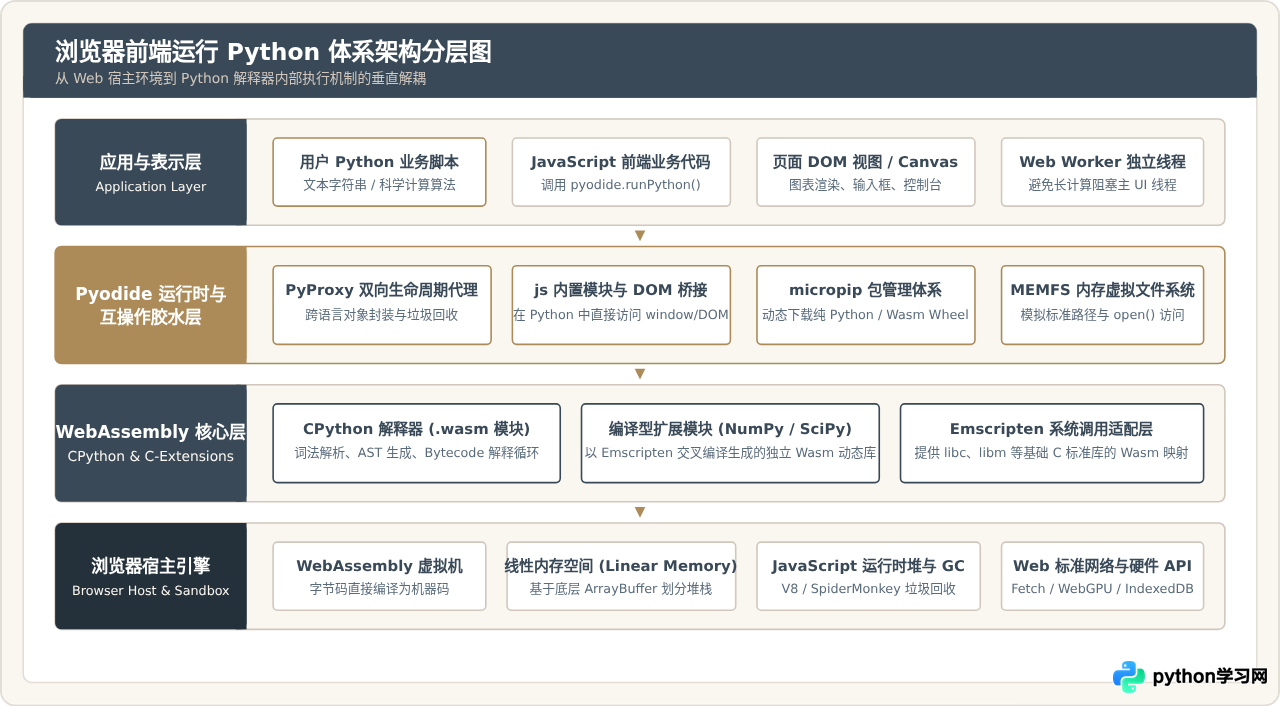
打破这一僵局的核心技术是 WebAssembly(简称 Wasm)。WebAssembly 是 W3C 制定的一项开放标准,它在浏览器中定义了一个高度优化的底层栈式虚拟机。与传统 JavaScript 代码需要经过词法分析、AST 解析、JIT 及时优化等多层编译管线不同,Wasm 是紧凑的二进制指令格式,现代浏览器可以直接以接近原生机器码的速度加载并执行它。
有了 WebAssembly 这个通用的浏览器虚拟机标准后,关键的问题变成了:如何把庞大而复杂的 CPython C 语言工程,转换成 WebAssembly 二进制模块?这一任务由编译器工具链 Emscripten 完成:
- LLVM 后端代码生成:Emscripten 基于 LLVM 编译器框架,接收 CPython 的 C 源码,将其编译为 Wasm 字节码指令,而非特定操作系统的本地机器码。
- POSIX 系统层仿真:Emscripten 在浏览器内用 JavaScript 实现了对标准 C 库(libc)和系统调用的仿真层。例如,当 C 代码调用
malloc时,操作的是 Wasm 实例内部的一块连续二进制内存(Linear Memory);当调用文件读写接口时,映射到内存中的虚拟文件系统(MEMFS)。
三、Pyodide 的诞生与它解决的问题
仅将 CPython 编译成一个 .wasm 文件,并不能直接构建一个开箱即用的前端 Python 环境。一个裸的 CPython Wasm 模块面临以下现实难题:
- 标准库缺失:Python 的大量内置功能(如
math、json、re)以.py脚本或 C 扩展模块形式存在。裸 Wasm 文件中不包含这些外置标准库。 - 无法直接与 JavaScript 交换对象:Wasm 与 JavaScript 之间在原生层面仅支持传递数值类型(32 位 / 64 位整数与浮点数)。如果在 Python 中生成了一个字典或对象,JavaScript 无法直接通过指针读取其字段。
- 第三方科学计算生态孤立:数据科学离不开 NumPy、Pandas、SciPy、Matplotlib 等库。这些库包含大量 C、C++、Fortran 扩展源码,无法直接从官方 PyPI 下载 x86 预编译的 wheel 包使用。
Pyodide 的核心贡献,正是解决了上述全部难题。它不仅是一个预编译的 CPython Wasm 发行版,更是由 Mozilla 启动、目前独立维护的成熟开源项目。Pyodide 包含:
- 完整的 CPython 解释器 Wasm 预构建二进制文件及其精简打包的标准库。
- 一套双向透明的 Foreign Function Interface(FFI)跨语言互操作桥梁。
- 专用的前端包管理器
micropip,支持从专用源安装已经针对 WebAssembly 交叉编译好的近百种主流科学计算库。 - 一套基于 Emscripten MEMFS 的虚拟文件系统封装,让 Python 代码能够透明地使用
open("data.csv")。
四、代码实操:在 HTML 中运行 Python 代码
理解原理之前,先看一个在现代浏览器中加载并运行 Python 的实际最小代码示例。只需引入 pyodide.js 引导脚本,即可在前端完成初始化与执行:
<!-- 引入 Pyodide 官方 CDN 引导脚本 -->
<script src="https://cdn.jsdelivr.net/pyodide/v0.26.2/full/pyodide.js"></script>
<script>
  async function runPythonDemo() {
    // 步骤 1:下载并初始化 Pyodide 运行时(分配 Wasm 内存、挂载标准库)
    const pyodide = await loadPyodide();

    // 步骤 2:直接执行纯 Python 字符串
    const result = pyodide.runPython(`
      import sys
      print(f"当前运行的 Python 版本: {sys.version}")

      # 定义一个简单的高阶函数并计算
      def compute_factors(n):
          return [i for i in range(1, n + 1) if n % i == 0]

      compute_factors(48)
    `);

    // 步骤 3:获取 Python 运算结果(返回 PyProxy 包装对象)
    console.log("返回的计算结果:", result.toJs());

    // 步骤 4:显式释放 PyProxy,避免内存泄漏
    result.destroy();
  }

  runPythonDemo();
</script>
五、Pyodide 的运行生命周期剖析
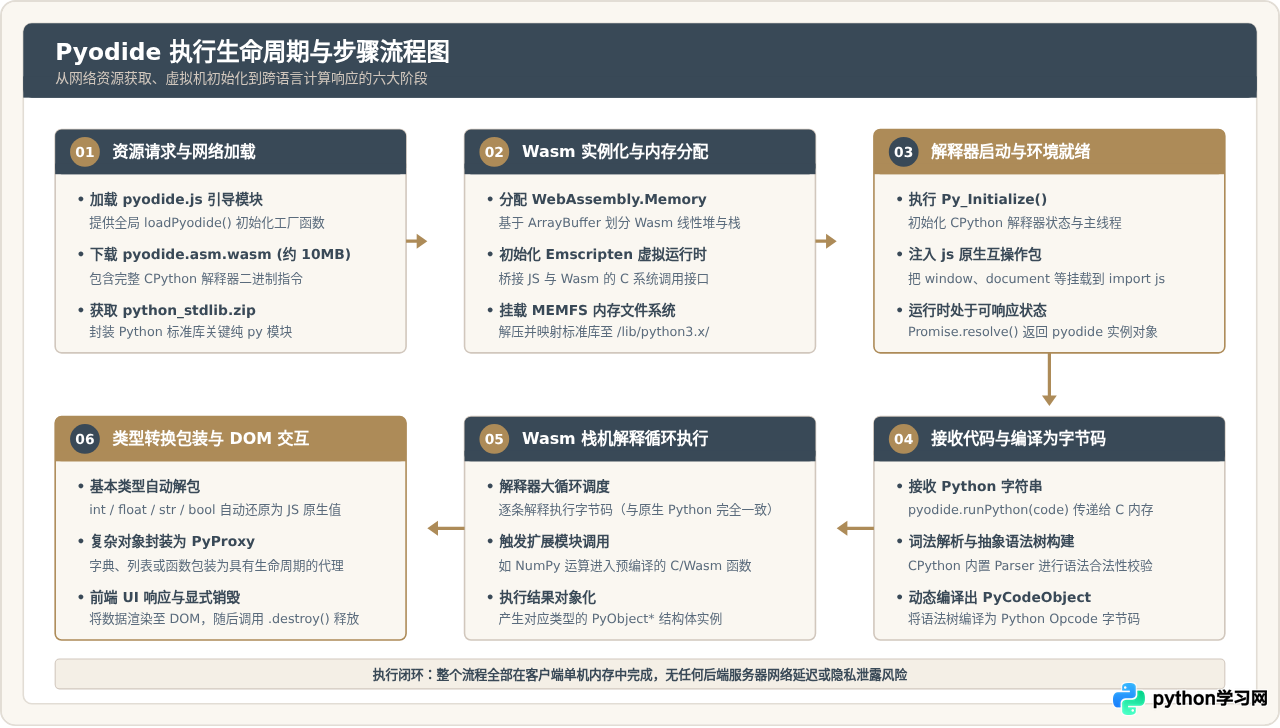
当执行上述代码时,浏览器后台按序经历以下六个阶段:
- 资源请求与加载:首先加载仅有几十 KB 的
pyodide.js胶水脚本。随后,调用loadPyodide()会异步请求体积约 10MB 的核心二进制文件pyodide.asm.wasm以及打包了标准库的python_stdlib.zip。 - 线性内存分配与环境初始化:浏览器分配一块连续的
WebAssembly.Memory(底层是一个 JavaScriptArrayBuffer)。Emscripten 在此内存上初始化 C 语言堆栈指针、全局数据段,并构建 MEMFS 虚拟内存文件系统,把标准库 zip 解压挂载到虚拟路径/lib/python3.x/下。 - CPython 解释器启动:调用 CPython 导出的 C 函数入口
Py_Initialize(),创建核心解释器状态(PyInterpreterState)与线程状态(PyThreadState),加载内建类型与核心命名空间。 - 代码传入与 AST 编译:前端调用
pyodide.runPython(code)时,代码字符串通过 UTF-8 编码写入 Wasm 共享内存。CPython 词法分析器与语法分析器将其解析为抽象语法树(AST),并在内存中生成 Python 字节码对象。 - Wasm 虚拟机解释执行:WebAssembly 栈式指令集执行 CPython 的字节码解释主循环(
_PyEval_EvalFrameDefault),完成指令调度与数据计算。 - 跨语言类型转换与 DOM 响应:计算结果以 Python 对象指针(
PyObject*)的形式产出。Pyodide 的 FFI 胶水层将其自动映射为 JavaScript 原始值或封装为PyProxy,并交由前端业务代码处理或渲染至页面。
六、深度解密:Python 与 JavaScript 的双向互操作
Pyodide 之所以实用,关键在于它消除了 Python 与 JavaScript 之间的鸿沟。开发者不仅可以在 JS 中读取 Python 计算出的变量,还可以在 Python 中直接操作浏览器的 DOM 树、监听事件或触发 Web API。
1. 内存隔离与基本数据类型的深拷贝传递
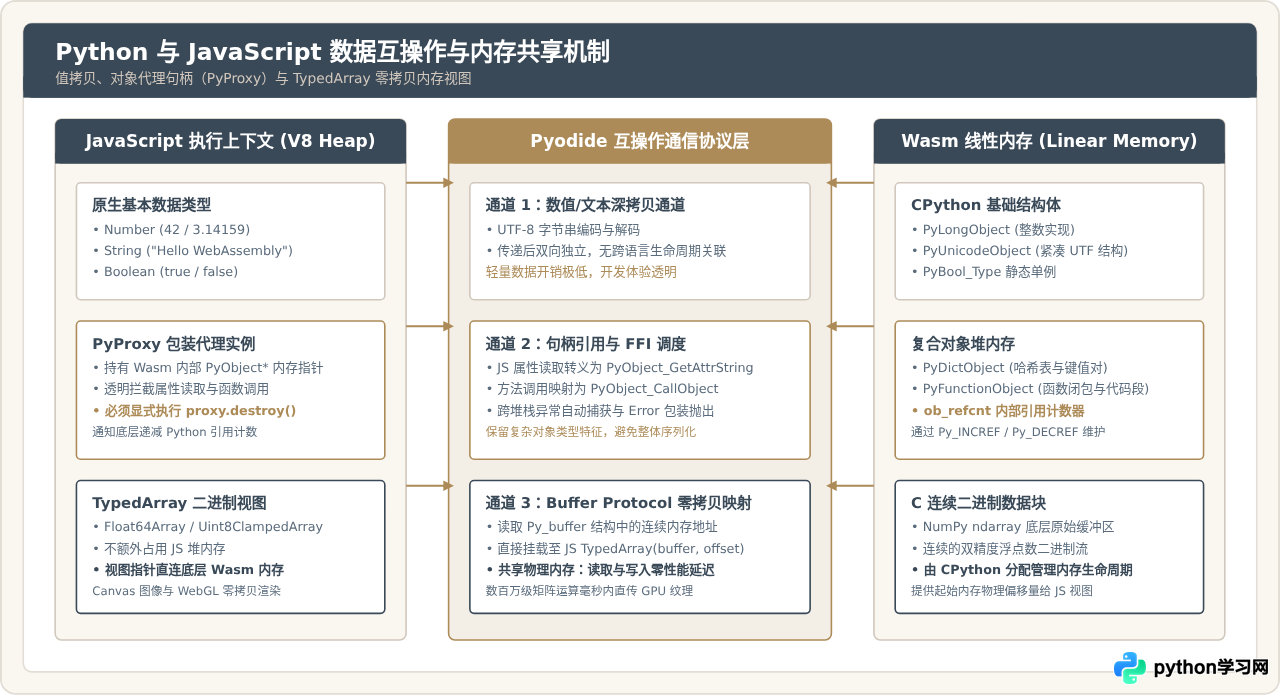
WebAssembly 运行在独立的线性内存(Linear Memory)中,而 JavaScript 对象存放在浏览器的垃圾回收堆(V8 Heap)中。两者物理上是相互隔离的。
对于数字(int/float)、布尔值(bool)和字符串(str),Pyodide 采用值拷贝(Pass by Value)策略。当 Python 返回一个字符串时,Pyodide 会读取 Wasm 线性内存中的 UTF-8 字节流,并在 JavaScript 堆中新建一个对应的 JavaScript 字符串。
2. 复合对象与 PyProxy 代理句柄
当 Python 返回一个复杂对象(如字典、自定义类实例或高阶函数)时,深拷贝整个对象会产生巨大的性能开销,且会丢失面向对象的引用语义。
为此,Pyodide 引入了 PyProxy 机制。PyProxy 是一个带有 JavaScript Proxy 行为的特殊包装器,它内部只持有一个指向 Wasm 线性内存中 PyObject* 的指针。通过这个代理,开发者在 JavaScript 中可以像访问普通 JS 对象一样读取字段或调用方法:
proxy.get("key")或proxy.key:触发内部 FFI 调用,通过指针查询 Python 字典或属性。- 必须注意生命周期:JavaScript 的垃圾回收器无法感知 WebAssembly 内部的引用计数增减。因此,JavaScript 代码在用完
PyProxy后,必须手动调用proxy.destroy(),通知 CPython 减少该对象的引用计数(Py_DECREF)。否则,这块 Wasm 内存将永远无法被回收,从而导致严重的内存泄漏。
3. 科学计算杀手锏:基于 Buffer Protocol 的零拷贝内存共享
在数据科学中,数组可能包含上百万个高精度浮点数。如果每次在 JS 与 Python 之间传递数组都要逐个元素序列化和拷贝,性能将不可接受。
Pyodide 利用了 Python 底层的缓冲区协议(Buffer Protocol)与 JavaScript 的 TypedArray 机制:
当 Python 创建一个 NumPy 数组(np.zeros(1000000))时,数据是以连续二进制形式存放在 Wasm 线性内存(ArrayBuffer)中的。调用 pyodide.toPy() 或 array.toJs() 时,Pyodide 可以直接构造一个 JavaScript 的 Float64Array,直接将该视图的内部指针指向 Wasm 内存中对应的起始字节偏移。
这就实现了真正的零拷贝(Zero-Copy):JavaScript 与 Python 共同读写同一片物理物理连续内存块,极大加速了浏览器端的大规模数据处理与图像渲染。
七、第三方库生态:纯 Python 与 C 扩展的差异
在实际工程中,仅仅运行 Python 内置语法通常是不够的,往往需要引入第三方开源库。在浏览器环境下,第三方库被严格划分为两类:
1. 纯 Python 轮子包(Pure Python Wheel)
如果第三方包的代码完全由 Python 编写,没有包含任何 C/C++ 扩展或 Cython 代码(例如 requests 替代库、jinja2、networkx 等),它们可以直接在 Pyodide 中运行。
Pyodide 内置了 micropip 模块。在浏览器中执行 await micropip.install("some-pure-package") 时,它会通过浏览器的标准 fetch 请求直接从 PyPI 下载对应的 .whl 文件,解压写入到虚拟文件系统 MEMFS 中,完成免编译动态加载。
2. 编译型 C/C++ 扩展库(如 NumPy、Pandas、SciPy)
这类库包含大量需要编译为机器指令的底层代码。你绝不能从 PyPI 直接安装带有 manylinux_x86_64 或 win_amd64 标记的预编译二进制包。
为了让这些库运行在浏览器中,Pyodide 维护团队建立了一套完备的 Emscripten 交叉编译流水线。在服务端提前将 NumPy、SciPy、Scikit-learn、Matplotlib 等库的 C/C++/Fortran 源代码编译为配套的 .wasm 文件,并构建出专为 WebAssembly 优化的 Wheel 包。当你在前端声明需要这些包时,Pyodide 会直接从其专用的 CDN 仓库拉取预编译好的 Wasm 构件。
八、技术权衡与选型依据
在浏览器端使用 Pyodide 运行 Python 带来了前所未有的工程能力,但也引入了明显的物理限制。在决定是否采用该架构前,必须全面评估其技术特征:
| 评估维度 | 浏览器前端 Pyodide 运行 | 传统后端服务器 Python 执行 | 原生浏览器 JavaScript |
|---|---|---|---|
| 计算资源成本 | 零服务器算力消耗,完全消耗终端用户 CPU/GPU | 服务器承担全部负载,随用户量增长需线性扩容 | 零服务器算力消耗,完全使用客户端资源 |
| 数据安全与隐私 | 极佳,所有用户数据完全保留在客户端内存中 | 用户数据需上传至云端,存在合规与泄露风险 | 极佳,数据仅在客户端流转 |
| 首屏加载耗时 | 较慢(初次需下载 10MB~30MB Wasm 运行时与库) | 极快,仅需加载轻量 HTML/JS 界面 | 极快,原生无需额外安装虚拟机 |
| 离线可用性 | 支持(配合 Service Worker 缓存后可纯离线计算) | 无法离线,断网即无法提供计算服务 | 支持,前端逻辑天然支持离线运行 |
| 底层计算性能 | 约为原生 CPython 的 50%~80%(受 Wasm 栈机开销影响) | 原生 100% 性能,可充分利用多核并行与 SIMD | 经过 V8 深度 JIT 优化,简单算法执行速度极快 |
| 多线程与网络限制 | 受沙箱限制,无原始 Socket,需通过 Web Worker 模拟并发 | 具备完整操作系统权限,支持原生多进程/线程/Socket | 受浏览器沙箱限制,使用 Fetch/WebSocket 与 Workers |
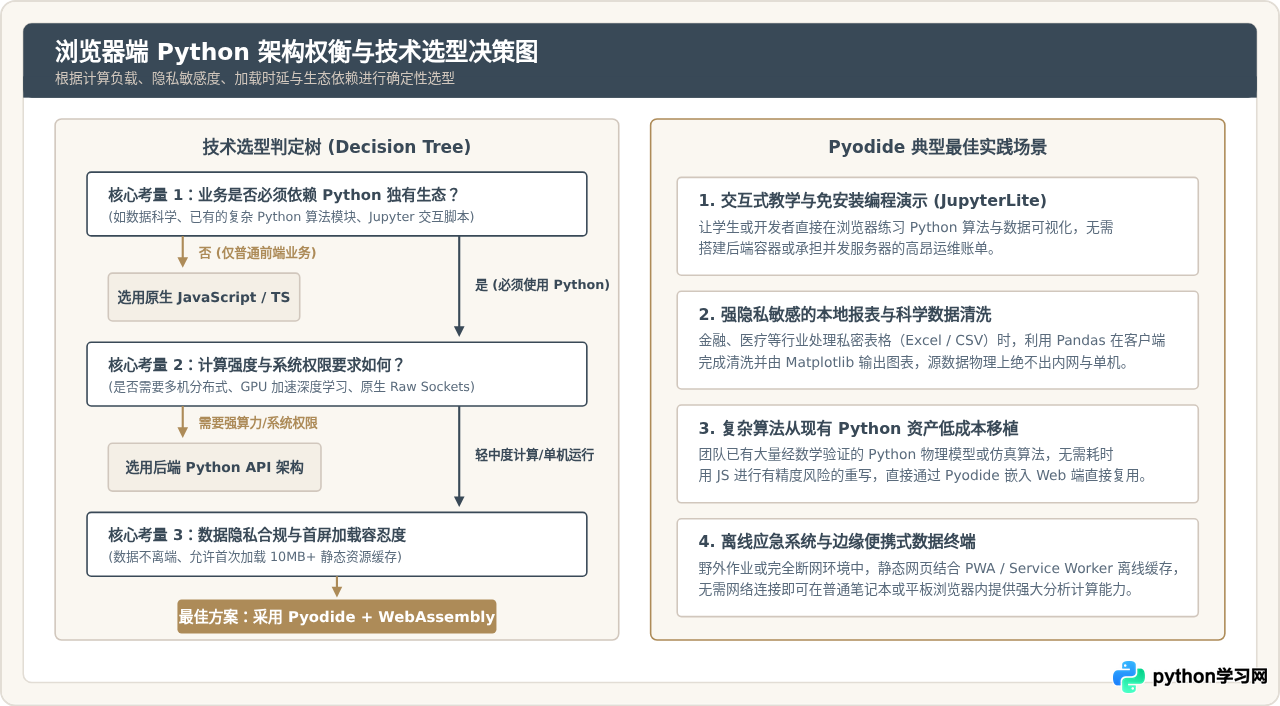
九、总结
浏览器前端运行 Python 并不是对前端生态的盲目替代,而是现代 Web 标准发展至 WebAssembly 时代带来的重要技术延伸:
- 技术本质:它依托 Emscripten 将官方成熟的 CPython 解释器源代码直接编译为 WebAssembly 二进制字节码,在浏览器的沙箱虚拟机内运行。
- 生态黏合:Pyodide 补齐了标准库装载、虚拟文件系统映射、第三方 C 扩展模块交叉编译以及与 JavaScript 之间高效的双向 FFI 互操作机制。
- 架构价值:对于数据密集、算法复用度高、数据隐私敏感且追求零后端开销的应用(如 JupyterLite、客户端数据清洗工具、交互式教学),Pyodide 与 WebAssembly 构成了极具竞争力的现代化解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









