

python必背源代码爬网页requests+bs4代码
深入解析Python使用requests与BeautifulSoup4(bs4)爬取网页的核心必背源代码模板,涵盖请求头伪装、中文编码处理、网络异常防御、DOM节点安全定位以及工程级数据抽取全流程。
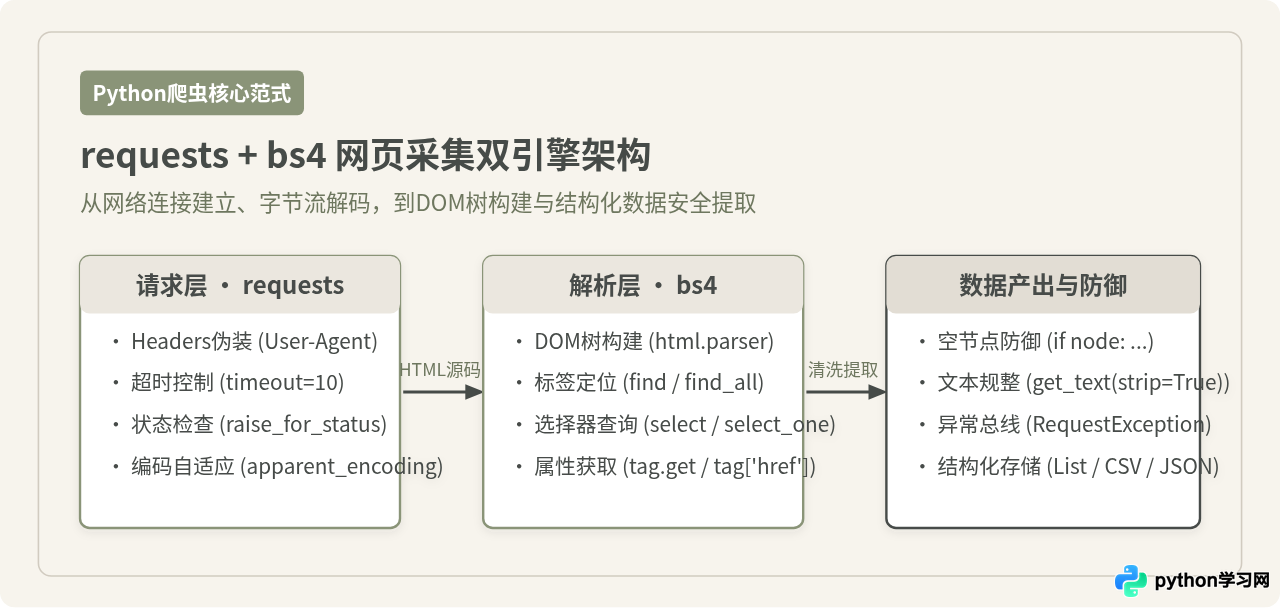
requests 负责建立网络连接并获取远程服务器返回的源码内容,而 BeautifulSoup(bs4)则负责将文本解析为层级分明的 DOM 树,进而实现精准的数据检索与抽取。这两者的结合是 Python 爬虫领域结构最精简、运行最稳健的标准范式。掌握一套具备请求头伪装、自适应编码纠正、网络异常防御与空节点保护的“必背标准代码”,能够帮助开发者直接应对绝大多数静态网页抓取任务,并在遭遇中文乱码、连接超时或目标标签缺失时具备确定的排查路径。
一、最简必背标准代码模板与逐行拆解
编写网络爬虫最忌讳直接使用无防护的裸请求(如直接 requests.get(url) 且不带请求头、不设超时)。实际网页服务器通常配置了基础的安全策略,若不提供合法的客户端标识,极易被直接拒绝服务;而在弱网环境下不设定超时阈值,更会导致整个程序长时间挂起无法恢复。
以下是每一个 Python 开发者都应熟练掌握的标准基础采集模板:
import requests
from bs4 import BeautifulSoup

def fetch_and_parse(url):
    # 1. 构造请求头,伪装浏览器标识
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
    }

    try:
        # 2. 发起GET请求,设定超时截断阈值(秒)
        response = requests.get(url, headers=headers, timeout=10)

        # 3. 主动检查HTTP状态码(若为4xx或5xx则抛出HTTPError)
        response.raise_for_status()

        # 4. 纠正中文网页常见的编码推断偏差
        response.encoding = response.apparent_encoding

        # 5. 构建BeautifulSoup DOM解析树
        soup = BeautifulSoup(response.text, 'html.parser')
        return soup

    except requests.RequestException as e:
        # 捕获所有与网络传输相关的异常(包括DNS解析失败、超时、状态码异常等)
        print(f"[网络请求异常] 目标地址 {url} 抓取失败: {e}")
        return None
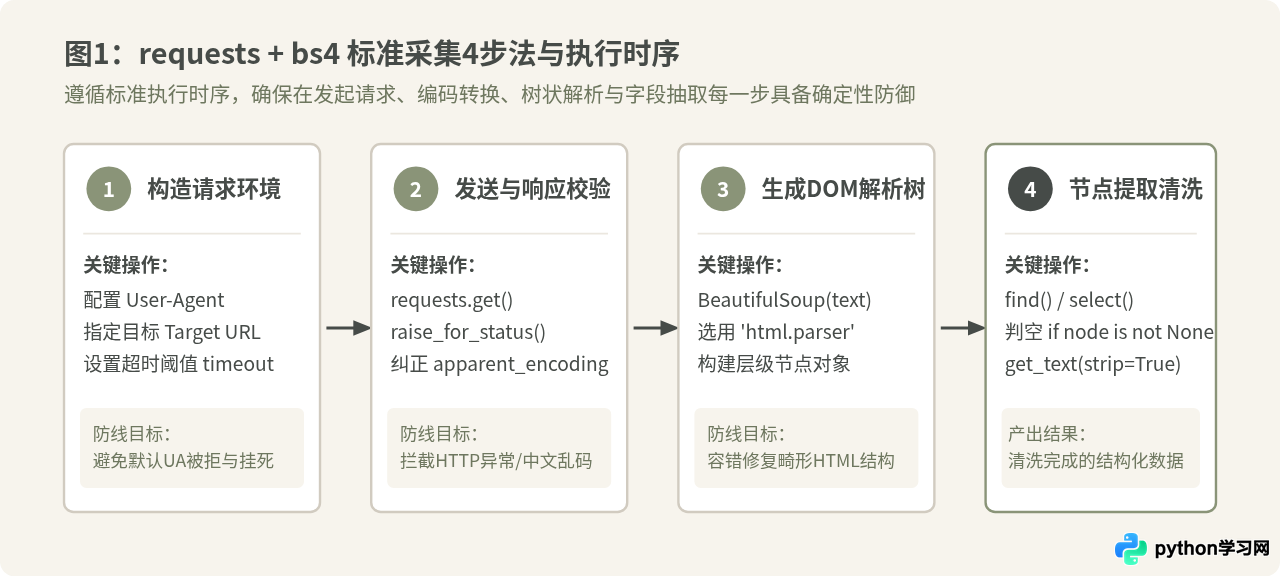
这个基础函数覆盖了网络采集全流程的四个核心支柱。每一行代码的设计意图非常明确:
- User-Agent 伪装:绝大多数防爬规则的第一步就是检测
User-Agent。如果不传递该参数,requests发出的默认标识为python-requests/x.x.x,许多站点会立即返回 403 Forbidden 错误。 - 显式超时 (timeout=10):
requests默认不会主动超时。若对端服务器假死或网络丢包,程序将永远处于等待状态,设定 10 秒超时可以保障整个采集流程不会无限期卡住。 - raise_for_status() 校验:常规的
requests.get()在遇到 404 或 500 页面时并不会直接抛出异常,而是继续返回一个包含错误提示页面的Response对象。调用此方法能够确保只有响应状态码为 200~299 时才继续向后执行。 - apparent_encoding 纠错:解决中文网页“一抓就乱码”的关键开关,由
chardet/charset_normalizer扫描响应正文的 HTML meta 标签与字符分布,推断出最匹配的编码。 - html.parser 解析器:Python 自带的标准解析器,无需额外安装底层 C 语言依赖库(如 lxml),在兼顾通用性与容错性的同时具备开箱即用的便利性。
二、网络请求环节的深入处理与编码陷阱辨析
在实际操作中,很多初学者常遇到“在终端打印出来全是乱码”的问题,并且尝试用 .encode('utf-8').decode('gbk') 乱试一通。理解 requests 内部对字节流和字符串的处理机制,是彻底避免乱码的前提。
1. response.text 与 response.content 的本质区别
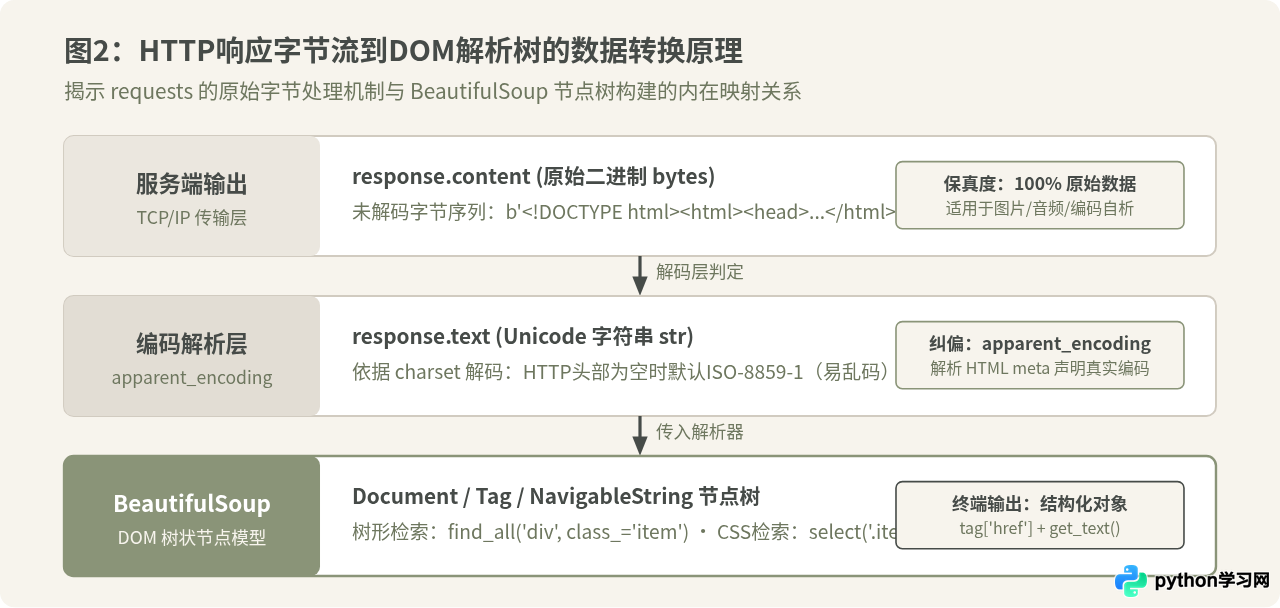
当对端服务器响应请求时,通过网络接口传输过来的本质上是一串纯粹的原始二进制字节流(bytes)。
response.content:返回未作任何解码转换的原始字节(bytes类型)。这是数据源头最精确的表示。response.text:返回已经转换完成的字符文本(str类型)。requests在生成.text时,会依据response.encoding指定的字符集对二进制字节进行反序列化。
安装 这种“拉丁乱码”?根据早期 HTTP/1.1 RFC 规范,如果 Web 服务器返回的
Content-Type 头中只写了 text/html 而没有显式附带 charset=utf-8,requests 会保守地将默认编码假定为 ISO-8859-1(西欧单字节字符集)。将 UTF-8 编码的汉字硬生生用 ISO-8859-1 解析,就会产生无意义的西欧字符。
针对这一问题的处理方案有两种,其中第二种更为推崇:
- 手动覆盖编码:在读取
response.text之前,执行response.encoding = response.apparent_encoding,让 requests 自行根据网页实际内容探测正确的编码(如 UTF-8 或 GBK/GB2312)。 - 直接传入字节流给 BeautifulSoup:直接执行
soup = BeautifulSoup(response.content, 'html.parser')。BeautifulSoup 内部拥有专属的编码检测模块(Unicode, Dammit),它能够更早地从 HTML 内部的<meta charset="...">标签中读取编码定义,直接完成字节到树节点的平滑映射。
2. 使用 requests.Session() 保持连接与状态
如果需要连续抓取几十上百个网页,不建议在循环体内反复调用 requests.get()。因为每一次单独调用都会经历 TCP 三次握手和 TLS 握手,开销巨大。使用 requests.Session() 可以在底层复用同一个 TCP 连接,并且自动管理跨请求的 Cookie:
# 进阶建议:在批量爬取场景下启用会话对象
session = requests.Session()
session.headers.update({
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
})

# 后续全部通过 session 发起请求,自动沿用请求头并维持连接池
# res = session.get(page_url, timeout=10)
三、节点定位与内容清洗的核心API辨析
成功获得 BeautifulSoup 对象后,核心任务就是从中检索出具体的节点标签并安全提取文本或属性。许多爬虫程序之所以在运行中途突然崩溃,往往是因为忽略了目标节点的非空防御。
1. find() 与 find_all() 的取舍与判空防御
这两个方法是基于标签名称和属性进行查找的基石方法:
find(name, attrs):仅返回匹配到的第一个Tag对象;若页面中根本没有对应元素,则返回None。find_all(name, attrs):返回包含所有匹配元素的列表;若无匹配元素,则返回一个空列表[]。
AttributeError: 'NoneType' object has no attribute 'text'初学者非常习惯写出单行链式调用:
title = soup.find('h1', class_='article-title').text。一旦网页结构微调、遇到了异常报错页,或者某篇内容本身没有 h1 标题,find() 就会返回 None,紧接着访问 .text 就会直接造成整个脚本异常中止。规范解法:必须先检查节点是否存在,再访问其属性或文本:
# 健壮的防御写法
title_node = soup.find('h1', class_='article-title')
title = title_node.get_text(strip=True) if title_node else "默认无标题"
2. select() 与 select_one():CSS 选择器的灵活性
对于习惯了前端开发或浏览器开发者工具(DevTools)的人员来说,使用 CSS 选择器往往比多层嵌套的 find 更加直观。例如层级选择器、兄弟节点选择器和属性过滤:
# 获取 class 为 content 容器内部所有的 a 标签链接
links = soup.select('.content div.entry > a.title-link')

# 获取第一个匹配项
first_author = soup.select_one('.meta span.author-name')
author_text = first_author.get_text(strip=True) if first_author else ""
3. .text 与 .get_text(strip=True) 的清洗细节
直接读取 tag.text 时,它会将该标签及其所有子标签内的文字生硬地拼合在一起,往往夹杂了大量的制表符 \t、多余空行 \n 和行首空格。使用 tag.get_text(strip=True) 则会自动对提取出的文本做首尾空白裁切;如果子标签之间需要保留间隔,还可以通过参数指定连接符,例如 tag.get_text(separator=' ', strip=True)。
4. 属性提取的安全性:tag['href'] vs tag.get('href')
提取超链接、图片地址等属性时,如果使用字典索引方式 tag['href'],当该标签恰好没有该属性(例如某些仅作为锚点占位的 <a name="target">)时,会抛出 KeyError。推荐始终使用字典的 .get() 方法并提供安全回退默认值:
href = tag.get('href', '').strip()
if href.startswith('http'):
    # 合法绝对路径
    pass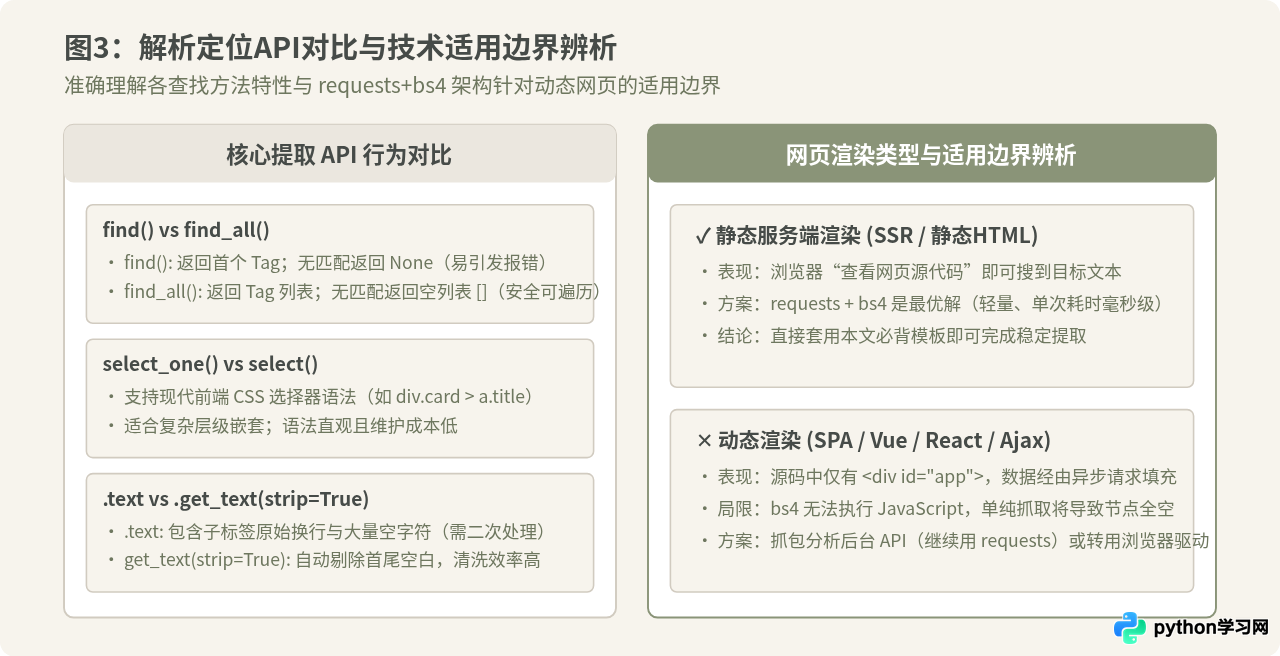
四、实战工程模板:列表数据抽取与结构化存储
为了让整套代码能够直接应用于真实的工程场景,我们以一个标准的“文章列表抓取与结构化导出”为例,将请求发送、状态防护、编码纠偏、列表遍历、节点非空过滤以及字典打包整合为完整的可运行模块:
import requests
from bs4 import BeautifulSoup
import csv
import time

def scrape_article_list(page_url):
    """
    抓取指定列表页的文章核心字段
    返回结构化字典列表
    """
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8'
    }

    results = []

    try:
        response = requests.get(page_url, headers=headers, timeout=12)
        response.raise_for_status()

        # 优先使用二进制流传入 BeautifulSoup 构建解析树
        soup = BeautifulSoup(response.content, 'html.parser')

        # 1. 定位包含所有文章项的卡片列表
        # 假定目标列表卡片类名为 'article-item'
        item_cards = soup.select('.article-item')
        if not item_cards:
            # 兼容性回退:尝试以原生 find_all 匹配
            item_cards = soup.find_all('div', class_='post-card')

        print(f"[*] 成功匹配到 {len(item_cards)} 个条目节点")

        # 2. 逐项安全抽取内部字段
        for card in item_cards:
            # 抽取标题及链接
            title_node = card.select_one('h2.title a') or card.find('a', class_='post-link')
            title = title_node.get_text(strip=True) if title_node else "无标题"
            link = title_node.get('href', '').strip() if title_node else ""

            # 抽取发布日期或作者
            date_node = card.select_one('.meta-date') or card.find('span', class_='date')
            publish_date = date_node.get_text(strip=True) if date_node else "未知日期"

            # 抽取摘要文本
            summary_node = card.select_one('.summary-text') or card.find('p', class_='excerpt')
            summary = summary_node.get_text(strip=True) if summary_node else "暂无摘要"

            # 过滤无效空记录
            if title != "无标题" and link:
                results.append({
                    'title': title,
                    'link': link,
                    'date': publish_date,
                    'summary': summary
                })

    except requests.RequestException as err:
        print(f"[ERROR] 网页抓取失败: {err}")

    return results

def save_to_csv(data_list, filename="scraped_data.csv"):
    """将清洗后的结构化数据持久化保存到CSV"""
    if not data_list:
        print("[!] 采集数据为空,跳过文件保存")
        return

    keys = ['title', 'link', 'date', 'summary']
    with open(filename, 'w', encoding='utf-8-sig', newline='') as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(data_list)
    print(f"[✓] 成功保存 {len(data_list)} 条数据至 {filename}")

if __name__ == '__main__':
    # 示例执行入口(请将URL替换为实际需抓取的合法静态页面地址)
    target_url = "https://example.com/blog/page/1"
    articles = scrape_article_list(target_url)
    save_to_csv(articles)
五、适用边界与排错速查清单
requests + bs4 之所以被称为爬虫领域的“必背基础”,是因为它以极低的资源占用解决了互联网上绝大部分静态内容的数据提取。但在投入具体项目前,必须清醒认识到它的适用边界,并遵循统一的安全防线。
| 维度 | requests + BeautifulSoup | 自动化浏览器 (Selenium / Playwright) |
|---|---|---|
| 运行开销 | 极低(纯 HTTP 传输,内存占用数兆字节) | 较高(启动完整 Chromium 内核,资源占用数百兆) |
| 单页响应时延 | 通常 0.1 ~ 0.5 秒完成请求与解析 | 需等待页面全部静态资源及脚本载入(1 ~ 5 秒) |
| JS 动态渲染能力 | 不支持(无法执行任何 JavaScript) | 完整支持(与真实用户浏览器行为一致) |
| 适用场景 | 静态博客、新闻列表、内容归档、标准API返回 | 复杂前端单页应用(SPA)、高强风控人机验证页面 |
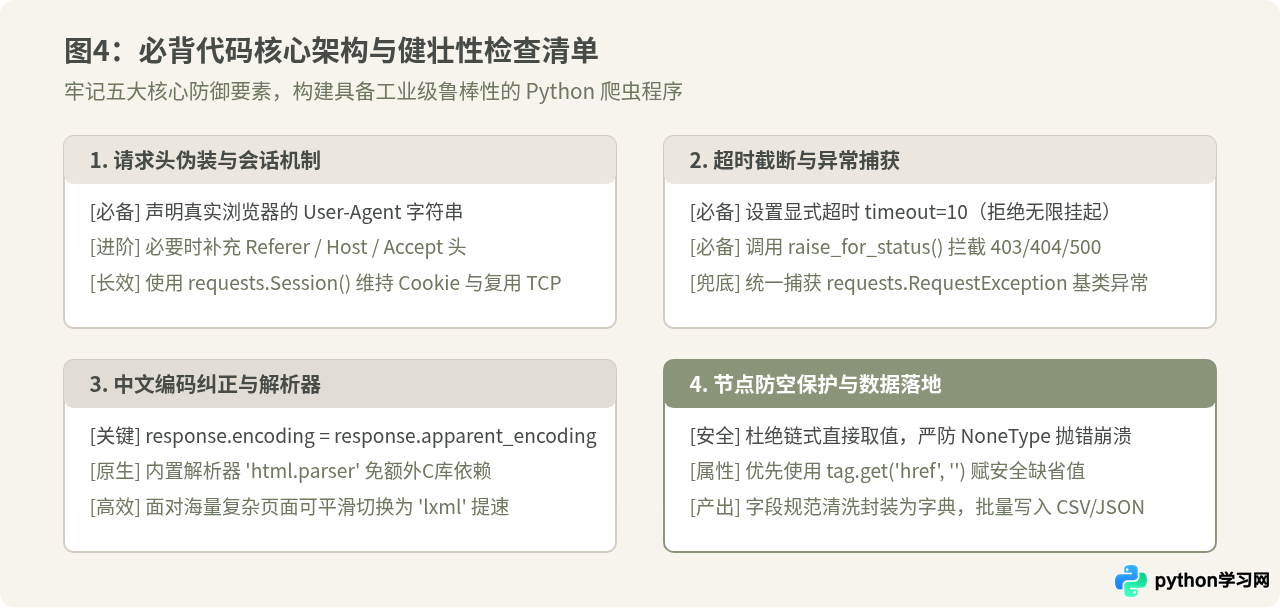
网页拿不到,先查
User-Agent 和 timeout;中文一团糟,把
apparent_encoding 或 response.content 标;解析报
NoneType,节点判空 if node is not None 不能少;源码全为空,打开开发者工具看是否是 Ajax 动态数据包。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









