

Python3.14延迟注解求值对pandas代码有什么影响?
深入解析 Python 3.14 延迟注解求值(PEP 649)对日常 pandas 数据分析代码与工程化数据验证框架的实际影响、底层原理与适配操作指南。
eval() 解析的隐患,实现更稳定可信的 DataFrame 结构校验。
一、延迟注解求值的底层机制转变
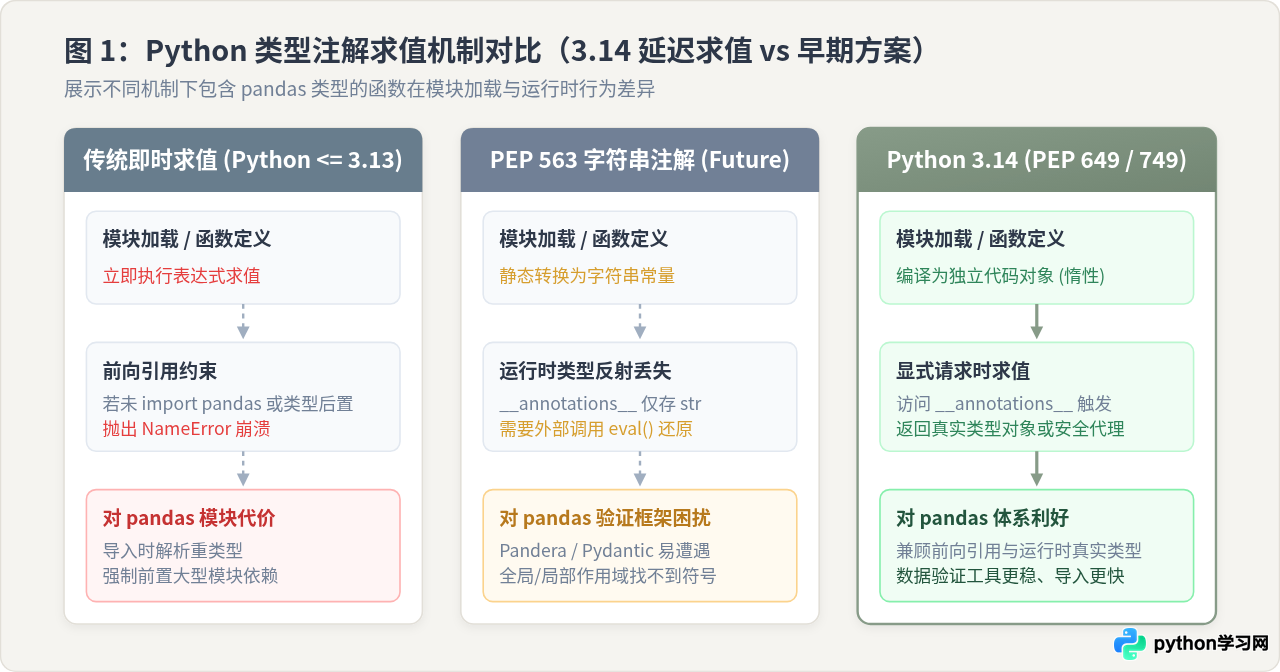
在深入探讨 pandas 代码前,需要先厘清 Python 类型注解求值方式的演化轨迹。在 Python 3.13 及更早版本中,函数或类定义上的类型注解默认在模块导入并执行该定义语句时立即计算。这意味着解释器在读到 def clean(df: pd.DataFrame): 时,会立即寻找并求值 pd.DataFrame 对象。如果该符号尚未被导入或定义在当前代码之后,就会直接抛出 NameError。
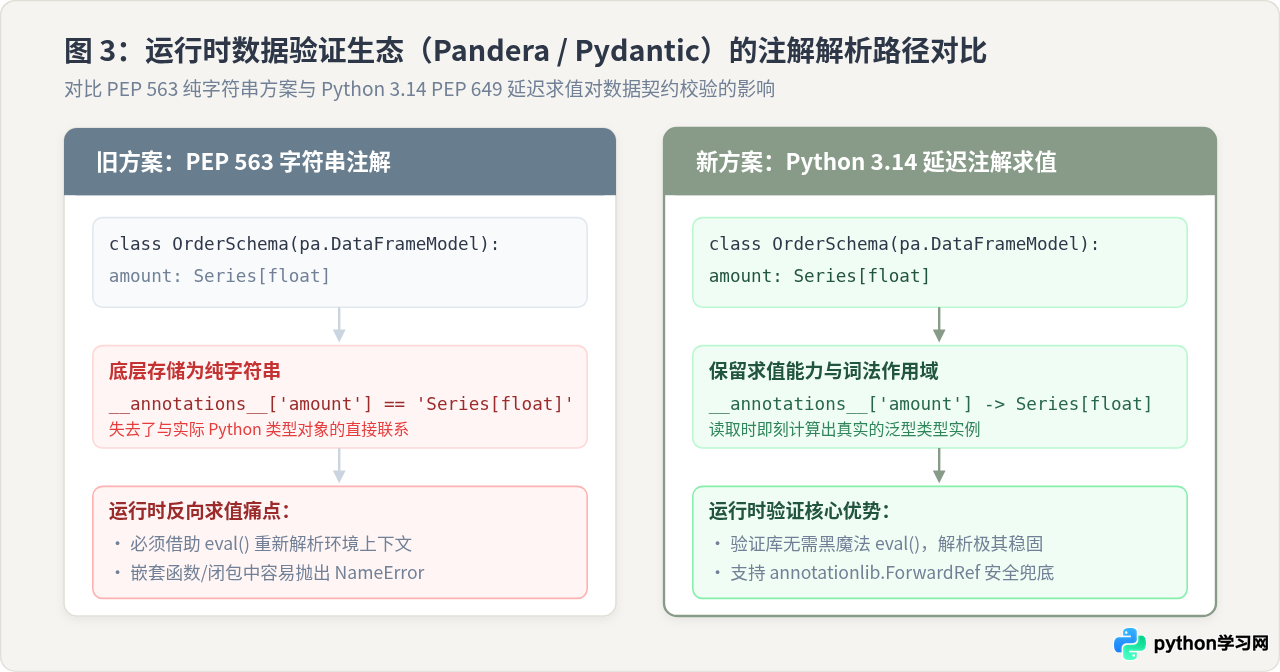
为了解决前向引用问题,社区曾在 Python 3.7 提出了 from __future__ import annotations(PEP 563),它的做法是将所有类型注解直接转换为纯静态字符串。然而,这种“字符串化”策略在解决静态检查的同时,给运行时依赖类型反射的工具(如数据校验框架、依赖注入库)带来了严重的副作用——原本的类型对象变成了单纯的文本,框架若想知道其实际类型,必须依靠 eval() 重新解析,极易丢失局部命名空间。
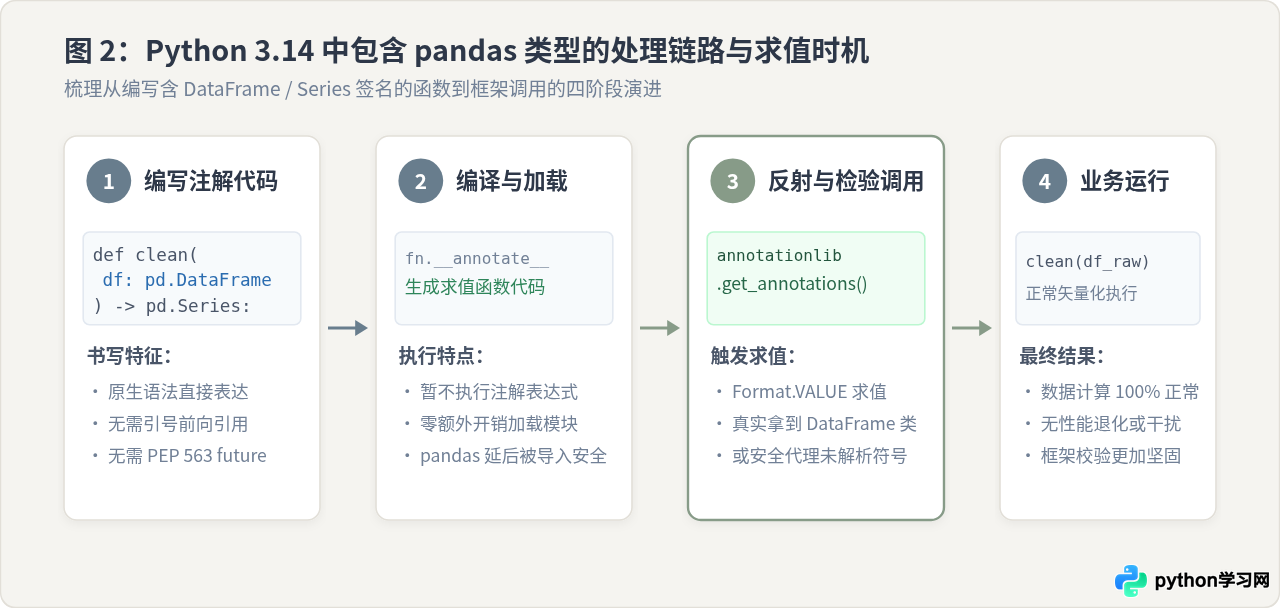
Python 3.14 确立了 PEP 649 与 PEP 749 规范,彻底改变了求值时机:当解释器解析函数或类定义时,只将注解编译为一个独立的求值代码对象(annotate function),而不执行它。只有在外部代码通过 __annotations__ 显式读取,或通过新增的 annotationlib 模块获取时,注解才会被惰性求值。
二、常规 pandas 数据分析代码的受影响情况
很多数据分析师在听到解释器内核改动时,往往会担忧既有的业务代码是否会产生兼容性异常或性能损耗。答案非常明确:纯粹的数据分析与管道代码不受任何影响。
pandas 的核心数据结构 DataFrame 与 Series,其内存布局与计算调度完全由底层的 C、Cython 以及 NumPy 数组支撑。诸如 pd.read_csv()、df.groupby()、df.merge()、df.pivot_table() 以及各类列级别的矢量化算子,在执行时完全不依赖 Python 的类型注解字典。
# 示例代码:典型的 pandas 业务清洗脚本(在 Python 3.14 下执行行为 100% 保持一致)
import pandas as pd

def process_sales_data(filepath: str) -> pd.DataFrame:
    raw_df = pd.read_csv(filepath)
    cleaned = (
        raw_df.dropna(subset=["order_id"])
              .assign(total_price=lambda d: d["quantity"] * d["unit_price"])
              .sort_values(by="order_date", ascending=False)
    )
    return cleaned

# 执行时仅涉及常规 Python 数据结构与底层数组计算,无任何反射开销
df_result = process_sales_data("sales.csv")
对于上述代码,Python 3.14 仅仅是在定义 process_sales_data 时延缓了对 str 和 pd.DataFrame 的类型内省求值,实际调用 process_sales_data("sales.csv") 进行数据流处理时,执行路径没有任何差异,耗时与内存开销也完全保持既有水平。
三、关键对比:PEP 563 字符串化 vs Python 3.14 延迟求值
为了准确评估对 pandas 工程代码的影响,我们将两种常见的注解处理状态置于同一 pandas 运行时校验场景下进行对比。
在复杂的数据工程中,开发者通常会使用 Pandera 或 Pydantic 来为 DataFrame 建立强类型的契约。例如,定义一个检验销售流水的数据模型:
import pandera as pa
from pandera.typing import DataFrame, Series

class SalesSchema(pa.DataFrameModel):
    order_id: Series[str]
    quantity: Series[int]
unit_price: Series[float]| 对比维度 | PEP 563 (from __future__ import annotations) |
Python 3.14 PEP 649 (延迟注解求值) |
|---|---|---|
| 注解内部表示 | 编译期直接固化为字符串,如 "Series[float]" |
编译为代码对象,访问时延迟执行,返回真实类型 |
| Pandera Schema 解析 | 必须使用 eval() 在当前模块全局空间中寻找 Series 与 float |
直接调用注解代码对象,原生获取真实的 pandera.typing.Series[float] |
| 局部闭包或嵌套作用域 | 若在工厂函数内部定义 Schema,eval() 无法获取外层局部变量,易抛出 NameError |
完整保留定义时的闭包作用域(Lexical Scoping),求值过程稳定无虞 |
| 前向引用支持 | 支持任意尚未导入的符号(本质上就是字符串文本) | 支持未求值符号;当符号不存在时可通过 annotationlib.Format.FORWARDREF 安全处理 |
从对比可以看出,这一差异对以数据契约为核心的 pandas 库极其关键:PEP 563 破坏了 Python 原生反射语义,而 Python 3.14 的延迟求值在保留前向引用便利的同时,恢复了真实的 Python 对象引用,彻底杜绝了框架在幕后使用危险的 eval() 解析引发的暗病。
四、实际受益场景与潜在适配事项
在理解了原理之后,我们将视角投向具体的开发场景,观察 Python 3.14 延迟注解为 pandas 项目带来的切实收益与需要留意的细节。
1. 模块冷启动(Import)耗时轻微降低
大型企业级数据管道往往拥有几十个由类型提示组织的数据处理步骤。在旧版本 Python 中,导入含有复杂泛型注解的模块时,解释器必须在 import 阶段逐个解析 pd.DataFrame、pa.typing.DataFrame[Schema] 以及 Union[...]。在 Python 3.14 下,这些求值全被推迟到真正被内省时执行;如果整个执行周期仅调用函数而不反射注解,模块加载耗时会有可见的优化。
2. 前向引用与类型解耦更为自然
编写返回自定义 DataFrame 包装类或自引用类型的函数时,以前需要加上字符串引号(如 -> 'CustomDataFrame')或者开启 future 标志。在 Python 3.14 中,只要在调用 __annotations__ 前该类已经定义,就可以直接使用原生语法书写,代码阅读体验与编写流畅度更高。
3. 自定义元编程与装饰器适配(需主动关注)
如果你的团队自研了基于函数类型注解的 DataFrame 自动缓存、流水线编排装饰器,需注意:不要再假设 fn.__annotations__ 包含的是字符串(如使用了 PEP 563),也不要随意用 eval() 去解析。
annotationlib.get_annotations() 代替直接读取裸字典。它提供了清晰的格式参数:
annotationlib.Format.VALUE:执行实际求值,获取类型对象;annotationlib.Format.FORWARDREF:若遇到未定义的符号,安全封装为 ForwardRef 代理,不触发崩溃;annotationlib.Format.SOURCE:返回原始代码字符串(主要用于文档工具)。
五、工程项目排查与平滑升级步骤
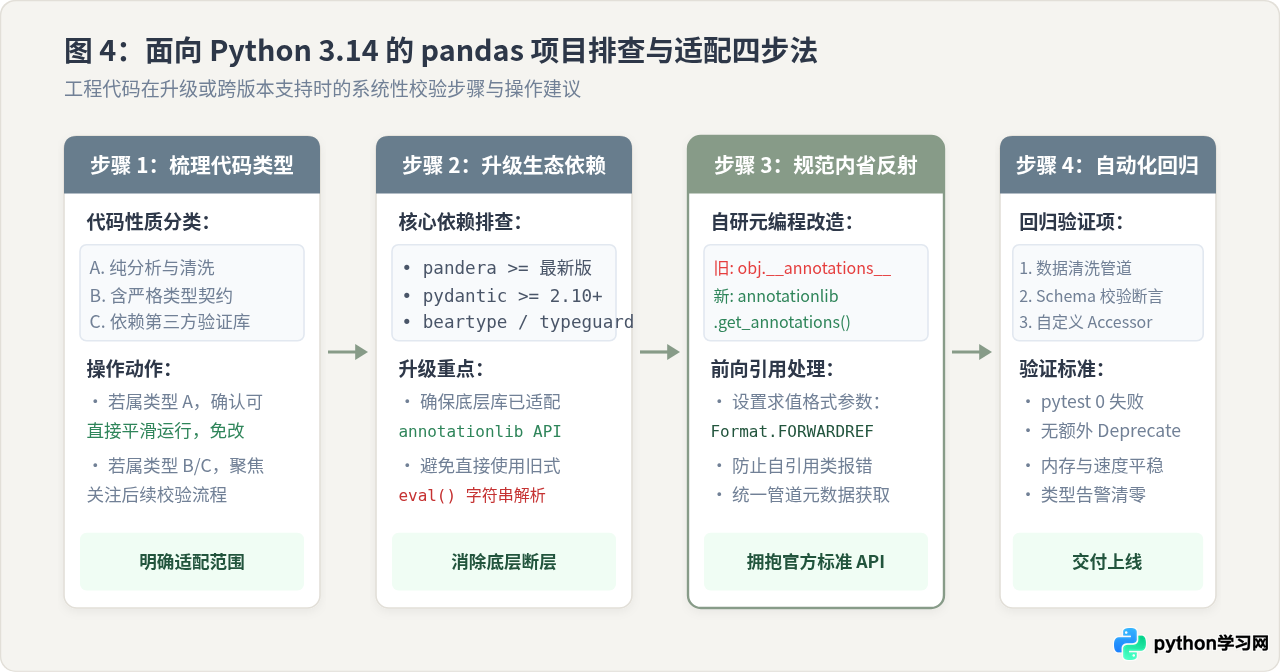
为了保证包含类型标注的 pandas 数据工程在 Python 3.14 环境下平稳运转,建议按照以下具体步骤进行检查与验证。
-
步骤 1:排查第三方数据验证库的版本兼容性
如果项目中使用了pandera、pydantic、beartype或typeguard,应确认所安装的版本已经具备对 Python 3.14 的适配更新。现代验证库已经内置了对annotationlib的检测支持。 -
步骤 2:清理不必要的
from __future__ import annotations
检查模块头部,逐步清理不再需要的旧式 future 导入语句。让代码平滑过渡到 Python 3.14 原生支持的延迟表达式求值状态。 -
步骤 3:更新自研内省代码
搜索代码库中所有直接访问.__annotations__的位置。将其重构为annotationlib.get_annotations(obj, format=annotationlib.Format.VALUE)或通用的inspect.get_annotations(),并增加对异常前向引用的兜底。 -
步骤 4:运行自动化测试套件回归验证
执行完整单元测试,重点关注数据管道入口与出口的 Schema 校验断言,确保 DataFrame 输入输出均符合预期,且没有抛出未捕获的内省弃用警告。
六、全景总结与开发者建议
总结而言,Python 3.14 的延迟注解求值是 Python 语言在类型系统设计上的一次重要修正。它兼顾了“避免定义期过度求值与前向引用报错”与“保留运行时真实类型内省能力”两大诉求。
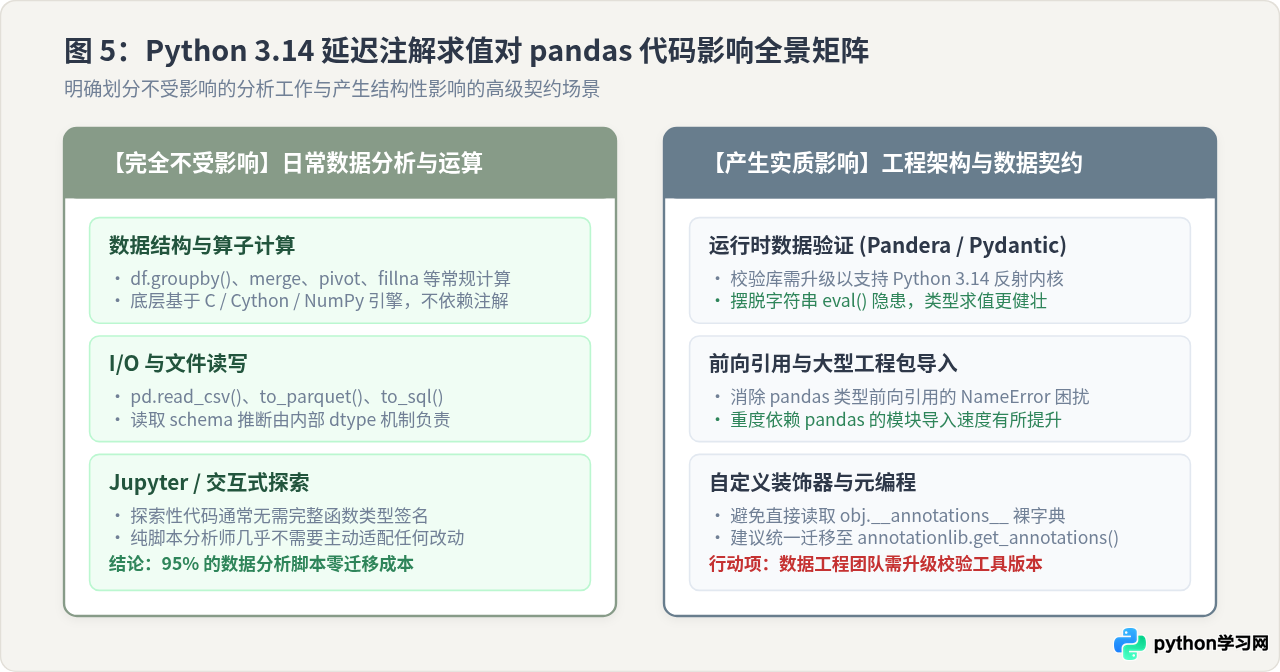
- 日常数据分析师 / 算法工程师:完全不必担忧。现有的 pandas 算子、Jupyter 笔记本与数据脚本均可直接平滑运行,无需更改任何业务代码。
- 数据工程架构师 / 平台开发者:及时跟进 Pandera、Pydantic 等上游依赖的更新版本;如果团队内部维护了带有 DataFrame 类型反射的公共工具库,使用
annotationlib规范替换掉直接操作__annotations__的旧逻辑即可。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









