

Python适合做什么项目?从网站搭建到机器学习的适用范围
全面梳理Python在Web网站开发、数据分析与机器学习、自动化脚本及网络爬虫等领域的核心适用场景,并明确给出不推荐使用Python的边界与技术选型建议。
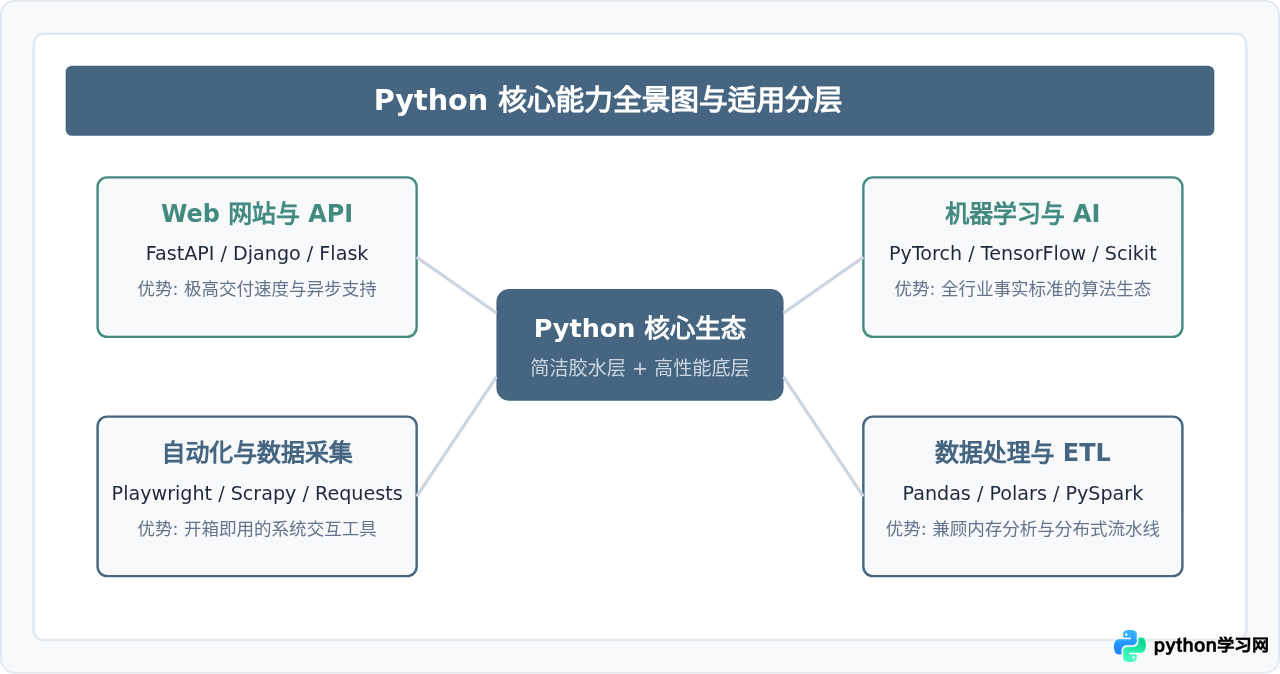
Python最适合以开发效率、数据流通与快速验证为核心目标的工程项目,典型领域包括Web服务与API搭建、机器学习与数据分析、运维自动化脚本以及网络数据采集。而在极度追求毫秒级延迟、硬件资源极度受限或底层图形引擎渲染的场景中,Python则不是首选。理清其强项与边界,是技术选型避免走弯路的关键。
一、Web 网站与服务搭建:框架选型与实战定位
很多开发者初学 Python 时会产生疑问:既然 Python 解释执行相对较慢,为什么还能支撑大型商业网站?答案在于现代化 Web 系统的瓶颈通常出现在数据库 I/O 和网络传输上,而非单纯的 CPU 运算。Python 的优势在于能以极短的开发周期交付稳定的接口和业务逻辑。
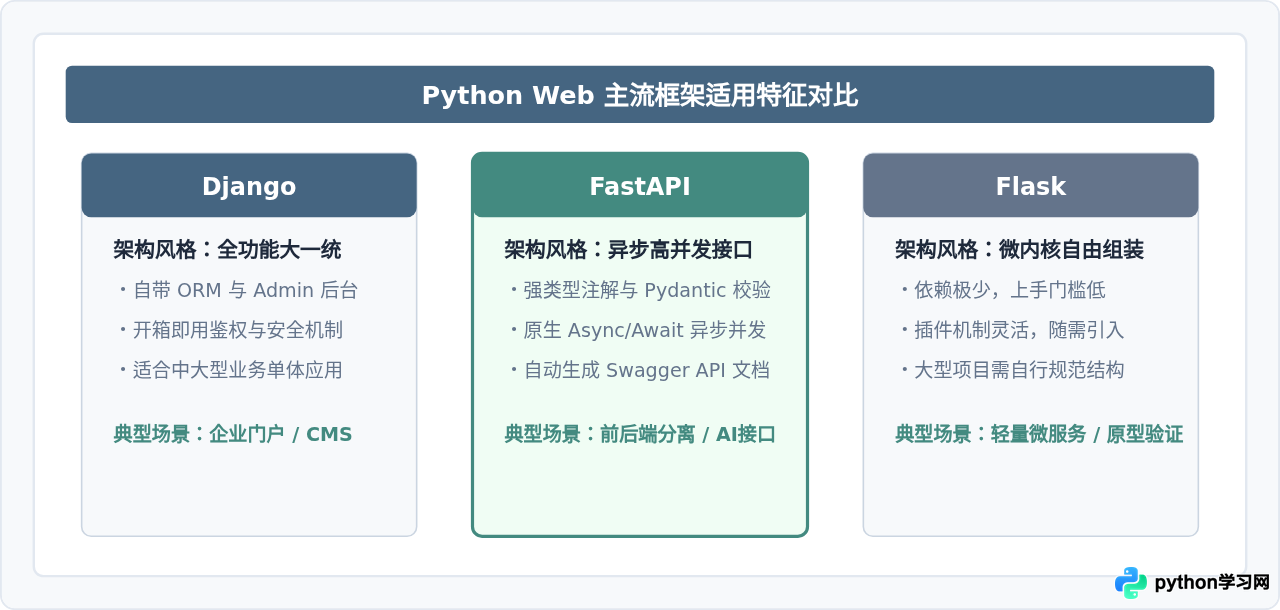
在实际搭建网站时,框架的选型直接决定了工程的落地效率。目前主流的三大框架各有明确的分工:
- Django(全功能全栈框架):内置了完善的 ORM、身份认证、表单验证与管理后台。适合内容管理系统(CMS)、企业内部管理系统、SaaS 平台等重数据管理的业务。
- FastAPI(现代异步微服务):基于 Python 3.8+ 类型提示和 Starlette 异步运行时,自动生成交互式 OpenAPI 文档。特别适合为前后端分离项目提供 RESTful API,或为机器学习模型封装推理服务。
- Flask(极简轻量级微服务):仅保留路由和请求上下文,扩展库完全自由搭配。适合单文件原型实验、边缘小工具或小型内部查询网关。
例如,使用 FastAPI 构建一个具备自动入参校验与异步响应的数据服务,代码仅需数行:
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="用户状态查询服务")

class QueryPayload(BaseModel):
    user_id: int
    query_type: str = "summary"

@app.post("/api/v1/user-info")
async def get_user_info(payload: QueryPayload):
    # 模拟异步处理数据库或上游接口
    return {
        "code": 200,
        "user_id": payload.user_id,
        "status": "active",
        "detail": f"Query executed for {payload.query_type}"
}实战建议:如果是构建企业信息化系统或需要管理后台的复杂应用,首选 Django;如果目标是给前端 Vue/React 或移动端 App 提供高性能纯 API 接口,首选 FastAPI。
二、机器学习与数据分析:全生命周期的工业标准
在人工智能和机器学习工程中,Python 拥有绝对的话语权。其核心原因并不是 Python 自身的单线程执行速度快,而是它充当了极为优秀的“语法包装胶水”——上层的 Python 代码调用的是底层的 C/C++、CUDA 与 Fortran 高性能动态链接库。
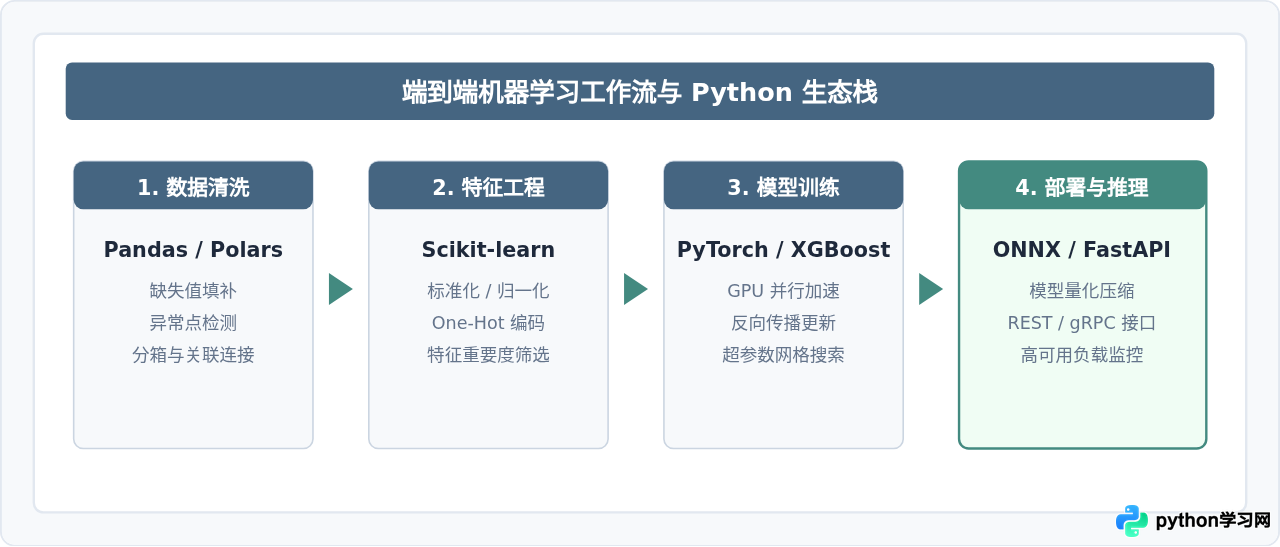
一个标准的机器学习工业项目通常经历四个阶段,Python 在每个阶段都有对应的主导工具:
- 数据清洗与探索分析:使用 Pandas 进行表格数据过滤、透视与时间序列对齐,利用 NumPy 进行密集矩阵向量运算。
- 特征工程与统计建模:使用 Scikit-learn 进行标准化、降维、交叉验证及传统分类/回归模型(如随机森林、支持向量机)训练。
- 深度学习与大模型微调:使用 PyTorch 构建自定义神经网络架构,利用 Hugging Face Transformers 生态库加载预训练权重并完成模型微调。
- 模型封装与在线服务化:将导出的 ONNX 或 PyTorch 权重通过 FastAPI/Triton 封装成标准 HTTP/gRPC 推理接口供业务侧调用。
三、自动化运维与数据采集:不可替代的提效利器
在日常开发和企业运维中,大量重复、繁琐的手工流程可以通过 Python 脚本固化下来。Python 拥有丰富的系统库(如 os、subprocess、shutil)以及完善的第三方生态,使其成为自动化领域事实上的通用语言。
1. 自动化任务与系统运维
无论是定时同步跨云存储文件、定期轮转分析服务日志,还是调用 Ansible API 批量配置服务器集群,Python 都能在数十行代码内实现稳健的异常捕获与重试机制。
2. 网络数据采集与爬虫
对于公开结构化或半结构化数据的定向聚合,Python 的生态层级分明:
- 轻量级静态采集:使用
requests或httpx获取页面 HTML,配合BeautifulSoup4提取 DOM 节点。 - 复杂动态渲染采集:使用
Playwright或Selenium驱动无头浏览器执行 JavaScript,获取单页应用(SPA)渲染后的完整页面或拦截网络 XHR/Fetch 报文。 - 高并发工程化框架:使用
Scrapy处理分布式抓取队列、中间件过滤、自动限速与管道持久化。
四、项目选型四步决策法:什么时候该用 Python?
技术选型本质上是团队在“开发速度”与“运行效率”之间的权衡。为了在立项初期明确是否采用 Python,可以遵循以下四步评估流程:
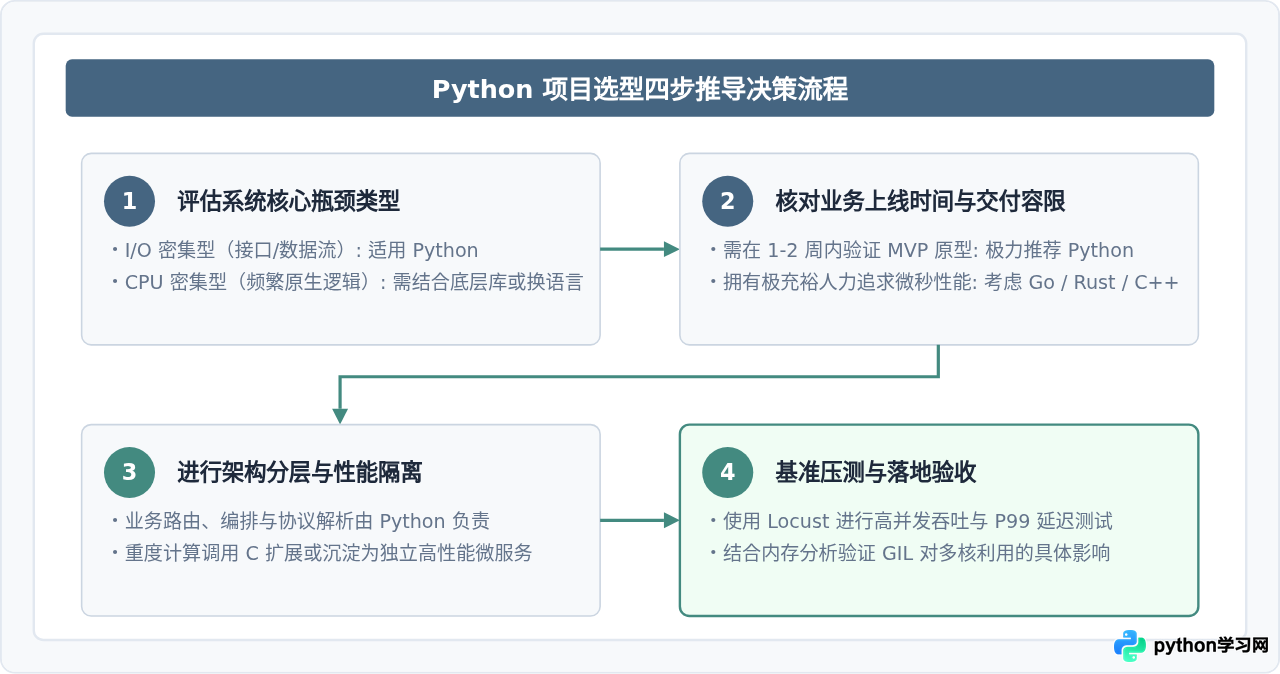
五、明确边界:哪些项目不适合或需谨慎使用 Python?
没有任何一门编程语言能够在所有维度胜任。识别 Python 的技术边界,有助于避免在错误的方向上浪费架构重构成本。
1. 3D 商业游戏与底层图形引擎
大型游戏引擎(如 Unreal、Unity 底层)对帧率稳定性、实时垃圾回收控制与缓存命中率有苛刻要求。Python 动态对象的内存开销过大,且全局解释器锁(GIL)不利于细粒度线程管理。主流游戏开发仅将 Python 用于编辑器插件或自动化编译管道脚本,而非运行时核心引擎。
2. 高频交易(HFT)与超低延迟系统
在高频撮合交易中,延迟单位以微秒甚至纳秒计。Python 的动态分发机制和自动垃圾回收(GC)引起的偶发停顿无法满足确定性时间要求。此类系统通常由 C++、Rust 编写,并配合内核旁路(Kernel Bypass)网卡运作。
3. 极度受限的单片机与嵌入式设备
虽然 MicroPython 和 CircuitPython 降低了硬件编程的学习门槛,但在工业级、极小内存(例如仅有几十 KB RAM)的 MCU 芯片上,C/C++ 或 Rust 仍然是不可动摇的选择。
避坑提醒:移动端原生 App(iOS/Android 界面开发)同样不建议采用 Python。虽然有 Kivy 等方案,但在系统交互体验、应用包体积以及平台审核兼容性方面,均不如 Swift、Kotlin 或 Flutter/React Native 成熟。
六、适用性与技术选型决策总结矩阵
综合以上分析,下表将常见业务方向的推荐度、选用原因以及替代技术路径进行系统归纳:
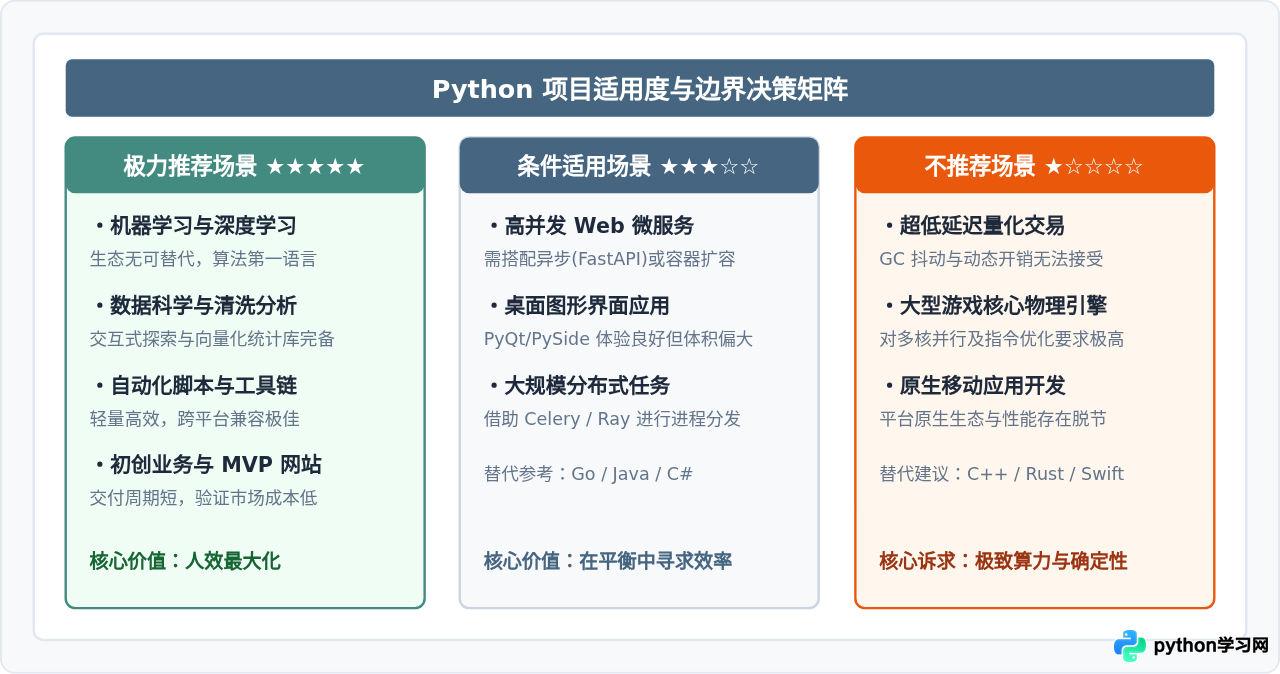
| 项目类型 | 推荐程度 | 核心框架 / 工具库 | 选型关键理由 |
|---|---|---|---|
| 企业管理网站与内容平台 | 强烈推荐 | Django, Django-REST-Framework | 自带 Admin 与用户权限系统,大幅缩减基础轮子代码 |
| 高并发 API 与微服务 | 推荐 | FastAPI, Uvicorn | 异步支持良好,自动类型验证与文档生成,契合现代前端 |
| 机器学习与 AI 模型服务 | 行业标准 | PyTorch, Scikit-learn, ONNX | 算力依赖 底层 C/CUDA,上层胶水层开发体验无可替代 |
| 网络数据采集与清洗 | 强烈推荐 | Playwright, Scrapy, BeautifulSoup4 | 针对各类动态反爬与复杂 DOM 解析有完备的开源方案 |
| 高频交易撮合与硬件驱动 | 不推荐 | — | 解释器开销与垃圾回收停顿无法满足微秒级确定性响应 |
总结而言,Python 的核心竞争力在于最大化开发者的单位时间产出。当业务处于探索期、迭代频繁,或者核心逻辑偏向于调度成熟底层算法与外部 I/O 资源时,Python 几乎总是最稳妥且高效的选择;而当项目的物理瓶颈明确落在机器本身的指令吞吐与内存极限上时,则应当坚决采用 Go、Rust 或 C++ 等底层语言进行专项突破。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









