

在线Python编程有哪些性能与功能限制?
深入解析在线Python编程环境在算力配额、执行超时、文件持久化、网络通信与系统调用等维度的性能与功能限制,详细剖析远程容器沙箱与浏览器端Wasm的架构差异,并提供环境探测方法与本地迁移指引。
一、架构分野:远程容器沙箱与浏览器端Wasm的本质差异
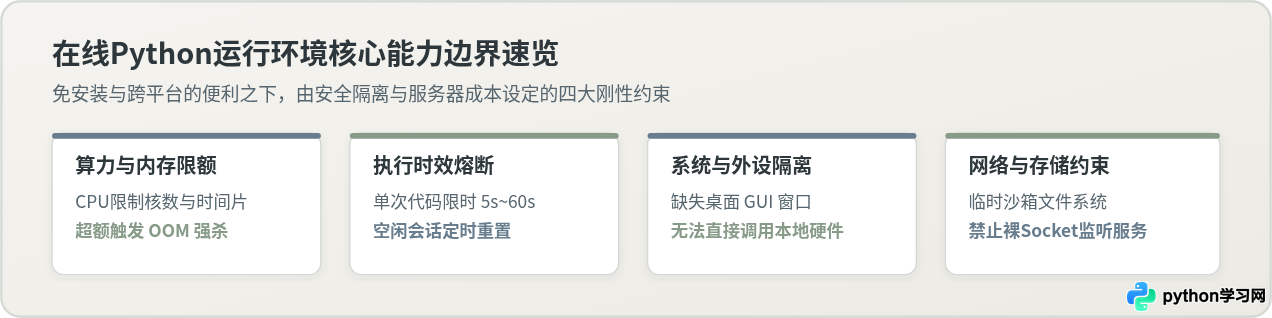
探讨在线Python的限制,不能脱离具体的运行架构。当前主流的在线Python平台在技术路线上分为两大阵营:一种是远程容器沙箱架构(如Google Colab、Replit、各大在线代码评测OJ平台),另一种是浏览器端WebAssembly架构(如基于Pyodide的JupyterLite、各类纯前端演示工具)。在一致的硬件观察条件下,两者的工作原理不同,导致性能瓶颈与功能受阻的根源也截然不同。
| 比较维度 | 远程容器沙箱 (Server-side) | 浏览器端 WebAssembly (Client-side) |
|---|---|---|
| 代码执行宿主 | 服务商集群中的Linux容器(Docker/Pod) | 读者本地浏览器的JavaScript/Wasm虚拟机 |
| 主要算力制约 | 平台服务端设定的CPU时间配额与内存硬限制 | 读者个人设备的单核CPU性能与浏览器进程限制 |
| 并发与多进程 | 支持multiprocessing,但受vCPU核数严格限制 |
完全不支持多进程(无法调用os.fork) |
| 第三方C扩展 | 支持绝大部分预编译为Linux ELF的第三方库 | 仅支持预先交叉编译为Wasm静态架构的库 |
| 网络与套接字 | 可发起外部HTTP请求,但禁止监听低位Socket服务 | 受浏览器同源策略限制,无原生裸TCP Socket |
| 环境启动与成本 | 需排队分配云端容器,闲置超时会被回收 | 纯前端秒级加载,计算资源全部在本地消耗 |
区分这一差异之所以重要,是因为当代码在在线环境报错时,原因往往直接由架构决定。例如,同样是运行multiprocessing.Pool(),在远程容器沙箱中通常可以正常启动(仅仅是因CPU核数较少加速不明显),而在基于Pyodide的纯前端环境中则会直接抛出NotImplementedError或OSError。
二、性能限制的具体表现与边界探测
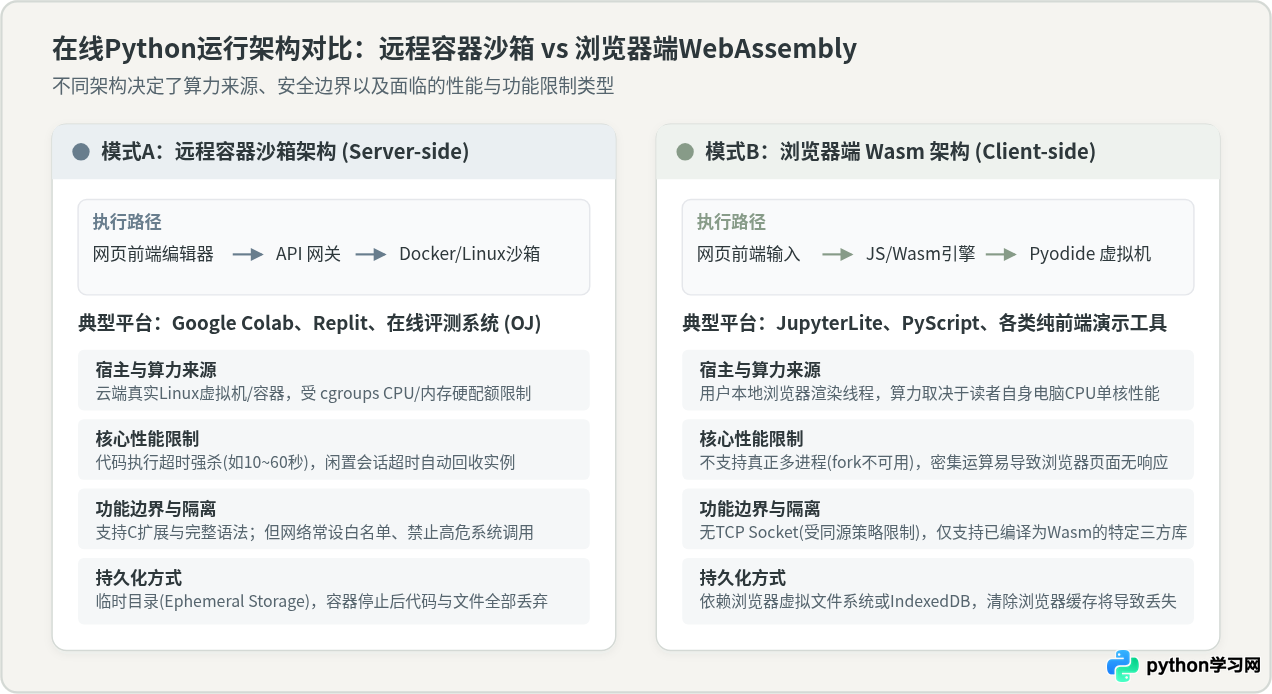
在性能维度上,在线环境设置了多道刚性红线,以防止个别脚本占用过多共享资源。最常见的性能瓶颈包含以下四个方面:
1. 内存配额熔断(OOM Kill)
在线平台通常为每个运行实例分配固定的物理内存上限(免费版容器通常在512MB至2GB之间,轻量OJ评测平台通常仅有64MB至256MB)。当代码尝试一次性读取数百万行的大型CSV文件、构建深度递归树或创建超大NumPy数组时,一旦瞬时内存超过配额,宿主系统的cgroups机制会直接向Python进程发送SIGKILL(信号9)强行终止进程。
在界面上的直观表现通常不是捕获到友好的MemoryError,而是控制台突然显示“Kernel died”、“进程被终止”或“Out of Memory”,未保存的中间变量会瞬间丢失。
2. 单次执行超时与空闲连接断开
为防止无限死循环或恶意占用,几乎所有在线运行平台都配置了严格的执行时间看门狗:
- 单次执行超时(Execution Timeout):常见的交互式平台通常限制单次代码运行在15秒到60秒以内;即使是支持数据分析的云端Notebook,若单个Cell连续执行超过固定时长(如数小时或平台额度耗尽),任务也会被强制中断。
- 空闲释放超时(Idle Timeout):若网页与后端服务中断通信超过一定时间(如15分钟至60分钟无操作),云端容器会自动销毁,临时内存状态全部清空。
3. 多线程与并发加速受限
由于Python全局解释器锁(GIL)的存在,计算密集型任务通常依赖multiprocessing多进程。但在在线容器中,平台分配的往往是共享vCPU(例如仅分配0.5核或1核算力)。此时开启多个工作进程不仅无法带来成倍加速,反而会因为进程上下文切换和频繁的锁竞争导致整体运行变慢。在WebAssembly环境中,多进程更是一项完全不可用的特性。
实操:如何探测当前在线环境的资源天花板
通过一段简洁的标准探测脚本,可以快速查明当前所在环境的操作系统、架构、CPU核心数和可用内存范围。在终端或代码单元格中输入如下代码:
import sys
import os
import platform
import time

def probe_environment():
    print("=== 基础环境与解释器探测 ===")
    print(f"操作系统标识 (sys.platform): {sys.platform}")
    print(f"系统架构 (platform.uname): {platform.uname()}")
    print(f"Python解释器版本: {sys.version.split()[0]}")
    print(f"系统指针位数: {64 if sys.maxsize > 2**32 else 32} 位")

    print("\n=== 并发与CPU核心感知 ===")
    cpu_count = os.cpu_count()
    print(f"感知到的逻辑CPU核心数: {cpu_count}")

    print("\n=== 内存配额安全测试 ===")
    # 尝试阶梯式申请内存,测试上限容忍度(以100MB为步长)
    chunks = []
    allocated_mb = 0
    try:
        for i in range(1, 11):
            chunks.append(b" " * (100 * 1024 * 1024))
            allocated_mb += 100
            print(f"已成功申请内存: {allocated_mb} MB")
    except MemoryError:
        print(f"触达内存上限!在分配 {allocated_mb + 100} MB 时触发 MemoryError")
    except Exception as e:
        print(f"内存测试异常: {e}")
    finally:
        del chunks

if __name__ == "__main__":
    probe_environment()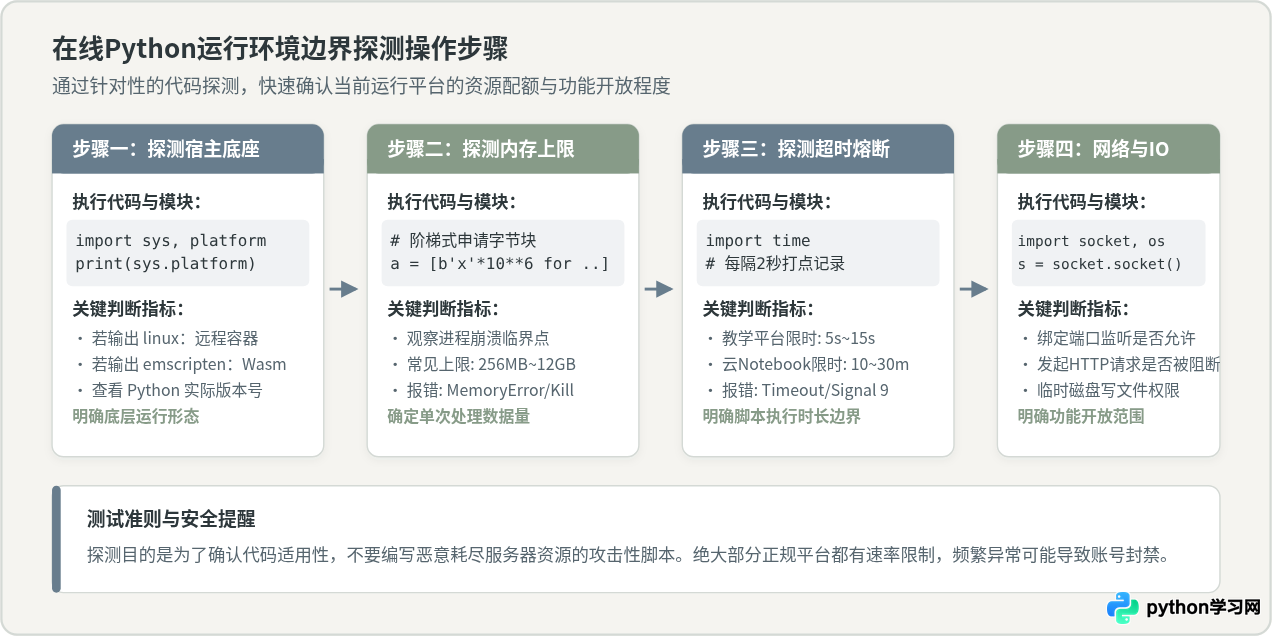
三、功能维度的四大边界与安全隔离机制
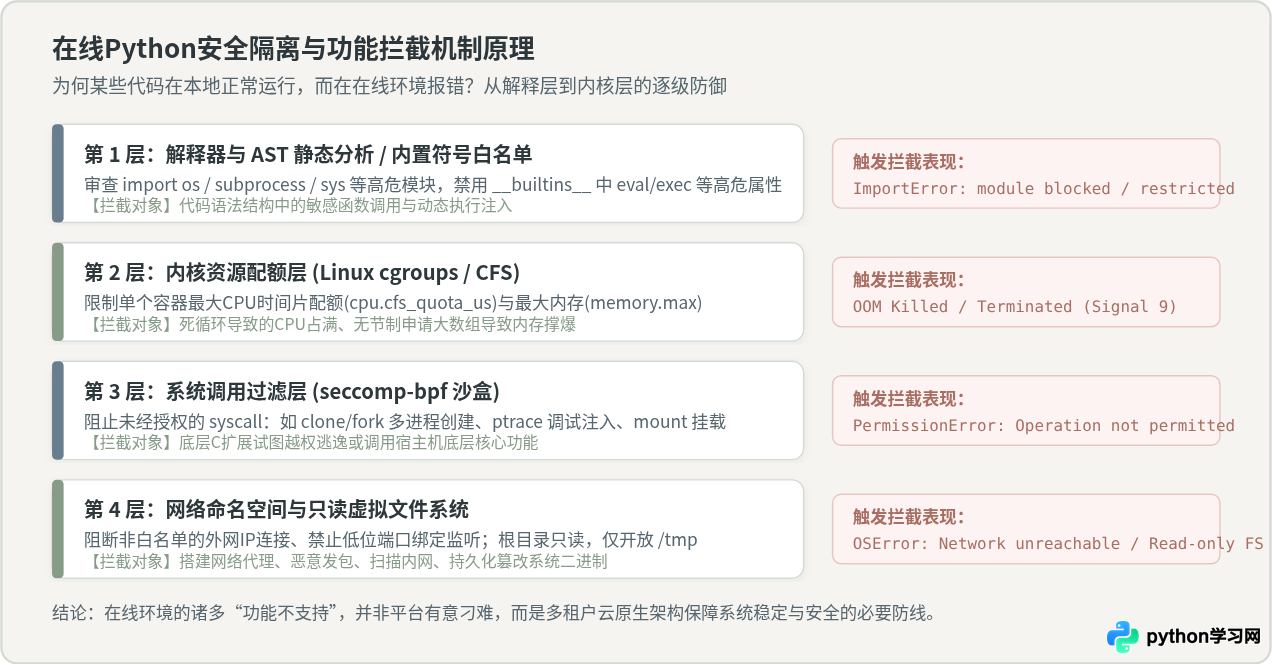
除了计算资源限额,在线环境在系统功能调用方面也受到了多层安全沙箱的深度拦截。本地Python程序能够轻易调用的底层API,在网页端运行平台中往往无法正常工作。
1. 本地文件系统与数据持久化限制
在线Python环境普遍运行在隔离的临时存储(Ephemeral Storage)之上。这意味着:
- 路径虚拟化:程序无法直接访问读者真实计算机上的本地磁盘目录(例如Windows的
C:\Users或macOS的/Users/name)。若要处理本地文件,必须先通过网页界面的“上传”功能将文件传到云端沙盒中。 - 生命周期短暂:保存在沙盒工作目录下的文件只在当前会话生命周期内有效。一旦刷新页面、容器重启或会话超时断开,所有未手动下载到本地的数据都会永久丢失。
- 只读限制:为了避免系统核心文件被破坏,Linux根目录
/、系统二进制目录/usr/bin通常被挂载为只读文件系统,用户代码仅拥有在特定目录(如/tmp或/home/sandbox/)有限容量的写权限。
2. 原生桌面GUI与图形窗口缺失
初学者在学习Python GUI开发时,常会尝试运行以下代码:
import tkinter as tk
root = tk.Tk()
root.title("测试窗口")
root.mainloop()
在绝大部分在线环境中,该代码会立即抛出_tkinter.TclError: no display name and no $DISPLAY environment variable错误。原因在于云端Linux服务器默认没有运行X11或Wayland图形视窗服务,也没有物理显示器。原生桌面GUI库(如Tkinter、PyQt、PySide、wxPython)无法直接生成窗口。
matplotlib绘图时配合%matplotlib inline内嵌到网页,或者使用ipywidgets、Plotly生成基于浏览器DOM渲染的交互式HTML控件。
3. 底层硬件与外设调用隔离
在线Python代码运行在远端虚拟化容器或浏览器受限沙箱中,物理上切断了与本地硬件设备的连接。代码无法通过serial.Serial()直接读取连接在本机USB接口的Arduino或单片机,无法调用cv2.VideoCapture(0)调用本地物理摄像头,也无法直接捕获声卡音频输入。如果涉及硬件交互、机器人控制或低延迟音视频采集,在线环境并不具备适用的硬件通道。
4. 原始网络套接字(RAW Socket)与服务监听阻断
为防止服务器被滥用为跳板机、DDoS攻击源或未授权的网络代理,在线平台对网络进行了严格的策略限制:
- 禁止端口监听:尝试使用
socket.bind(('0.0.0.0', 8080))在容器内创建服务端时,由于未开放外部端口映射或缺少系统权限,通常会返回PermissionDenied错误。 - 出站流量审计:许多面向教育与机考的平台对外部网络访问实行全封闭,禁止调用
urllib或requests向外部互联网发起HTTP连接;部分开放网络的平台也会拦截非标准端口或高风险域名的连接。
四、避坑指引:如何规避在线限制与何时迁移本地
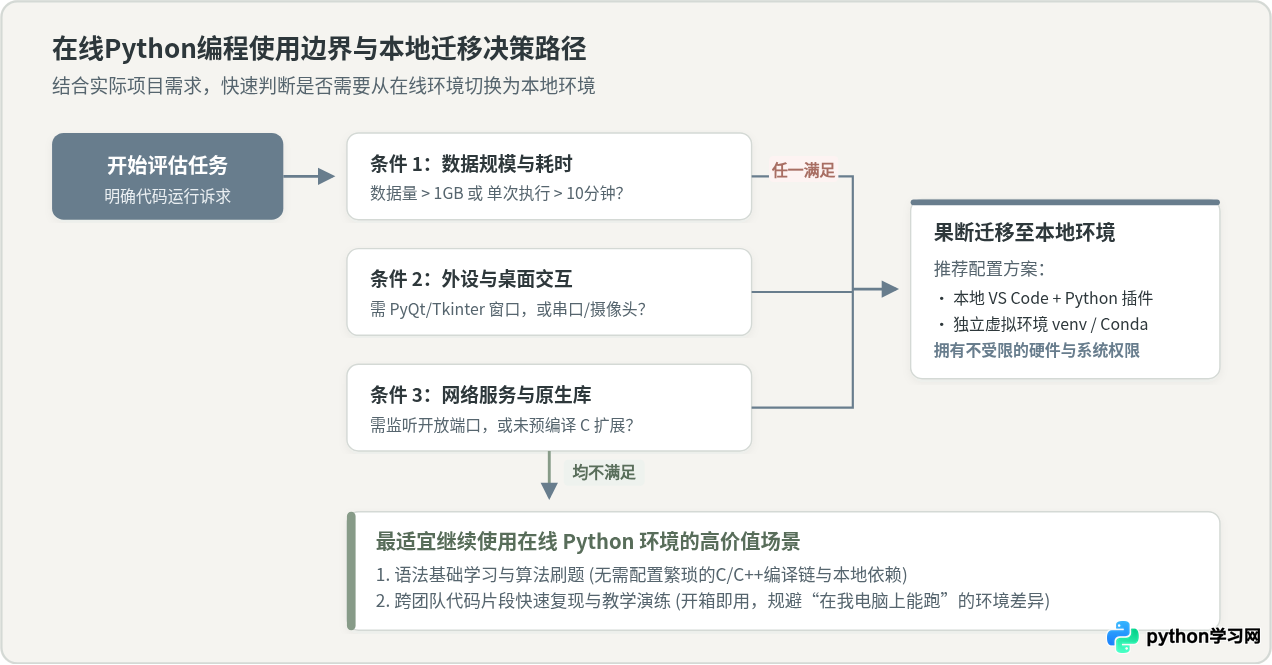
了解在线Python的限制,并不是为了全盘否定在线工具的价值,而是为了在正确的场景使用最恰当的工具。根据开发目标,可以采取对应的规避技巧,或在必要时果断迁移至本地环境。
1. 在线环境的最佳实践技巧
- 数据切片调试:面对几百兆的生产数据集,在在线环境中调试时,使用
pandas.read_csv('data.csv', nrows=1000)只读取前一千行进行逻辑验证,规避OOM崩溃。 - 善用外部持久化挂载:在Google Colab等支持云存储挂载的平台中,通过
google.colab.drive.mount()将计算结果实时写入网盘,防止容器断连导致工作丢失。 - 改用Web原生可视化:将传统的GUI交互转为Jupyter的交互小部件(IPython Widgets)或基于前端输出的动态图表,避免调用桌面视窗系统。
2. 必须迁移至本地环境的四种典型信号
当项目出现以下任何一种特征时,继续在在线环境调试通常会带来极高的沟通与调试成本,应果断迁移至本地操作系统(如本地配置VS Code、PyCharm搭配Conda/venv环境):
- 持续运行与后台常驻任务:需要编写长期运行的网络爬虫、定时同步脚本或需要常驻后台的API微服务。
- 硬件外设与系统级开发:需要连接串口设备、操作本地蓝牙、编写本地自动化鼠标键盘脚本(如
pyautogui),或开发带本地桌面窗口的客户端软件。 - 重度计算与超大数据集处理:模型训练需要持续数小时以上、数据集大小超过单机物理内存限制,或需要完全榨干本地GPU的多卡并行计算。
- 深度定制C/C++编译依赖:依赖尚未预编译为通用Wheel包的底层库,需要在本地操作系统配置特定的GCC/Clang工具链与动态链接库(.so/.dll)。
五、常见问题排查与注意事项
1. 为什么在在线平台执行 pip install 提示权限错误?
在线容器中,系统目录/usr/lib/python3/dist-packages通常归属于root账户,而用户代码以低权限普通用户身份运行。如果在执行pip install时未添加参数,可能会出现Permission denied。
解决方法:在命令后加上--user参数,例如执行pip install --user package_name,将依赖安装至当前用户的沙箱家目录下;或者在支持Notebook魔法命令的环境中使用%pip install package_name。
2. 代码在在线平台画完图后没有任何显示,也不报错?
这是使用Matplotlib等绘图库时最普遍的问题。在本地执行时,plt.show()会唤起桌面窗口;而在无显示环境(Headless)的云端,GUI后端无法渲染。
解决方法:在代码最上方显式配置无视窗后端,并将图片保存到文件或直接内嵌展示:
import matplotlib
matplotlib.use('Agg')  # 设置为无GUI的后端模式
import matplotlib.pyplot as plt

plt.plot([1, 2, 3], [4, 5, 6])
plt.savefig('output.png')  # 将图表保存为文件,从文件浏览器下载查看
3. 在线平台执行多进程 multiprocessing 为什么卡住不动?
在类Unix容器中,Python 3.8及更高版本在多进程启动方式(start method)上对线程安全有严格要求;若平台本身基于Pyodide/Wasm,多进程根本无法使用。
解决方法:首先确认环境是否为Wasm环境(参考前文探测脚本)。若为容器环境,可尝试在入口处将启动方式显式声明为forkserver或spawn,并严格包裹在if __name__ == '__main__':作用域内。若仍无法稳定运行,建议将任务重构为基于concurrent.futures.ThreadPoolExecutor的轻量并发或迁移至本地。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









