

Scrapy框架实战:构建高效Python大规模爬虫项目
深入解析Scrapy底层异步事件驱动架构,从高并发配置、分布式调度改造、反爬中间件设计到异步持久化入库,全流程构建稳定高效的大规模Python爬虫工程。
在大规模网络数据采集任务中,单机多线程或单纯依赖 requests 编写的脚本极易在数十万乃至上千万级 URL 面前崩溃。面对网络抖动、DNS 瓶颈、目标站点频控以及数据库写入延迟,爬虫系统必须具备事件驱动的高吞吐调度能力与容错架构。Scrapy 依托底层的 Twisted 异步网络引擎,天然支持非阻塞 I/O,是构建企业级海量爬虫项目的基石。本文将从核心架构运行流转出发,层层拆解并发参数调优、分布式队列解耦、反爬攻防中间件设计与防阻塞异步入库,提供一套可直接应用于生产环境的大规模爬虫解决方案。
一、Scrapy 异步核心架构与数据流转机制
要想让大规模爬虫跑得快且稳,首先必须理解 Scrapy 的核心调度模型。许多开发者误以为 Scrapy 内部启动了大量操作系统线程,实际上,Scrapy 主引擎基于单进程单线程的 Twisted Reactor 事件循环运行。所有的网络请求与响应均以非阻塞 Deferred 机制挂起和回调,这意味着在等待网络传输的空闲期,CPU 可以持续处理其他已完成请求的解析工作。
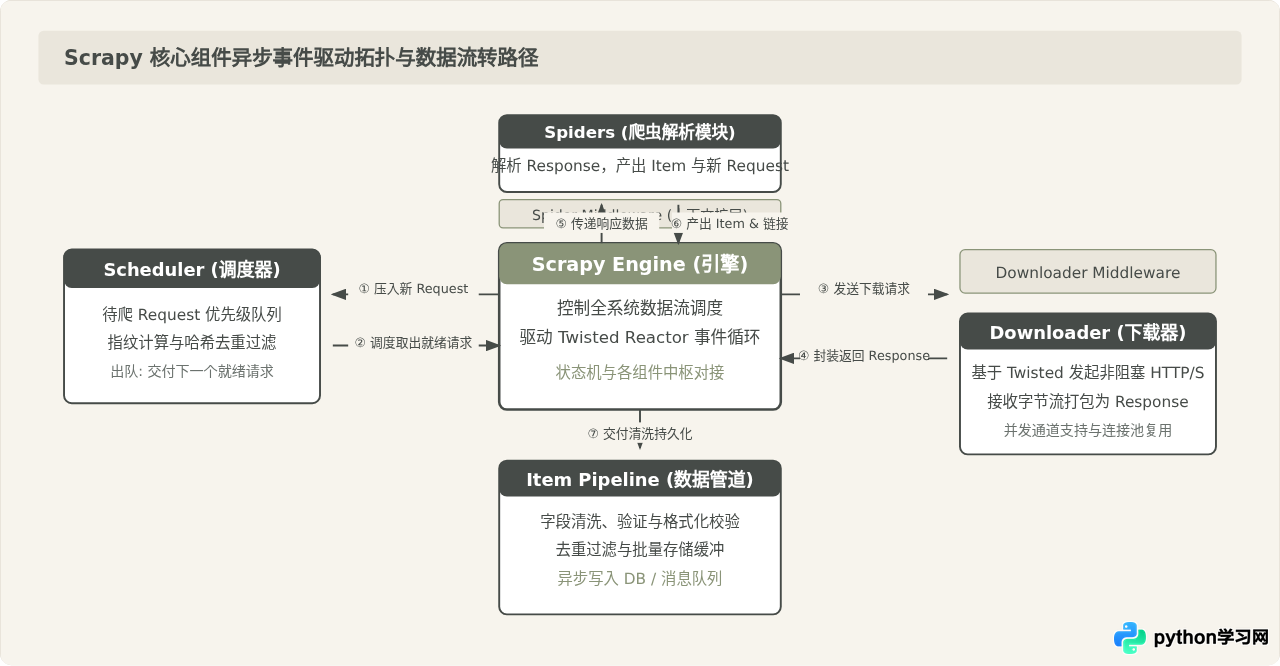
在这个闭环中,引擎(Engine)是绝对的调度核心:它从调度器(Scheduler)中索取准备就绪的 Request,经下载中间件处理后投递给下载器(Downloader);下载器抓取完成后包装成 Response 原路返回,再由引擎交给 Spider 解析。Spider 产生的全新请求被送回调度器,抽取出的业务数据 Item 则被推送至 Item Pipeline。整个链路没有线程创建与上下文切换的开销,这正是 Scrapy 实现百万级抓取的根本原因。
二、大规模采集工程的并发配置与性能基准调优
很多初学者在面对千万级任务时,往往直接将 CONCURRENT_REQUESTS 修改为 1000,结果爬虫启动几秒内便出现大量超时、连接重置甚至直接耗尽本地文件句柄。要构建高效工程,必须科学平衡网络吞吐、DNS 解析与系统资源开销。
这种说法看似符合直觉,但仅在目标服务器带宽无限且网络完全无丢包的理想实验环境中成立。在真实生产环境下,盲目扩大并发会导致三大瓶颈:第一,本地操作系统默认文件描述符受限,引发 Too many open files 异常;第二,并发瞬间发起数百个未解析域名的 HTTP 请求会迅速打满系统 DNS 线程池,导致大量域名解析超时;第三,短时高频并发极易触发目标服务器的 WAF 防护墙,导致整段 IP 被封锁。因此,真正的“高效”是根据目标集群承载力、代理吞吐上限与网络 RTT 找到最佳并发平衡点,而非无节制盲目调大数值。
在大型爬虫项目的 settings.py 中,推荐依据以下生产级标准进行基准调优:
# ==========================================
# Scrapy 大规模数据采集性能核心调优配置
# ==========================================

# 1. 全局最大并发请求数 (推荐单机单进程 32 ~ 64,性能强劲服务器可提升至 128)
CONCURRENT_REQUESTS = 64

# 2. 单域名并发限制与单IP并发限制
CONCURRENT_REQUESTS_PER_DOMAIN = 32
CONCURRENT_REQUESTS_PER_IP = 0  # 设为0表示不按单IP限制,按域名独立统计

# 3. 超时时间调优 (大规模抓取中切忌长时间等待僵死连接,缩短至 10~15 秒)
DOWNLOAD_TIMEOUT = 12

# 4. 禁用 Cookies (若无需登录态,禁用可大幅减少内存占用与响应解析耗时)
COOKIES_ENABLED = False

# 5. 关闭重定向追踪 (针对纯 API 或特定静态页,关闭可降低无用网络往返)
REDIRECT_ENABLED = False

# 6. DNS 缓存与解析线程池调优 (关键瓶颈所在)
REACTOR_THREADPOOL_MAXSIZE = 30  # Twisted 内部 DNS 解析线程池扩大
DNSCACHE_ENABLED = True
DNSCACHE_SIZE = 10000            # 本地常驻 DNS 缓存条目数

# 7. 降低重试次数并开启指数退避
RETRY_ENABLED = True
RETRY_TIMES = 2                  # 生产环境建议只重试 2 次,避免僵尸请求拖慢队列
RETRY_HTTP_CODES = [500, 502, 503, 504, 408, 429]

# 8. 内存防爆阈值警报
MEMUSAGE_ENABLED = True
MEMUSAGE_LIMIT_MB = 2048         # 内存占用超过 2GB 时主动报警并安全停止
MEMUSAGE_NOTIFY_MAIL = []
通过调优 REACTOR_THREADPOOL_MAXSIZE 与 DNSCACHE_SIZE,可以消除 90% 以上由 DNS 阻塞引起的非预期延迟。同时,将 DOWNLOAD_TIMEOUT 缩短至 12 秒,能够快速淘汰无响应的死链,释放宝贵的并发槽位给健康请求。
三、工程落地实施流程:从单机爬虫到分布式架构演进
当目标 URL 规模达到千万量级或需要多台服务器协作抓取时,单机内存的队列不仅受限于物理内存容量,而且无法抵御意外断电或程序崩溃。必须将单机调度器重构为基于 Redis 的集中式队列模型。
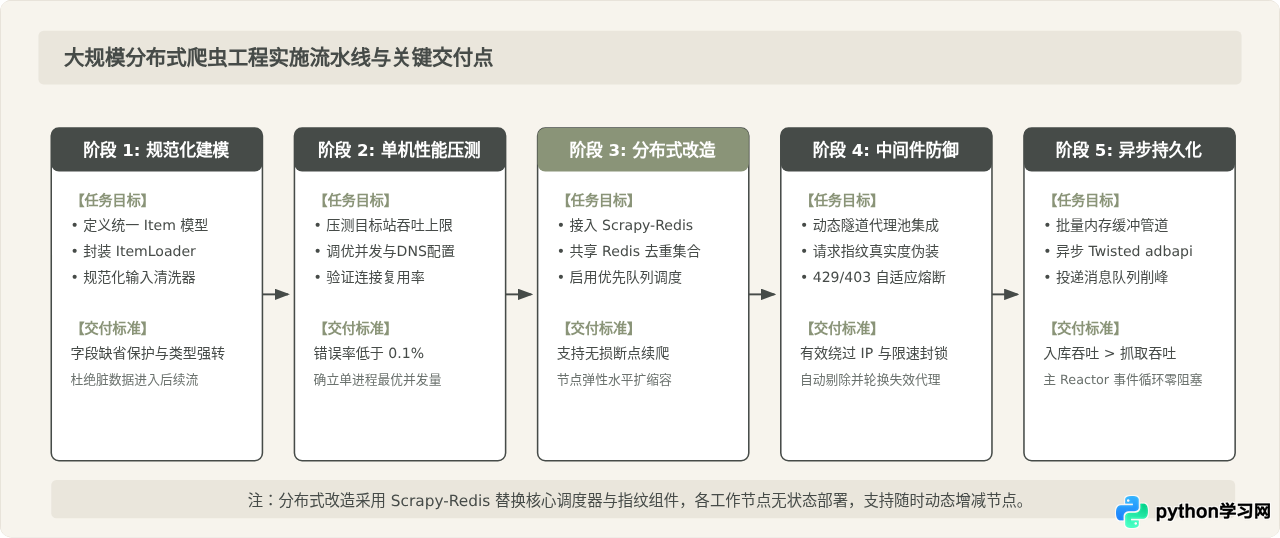
1. 引入 Scrapy-Redis 进行分布式调度改造
在工程中安装 scrapy-redis,并在 settings.py 中替换原生的调度器和去重组件:
# 替换为 Scrapy-Redis 的调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 替换为基于 Redis 的请求指纹去重过滤器
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 保持请求队列持久化 (爬虫中断后不清理 Redis 队列,重启时实现断点续爬)
SCHEDULER_PERSIST = True

# 调度队列类型:默认是优先级队列 (Sorted Set)
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderPriorityQueue"

# 配置 Redis 连接参数
REDIS_URL = "redis://:YourStrongPassword@192.168.1.100:6379/1"
2. 编写分布式通用 Spider 示例
将普通继承 scrapy.Spider 改为继承 RedisSpider,请求种子不再写死在代码内,而是监听 Redis 中的 lpush 指令:
import scrapy
from scrapy_redis.spiders import RedisSpider
from myproject.items import ProductItem

class DistributedProductSpider(RedisSpider):
    name = "distributed_product"

    # 监听的 Redis 种子键名
    redis_key = "product:start_urls"

    # 动态并发配额,单爬虫实例专属配置
    custom_settings = {
        'CONCURRENT_REQUESTS': 32,
    }

    def parse(self, response):
        # 1. 抽取当前列表页中的详情链接
        detail_urls = response.css("div.product-card a.title::attr(href)").getall()
        for url in detail_urls:
            full_url = response.urljoin(url)
            # 设置优先级 priority,保证核心数据优先抓取
            yield scrapy.Request(
                url=full_url,
                callback=self.parse_detail,
                priority=10
            )

        # 2. 提取下一页链接并继续推入调度队列
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse, priority=1)

    def parse_detail(self, response):
        item = ProductItem()
        item['sku_id'] = response.css("span.sku::text").get("").strip()
        item['title'] = response.css("h1.product-title::text").get("").strip()
        item['price'] = response.css("span.price::text").re_first(r'[\d\.]+')
        item['url'] = response.url
        yield item
在分布式架构下,你只需在运维终端执行 redis-cli -n 1 lpush product:start_urls "https://example.com/category/1",部署在不同机器上的多个爬虫节点便会立即协同出队并分发任务,单节点异常退出不会丢失任何 URL 进度。
四、构建坚固的下载中间件:代理池、请求头与反爬对抗
大规模抓取中最常遇到的网络阻碍是 IP 封禁与风控拦截(HTTP 403 Forbidden、429 Too Many Requests)。下载中间件(Downloader Middleware)是介入请求与响应的核心防线。
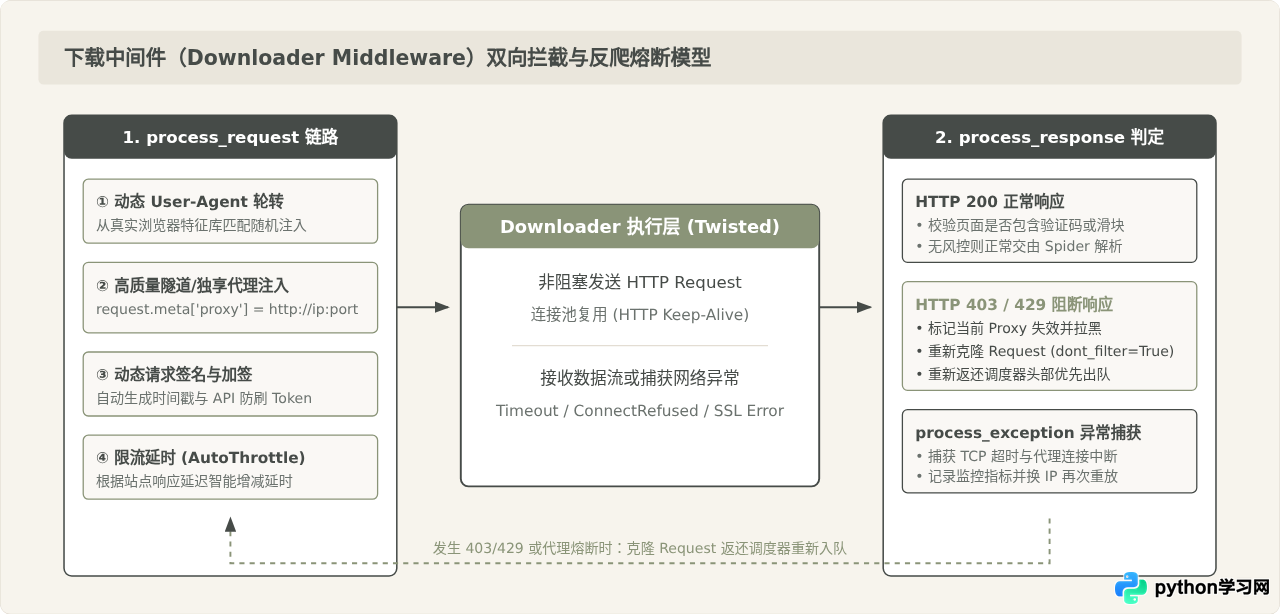
以下是经过高并发项目实测检验的动态代理与失败自愈中间件完整实现:
import random
import logging
from twisted.internet.error import TimeoutError, ConnectionRefusedError
from scrapy.core.downloader.handlers.http11 import TunnelError

logger = logging.getLogger(__name__)

class SmartProxyMiddleware:
    def __init__(self, proxy_pool_url):
        self.proxy_pool_url = proxy_pool_url
        self.user_agents = [
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36",
            "Mozilla/5.0 (X11; Linux x86_64; rv:109.0) Gecko/20100101 Firefox/123.0"
        ]

    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            proxy_pool_url=crawler.settings.get('PROXY_POOL_URL', 'http://127.0.0.1:5010/get/')
        )

    def process_request(self, request, spider):
        # 1. 随机轮转标准浏览器 User-Agent
        request.headers['User-Agent'] = random.choice(self.user_agents)

        # 2. 如果请求未显式指定跳过代理,则注入代理服务器地址
        if not request.meta.get('dont_proxy', False):
            # 生产环境通常采用动态隧道代理服务(如 http://user:pwd@gateway.proxy.com:9020)
            # 隧道代理在服务端自动保证每个 HTTP 请求使用全新出口 IP
            request.meta['proxy'] = "http://tun-user:tun-pass@proxy.provider.com:8080"

    def process_response(self, request, response, spider):
        # 针对 403、429 或带风控特征的响应进行判定
        if response.status in [403, 429] or "访问过于频繁" in response.text:
            logger.warning(f"触发反爬风控 [状态码 {response.status}],准备重放请求: {request.url}")
            return self._retry_request(request, spider)
        return response

    def process_exception(self, request, exception, spider):
        # 针对连接超时、代理隧道握手失败等异常捕获
        if isinstance(exception, (TimeoutError, ConnectionRefusedError, TunnelError)):
            logger.warning(f"网络底层故障: {exception.__class__.__name__},重放请求: {request.url}")
            return self._retry_request(request, spider)

    def _retry_request(self, request, spider):
        # 深度克隆请求,避免修改原对象,设置 dont_filter 防止被去重器过滤
        retried_req = request.copy()
        retried_req.dont_filter = True
        # 提升优先级,确保被拦截的请求优先被重试
        retried_req.priority = request.priority + 2
        return retried_req
五、高吞吐数据持久化:防范 Twisted 事件循环被阻塞
在性能调优中,最隐蔽也是最常见的致命瓶颈存在于 Item Pipeline。许多开发者在 process_item 方法中直接调用 pymysql.connect(...) 或 requests.post(...) 执行同步写入。由于 Scrapy 整个主进程共享一个事件循环,一个耗时 200ms 的同步 SQL 操作就会把整个爬虫完全“冻结” 200ms,导致几十个并发网络通道全部停摆,瞬时吞吐量从每秒几百页暴跌至几页。
针对千万级数据入库,有两种主流且经过实证的无损解决方案:
- 方案 A:内存缓冲区与批量批量写入(Batch Buffer)。在内存中暂存解析好的 Item,达到预设批次(如 1000 条)或经过固定时间间隔(如 2 秒)时,一次性执行
executemany批量入库。 - 方案 B:解耦到消息中间件(Message Queue)。Pipeline 只负责将 Item 序列化后快速投递至 Kafka 或 RabbitMQ,爬虫端彻底卸下存储压力,由独立的消费集群负责清洗和入库。
下面提供一套生产环境通用的批量缓冲异步 Pipeline 完整实现:
import pymysql
import logging
from twisted.internet import task

logger = logging.getLogger(__name__)

class BatchMysqlPipeline:
    def __init__(self, host, user, password, db, batch_size=500):
        self.host = host
        self.user = user
        self.password = password
        self.db = db
        self.batch_size = batch_size
        self.buffer = []
        self.conn = None
        self.cursor = None

    @classmethod
    def from_crawler(cls, crawler):
        s = crawler.settings
        return cls(
            host=s.get('MYSQL_HOST', '127.0.0.1'),
            user=s.get('MYSQL_USER', 'root'),
            password=s.get('MYSQL_PASSWORD', 'secret'),
            db=s.get('MYSQL_DB', 'crawler_db'),
            batch_size=s.getint('PIPELINE_BATCH_SIZE', 500)
        )

    def open_spider(self, spider):
        self.conn = pymysql.connect(
            host=self.host,
            user=self.user,
            password=self.password,
            database=self.db,
            charset='utf8mb4',
            autocommit=False
        )
        self.cursor = self.conn.cursor()
        # 启动定时刷新循环 (每隔 3 秒无论是否填满批次均自动入库,防止尾部数据滞留)
        self.flush_loop = task.LoopingCall(self._flush_buffer)
        self.flush_loop.start(3.0, now=False)

    def process_item(self, item, spider):
        # 仅将数据压入本地列表,耗时小于 0.001 毫秒,对 Reactor 零阻塞
        self.buffer.append((
            item['sku_id'],
            item['title'],
            float(item['price']),
            item['url']
        ))
        if len(self.buffer) >= self.batch_size:
            self._flush_buffer()
        return item

    def _flush_buffer(self):
        if not self.buffer:
            return
        data_to_insert = self.buffer
        self.buffer = []  # 立即置空缓冲
        try:
            sql = """
            INSERT INTO tb_product (sku_id, title, price, url)
            VALUES (%s, %s, %s, %s)
            ON DUPLICATE KEY UPDATE price=VALUES(price), update_time=NOW()
            """
            self.cursor.executemany(sql, data_to_insert)
            self.conn.commit()
            logger.info(f"批量持久化成功入库 {len(data_to_insert)} 条数据")
        except Exception as e:
            self.conn.rollback()
            logger.error(f"批量入库异常: {e}")

    def close_spider(self, spider):
        # 停止定时器并刷出剩余数据
        if self.flush_loop.running:
            self.flush_loop.stop()
        self._flush_buffer()
        if self.cursor:
            self.cursor.close()
        if self.conn:
            self.conn.close()
六、系统全景总结与长期运维保障
构建大规模 Scrapy 爬虫绝非单纯调大参数,而是一项涵盖“网络吞吐、任务分布、反爬抗性和存储容量”的系统级协同工程。下表与架构总结全景图为工程落地与长期平稳运行提供了全局参考:
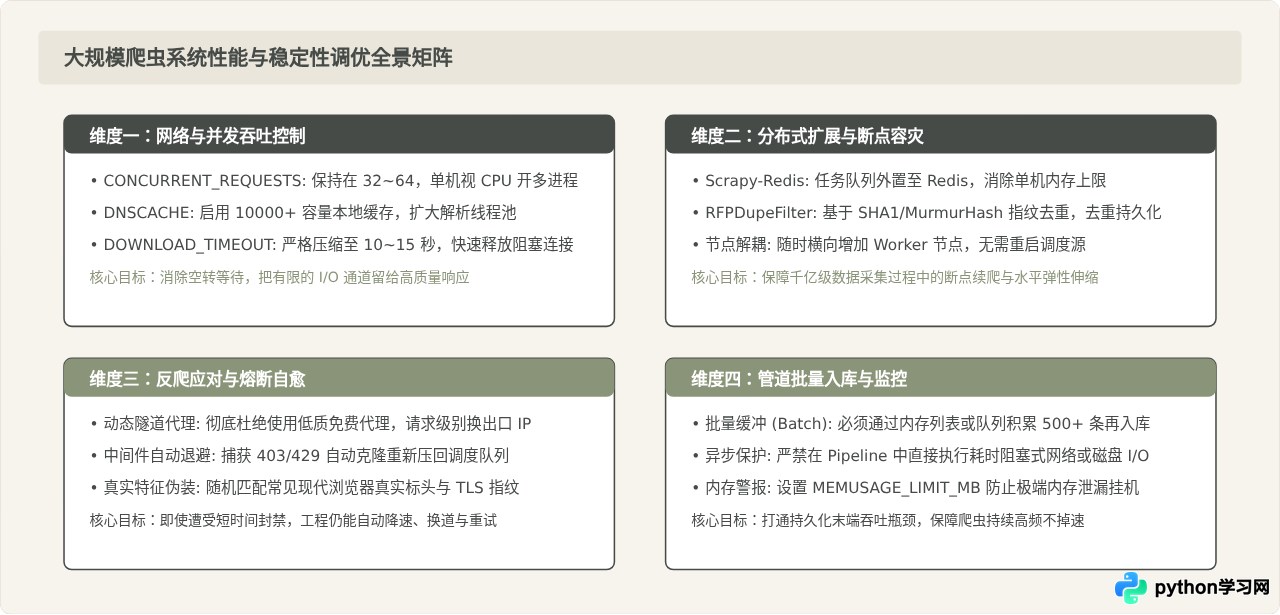
生产运维关键巡检清单
| 监控维度 | 关键指标 / 表现 | 排查方向与调优手段 |
|---|---|---|
| 吞吐量断崖下跌 | log/item_scraped_count 骤降 |
检查是否触发目标站 403/429 拦截;检查 Pipeline 数据库连接池是否耗尽或锁表。 |
| 内存持续增长 | 进程 RSS 内存超过 2GB | 检查 Spider 是否在 Request.meta 中传递过大的字典或闭包;开启 Telnet Console 检查未释放的引用对象。 |
| 高延时超时增加 | 大量 DNSLookupError |
调整 REACTOR_THREADPOOL_MAXSIZE,加大 DNSCACHE_SIZE,更换内网稳定 DNS 服务器。 |
| 队列积压严重 | Redis 调度队列长度只增不减 | 检查网络代理池可用率;增加工作节点容器数量,横向扩容爬虫消费能力。 |
遵循以上设计原则,从底层异步事件驱动机制出发进行全局协同设计,就能彻底告别脚本式的脆弱爬虫,搭建起一套兼顾高吞吐、强容灾与自动化运维的企业级大规模数据采集系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









