

Python异步编程中怎么避免同步阻塞操作
深入解析Python异步编程中同步阻塞操作的危害与成因,系统讲解从原生异步库替换、I/O多线程卸载到CPU多进程分流的完整解决方案,助你彻底消除事件循环卡顿。
async 与 await,但在并发压测或业务流量上升时,整体吞吐量急剧跌落,甚至连最简单的健康检查端点都开始超时。深究其根源,往往只是某处深层逻辑悄悄执行了 requests.get()、time.sleep() 或读取了大体积磁盘文件。解决 Python 异步编程中同步阻塞操作的核心,在于严守单线程事件循环(Event Loop)的非阻塞底线——对外部依赖全面换用原生异步驱动;对无法替代的同步 I/O 调用卸载至后台线程池;对 CPU 密集型运算移交独立多进程。
一、为什么一个微小的阻塞调用就能拖垮整个事件循环
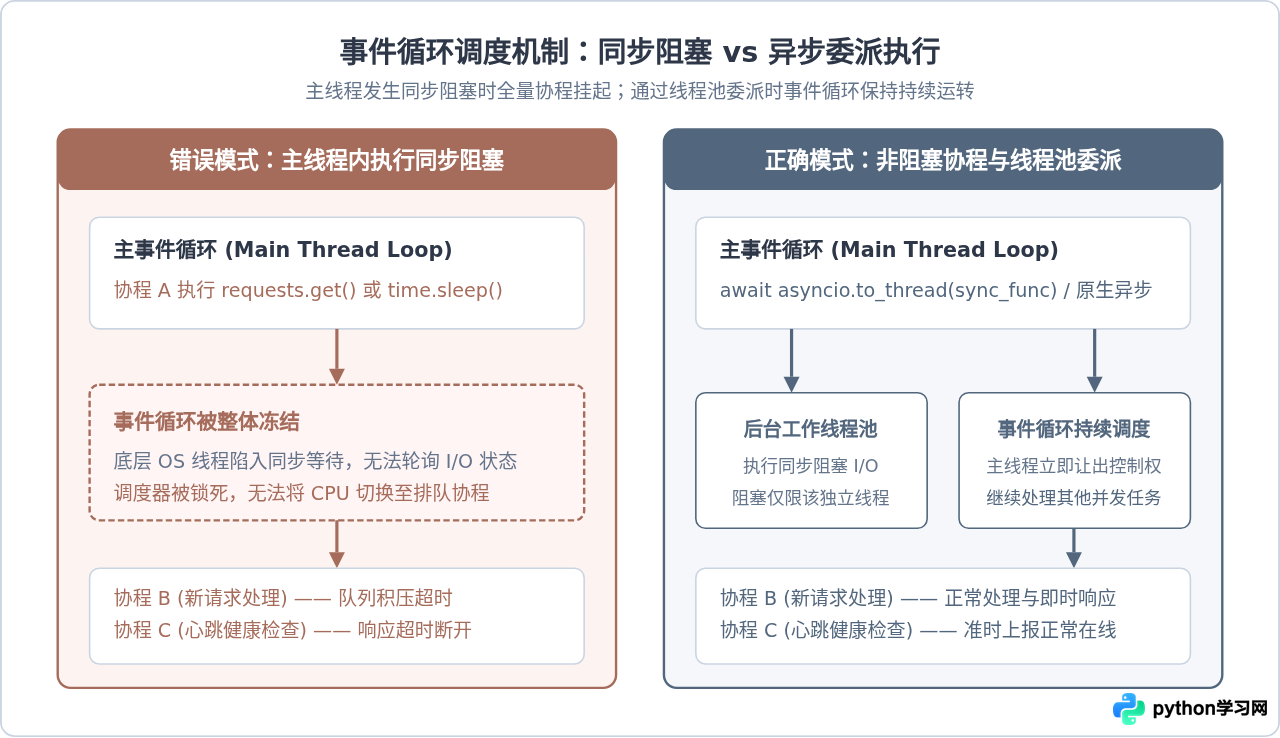
要彻底解决阻塞,必须先透彻理解 Python 异步的底层执行模型。与 Java、Go 的多线程抢占式调度不同,Python 标准库 asyncio 默认基于单线程的“协作式多任务”(Cooperative Multitasking)。所谓协作式,意味着操作系统不会主动强行剥夺当前运行代码的 CPU 占用权,调度器(Event Loop)能否运行下一个任务,完全仰赖当前协程是否主动通过 await 放弃控制权。
当一个协程执行诸如 time.sleep(2) 或 requests.get(...) 时,底层的系统调用会直接让操作系统将整个 Python 主进程的主线程挂起。在这阻塞的几秒内,事件循环完全丧失了执行机会:它无法轮询 Socket 状态、无法派发就绪事件、也无法切换到队列中排队等待的成百上千个轻量级协程。结果就是:一个耗时 2 秒的同步请求,足以让整个服务对外部的所有新连接和现有会话“冻结”整整 2 秒。
二、日常代码中最隐蔽的五类同步阻塞陷阱
在实际工程开发中,开发者很少会故意写出低效代码,阻塞大多隐藏在不经意的惯性调用和历史遗留库中:
-
传统同步网络请求:最经典的莫过于在异步路由处理函数中直接使用
requests.get()或urllib.request.urlopen()。即使设置了超时,高频调用也会让事件循环反复卡顿数百毫秒。 -
内置文件 I/O 操作:Python 的内置
open()、file.read()和file.write()都是同步阻塞的。尽管操作系统存在页缓存(Page Cache),读取几十 KB 文件时感知不明显,但当读取大文件、写入机械硬盘或访问网络挂载(NFS)目录时,线程会被强制挂起。 -
同步休眠与重试轮询:使用
time.sleep(n)代替await asyncio.sleep(n)。前者冻结整个线程,后者仅挂起当前协程并将定时器交给事件循环。 - CPU 密集型计算:例如复杂的正则表达式解析、数百兆字节的 JSON/Pickle 序列化与反序列化、大图裁剪(Pillow)或密码学哈希(hashlib/bcrypt)。这类计算虽然不涉及 I/O,但会持续占满 CPU 核心数秒,导致主事件循环无法得到调度时间片。
-
同步子进程执行:使用
os.system()或subprocess.run()等待外部可执行程序返回,由于是阻塞调用,主循环在这段系统执行期间处于完全瘫痪状态。
三、系统化规避策略与场景决策路径
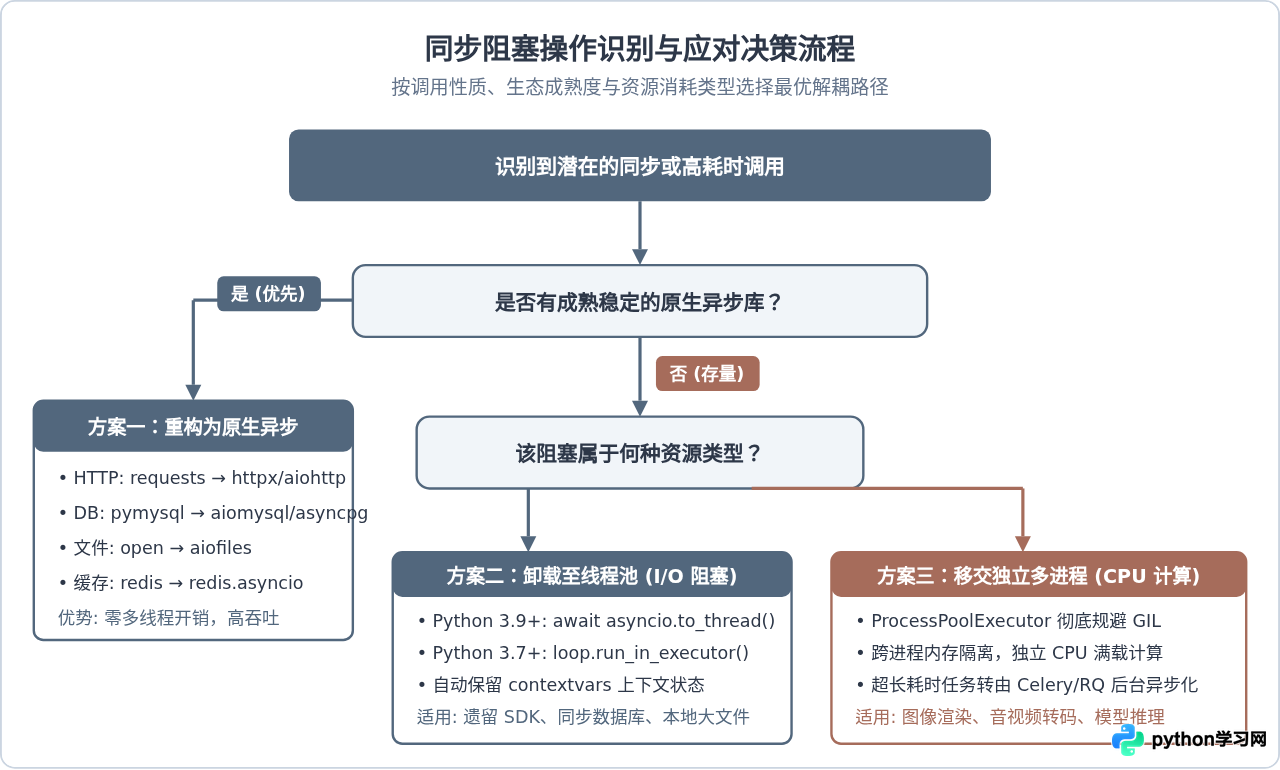
消除同步阻塞不是盲目给所有函数套上 async,必须根据调用的本质特性(是否有异步驱动、是 I/O 阻塞还是 CPU 密集)对症下药。
策略一:优先迁移至成熟的原生异步生态
在绝大多数 Web 开发场景中,主流存储和协议均已有成熟的异步实现。原生异步库通过操作系统底层的事件多路复用机制(如 Linux epoll、macOS kqueue、Windows IOCP)注册 Socket 监听,零线程上下文切换开销,是性能最佳的方案:
# ❌ 错误示范:在协程中直接使用同步 requests 库
import requests

async def fetch_user_bad(user_id: int):
    # 阻塞整个事件循环,后续所有协程排队等待
    resp = requests.get(f"https://api.example.com/users/{user_id}", timeout=5)
    return resp.json()

# ✅ 正确实践:全面替换为原生异步库 httpx
import httpx

async def fetch_user_good(user_id: int):
    async with httpx.AsyncClient(timeout=5.0) as client:
        # 非阻塞 I/O,等待网络响应期间主循环自动调度其他任务
        resp = await client.get(f"https://api.example.com/users/{user_id}")
        return resp.json()
常见基础组件的替换对比如下表所示:
| 业务场景 | 同步阻塞库(避免在异步代码中使用) | 推荐原生异步替代方案 |
|---|---|---|
| HTTP 客户端 | requests, urllib3 |
httpx, aiohttp |
| PostgreSQL 数据库 | psycopg2 |
asyncpg, psycopg (v3 async) |
| MySQL 数据库 | pymysql, mysqlclient |
aiomysql, asyncmy |
| Redis 缓存 | redis-py (同步 API) |
redis.asyncio |
| 本地文件读写 | open(), pathlib.Path.read_text() |
aiofiles |
策略二:利用 asyncio.to_thread 卸载无法替换的阻塞 I/O
在真实业务系统中,我们不可避免地需要调用一些尚未异步化的闭源 SDK(如某些支付网关、云服务商对象存储 SDK、同步驱动的硬件接口等)。重写这些 SDK 的网络通信并不现实,正确的解法是将其卸载到专用的工作线程池中执行。
在 Python 3.9+ 中,官方提供了开箱即用且高度优化的 asyncio.to_thread() 函数。它不仅简化了代码书写,而且会自动捕获并传播当前的 contextvars 上下文变量(如链路追踪 ID、请求上下文等),这在现代框架中至关重要。
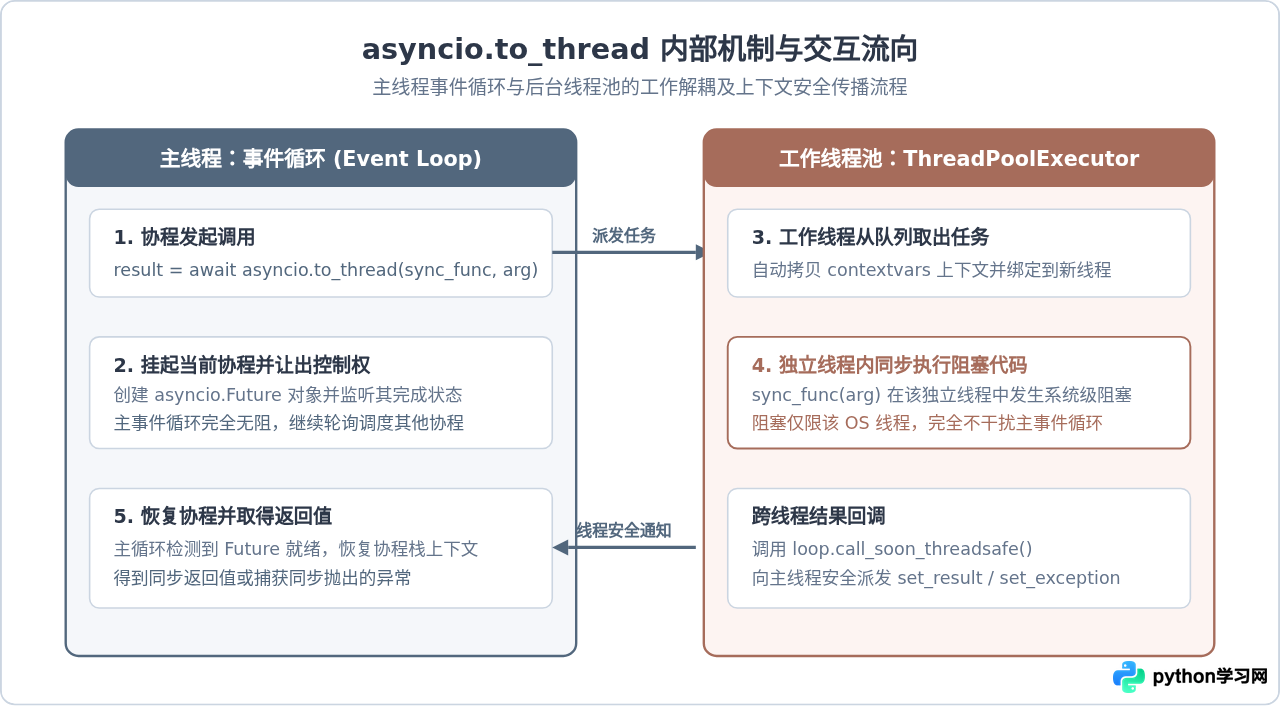
如果代码需要兼容 Python 3.7 或 3.8,或者你需要对线程池的最大线程数、线程名称做精细化隔离控制,则应使用底层 API loop.run_in_executor():
import asyncio
from concurrent.futures import ThreadPoolExecutor

# 针对耗时较长、容易出现网络波动的第三方 SDK,建立专用受限线程池
io_pool = ThreadPoolExecutor(max_workers=20, thread_name_prefix="sdk_worker")

def sync_legacy_payment_call(order_id: str, amount: float) -> dict:
    # 某第三方旧版同步 SDK 调用
    # 模拟包含同步网络交互的耗时调用
    import time
    time.sleep(0.5)
    return {"order_id": order_id, "status": "PAID", "amount": amount}

# 方案 A:现代 Python 3.9+ 极简方式(使用系统默认线程池)
async def handle_payment_modern(order_id: str, amount: float):
    # 底层自动调用 loop.run_in_executor(None, ...) 并支持上下文传递
    result = await asyncio.to_thread(sync_legacy_payment_call, order_id, amount)
    return result

# 方案 B:通用自定义隔离线程池方式(适用于全版本)
async def handle_payment_isolated(order_id: str, amount: float):
    loop = asyncio.get_running_loop()
    # 将任务提交至专属的 io_pool,避免打满全局默认线程池
    result = await loop.run_in_executor(io_pool, sync_legacy_payment_call, order_id, amount)
    return result
策略三:利用 ProcessPoolExecutor 隔离 CPU 密集型任务
如果任务耗时的原因是 CPU 计算而非网络或磁盘等待,将它放入线程池并不能带来真正的并发。因为在标准 CPython 实现中,全局解释器锁(GIL)的存在使得同一时刻只有一个线程能够真正执行 Python 字节码。即使分配了多个线程,主线程的事件循环依然会被密集的 CPU 运算剥夺解释器锁,导致严重的调度延迟。
应对 CPU 密集型任务,必须使用 ProcessPoolExecutor(多进程执行器)。子进程拥有独立的 Python 解释器、独立的内存空间以及独立的 GIL,计算在物理多核上真正并行,完全不消耗主进程事件循环的 CPU 资源:
import asyncio
from concurrent.futures import ProcessPoolExecutor

# 纯 CPU 密集型纯函数(必须处于模块顶层,确保可被 pickle 序列化)
def cpu_heavy_hash_verification(data_chunk: bytes) -> str:
    import hashlib
    # 模拟大块数据的哈希计算与重复混淆
    h = hashlib.sha256(data_chunk)
    for _ in range(200_000):
        h = hashlib.sha256(h.digest())
    return h.hexdigest()

# 在应用启动生命周期中初始化进程池
process_pool = ProcessPoolExecutor(max_workers=4)

async def process_data_stream(payload: bytes):
    loop = asyncio.get_running_loop()
    # 派发到子进程执行,主循环完全无感,继续接收其他请求
    digest = await loop.run_in_executor(process_pool, cpu_heavy_hash_verification, payload)
return {"status": "ok", "digest": digest}ProcessPoolExecutor 传递参数或接收返回值时,数据必须通过 pickle 进行跨进程序列化。因此,不要向子进程传递不能被 pickle 的对象(如生成器、活动 Socket、协程对象或包含复杂闭包的函数)。对于数吉字节(GB)的超大对象,进程间通信序列化本身也会产生显著开销,此时应考虑内存映射文件(mmap)或通过共享存储配合外部分布式队列(如 Celery)。
策略四:异步子进程命令调用
在需要调用外部命令行工具(如 FFmpeg、Pandoc 或系统工具)时,切勿使用 subprocess.run()。标准库提供了对应的异步替代:
import asyncio

async def run_external_converter(input_file: str, output_file: str):
    # ✅ 使用 asyncio 提供的异步子进程 API,不阻塞事件循环
    proc = await asyncio.create_subprocess_exec(
        "ffmpeg", "-i", input_file, output_file,
        stdout=asyncio.subprocess.PIPE,
        stderr=asyncio.subprocess.PIPE
    )
    # 异步等待外部子进程退出并读取标准输出/错误输出
    stdout, stderr = await proc.communicate()
    if proc.returncode != 0:
        raise RuntimeError(f"FFmpeg failed with code {proc.returncode}: {stderr.decode()}")
    return True
四、排查实操:怎样揪出潜伏在生产环境的慢回调
再严苛的代码审查也可能遗漏某处间接引用的同步库。在开发测试阶段和准生产环境中,我们可以借助 Python 提供的内置监控机制,直接定位所有阻塞事件循环的代码行。
1. 开启 asyncio Debug 模式
可以在运行程序时指定环境变量 PYTHONASYNCIODEBUG=1,或者在代码初始化事件循环时显式调用:
import asyncio
import logging

logging.basicConfig(level=logging.INFO)

# 获取事件循环并开启调试模式
loop = asyncio.get_event_loop()
loop.set_debug(True)

# 设置慢回调告警阈值(默认 0.1 秒即 100 毫秒,可根据要求调至更严格的 0.02 秒)
loop.slow_callback_duration = 0.05
一旦有任何协程或回调函数的单次执行时长超过 slow_callback_duration 设定的阈值,Python 会在标准错误中直接输出 WARNING:asyncio:Executing <Task...> took 0.354 seconds,并附带精确的文件名、函数名与源代码行号,让隐式同步操作无所遁形。
五、全景防御体系与避坑自查清单
构筑高吞吐、高稳定性的 Python 异步系统,应当从工程规范、并发解耦、运行检测等多个维度建立纵深防御体系。
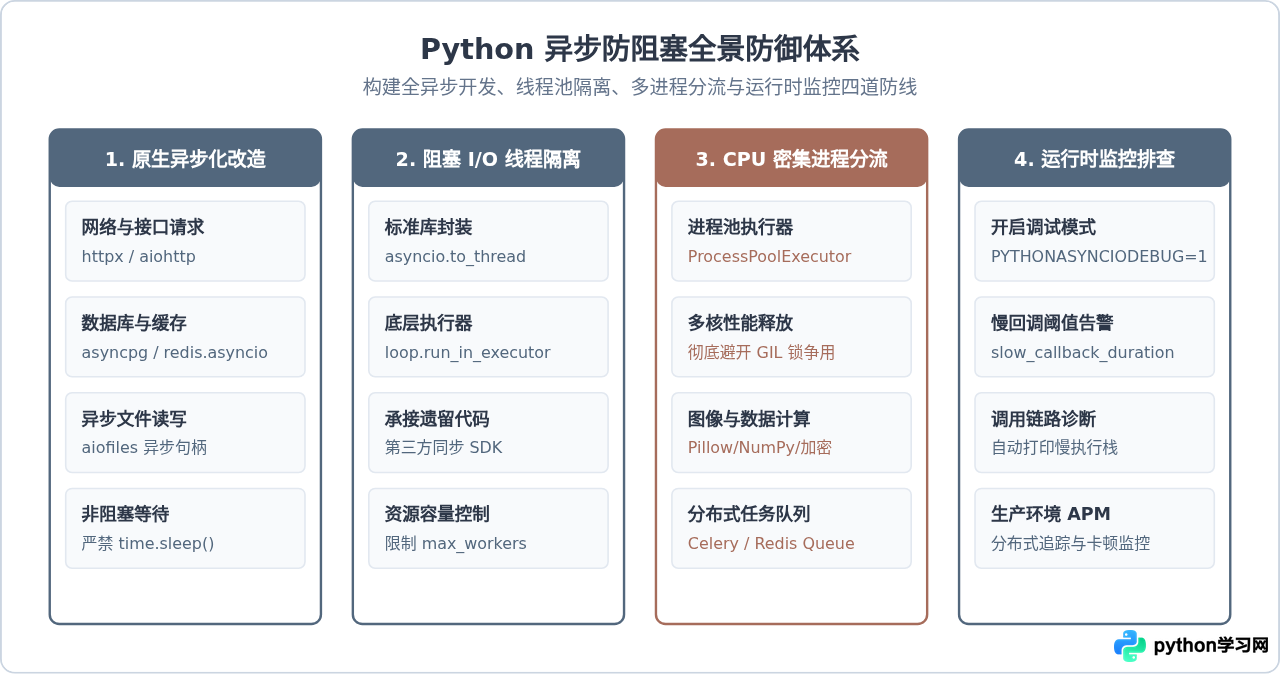
在日常开发与部署中,建议团队对照以下清单进行自查:
- 依赖审查:检查项目中是否引入了旧版同步客户端(如
requests,pymysql,pika等),若有,评估是否能迁移至对应的async生态版本。 - 线程隔离边界:所有无法避免的同步 I/O(第三方 SDK、大文件处理),是否统一包裹在
asyncio.to_thread()或受限的ThreadPoolExecutor中,严禁直接在主协程函数内裸跑。 - CPU 负载分流:耗时超过 50 毫秒的数据运算、格式解析或密码哈希,是否已移交
ProcessPoolExecutor或剥离为独立后台微服务。 - 死锁防范:在派发到线程池的同步函数内部,严禁再次反向调用
asyncio.run()或同步等待主事件循环的 Future,避免出现父子线程互相等待导致的永久死锁。 - 准生产验证:在集成测试与预发布压测环境中,始终开启
PYTHONASYNCIODEBUG=1,对所有慢回调日志实行零容忍归零治理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









