

基于Scrapy框架的Python爬虫项目搭建与数据持久化实例

本文详细讲解如何基于Scrapy框架搭建规范的Python网络爬虫工程,解析网页结构化数据,并通过Item Pipeline将采集结果持久化保存至SQLite数据库与JSON文件。
Scrapy 是 Python 领域工业级的异步网络爬虫框架,凭借 Twisted 异步网络库的事件驱动机制,能够在低资源消耗下实现高吞吐的数据采集。本文以抓取经典名言站点为实例,完整演示从零初始化 Scrapy 工程骨架、设计结构化 Item 实体、编写选择器与自动翻页爬虫,并通过自定义 Item Pipeline 将非结构化网页数据清洗并持久化至 SQLite 数据库与 JSON 文件的全过程。
一、理解核心:Scrapy 核心架构与异步流转机制
在着手写代码之前,理解 Scrapy 内部组件的协作方式至关重要。很多初学者使用单纯的 requests 配合循环或线程池编写爬虫,当遇到海量链接调度、自动去重、失败重试与管道存储时,代码容易变得混乱脆弱。Scrapy 将这些高频爬虫任务拆分为高度解耦的核心组件:
- 引擎 (Engine):框架的神经中枢,控制所有组件之间的数据信号流动,在特定动作发生时触发对应事件。
- 调度器 (Scheduler):接收来自引擎的 HTTP 请求 (Request),按照优先级进行入队排序,并在内部通过请求指纹算法实现 URL 自动去重。
- 下载器 (Downloader):基于 Twisted 异步获取网页 HTML 报文,并将封装好的响应对象 (Response) 返还给引擎。
- 爬虫模块 (Spiders):开发者主要编写的核心业务代码,负责根据 XPath 或 CSS 选择器从 Response 中提取结构化数据 (Item) 或发掘下一页链接。
- 数据管道 (Item Pipeline):负责接收爬虫产出的 Item,按顺序执行验证清洗、去重过滤以及持久化写入数据库或文件系统。
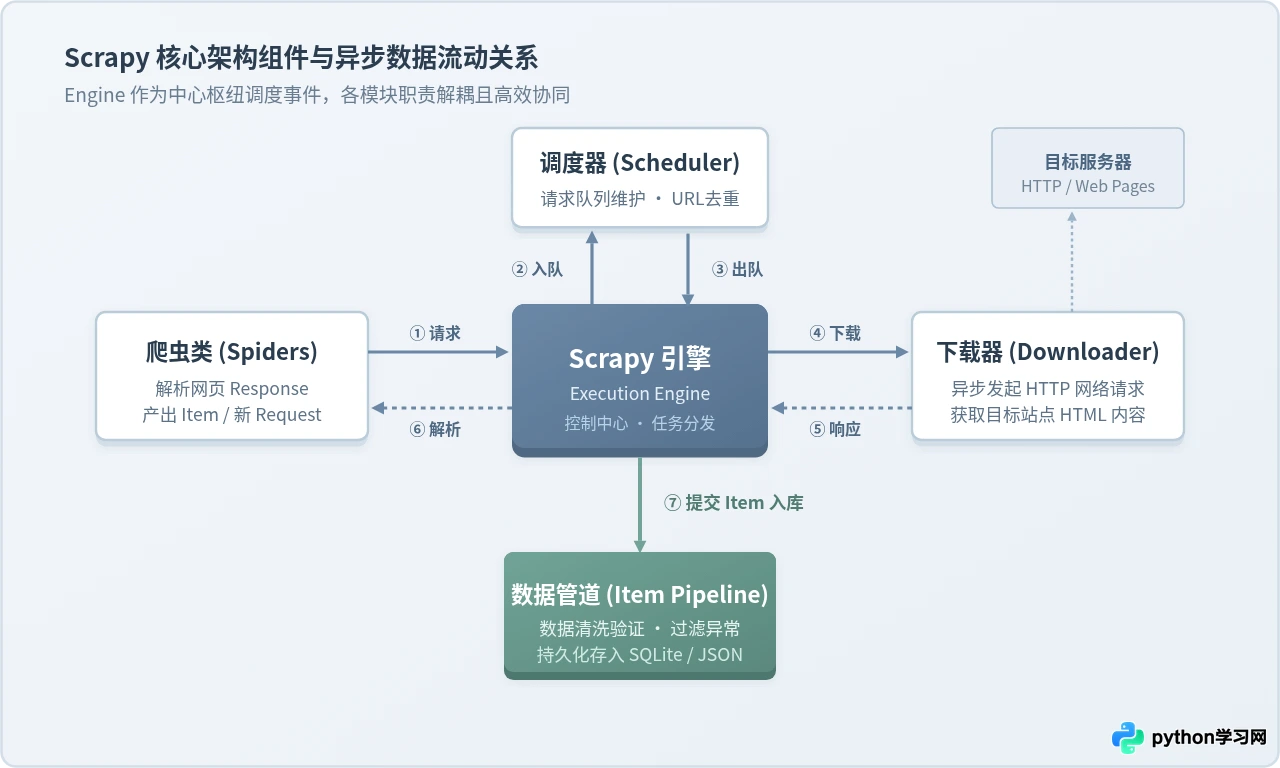
整个流转过程为单向闭环:Spider 产出初始 Request 提交给 Engine;Engine 将其送入 Scheduler 排队;Downloader 从 Scheduler 获取任务并异步拉取网页;返回的 Response 经过 Engine 投递回 Spider 的解析函数;Spider 提取出结构化的 Item 交给 Item Pipeline 落地存储,若提取出新链接则再次送入 Scheduler 进入下一轮循环。
二、环境准备与项目骨架搭建
进行 Scrapy 项目开发需要 Python 3.8 及以上环境。首先在终端中通过 pip 完成框架安装。为保证依赖纯净,建议在虚拟环境中操作。
Collecting scrapy
Installing collected packages: twisted, cryptography, cssselect, parsel, Scrapy
Successfully installed Scrapy-2.11.0
1. 创建项目工程
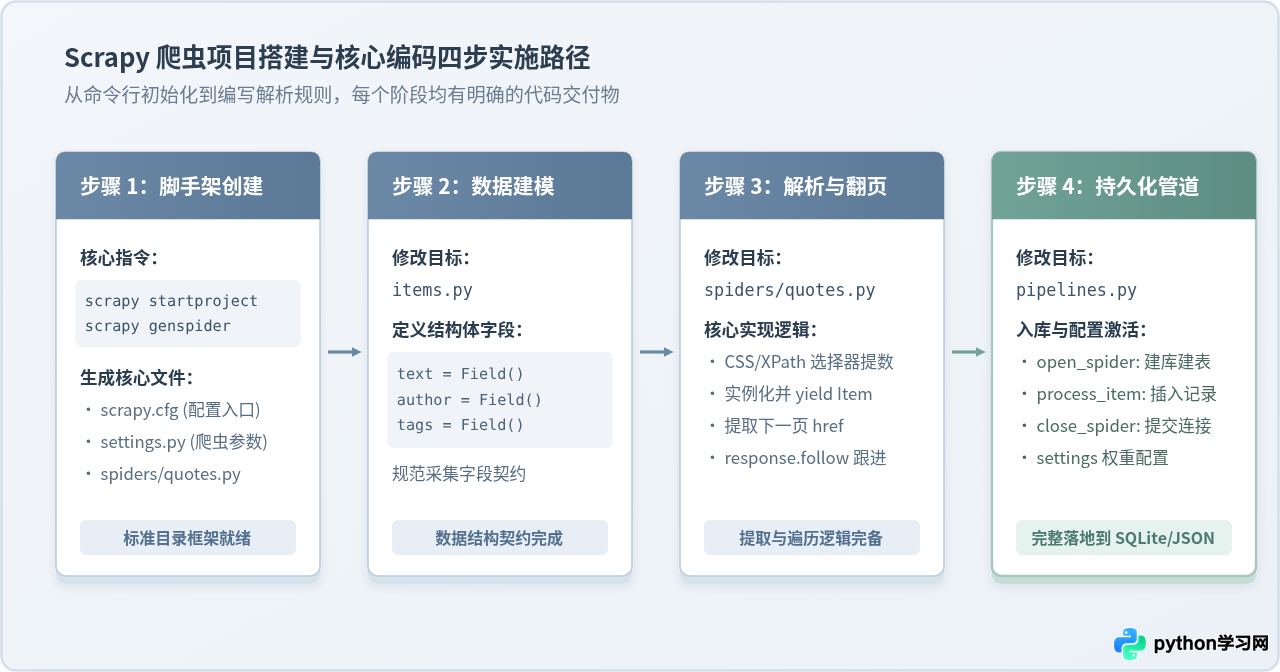
在工作目录中执行 scrapy startproject 命令,创建名为 quotes_crawler 的爬虫工程:
New Scrapy project 'quotes_crawler', using template directory '.../site-packages/scrapy/templates/project'
You can start your first spider with:
cd quotes_crawler
scrapy genspider example example.com
2. 理解项目文件布局
进入创建好的项目文件夹,Scrapy 会自动生成规范的模块化文件结构:
quotes_crawler/
├── scrapy.cfg            # 项目部署根配置文件
└── quotes_crawler/       # Python 源码包
    ├── __init__.py
    ├── items.py          # 数据结构定义文件 (数据契约)
    ├── middlewares.py    # 爬虫与下载器中间件 (拦截修改 Request/Response)
    ├── pipelines.py      # 数据持久化处理管道 (存入文件或数据库)
    ├── settings.py       # 爬虫全局配置文件 (并发、请求头、管道启用等)
    └── spiders/          # 爬虫逻辑脚本存放目录
        └── __init__.py
3. 生成爬虫脚本
进入 quotes_crawler 目录,执行 genspider 命令以经典测试站点 quotes.toscrape.com 为目标生成爬虫模板:
Created spider 'quotes' using template 'basic' in module:
quotes_crawler.spiders.quotes
三、数据建模与 Spider 解析逻辑编写
在 Scrapy 中,数据采集并非直接使用零散的 Python 字典,而是通过继承 scrapy.Item 建立明确的数据契约。这样做不仅能统一数据格式,还能在字段赋值错误时提前抛出异常,防止低级拼写错误。
1. 定义 Item 实体字段
编辑 quotes_crawler/items.py 文件。本实例目标是提取名言文本 (text)、作者 (author) 以及标签列表 (tags):
import scrapy

class QuoteItem(scrapy.Item):
    # 名言正文
    text = scrapy.Field()
    # 作者名字
    author = scrapy.Field()
    # 标签数组
    tags = scrapy.Field()
2. 编写 Spider 网页解析与翻页跟进
打开 quotes_crawler/spiders/quotes.py。分析目标网页可知,每个名言块包裹在 <div class="quote"> 容器内。名言文本位于 span.text,作者位于 small.author,标签位于 a.tag,下一页链接位于 li.next > a::attr(href)。
使用 response.css 解析数据,并通过 response.follow 实现自动跟踪翻页:
import scrapy
from quotes_crawler.items import QuoteItem

class QuotesSpider(scrapy.Spider):
    name = "quotes"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["http://quotes.toscrape.com/"]

    def parse(self, response):
        # 遍历当前页面的所有名言块
        quote_elements = response.css("div.quote")
        for q in quote_elements:
            item = QuoteItem()
            # 提取文本并去除首尾特殊引号
            raw_text = q.css("span.text::text").get(default="").strip("“”")
            author = q.css("small.author::text").get(default="").strip()
            tags = q.css("div.tags a.tag::text").getall()

            item["text"] = raw_text
            item["author"] = author
            item["tags"] = tags

            # 将提取出的 item yield 给 Scrapy 引擎,进而流向 Pipeline
            yield item

        # 提取下一页链接并继续爬取
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            # response.follow 会自动将相对路径拼接为完整绝对 URL
            yield response.follow(next_page, callback=self.parse)
注意:在解析时优先使用 .get() 与 .getall() 方法,避免使用老旧的 .extract_first() 或 .extract()。.get(default="") 能有效避免解析不到元素时报 NoneType 异常。
四、数据持久化实现:从轻量导出到 SQLite 数据库
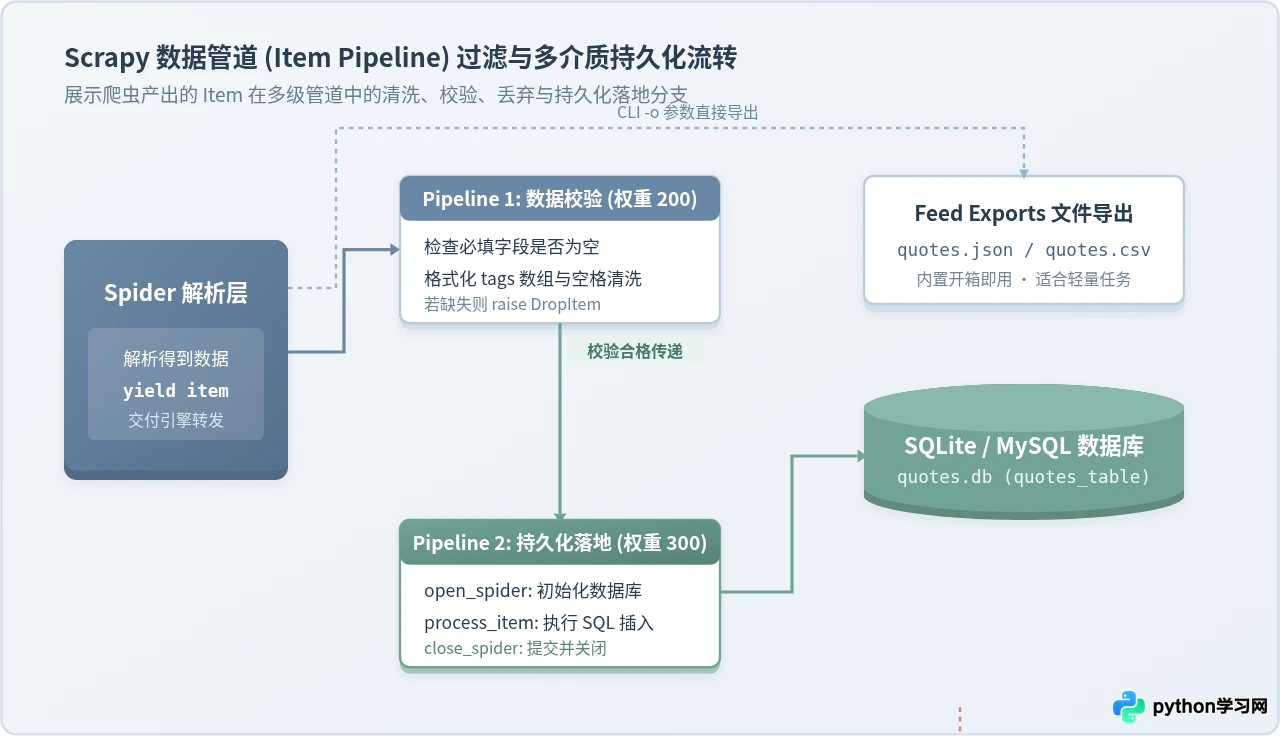
数据从网页提取出来后,最终目标是沉淀存储。Scrapy 提供了两种持久化路径:无需编写额外代码的内置 Feed Exports,以及应对复杂业务场景的 Item Pipeline。
1. 方式一:使用 Feed Exports 导出文件
对于快速测试或数据量适中的一次性任务,直接使用 Scrapy 内置的命令行参数 -o 即可导出标准格式文件:
该命令会自动将所有 yield 出的 Item 聚合保存为 UTF-8 编码的 JSON 文件。同样支持将后缀改为 .csv 或 .jsonl。
2. 方式二:编写自定义 Item Pipeline 写入 SQLite
在生产环境中,往往需要将数据实时落地到数据库中,并具备防重、过滤空数据和格式转换功能。Item Pipeline 是一个普通的 Python 类,通过实现以下三个标准钩子函数完成持久化周期管理:
open_spider(self, spider): 爬虫启动时触发一次,常用于建立数据库连接与初始化数据表。process_item(self, item, spider): 每当 Spider yield 出一个 Item 时触发,在此执行校验、清洗与 SQL 插入。必须返回item或抛出DropItem异常。close_spider(self, spider): 爬虫抓取结束时触发一次,常用于提交事务与安全关闭数据库连接。
打开 quotes_crawler/pipelines.py,编写完整的 SQLite 持久化管道:
import sqlite3
from scrapy.exceptions import DropItem

class QuoteValidationPipeline:
    # 第一阶段管道:校验与数据清洗
    def process_item(self, item, spider):
        # 校验正文是否有效
        if not item.get("text"):
            raise DropItem(f"发现无效名言数据,已丢弃: {item}")
        # 将标签列表转换为逗号分隔的字符串,便于关系型数据库存储
        if isinstance(item.get("tags"), list):
            item["tags_str"] = ",".join(item["tags"])
        else:
            item["tags_str"] = ""
        return item


class QuoteSqlitePipeline:
    # 第二阶段管道:SQLite 数据库持久化落地
    def __init__(self):
        self.db_name = "quotes_storage.db"
        self.connection = None
        self.cursor = None

    def open_spider(self, spider):
        # 建立数据库连接,并在本地创建 SQLite 文件
        self.connection = sqlite3.connect(self.db_name)
        self.cursor = self.connection.cursor()
        # 创建名言存储表结构
        self.cursor.execute('''
            CREATE TABLE IF NOT EXISTS quotes_record (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                author TEXT NOT NULL,
                content TEXT NOT NULL UNIQUE,
                tags TEXT,
                created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
            )
        ''')
        self.connection.commit()
        spider.logger.info(f"SQLite 数据库 [{self.db_name}] 初始化就绪。")

    def process_item(self, item, spider):
        # 执行数据插入,使用 INSERT OR IGNORE 避免重复录入相同名言
        try:
            self.cursor.execute('''
                INSERT OR IGNORE INTO quotes_record (author, content, tags)
                VALUES (?, ?, ?)
            ''', (item["author"], item["text"], item.get("tags_str", "")))
            self.connection.commit()
        except sqlite3.Error as e:
            spider.logger.error(f"写入 SQLite 数据库失败: {e}")
        return item

    def close_spider(self, spider):
        # 安全提交与关闭数据库连接
        if self.connection:
            self.connection.commit()
            self.connection.close()
            spider.logger.info("SQLite 数据库连接已安全关闭。")
3. 在 settings.py 中激活 Pipeline 管道
定义完管道后,必须在 quotes_crawler/settings.py 中显式激活,否则 Scrapy 不会调用它们。在配置文件中找到 ITEM_PIPELINES 并修改如下:
ITEM_PIPELINES = {
    # 权重范围 0-1000,数值越小越优先执行
    "quotes_crawler.pipelines.QuoteValidationPipeline": 200,
    "quotes_crawler.pipelines.QuoteSqlitePipeline": 300,
}
此处 QuoteValidationPipeline 权重为 200,它会先接收到 Item 并清洗格式;清洗完毕返回给引擎,随后传递给权重为 300 的 QuoteSqlitePipeline 执行 SQL 插入。
五、配置调优、运行执行与结果验证
1. 爬虫策略关键配置 (settings.py)
在进行真实爬取前,需要对 settings.py 中的关键运行参数进行确认,保证爬虫稳定且合规运行:
| 配置项 | 推荐设定值 | 作用与原理解析 |
|---|---|---|
ROBOTSTXT_OBEY |
True 或 False |
是否遵守目标站点的 robots.txt 协议。若为 True 且网站声明封禁,则爬虫会直接忽略抓取。 |
DOWNLOAD_DELAY |
0.5 ~ 1.0 |
单域名下载延迟(秒)。限制发包频率,避免高并发直接打垮服务器或被防爬机制直接拉黑。 |
CONCURRENT_REQUESTS |
16 (默认) |
Scrapy 下载器并发请求总数。生产环境中需结合网络带宽与目标服务器承载力综合权衡。 |
DEFAULT_REQUEST_HEADERS |
规范浏览器 User-Agent | 伪装正常浏览器访问指纹,防止被反爬系统凭借默认的 Scrapy/2.x 特征直接阻断。 |
# settings.py 关键修改片段示例
USER_AGENT = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
ROBOTSTXT_OBEY = False
DOWNLOAD_DELAY = 0.5
FEED_EXPORT_ENCODING = "utf-8"
2. 执行爬取命令
在项目根目录下启动爬虫:
2026-11-01 03:10:00 [scrapy.core.engine] INFO: Spider opened
2026-11-01 03:10:00 [quotes_crawler.pipelines] INFO: SQLite 数据库 [quotes_storage.db] 初始化就绪。
2026-11-01 03:10:01 [scrapy.core.engine] DEBUG: Crawled (200) <GET http://quotes.toscrape.com/>
2026-11-01 03:10:01 [quotes] DEBUG: Scraped from <200 http://quotes.toscrape.com/>: {'author': 'Albert Einstein', ...}
...
2026-11-01 03:10:08 [scrapy.statscollectors] INFO: Dumping Scrapy stats:
{'item_scraped_count': 100,
'response_received_count': 10,
'downloader/request_count': 10}
2026-11-01 03:10:08 [quotes_crawler.pipelines] INFO: SQLite 数据库连接已安全关闭。
2026-11-01 03:10:08 [scrapy.core.engine] INFO: Spider closed (finished)
3. 验证数据库落库结果
使用 Python 自带的 sqlite3 命令行工具或脚本查询刚才生成的 quotes_storage.db 文件,确认持久化是否成功:
已成功落库条数: 100
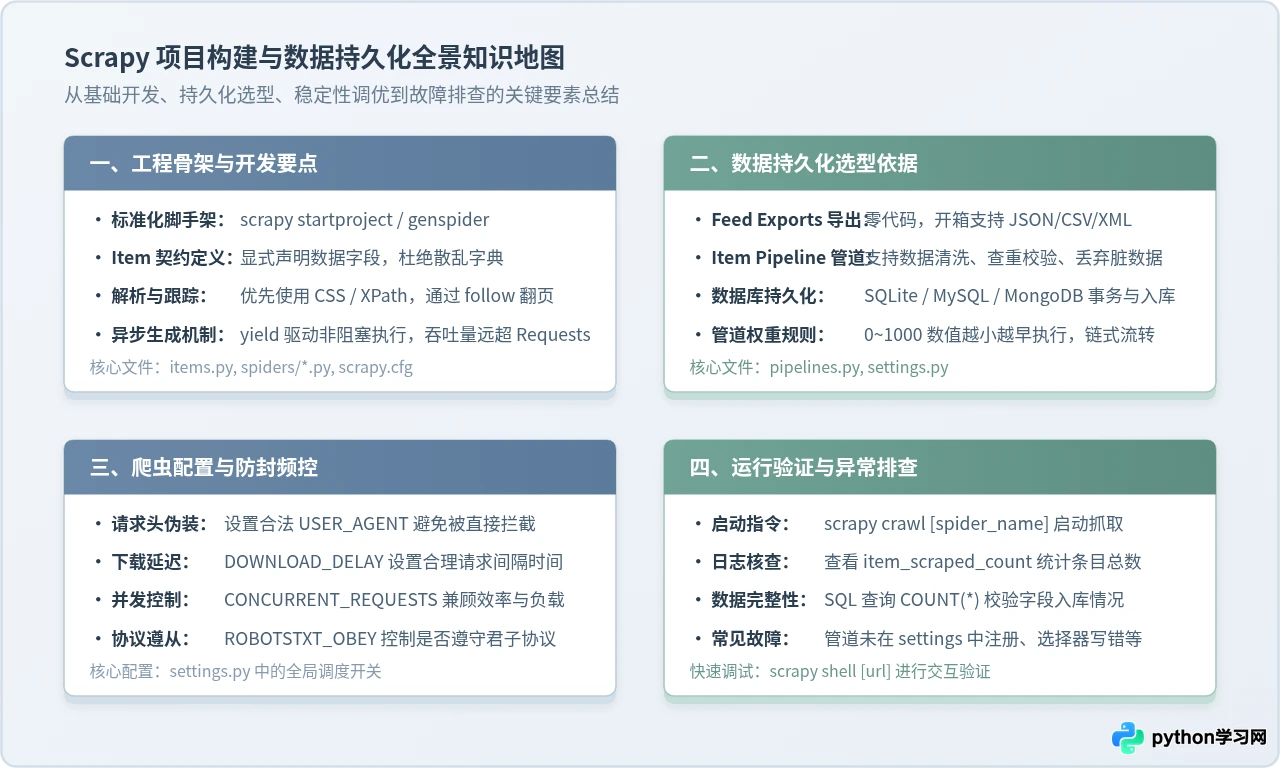
至此,一个从页面异步抓取、结构化数据清洗、多层过滤到最终入库 SQLite 数据库的完整 Scrapy 爬虫项目便搭建完成。在后续更复杂的项目中,你可以直接复用这套工程规范,并在 pipelines.py 中无缝扩展 MySQL 连接池、MongoDB 驱动或 Elasticsearch 索引引擎。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









