

深入理解Scrapy框架:哪本Python爬虫书讲解最透彻?
深入对比主流Python爬虫书籍对Scrapy框架的讲解深度,从Twisted异步机制、数据流调度、中间件链路及工程实战等维度分析哪本书讲得最透彻,并提供系统化阅读与实操路径。
很多开发者在写惯了基于 requests 和 BeautifulSoup 的脚本后,一旦面对数十万量级的多级联动爬取,单线程循环很快就会遭遇性能瓶颈,而手动维护线程池和队列又极易出现死锁或请求丢失。这时转向 Scrapy,按照网络教程执行 scrapy genspider,写几个选择器规则和 Pipeline 入库,跑起来似乎并不困难。然而,一旦遇到高并发场景下的并发卡死、请求优先级错乱、中间件异常未能按预期重试、或者内存占用莫名暴增几倍时,多数人会立刻陷入困惑——因为他们只是把代码填进了模板,却从未真正理解 Scrapy 内部的 Twisted 事件循环是如何驱动整个调度体系的。
核心结论先知:如果要选出国内对 Scrapy 框架本身机理讲解最透彻、源码与细节最深入的书籍,答案是刘硕所著的《精通Scrapy网络爬虫》。该书从头至尾只专注剖析 Scrapy 一套框架,把 Twisted 异步反应器、引擎与组件通信闭环、中间件调用链与短路返回值、扩展和信号系统讲解得丝丝入扣。而如果你不仅要理解 Scrapy 局部,还需要建立现代网络爬虫的全栈工程视野与分布式(Scrapy-Redis/Docker)交付能力,崔庆才所著的《Python 3网络爬虫开发实战》(第2版)则是覆盖面最完整、实战性最接地气的经典标杆。
一、衡量“透彻理解Scrapy”的四个技术标尺
市面上绝大多数爬虫书籍都会留出一到两章介绍 Scrapy,但绝大部分只是在重复官方文档的入门指南(Tutorial),教读者如何创建项目、用 CSS 提取字段、输出为 JSON 文件。要判定一本书是否真正做到了“讲解透彻”,必须考量其对以下四个底层机制的剖析深度:
1. 异步事件循环与 Twisted 反应器机制
Scrapy 不是多线程爬虫,而是基于 Python 经典异步网络库 Twisted 构建的单线程事件驱动系统。一本体现深度的书,必须讲清 Twisted Reactor(反应器)的工作原理,解释为什么在解析函数中使用 time.sleep() 或同步数据库驱动会直接阻塞整个框架的所有并发,并给出如何利用 Twisted 线程池(deferToThread)或异步协程安全处理阻塞任务的方法。
2. 引擎(Engine)调度闭环与组件解耦
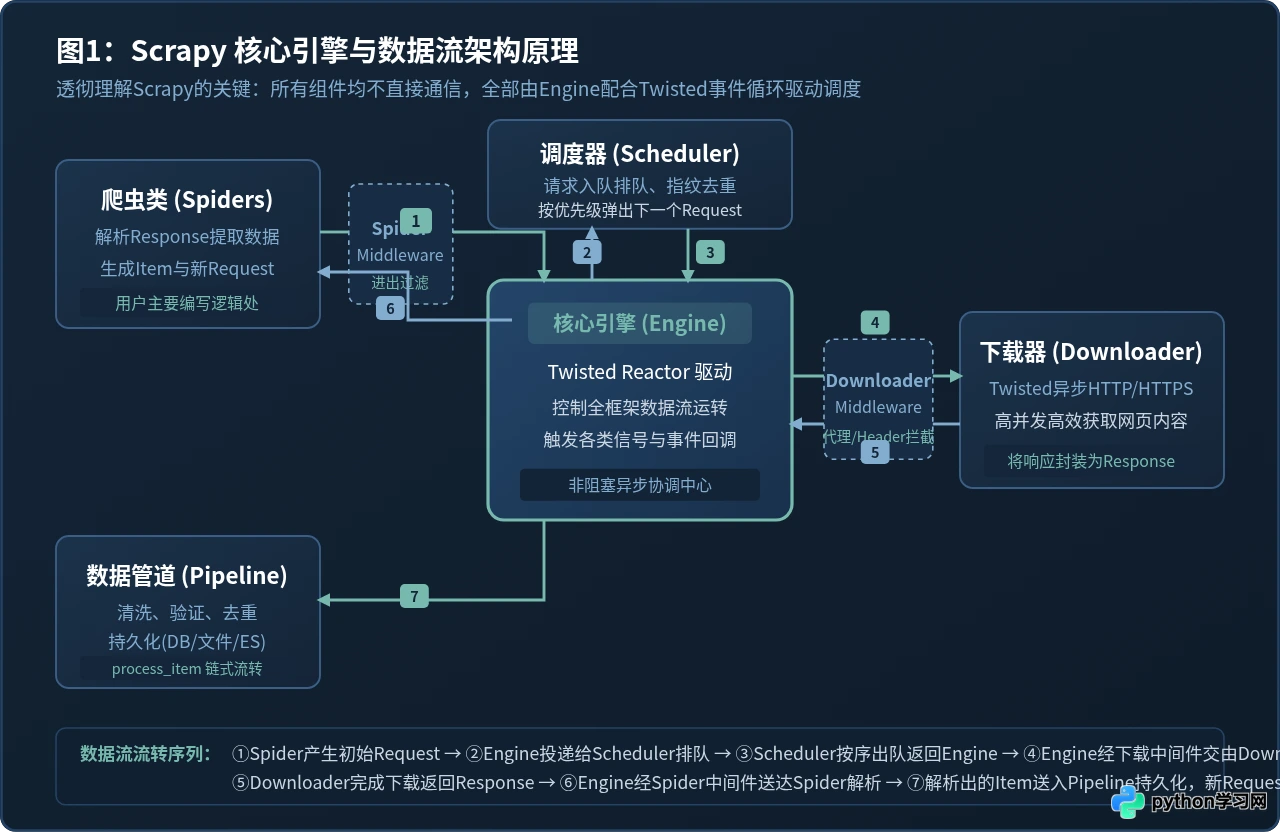
Scrapy 内部由 Engine(引擎)、Scheduler(调度器)、Downloader(下载器)、Spiders(爬虫类)和 Item Pipeline(数据管道)五个主要部件构成。透彻的讲解必须清晰还原组件间绝不相互直接调用的解耦设计,指出每一个 Request 和 Response 是如何经由引擎中转,并精准对应队列调度算法与去重指纹生成。
3. 中间件链式调用与短路逻辑
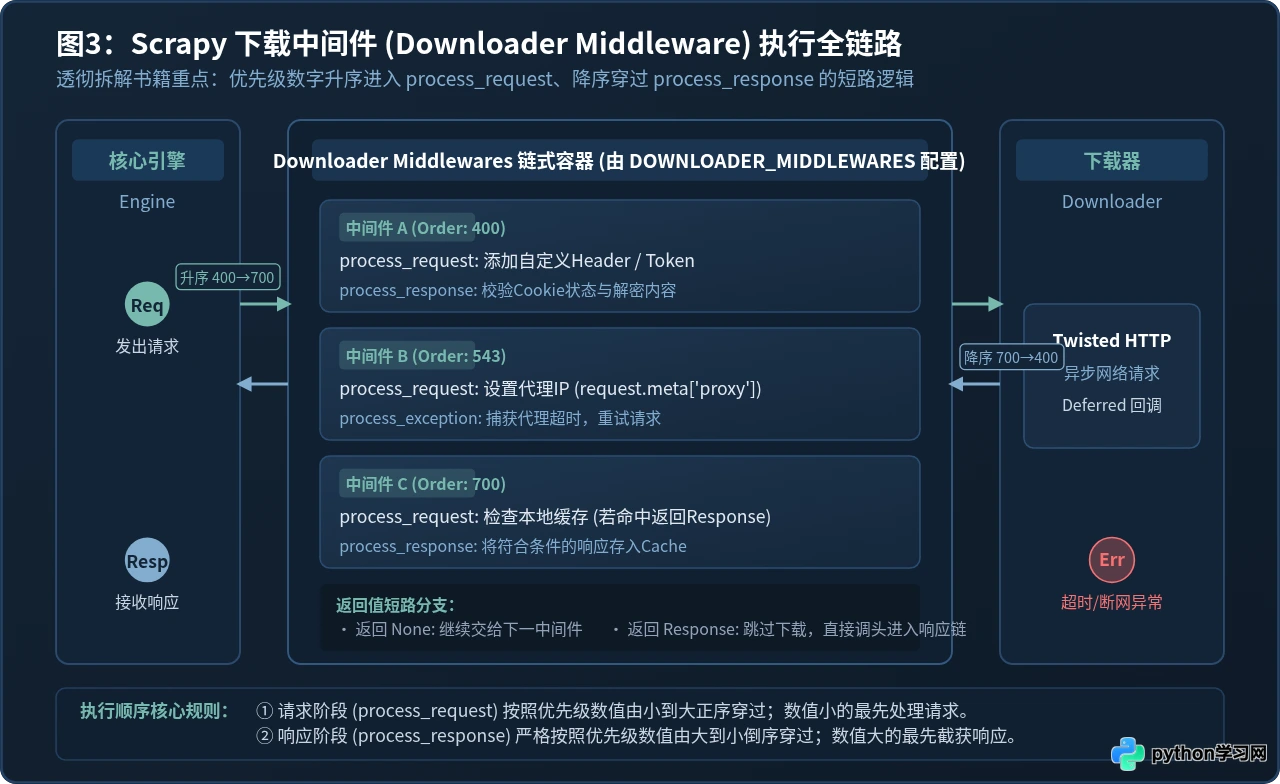
Downloader Middleware 与 Spider Middleware 是 Scrapy 的灵魂所在。透彻的专著不仅要列出配置项,更要讲透执行链的顺序:为什么 process_request 升序执行,而 process_response 降序执行?返回值返回 None、Response 或 Request 时,后续链条如何实现“短路”和“重定向”?这是排查反爬代理失效或认证丢失的核心底座。
4. 信号系统(Signals)、扩展(Extension)与内存监控
在生产环境下,长时间运行的大型爬虫极易出现内存泄漏或连接悬挂。真正透彻的书籍会引导读者利用 Scrapy 内置的信号系统挂载监控钩子,使用 trackref 模块检测未被垃圾回收的 Request/Response 实例,乃至编写自定义 Extension 接管爬虫生命周期。
二、主流 Python 爬虫著作中 Scrapy 的横向横评
为了让读者能够根据自身的学习阶段精准挑选,下面针对技术圈讨论度最高的几部代表性著作展开对比分析。
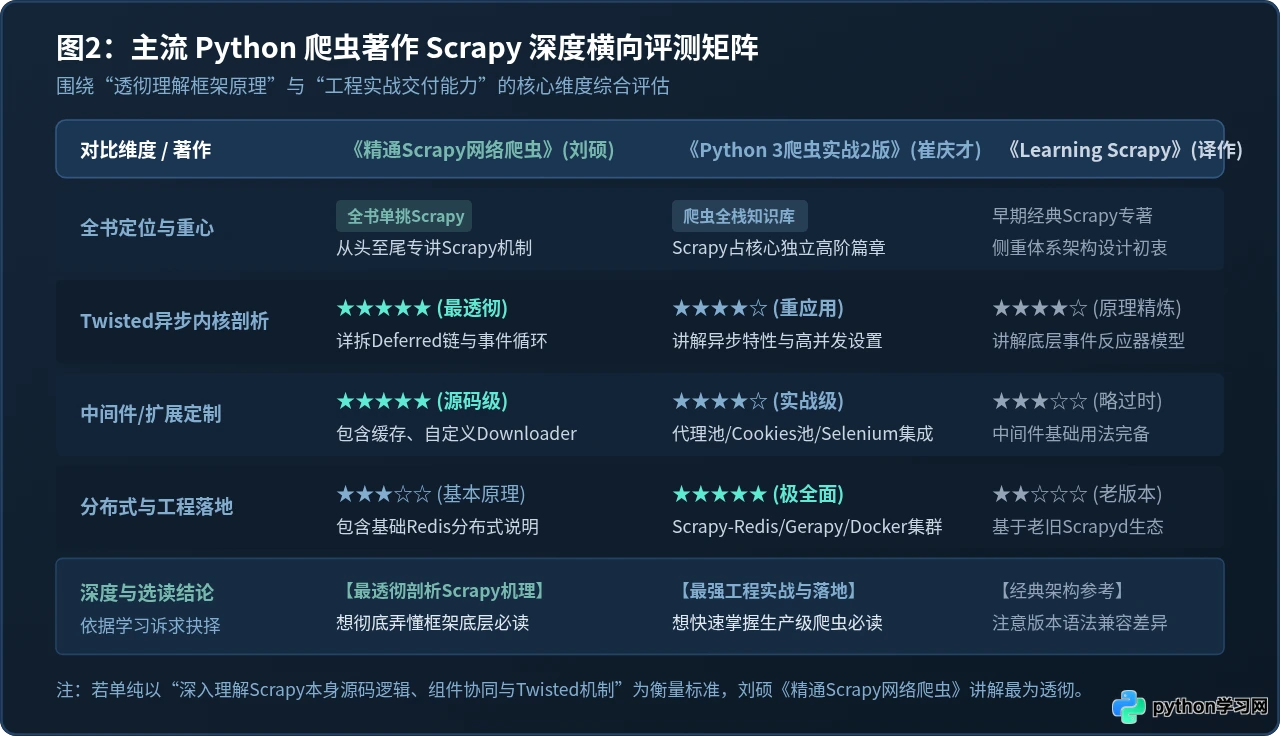
1. 刘硕《精通Scrapy网络爬虫》(清华大学出版社)
专注度与透彻指数:★★★★★
这本书是中文出版物中少有的、全书300多页纯粹聚焦于 Scrapy 单一框架的技术专著。作者从 Scrapy 架构的演化背景起步,逐章拆解了 Selector 选择器底层机制、Spider 运行周期、Downloader 的 Twisted 异步实现、Item Pipeline 的并发写入,以及最关键的 Downloader Middleware 核心源码分析。书中对 HTTP 缓存存储器(FilesystemCacheStorage)、重试中间件(RetryMiddleware)内部逻辑,以及自定义扩展插件的实现讲得尤为透彻。读完此书,读者对 Scrapy 的认知会从“API 使用者”直接上升到“框架架构与定制者”。
本书编写时基于 Scrapy 1.x / Python 3.5+ 环境,书中部分基础语法与配置在当前的 Scrapy 2.x(如异步协程原生支持、itemloaders 独立为单独库等)略有更新,但由于其阐述的是不变的 Twisted 反应器底层模型与架构契约,核心原理解读至今依然十分扎实。
2. 崔庆才《Python 3网络爬虫开发实战》(第2版,人民邮电出版社)
工程落地与实战指数:★★★★★ / 机制透彻指数:★★★★☆
这是一部超过1000页的现代化爬虫鸿篇巨制。全书系统梳理了从基础请求、网页解析、验证码识别、JavaScript 动态逆向到移动端抓取的全部技术链路。在 Scrapy 篇章中,作者不仅清晰梳理了核心组件使用方法,还结合现代工程实践,详细演练了分布式调度中间件 Scrapy-Redis、Gerapy 分布式管理平台、Docker 容器化部署以及代理池的深度集成。如果你的目标是“在企业真实业务中快速构建稳定、高并发、抗反爬的 Scrapy 集群”,这本书的指导意义和参考价值极高。
3. Dimitrios Kouzis-Loukas《Learning Scrapy》(中译《精通Python爬虫框架Scrapy》)
架构理念指数:★★★★☆ / 时效实用指数:★★☆☆☆
作为国外较早成体系讲解 Scrapy 的经典译作,本书最大的亮点在于从分布式系统架构和批量数据流的角度剖析 Scrapy。作者详细推演了基于 Twisted Deferred 构建非阻塞下载管道的思维逻辑。遗憾的是,该书出版年代较早(主要基于 Python 2.7 与早期 Scrapy 版本),读者在实际敲代码练习时会遇到大量语法弃用和安装兼容性报错,更适合作为理解设计模式的参考读物,不建议新手直接作为动手实操手册。
| 对比维度 | 刘硕《精通Scrapy网络爬虫》 | 崔庆才《Python 3实战(第2版)》 | 《Learning Scrapy》(译作) |
|---|---|---|---|
| 内容定位 | 全书专攻 Scrapy 内核机制与组件原理 | 全栈爬虫工程百科,Scrapy为高阶篇 | 基于早版 Scrapy 的架构设计与理论 |
| Twisted 原理 | 深入剖析 Deferred 链、反应器与事件驱动 | 侧重异步使用规范与高并发配置 | 深入讲解非阻塞 I/O 思维模型 |
| 中间件与底层 | 深入源码逻辑,涵盖自定义中间件与缓存 | 结合代理池、Cookies 池与动态渲染实战 | 详述标准中间件生命周期(部分API老旧) |
| 分布式与部署 | 讲解基础 Redis 分布式思路 | 深入 Scrapy-Redis、Docker、Gerapy 集群 | 基于旧版 Scrapyd 机制展开 |
| 最适宜读者 | 希望彻底吃透框架、能自研扩展的进阶者 | 希望打通从单机到集群落地全流程的工程师 | 对框架架构设计演化感兴趣的资深开发者 |
三、以具体机制为例:一本透彻的书如何讲清中间件链路
为了让读者直观感受“透彻讲解”与“浮于表面”的差距,我们可以通过 Scrapy 下载中间件(Downloader Middleware)的具体执行规则来深入对照。
普通的教程往往只会告诉读者:在 middlewares.py 中写一个类,实现 process_request,然后在 settings.py 中配置一个数字。然而,一本质地透彻的书会清晰指出:优先级数字决定了请求与响应在中间件管道中的流动方向。
1. Downloader Middleware 执行契约
假设我们在 settings.py 中配置了三个不同优先级的中间件:
# settings.py 中间件注册示例
DOWNLOADER_MIDDLEWARES = {
    'myproject.middlewares.CustomHeaderMiddleware': 400,
    'myproject.middlewares.ProxyMiddleware': 543,
    'myproject.middlewares.CacheCheckMiddleware': 700,
}在请求阶段(进入下载器前),调用顺序为:400 → 543 → 700(优先级数字由小到大正序执行);当网页下载完成或生成响应返回时,调用顺序严格逆转为:700 → 543 → 400(优先级数字由大到小倒序执行)。
2. process_request 的三种短路分支代码与行为
透彻的书籍会用具体的控制流解释 process_request(request, spider) 返回值的不同含义:
class ProxyMiddleware:
    def process_request(self, request, spider):
        # 分支1:返回 None。框架继续将该 Request 传递给下一个中间件处理
        if 'proxy' not in request.meta:
            request.meta['proxy'] = 'http://127.0.0.1:7890'
            return None

        # 分支2:返回 Response。直接截断后续所有中间件及下载器本身!
        # 立即调头进入 process_response 链条(例如命中本地缓存或模拟返回)
        if spider.name == 'mock_spider':
            from scrapy.http import HtmlResponse
            return HtmlResponse(url=request.url, body=b'<html>mock</html>', encoding='utf-8', request=request)

        # 分支3:返回 Request 或抛出 IgnoreRequest。
        # 当前请求被废弃,返回的新 Request 被送回调度器重新排队
        if request.meta.get('invalid_token'):
            return request.replace(url='https://example.com/refresh_token')
刘硕在《精通Scrapy网络爬虫》中,不仅列出上述规则,还进一步带领读者阅读 scrapy.core.downloader.middleware.DownloaderMiddlewareManager 源码,展示框架是如何通过 Python 列表与 twisted.internet.defer.Deferred 回调链绑定上述方法的。理解了这一层,面对各种复杂的身份验证和代理调度,代码编写就会变得游刃有余。
四、深入掌握 Scrapy 的体系化研读路径
了解了各书籍的长短板后,最科学的学习策略不是捧着一本书从头死啃,而是分阶段结合不同书籍的优势形成合力:
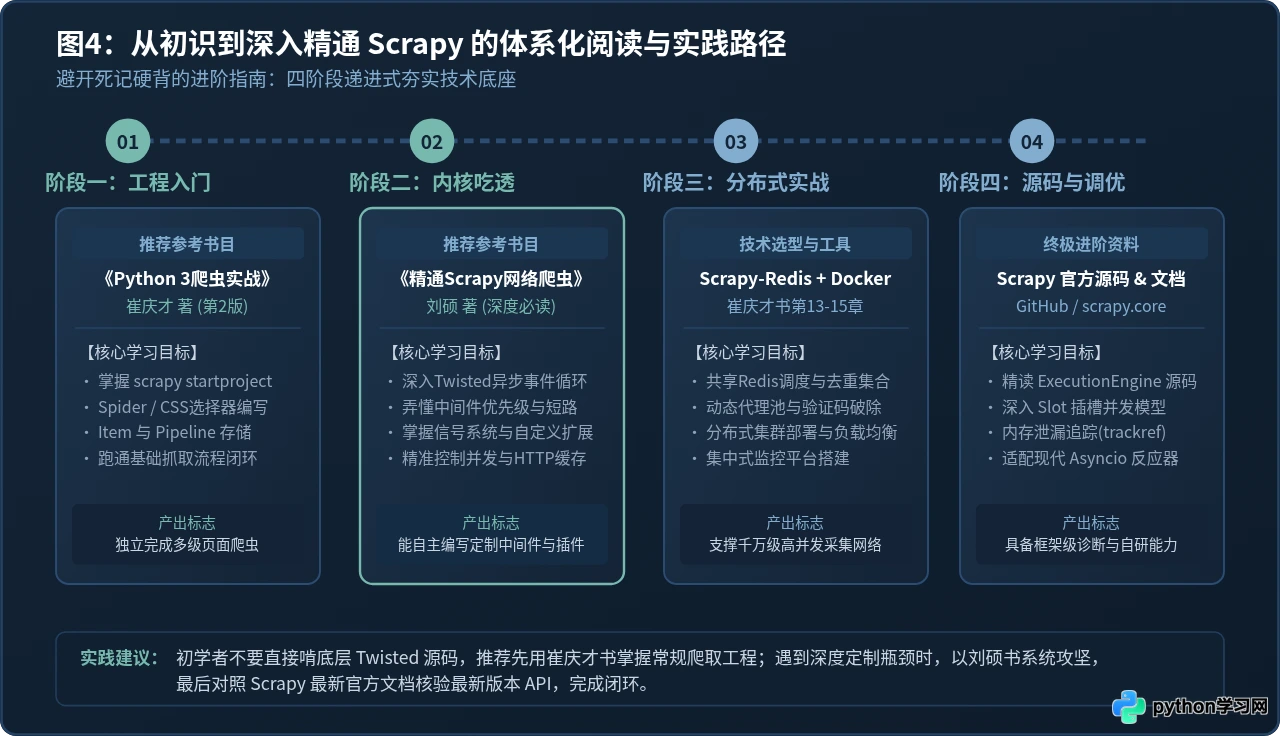
- 第一阶段:工程实操与建立直观认知(用时约 1~2 周)
直接研读崔庆才《Python 3网络爬虫开发实战》(第2版)的第13章。跟随书中的实战案例,完整跑通从页面分析、Spider编写、Selector提取、ItemLoader填充到Item Pipeline异步存储到 MongoDB/MySQL 的完整闭环。此时不必深究 Twisted 细节,重点在于熟悉 Scrapy 的命令行工具集(scrapy shell、scrapy crawl)与标准工程规范。 - 第二阶段:内核攻坚与机制吃透(用时约 2~3 周)
精读刘硕《精通Scrapy网络爬虫》的核心章节(特别是第6~9章及第11章)。重点研读中间件调用链、HTTP 缓存存储机制、下载器底层实现及信号系统。尝试脱离教程编写一个具备“自动检测代理健康度并在失败时精准重试”的自定义 Downloader Middleware,以及一个“在爬虫关闭时发送统计邮件与钉钉告警”的自定义 Extension。 - 第三阶段:分布式拓展与现代生产实战(用时约 1~2 周)
回过头来,再次研读崔庆才书中的Scrapy-Redis分布式章节与 Docker 容器化编排。理解分布式调度中如何用 Redis 的zset替代本地内存优先队列,如何用set存储请求指纹实现跨服务器集群去重。 - 第四阶段:源码印证与现代 Asyncio 演化(持续进阶)
在本地 IDE 中直接打开虚拟环境下的site-packages/scrapy目录,重点阅读core/engine.py(执行引擎主循环)与core/scheduler.py。对照官方最新发布的英文文档,核验现代 Scrapy 2.x 中引入的asyncio反应器协同机制(如async def parse(self, response)协程语法),完成从技术认知到生产交付的最终跃迁。
五、研读与编码过程中的避坑要点
在按照上述书籍实践 Scrapy 的过程中,开发者最容易踩进几个隐蔽的技术误区,务必在阅读和实测时重点防范:
- 切忌在解析函数与中间件中调用阻塞 I/O: Scrapy 单进程内所有并发均依赖 Twisted 反应器的事件分发。如果因为解析验证码或等待页面而调用
time.sleep(5)或使用同步requests.get(),会导致全框架所有并发下载全部停滞 5 秒。需要延时应使用DOWNLOAD_DELAY配置,需要线程级阻塞应使用twisted.internet.threads.deferToThread。 - 注意新旧版本 API 迁移: 在阅读刘硕《精通Scrapy网络爬虫》时,读者会看到
scrapy.loader.ItemLoader,在 Scrapy 2.x 之后官方已将其拆分为独立的itemloaders库;另外,旧书中的scrapy.conf.settings已被废弃,现代代码应统一通过crawler.settings或spider.settings访问配置。 - 内存泄漏的主因是闭包引用 Response: 在使用
scrapy.Request(url, callback=self.parse_detail, cb_kwargs=...)传递参数时,切忌将庞大的response对象本身或其未提取的 selector 塞入 meta/cb_kwargs,这会导致 GC 无法回收已被处理的网页内存,从而引发高并发爬取时的内存溢出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









