

常见反爬机制解析:Python爬虫怎么应对IP封禁和验证码
深入解析Python爬虫在抓取过程中遭遇的IP封禁与验证码反爬机制,提供代理池构建、请求频率控制、无头浏览器环境绕过以及自动化验证码处理的完整解决方案与实操代码。
在编写网络爬虫提取公开数据时,最容易遇到的阻碍就是目标站点触发的访问频率限制与人机验证。本文将拆解服务端识别异常流量的核心依据,聚焦“IP封禁”与“各类验证码”两道防御屏障,提供从被动防御判定、代理池动态调度,到常见图形与行为式验证码识别处理的整套实战方案与代码实现。
反爬风控系统的核心判定逻辑
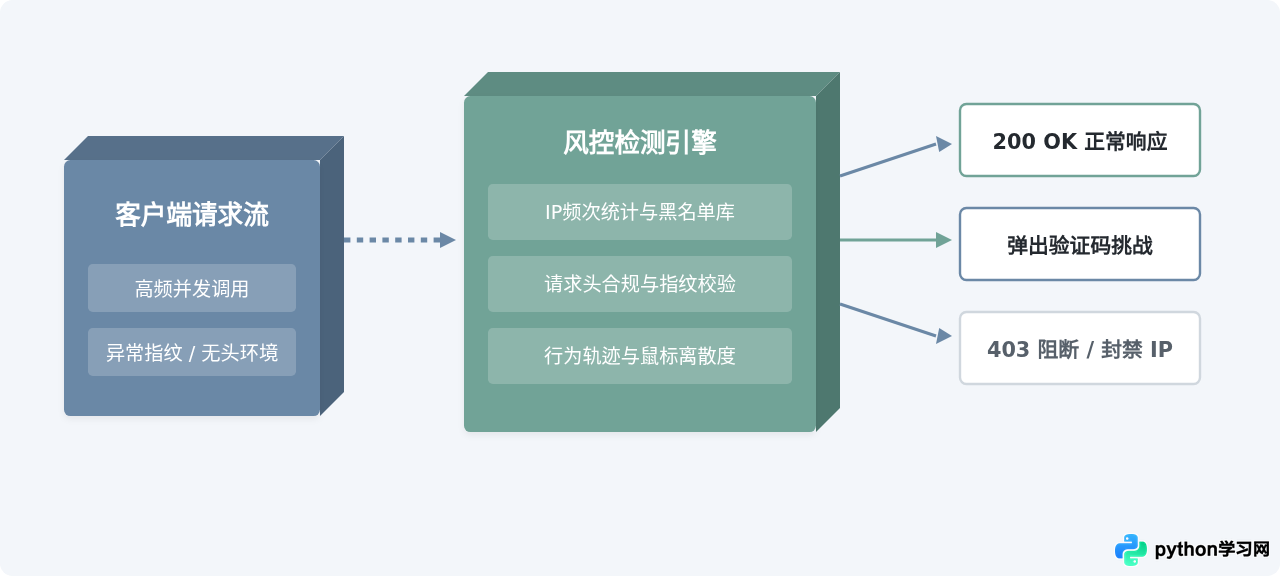
网站服务端的风控系统并非随机拦截请求,而是通过对网络层、传输层与应用层的特征提取,计算当前访问者的异常分值。当单项指标超标或综合评分超过安全阈值时,系统就会依序触发降频提示、强制验证码挑战乃至直接阻断IP通信。
针对请求来源的判定通常分为两个维度:一是网络层面的连接状态,包括单个IP的请求频度、TCP连接重用率以及地理分布;二是应用层面的环境特征,如HTTP请求头完整度、Cookie连贯性,以及浏览器运行时的指纹信息。
突破限制前必须做好的基础规范
在引入代理或图像识别等复杂方案之前,检查并修正请求客户端的基础特征能解决绝大多数初级拦截。很多初学者遇到的封锁并不是真正的风控黑名单,而是触发了最简单的防护规则。
1. 规范基础请求头与会话维持
默认状态下,Python的requests库会发送带有python-requests/x.x.x的User-Agent标识,这会直接被绝大多数Web应用防火墙(WAF)拒绝。必须伪装成现代主流桌面浏览器,并配齐标准标头:
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Accept-Encoding": "gzip, deflate, br",
    "Connection": "keep-alive",
}

session = requests.Session()
session.headers.update(headers)
response = session.get("[https://example.com/target-page](https://example.com/target-page)", timeout=10)
2. 节制请求频次并引入随机休眠
固定周期的请求(如精确的每秒1次)在服务器监控图表上表现为极度异常的机械波形。即使没有大规模并发,也会被滑动窗口统计算法标记。必须在每次抓取之间加入随机等待:
import time
import random

# 在每次请求循环后加入随机浮动等待
time.sleep(random.uniform(1.5, 3.8))
如何系统性应对IP封禁
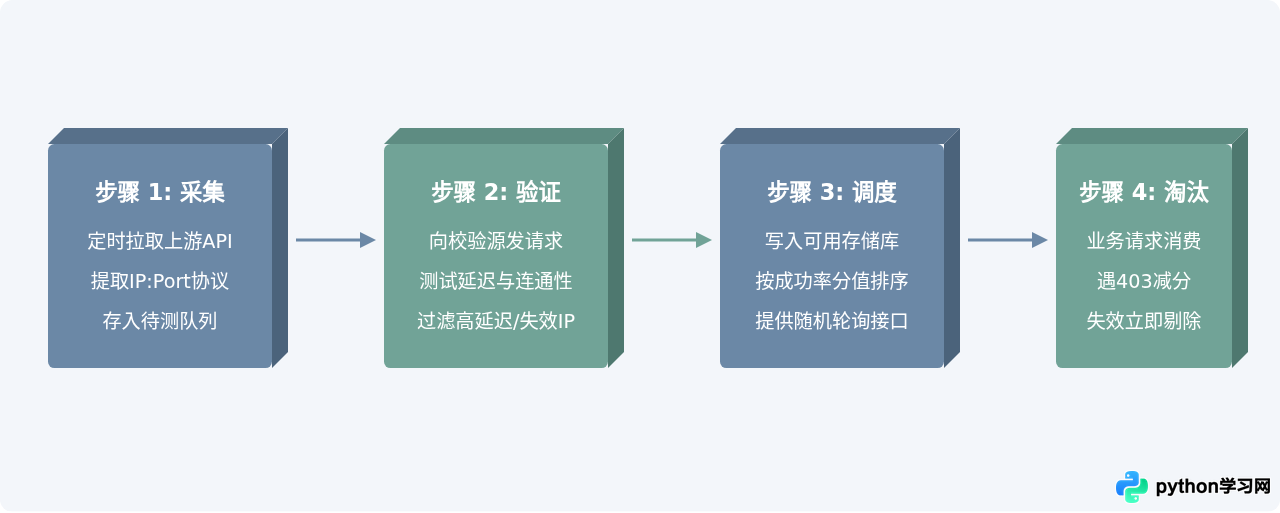
当目标服务开启基于单IP每分钟请求上限(Rate Limiting)的防御时,单节点无论怎么降低速度,总体吞吐量都无法支撑业务需求。此时唯一可靠的解法是构建动态代理IP池。
构建稳固的代理调度与自动重试机制
在网络请求中使用代理时,不能假设代理服务器百分之百可用。必须设置严格的超时控制,并配合重试装饰器或异常捕捉结构,当特定代理响应异常或返回403状态码时,立即从池中更换下一个IP重发请求。
下面是一个包含自动切换代理、捕获异常并降级重试的完整抓取模块:
import requests
from requests.exceptions import RequestException, Timeout

# 模拟本地缓存的可用代理列表(实际场景通常从Redis或代理服务商拉取)
PROXY_POOL = [
    "[http://103.152.112.120:8080](http://103.152.112.120:8080)",
    "[http://185.199.229.156:7492](http://185.199.229.156:7492)",
    "[http://45.152.188.243:3128](http://45.152.188.243:3128)"
]

def fetch_with_retry(url, max_retries=3):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
    }

    for attempt in range(max_retries):
        if not PROXY_POOL:
            raise RuntimeError("可用代理池已耗尽,请及时补充代理资源")

        proxy = PROXY_POOL[0]
        proxies = {
            "http": proxy,
            "https": proxy
        }

        try:
            # 必须设置较短的timeout,防止挂死在故障代理节点上
            response = requests.get(url, headers=headers, proxies=proxies, timeout=5)

            # 若服务器返回被封锁特征状态码,视同代理失效
            if response.status_code in [403, 429]:
                print(f"[警告] 代理 {proxy} 被目标服务器限制,状态码: {response.status_code}")
                PROXY_POOL.pop(0)
                continue

            return response.text

        except (Timeout, RequestException) as e:
            print(f"[错误] 代理 {proxy} 连接超时或异常: {e},正在切换下一个")
            PROXY_POOL.pop(0)

    return None

# 执行示例
content = fetch_with_retry("[https://httpbin.org/ip](https://httpbin.org/ip)")
print("抓取结果示例:", content)实战避坑:不要使用免费公开代理池采集生产级数据。这类节点往往早已被知名云安全服务商列入固定黑名单,且通信未加密,存在请求篡改和数据泄漏风险。对于大规模抓取任务,应采用按量计费的隧道代理(由服务端自动转发并轮询出口IP)。
各类验证码的具体识别与绕过技术
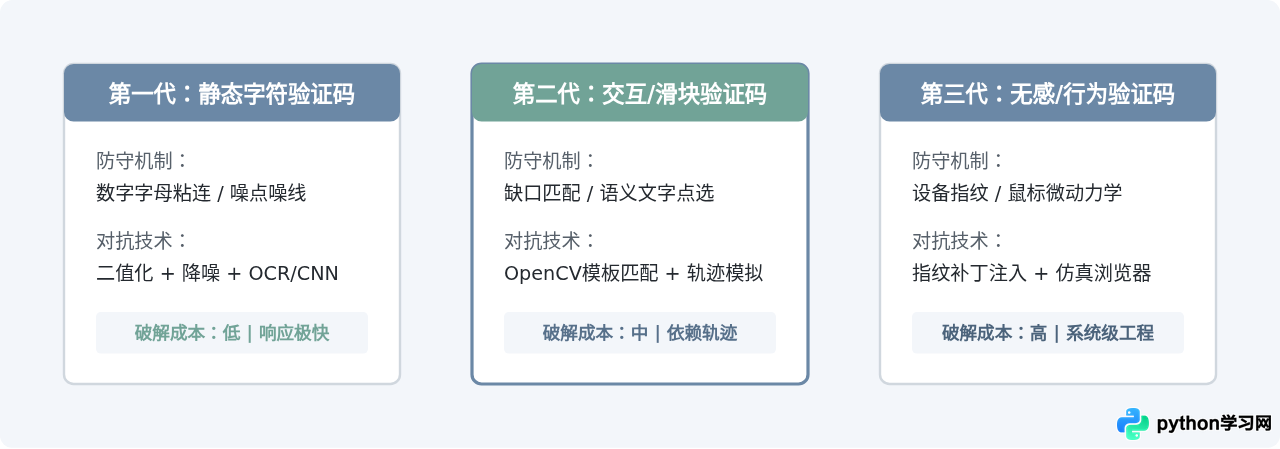
当请求被识别为嫌疑流量但尚未触发永久封禁时,系统通常会下发验证码。不同技术阶段的验证码在对抗成本和处理思路上有着本质差异。
1. 传统图形验证码:图像预处理 + OCR识别
对于扭曲的英文与数字图形验证码,直接送入OCR(光学字符识别)识别率通常偏低。标准的做法是利用Pillow或OpenCV库先进行灰度化与二值化处理,清除干扰线条和孤立噪点,再进行文字识别:
from PIL import Image
import pytesseract

def clean_and_ocr_image(image_path):
    # 1. 打开图像并转为灰度图
    img = Image.open(image_path).convert('L')

    # 2. 二值化处理(将像素根据阈值直接分为黑白两色)
    threshold = 140
    table = [0 if i < threshold else 255 for i in range(256)]
    img_binary = img.point(table, '1')

    # 3. 使用Tesseract进行字符推理识别(需要系统安装tesseract-ocr引擎)
    text = pytesseract.image_to_string(img_binary, config='--psm 7 -c tessedit_char_whitelist=0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ')
    return text.strip()

# 示例调用
# code = clean_and_ocr_image("captcha_sample.png")
# print("识别结果:", code)
2. 滑块验证码:缺口坐标识别与仿真滑动轨迹生成
滑块验证码不仅核验拼图是否复位,更严格审查用户拖拽滑块时的瞬时速度、加速度以及垂直微动(离散抖动)。单纯通过自动化工具将滑块瞬间移动到目标点,会直接被判定为作弊。
解决滑块验证包含两个核心步骤:
- 定位缺口位移:利用
cv2.matchTemplate对带缺口的背景图与滑块小图进行边缘提取与模板匹配,计算出水平偏移量 $X$。 - 拟合拟人轨迹:模拟人类操作时“先快速加速、接近终点时减速微调、带有轻微回退与垂直抖动”的物理规律。
import random
import cv2

def find_slider_gap(background_path, slider_path):
    """通过边缘匹配计算滑块缺口的水平相对距离"""
    bg_img = cv2.imread(background_path, 0)
    slider_img = cv2.imread(slider_path, 0)

    # 边缘检测,增强轮廓辨识度
    bg_edge = cv2.Canny(bg_img, 100, 200)
    slider_edge = cv2.Canny(slider_img, 100, 200)

    # 模板匹配
    res = cv2.matchTemplate(bg_edge, slider_edge, cv2.TM_CCOEFF_NORMED)
    min_val, max_val, min_loc, max_loc = cv2.minMaxLoc(res)

    # max_loc[0] 即为缺口在背景上的水平起始横坐标
    return max_loc[0]

def generate_human_track(distance):
    """
    根据给定的距离,生成符合物理变速与抖动的轨迹列表
    每个元素为当前时间步长前进的相对位移
    """
    tracks = []
    current = 0
    # 中途切换减速段的阈值位置
    mid = distance * 4 / 5
    v = 0
    t = 0.2

    while current < distance:
        if current < mid:
            a = random.uniform(2.5, 4.0)  # 加速段
        else:
            a = -random.uniform(3.0, 5.0) # 减速段

        v0 = v
        v = v0 + a * t
        move = v0 * t + 0.5 * a * (t ** 2)

        # 确保每次至少前进一步
        move = max(round(move), 1)
        current += move
        tracks.append(move)

    # 增加末端的人为微调抖动(回退与推进)
    tracks.extend([-1, -1, 1, 1])
    return tracks
在通过自动化工具(如Playwright或Selenium)控制页面时,依次读取该数组中的位移数据,并在每次移动后停顿若干毫秒,即可大幅提升滑块通过率。
3. 行为式无感验证码:浏览器指纹去混淆
以Cloudflare Turnstile、极验第4代或Google reCAPTCHA为代表的验证系统,会在前端执行复杂的JavaScript脚本,探测当前浏览器环境是否包含自动化工具的专属变量(例如navigator.webdriver = true、特定的插件列表或无头浏览器特有的Canvas渲染特征)。
针对这类机制,直接使用基础网络请求库基本无法通过,推荐使用支持深度指纹伪装的自动化工具执行操作。例如在Playwright启动时打上反侦测补丁:
from playwright.sync_api import sync_playwright

def run_stealth_browser():
    with sync_playwright() as p:
        browser = p.chromium.launch(
            headless=False, # 调试阶段建议开启可视化界面观察
            args=[
                "--disable-blink-features=AutomationControlled",
                "--no-sandbox"
            ]
        )
        context = browser.new_context(
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            viewport={"width": 1440, "height": 900}
        )

        # 注入初始化脚本,抹去浏览器核心环境中的自动化标记
        context.add_init_script("""
            Object.defineProperty(navigator, 'webdriver', {
                get: () => undefined
            });
            window.chrome = { runtime: {} };
        """)

        page = context.new_page()
        page.goto("[https://target-anti-scraping-website.com](https://target-anti-scraping-website.com)")
        page.wait_for_timeout(5000)
        browser.close()
反爬对抗架构总结与决策路径
在日常开发中,面对反爬限制切忌盲目上重度工具。复杂的拟人化环境虽然有效,但其运行速度和服务器资源消耗是纯接口调用的数十倍。应当按照“先排查轻量配置、再解耦代理流量、最后引入环境渲染”的阶梯式路径组织抓取架构。
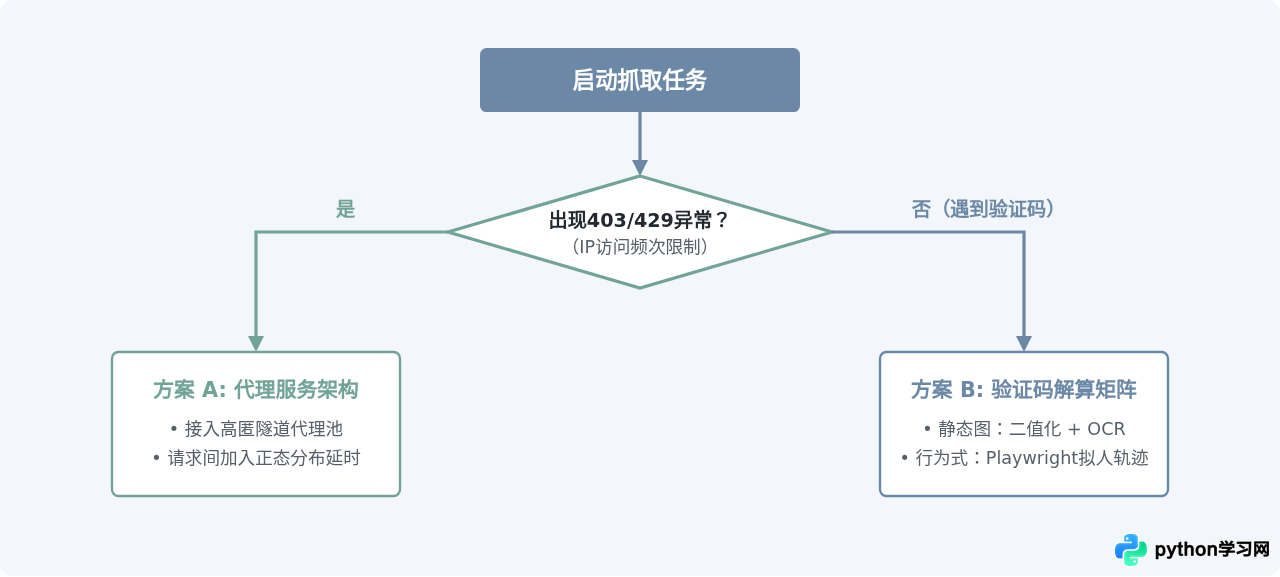
在实际工程中,合理的网络爬虫设计应遵循“最小扰动原则”:首先通过完善Header伪装、会话复用降低自身异味;当面对硬性频控时,交由代理中间件调度出向IP;遇到验证码时,根据其交互类型选择最低算力消耗的识别方案。将这些模块解耦封装,爬虫项目才能在面对站点的风控策略迭代时具备平滑维护的能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









