

Python爬虫与数据采集免费源码哪里找

寻找Python爬虫与数据采集的免费源码,最直接且高质量的路径是围绕公开代码托管平台、主流爬虫框架官方示例库、专业开发者技术社区以及数据科学竞赛项目展开。由于目标网站的前端架构与反爬策略更新频繁,获取源码的核心不仅是“下载文件”,更在于筛选出结构健全、近期维护、安全合规的高质量工程。本文将详细讲解四大免费渠道的检索方法、甄别有效代码的关键标准、源码安全审计要点,以及从下载到隔离试跑的标准操作步骤。
一、免费爬虫与采集源码的核心获取渠道
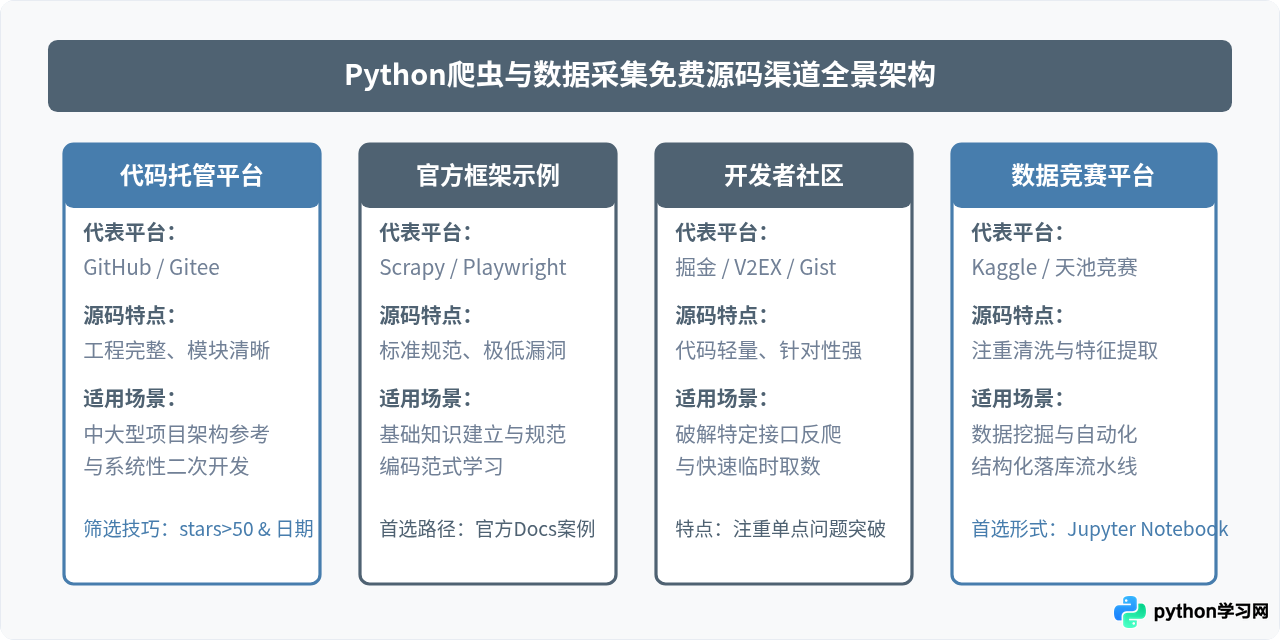
很多初学者寻找源码时习惯直接使用通用搜索引擎输入关键词,结果往往被导向失效的网盘链接、缺乏维护的技术博客镜像,或是诱导付费的旧资源打包。真正具备参考价值、结构清晰且规范的免费爬虫源码,主要集中在以下四类公开技术生态中:
1. 代码托管平台的高级语法检索(GitHub 与 Gitee)
GitHub 是全球开源爬虫项目最集中的平台,而 Gitee 则聚集了大量针对国内主流平台的采集示例。直接搜索站名往往会返回数千个废弃项目,必须配合高级搜索语法进行精确收敛:
- 指定编程语言与星标门槛:例如在搜索框中输入
language:python stars:>50 crawler,可以过滤掉随手建立的空白测试仓库。 - 按更新日期筛选:爬虫具有极强时效性,通过
pushed:>2024-01-01可以限定最近仍有代码推送的活跃项目。 - 聚合精选合集(Awesome 仓库):搜索
awesome-python-crawler或awesome-spider,这类由社区维护的专题仓库通常按照电商、社交、新闻、学术等领域对源码进行了系统归类与可用性标注。
2. 主流框架官方文档与随书开源仓库
如果学习目标是掌握生产级数据采集架构,官方提供的教程与示例项目是最权威的免费来源:
- Scrapy 官方示例:如官方维护的
scrapy/quotesbot项目,完整展示了基于 XPath 与 CSS 选择器的 Spider 编写规范、Pipeline 数据清洗流程与多层爬取逻辑。 - Playwright 与 Selenium 官方示例仓库:针对 JavaScript 动态渲染页面的自动化采集,官方仓库的
examples目录提供了如何处理页面等待、处理无限滚动、监听网络请求与导出 JSON 的规范代码。 - 技术出版物配套源码:正规出版社出版的爬虫书籍(如人民邮电出版社、清华大学出版社出版的 Python 爬虫实战教程),其配套的 GitHub 组织或 Gitee 仓库通常对公众完全免费开放,代码注释丰富且带有清晰章节规划。
3. 开发者技术社区与开源片段分享库
当面临特定接口逆向、特殊反爬验证或单页面精准抓取时,完整项目往往过于庞大,而技术社区中的代码片段更为直接有效:
- GitHub Gist 与 Pastebin:搜索特定网站名称加上
gist.github.com,常能找到工程师分享的精简单文件采集脚本(Stand-alone Scripts)。 - Stack Overflow:搜索具体报错或提取逻辑(例如
python extract table from html beautifulsoup),回答中附带的不仅是源码,还有针对异常情况的容错处理方案。 - 国内活跃技术社区:如掘金、V2EX、知乎技术专栏。搜索具体平台数据采集时,开发者通常会在文章中附上关键逆向函数或完整的 Gitee 仓库链接。
4. 数据科学与机器学习竞赛平台
Kaggle、阿里天池等数据竞赛平台上,有大量参赛选手公开的“数据预处理与网络采集”Notebook:
- 这些源码不仅包含网络请求部分,还涵盖了完整的 Pandas 数据清洗、缺失值填充、结构化字段对齐及存入 SQLite 或 Parquet 的全链路流水线。
- 对于需要学习“采集与数据分析结合”的读者,这类源码的工程参考价值极高。
二、从搜索到本地运行的标准化实操流程
检索到开源源码后,切忌直接在本地物理环境中无防护执行。网络爬虫涉及网络通信、三方包安装及频繁磁盘IO,遵循标准化的“检索-筛选-审计-隔离试跑”流程是确保效率与安全的基础:
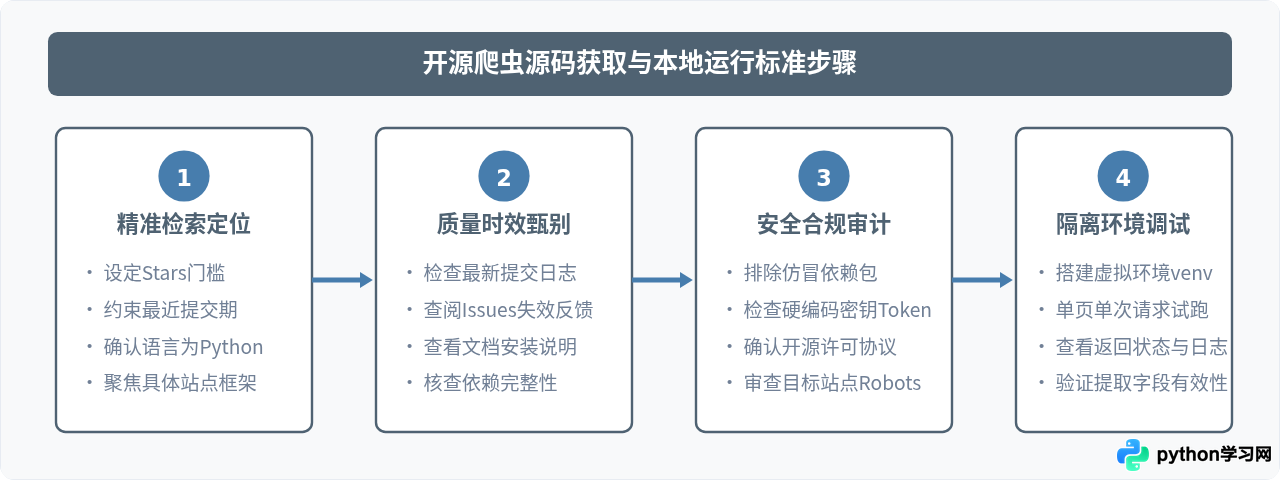
步骤一:使用命令行工具克隆或下载源码
选定目标项目后,使用 Git 工具克隆代码到本地工作目录:
# 以抓取通用开源示例仓库为例
git clone --depth 1 https://github.com/scrapy/quotesbot.git
cd quotesbot
使用 --depth 1 参数可以只拉取最新一次提交,避免下载冗长的历史提交记录,显著提升下载速度并节省磁盘空间。
步骤二:创建独立虚拟环境隔离依赖
为避免开源项目携带的依赖版本污染系统全局 Python 环境,必须在项目根目录新建独立的虚拟环境:
# 创建名为 .venv 的虚拟环境
python3 -m venv .venv

# 激活虚拟环境 (macOS / Linux)
source .venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
# .venv\Scripts\Activate.ps1
步骤三:审计并安装依赖清单
查看根目录下的 requirements.txt,确认库名无误后再执行安装:
# 确认依赖项后静默安装
pip install --no-cache-dir -r requirements.txt
步骤四:单页断点调试验证
不要一上来就启动全站批量抓取。建议在代码中临时将抓取页数限制为 1,或者提取单条 URL 进行打印测试:
# Scrapy 框架单次调试命令示例
scrapy parse --spider=toscrape-css http://quotes.toscrape.com/
检查输出控制台中是否正确输出了目标字段(如标题、标签、作者),确认状态码为 200 且无解析异常后,再展开后续业务开发。
三、海量开源爬虫源码的甄别与安全审计
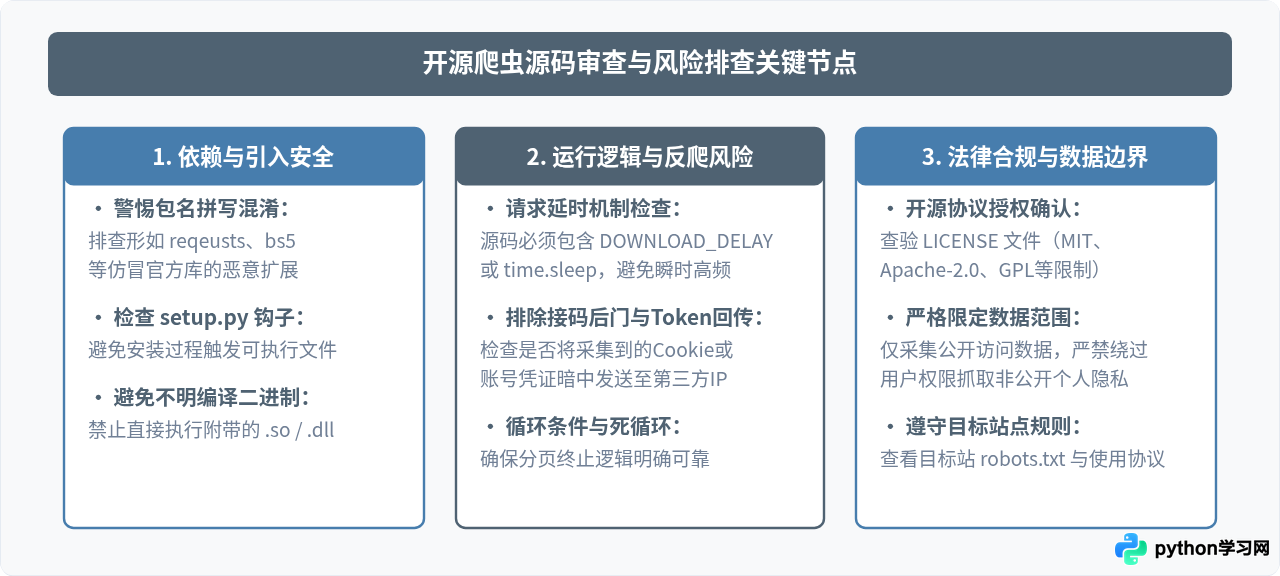
网络爬虫是开源代码中“失效度最高”且“安全隐患相对集中”的领域之一。未经审查的代码可能会破坏开发环境,甚至带来法律风险:
四、渠道选型与业务场景匹配总结
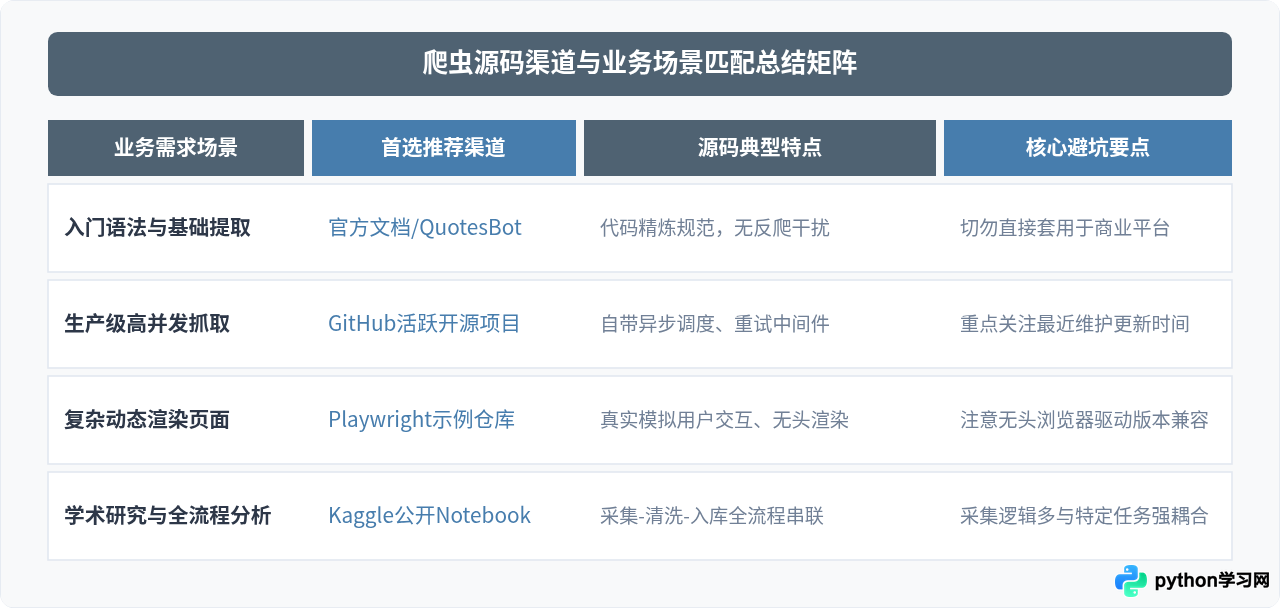
不同的学习阶段与实际业务需求,适合的免费源码来源并不相同。下表梳理了针对不同需求场景下的最优渠道选型矩阵:
五、常见问题与解决建议
1. 下载回来的源码运行直接报错 403 Forbidden 或连接被重置?
这通常是因为目标站点已经升级了前端反爬机制(例如增加了 User-Agent 校验、Cookie 签名或 IP 访问频率限制)。解决办法是在请求头中补全标准的 headers = {'User-Agent': 'Mozilla/5.0 ...'},并在每次请求间增加随机延时。若依然 403,查看该仓库在 GitHub 上的最新 Issues,通常会有其他遇到相同问题的开发者提供修复补丁。
2. 为什么网盘打包的“上百个爬虫实战合集”往往无法运行?
目标商业网站的 HTML 结构平均每 3 到 6 个月就会微调一次,而反爬算法(如滑块验证、加密参数)则迭代更快。网盘中打包的源码多数是一次性编写后未持续维护的死代码,选择代码托管平台上近期有 commit 记录的开源项目,才能保证学习与参考价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









