

Python爬虫报错怎么办?常见编码错误与连接超时排查思路
针对Python网络爬虫常见的编码解析异常与网络连接超时问题,提供成因分析、具体排查步骤、代码修复示例与配置建议。
编写爬虫抓取网页时,程序中断通常主要集中在两类节点上:第一类发生在网络请求阶段,表现为长时间无响应后抛出 ConnectTimeout 或 ReadTimeout;第二类发生在获取响应后的文本解析阶段,控制台抛出 UnicodeDecodeError,或者文本直接呈现为一连串不可读的乱码。本文将直接拆解这两大类错误的产生根源,提供标准化的排查步骤与修复代码,帮助你在实际抓取任务中定位并解决问题。
一、编码错误(UnicodeDecodeError 与中文乱码)的成因与排查
抓取中文页面时,常见的编码问题主要有两种表现形式:一种是程序在调用解码方法(如 bytes.decode())时直接崩溃,抛出 UnicodeDecodeError: 'utf-8' codec can't decode byte...;另一种是脚本正常运行,但提取出的中文内容显示为类似 ä¸æ–‡ 或 的杂乱字符。
网络传输本质上只传递二进制字节(Bytes)。当 HTTP 客户端(例如 requests 库)将响应内容转为字符串时,必须依赖一套字符编码规则把字节映射为字符。如果服务端实际采用的是 GBK 或 GB2312 编码,而爬虫尝试用 UTF-8 去解析,就会产生字节无法映射的异常;反之,若使用了不匹配的解码规则强行容错,便会形成视觉上的乱码。
排查步骤与解决办法
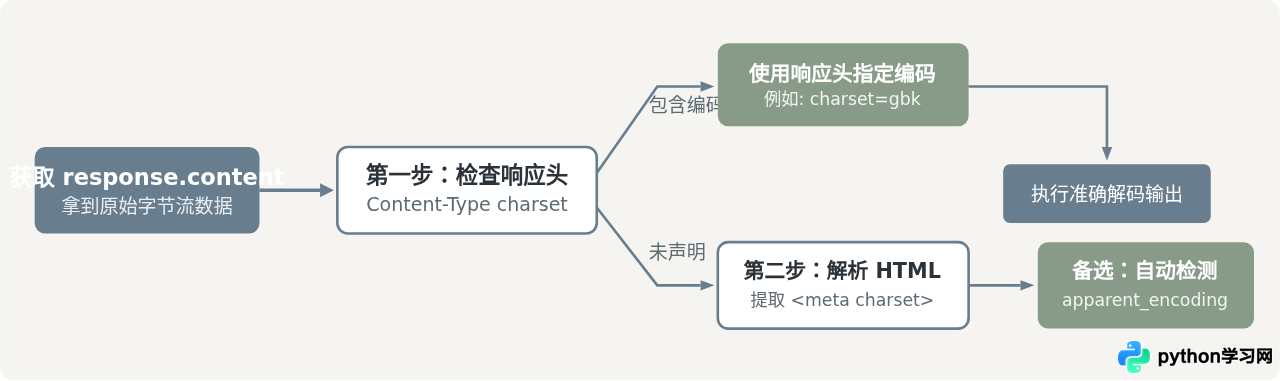
- 查看响应头的 Content-Type 字段:在发起请求后,先通过
response.headers.get('content-type')检查服务端是否显式告知了字符集,例如text/html; charset=gb2312。 - 检查网页内部的 meta 标签:部分服务端在 HTTP 响应头中仅返回
text/html而忽略了 charset,但会在 HTML 页面的<head>区域声明<meta charset="gbk">或<meta http-equiv="Content-Type" content="text/html; charset=gbk">。 - 使用二进制内容手动解码:当标准属性给出的结果不准确时,不要直接读取
response.text,改用response.content获取原始bytes数据,再手动传入指定的字符集进行解码。
import requests

url = "https://example.com/gbk-article"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

response = requests.get(url, headers=headers)

# 方式一:如果明确知晓或已检测到页面采用 GBK
response.encoding = 'gbk'
text_correct = response.text

# 方式二:直接操作原始字节流,遇到微小非标字符时忽略容错
# errors='replace' 会将无法识别的字节换为占位符,避免抛出崩溃异常
try:
    content_text = response.content.decode('gbk')
except UnicodeDecodeError:
    # 遇到混合编码或个别非法字符时的备选方案
    content_text = response.content.decode('gb18030', errors='ignore')

print("解析结果字符数:", len(content_text))
GB18030 规范。如果你在使用 gbk 解码时仍然偶发 UnicodeDecodeError,可以直接将解码格式提升为 gb18030。
深度对比:response.text 与 response.content.decode()
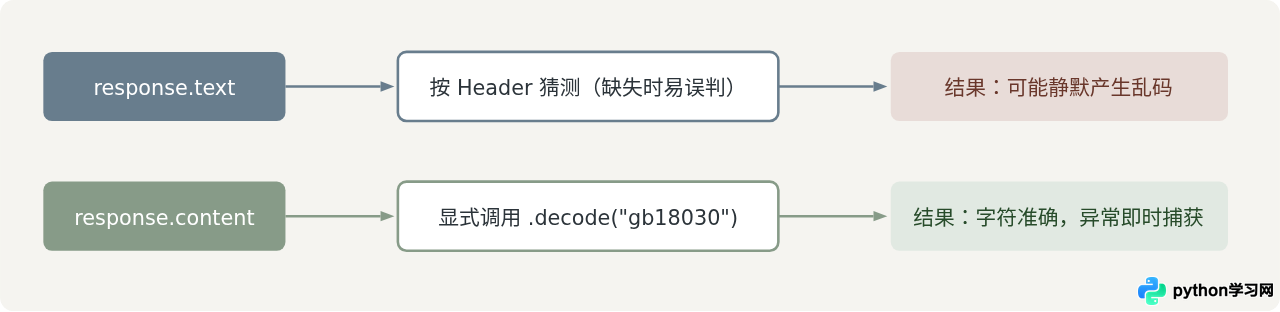
很多开发者习惯于直接使用 response.text,但在批量抓取多样化站点时,了解这两种文本提取方式的内在差异能够有效减少解析事故:
| 对比维度 | response.text 机制 |
response.content.decode('指定编码') 机制 |
|---|---|---|
| 编码决定方式 | 依赖 HTTP 标头猜测,缺失时依据 HTTP 规范可能默认回退为 ISO-8859-1。 |
由开发者显式传入确切字符集(如 utf-8、gb18030)。 |
| 报错倾向 | 通常不会抛出语法级错误,但会直接将文本解析为拉丁乱码(Mojibake)。 | 若指定的字符集与实际字节不符,会直接触发 UnicodeDecodeError。 |
| 容错可控性 | 内部隐式转换,难以对局部非法字符设置 ignore 或 replace 参数。 |
可以通过 errors 参数精确控制坏字符的处理逻辑。 |
| 适用场景 | 标头定义标准明确、且编码统一为 UTF-8 的现代 API 与网站。 | 爬虫工程、异构多源数据抓取、或存在陈旧 GBK 规范的目标站点。 |
二、连接超时(ConnectTimeout 与 ReadTimeout)的排查与处理
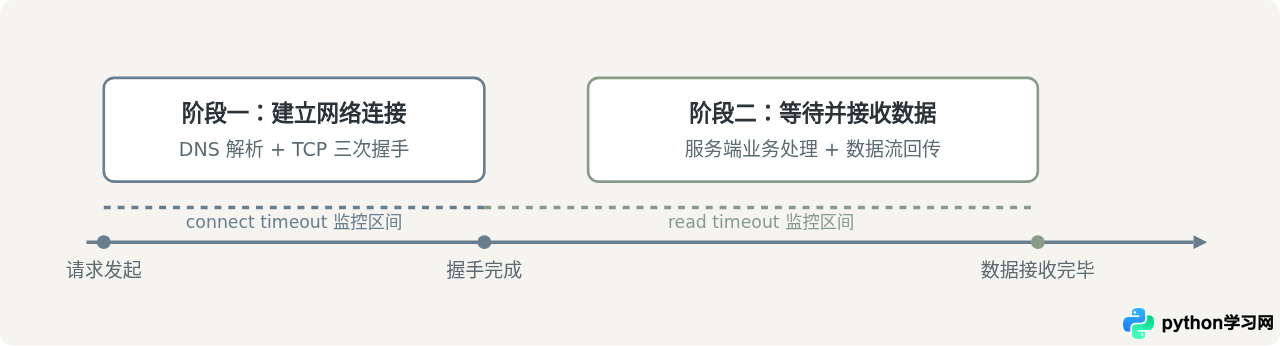
爬虫在网络层面的等待并不是无限期的。如果在指定时间内无法完成网络交互,客户端就会主动抛出超时异常。理解超时问题的前提,是将 HTTP 的连接生命周期拆开来看。
在 Python 的 requests 库中,超时主要由两部分构成:
- 连接超时(Connect Timeout):客户端尝试与目标服务器建立 TCP 连接(即三次握手阶段)所允许的最大时长。如果目标服务器宕机、防火墙拦截、路由不可达或本地代理失效,均会导致无法建连。
- 读取超时(Read Timeout):TCP 连接已经成功建立,客户端已发出请求,但在等待服务端返回第一个字节或者完整数据块时超过了预设时间。这通常由于目标服务器处理任务过载、数据库查询缓慢或目标站点启用了针对抓取行为的限速与挂起策略。
排查步骤与解决办法
- 拆分设置超时阈值:不要使用单一数值传递
timeout,建议以元组timeout=(连接时长, 读取时长)的方式调用。例如timeout=(3.05, 10),建连时允许 3.05 秒(略大于 TCP 数据包重传周期),给服务端处理留出 10 秒。 - 使用代理时的专项检查:若配置了
proxies,ConnectTimeout通常意味着代理服务器无法连通,或是代理节点到目标站点通路中断。优先不挂代理直接请求一次,验证是否是代理节点故障。 - 设置自动重试机制:偶发的超时并不代表目标站点永久不可用,网络抖动非常普遍。利用
urllib3提供的Retry工具结合requests.Session,可以在捕获特定异常后按指数退避策略自动重发。
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

session = requests.Session()

# 配置重试规则:针对网络连接与读取问题,重试 3 次,并在重试间隔逐渐增加等待时间
retry_strategy = Retry(
    total=3,
    backoff_factor=1,  # 间隔依次递增:1s, 2s, 4s...
    status_forcelist=[429, 500, 502, 503, 504],
    raise_on_status=False
)

adapter = HTTPAdapter(max_retries=retry_strategy)
session.mount("http://", adapter)
session.mount("https://", adapter)

url = "https://example.com/api/data"

try:
    # 明确设置 (连接超时, 读取超时),避免无限挂起
    response = session.get(url, timeout=(3.05, 10))
    response.raise_for_status()
    print("请求成功,状态码:", response.status_code)
except requests.exceptions.ConnectTimeout:
    print("排查建议:检查本地网络连通性、代理有效性,或目标域名解析是否正常。")
except requests.exceptions.ReadTimeout:
    print("排查建议:服务端响应缓慢或正遭遇反爬限制,可考虑加大读取超时或更换请求头。")
except requests.exceptions.RequestException as e:
    print("网络请求未完成:", str(e))
三、爬虫排查综合工作流与异常防护
在实际生产或批量抓取脚本中,编码问题与超时问题经常交织出现。规范的做法是将网络请求层与内容解码层分离开来,先通过带防护机制的会话拉取二进制数据,再根据页面特征执行容错解码。这样可以确保爬虫程序在面对未知网络波动或格式不标准的杂乱网页时,具备稳定运行和收集失败现场的能力。
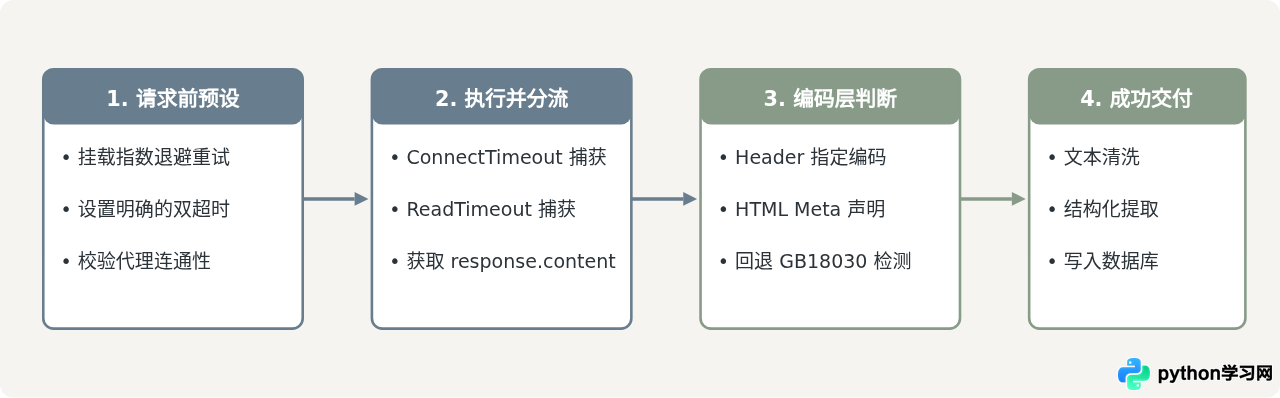
排查爬虫故障的关键,在于**准确定位问题发生的环节**。如果程序在发起请求后停顿卡死,应优先检查网络通路、分拆设置 (connect, read) 超时时间并挂载异常捕获;如果请求顺利完成但文本无法阅读或抛出解码错误,应果断绕过默认推断,提取 response.content 原始字节,采用与实际网页相匹配的编码规范(如 utf-8 或 gb18030)进行显式解码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









