

Python文件打开乱码怎么办:UTF-8编码识别与转换
针对Python打开文本文件出现中文乱码或UnicodeDecodeError报错的问题,系统解析字符与字节解码原理,提供显式编码指定、未知编码自动探测及批量转换为标准UTF-8文件的实用解决方案。
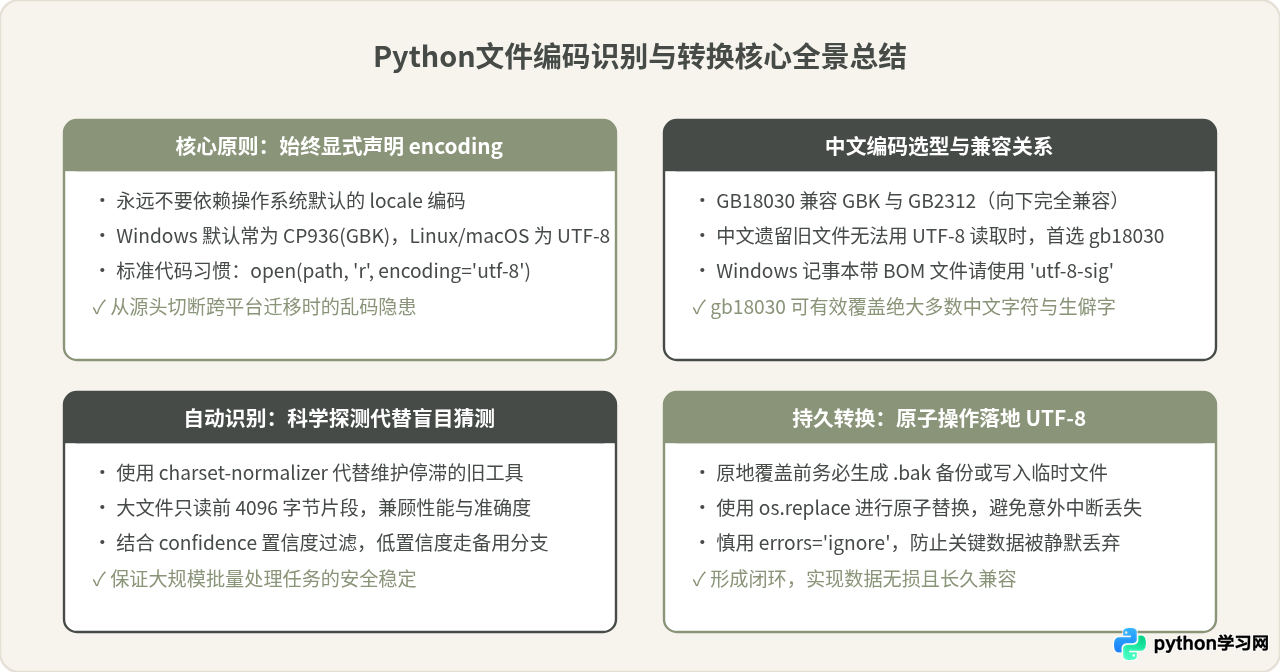
在 Python 程序中读取外部文本文件时,遇到中文乱码或触发 UnicodeDecodeError 异常,其根本原因只有一个:读取时解释器采用的字符解码规则,与该文件在磁盘中固化的二进制编码格式不一致。解决这一问题的标准路径非常明确:首先在 open() 函数中通过 encoding 参数显式声明与源文件匹配的编码(如 UTF-8 或 GB18030);若源文件编码未知,则提取前部二进制片段使用统计探测工具识别出其真实编码;确认无误后,将内容重新以标准无 BOM 的 UTF-8 编码写回,即可彻底消除环境依赖与乱码隐患。
一、乱码与解码错误的本质:字节与字符的映射断裂
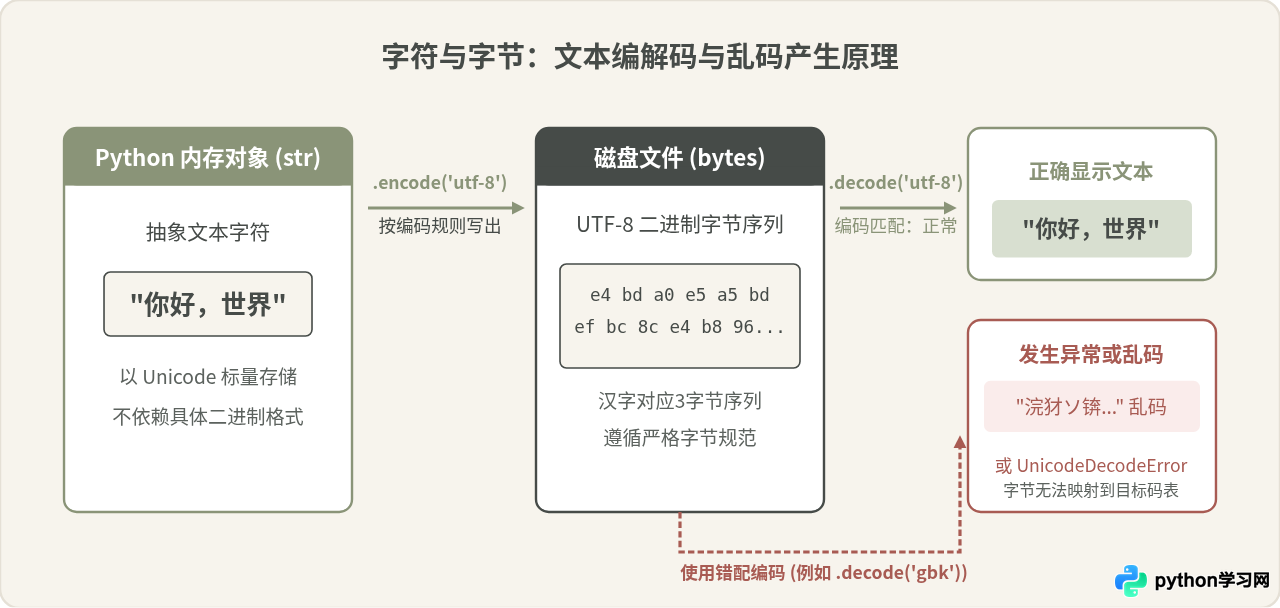
计算机磁盘无法直接存储抽象的字符,所有文本文件在底层均是由 0 和 1 构成的字节流(bytes)。Python 3 在内存中处理字符串(str)时使用统一的 Unicode 标量值。当我们调用 open(filename, 'r') 读取文本时,Python 会在后台自动完成一步“二进制字节流向 Unicode 字符串的映射还原”,这一过程称为解码(Decode)。
不同的编码规范在多字节序列与字符之间的映射关系差异极大:
- UTF-8 编码:采用可变长度设计,英文字符占用 1 个字节,常用中文字符通常占用 3 个字节(以
0xE4~0xE9引导)。 - GBK / GB2312 编码:专门用于中文环境的双字节编码,每个汉字固定占用 2 个字节(首字节在
0x81~0xFE之间)。
当一个由 Windows 早期软件以 GBK 编码保存的文件,被 Python 以默认的 UTF-8 解码器逐字节读取时,UTF-8 解码器会尝试在指定的字节位置寻找合法的 3 字节前缀标志。一旦遇到不符合 UTF-8 语法的字节组合,解释器就会立即抛出类似 UnicodeDecodeError: 'utf-8' codec can't decode byte ... in position ...: invalid start byte 的致命错误。反之,若在没有抛出异常的容错机制下错配了码表,字节虽被强行映射为字符,屏幕上便会呈现如“浣犲ソ”或连续的“锟斤拷”等无法辨识的乱码。
二、Python文件乱码排查与处理四步法
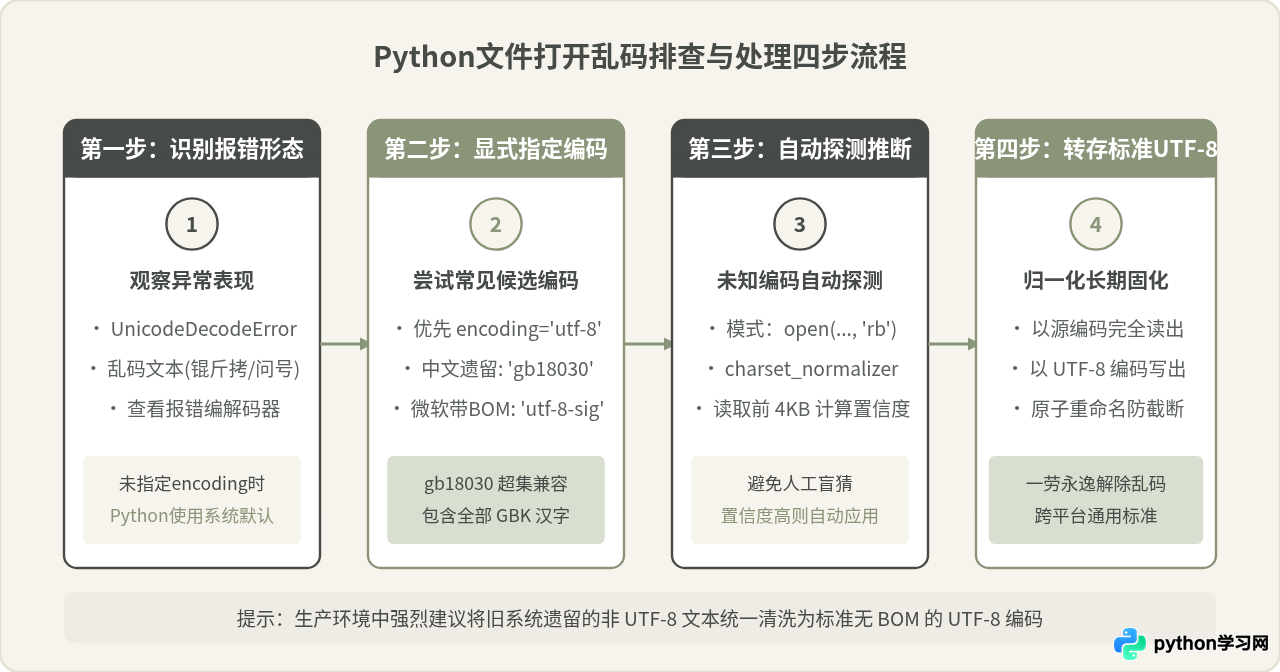
排查文件乱码问题时,切忌在代码中反复盲目更改编码名称。遵循清晰的层次化排查步骤,可以在数分钟内定位并根治绝大部分问题。
步骤 1:避免隐式默认编码,显式声明 UTF-8
如果不向 open() 传入 encoding 参数,Python 将调用底层的 locale.getpreferredencoding(False) 获取当前操作系统的默认编码。在 macOS 和大多数现代 Linux 发行版中,该值通常为 utf-8;但在简中 Windows 系统中,默认值往往是代码页 936(即 cp936,兼容 GBK)。同一段代码在不同机器上运行,一个成功一个报错,多由此引起。
# 推荐的基础打开方式:显式指定 UTF-8
with open("data.txt", "r", encoding="utf-8") as f:
    content = f.read()
步骤 2:针对中文旧系统文件,尝试 GB18030 兼容集
如果声明 encoding="utf-8" 时触发了解码报错,说明源文件极大概率是在旧版 Windows 环境或特定政企管理软件中生成的中文编码文件。此时不要直接写 gb2312 或 gbk,而是应当优先指定 gb18030。
GB18030 是国家标准编码,它是 GBK 和 GB2312 的严格超集。许多在 gb2312 甚至 gbk 中因生僻字、特殊标点或少数民族文字引发的解码中断,在 gb18030 下都能顺畅通过。
# 尝试中文全集编码 GB18030
try:
    with open("legacy_data.txt", "r", encoding="gb18030") as f:
        content = f.read()
except UnicodeDecodeError:
    # 说明编码既不是 UTF-8 也非 GB 系列,进入下一步探测
    pass
步骤 3:处理微软环境特有的 BOM 标记(UTF-8-SIG)
使用 Windows 记事本等编辑器保存“UTF-8”时,编辑器可能会在文件开头插入 3 个不可见的标记字节:0xEF 0xBB 0xBF(即 Byte Order Mark,BOM)。
如果直接用标准的 encoding="utf-8" 读取,Python 会把这 3 个字节原封不动地解码为一个特殊的零宽非换行空格字符 \ufeff,这会导致字典键名匹配失败、JSON 解析异常或首行标题比对错误。针对此类文件,使用 Python 内置的 utf-8-sig 编解码器即可自动剥除开头的 BOM 标记。
# 自动识别并剥离文件头部的 UTF-8 BOM 标记
with open("windows_utf8.csv", "r", encoding="utf-8-sig") as f:
    header = f.readline()
步骤 4:合理使用 errors 容错参数
在处理规模庞大或存在轻微局部损坏的日志文件时,若个别脏字节不影响整体分析,可以通过 errors 参数控制解码策略:
errors="replace":遇到不合法字节时不中断程序,统一替换为标准替代符号(U+FFFD)。errors="ignore":直接忽略并跳过所有无法识别的非法字节。
三、未知编码的自动识别:使用探测工具
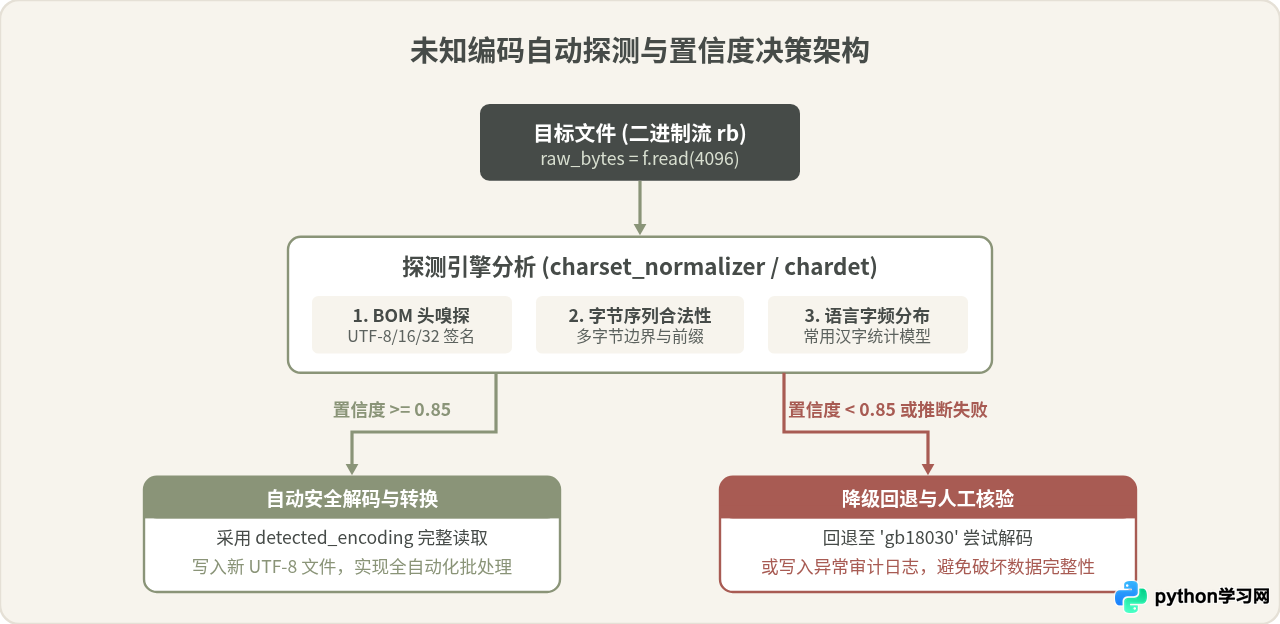
当批量接入大量来源未知的第三方文本(如用户上传数据、爬虫抓取网页、历史日志)时,人工逐个尝试显然不现实。这时可以通过读取原始二进制字节流,利用统计模型来自动识别文件编码。
过去 Python 社区常用 chardet,而现代工程实践中推荐使用性能更优、准确度更高且被 requests 官方默认集成的 charset-normalizer。
import charset_normalizer

def detect_file_encoding(file_path: str, sample_size: int = 4096) -> str:
    """
    通过读取前部二进制字节流,智能推断文件真实编码。
    """
    with open(file_path, "rb") as f:
        raw_chunk = f.read(sample_size)

    # 执行探测分析
    results = charset_normalizer.from_bytes(raw_chunk)
    best_match = results.best()

    if best_match is not None and best_match.encoding is not None:
        # 获取推断出的编码标准名(如 'utf_8', 'gb18030', 'big5')
        detected_enc = best_match.encoding
        # 若推断为 gbk,建议直接使用能力更全面的 gb18030
        if detected_enc.lower() in ("gbk", "gb2312"):
            return "gb18030"
        return detected_enc

    # 探测无法确信时的兜底方案
    return "utf-8"

# 示例调用
detected = detect_file_encoding("unknown_log.txt")
print(f"推断文件编码为: {detected}")

# 使用推断出的编码安全打开
with open("unknown_log.txt", "r", encoding=detected) as f:
    text = f.read()
四、实操演练:批量将非 UTF-8 文件清洗转换为标准 UTF-8
每次都在业务代码中针对不同编码做分支处理,既降低了程序的运行效率,也增加了维护成本。对于团队协作或工业化项目,最佳实践是将接收到的旧编码文件一次性永久转换为标准 UTF-8。
转换时需要注意两个核心工程安全原则:
- 原子替换写入:切勿直接以
w模式覆盖源文件。若在写出过程中遭遇断电或进程中断,源文件内容将直接被清空截断。正确的做法是先写入同目录下的临时文件,写入校验成功后,通过os.replace()完成原子替换。 - 显式去除 BOM:将
utf-8-sig文件统一以utf-8保存,彻底摆脱 Windows 特有标记带来的干扰。
import os
import shutil

def convert_to_utf8(file_path: str, source_encoding: str = None) -> bool:
    """
    安全地将指定文件转存为标准 UTF-8 编码文件。
    采用临时文件加原子替换策略,保障数据绝对完整。
    """
    # 若未指定来源编码,则自动探测
    if source_encoding is None:
        source_encoding = detect_file_encoding(file_path)

    # 规范化编码名称比对
    normalized_name = source_encoding.lower().replace("-", "_")
    if normalized_name in ("utf_8", "utf8", "ascii"):
        # 检查是否包含 UTF-8 BOM
        with open(file_path, "rb") as f:
            if f.read(3) != b'\xef\xbb\xbf':
                # 已经是标准无 BOM UTF-8,无需重复转换
                return True
        source_encoding = "utf-8-sig"

    temp_path = f"{file_path}.tmp_conv"
    bak_path = f"{file_path}.bak"

    try:
        # 以原始编码读取,以标准 utf-8 写入临时文件
        with open(file_path, "r", encoding=source_encoding) as src, \
             open(temp_path, "w", encoding="utf-8") as dst:
            for line in src:
                dst.write(line)

        # 备份原文件
        shutil.copy2(file_path, bak_path)
        # 原子性重命名替换目标文件
        os.replace(temp_path, file_path)
        # 确认成功后移除备份文件(按需保留)
        if os.path.exists(bak_path):
            os.remove(bak_path)
        return True

    except Exception as exc:
        print(f"转换文件 {file_path} 失败: {exc}")
        if os.path.exists(temp_path):
            os.remove(temp_path)
        return False
五、常见认知误区与辨析
误区 1:“Python 3 默认全部是 UTF-8,不传 encoding 绝无问题”
辨析:这是初学者最容易踩的坑。Python 3 源码文件(.py)自身的解析默认使用 UTF-8,但这并不等同于内置 open() 函数在运行时也是 UTF-8。如前文所述,在未显式传递 encoding 参数时,open() 严格取系统的 locale 首选项。Windows 默认依然是 cp936。任何脱离环境写出 open(path, 'r') 的代码,都是潜藏的跨平台故障点。
误区 2:“文件乱码了,在内存中再 encode('utf-8') 一次就能还原”
辨析:这种说法只有在极特殊条件(单字节编码 Latin-1 错配)下才偶尔巧合成立,在包含多字节汉字的场景下完全不成立。如果一个 GBK 编码的文件被以 UTF-8 读取:
- 如果触发了
UnicodeDecodeError,程序已经中断,内存中根本没有字符串对象可供重新调用encode()。 - 即使强行用
errors='ignore'或errors='replace'读入,无法识别的字节已经被直接丢弃或被替换为,原始信息在解码阶段就已经不可逆地丢失了。
正确的逻辑始终是:回到磁盘文件层面,以正确的源编码重新执行 decode。
误区 3:“遇到报错直接加 errors='ignore' 最省心”
辨析:errors='ignore' 看似让程序不再抛出红字报错,但在数据分析、金融报表或代码解析等严谨场景下是极其危险的。它会静默吃掉无法识别的汉字,导致“张伟”变成“张”,或者让数字与标点发生错位。errors='ignore' 仅适用于无关紧要的调试日志收集,正规数据清洗必须优先寻找匹配的真实编码。
六、排查速查与方案总结
| 使用场景 / 文件来源 | 推荐 open 参数 | 机制说明与注意事项 |
|---|---|---|
| 现代标准跨平台项目、Linux/macOS 文件 | encoding="utf-8" |
国际通用工业标准,首选配置,不带 BOM |
| Windows 记事本、部分 Excel 导出的 CSV | encoding="utf-8-sig" |
自动识别并滤除文件头部的 0xEF 0xBB 0xBF 标记 |
| 传统行业旧系统、国内政府/银行老旧接口数据 | encoding="gb18030" |
全面向后兼容 GBK 与 GB2312,覆盖全部生僻字 |
| 第三方未知文件、海量批处理管道 | 配合 charset_normalizer 动态推断 |
先取前 4KB 二进制探测编码名,再以推断编码打开 |
| 低价值大型日志、即使轻微丢字也不中断服务 | encoding="utf-8", errors="replace" |
将异常字节替换为 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









