

运行Python脚本时出现UnicodeDecodeError编码错误怎么办

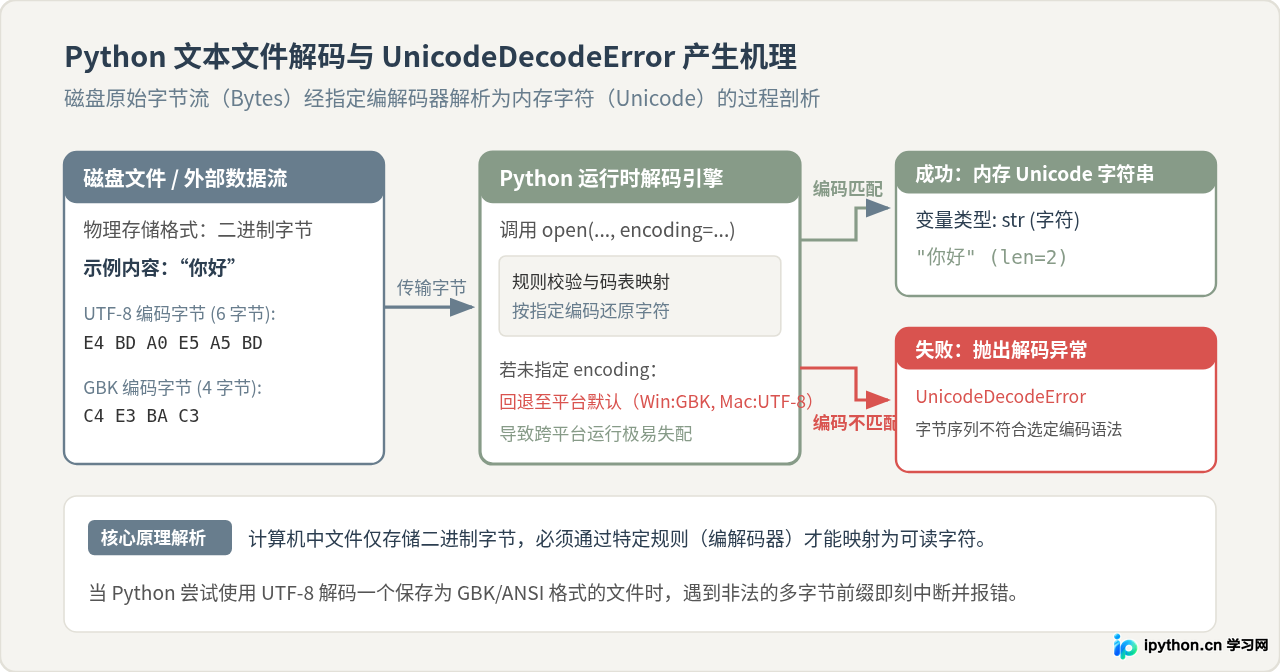
在运行 Python 脚本处理文本文件、网络请求或执行子进程命令时,UnicodeDecodeError 是一种高频出现的运行时异常。该错误的本质非常明确:Python 的解码器尝试使用某种字符编码(如 UTF-8)去解析一段二进制字节流时,遇到了不符合该编码规则的非法字节序列。这通常是因为文件在保存时采用的编码格式(例如 Windows 系统常见的 GBK 或 ANSI)与 Python 打开文件时采用的解码编码不一致。解决这一问题的标准路径包含三步:首先根据错误堆栈定位问题文件与发生行,其次查明或检测该文件的真实保存编码,最后在调用 open() 时显式传入对应的 encoding 参数。本文将系统拆解该错误的产生机理、排查流程、修复方案与工程防护规范。
一、读懂报错信息,快速定位故障根源
当 Python 抛出 UnicodeDecodeError 时,终端输出的堆栈跟踪信息已经指明了问题的核心要素。一个典型的报错日志如下所示:
Traceback (most recent call last):
  File "process_data.py", line 12, in <module>
    content = file.read()
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 0: invalid start byte
剖析上述错误信息,我们可以直接提取出三个排查线索:
- 使用的编解码器(Codec):报错前半段的
'utf-8' codec表明 Python 当前正尝试使用 UTF-8 编码规则来解析目标数据。 - 发生异常的具体字节(Byte):
byte 0xc4表示解码器在数据流中遇到了十六进制值为0xC4的字节。在 UTF-8 标准中,多字节序列的前导字节和延续字节有严格的二进制位分布规则,0xC4后续若未跟随合法的延续字节,就会被判定为无效字节;然而在 GBK 或 GB2312 编码中,0xC4恰好是汉字“你”的第一个字节(“你”的 GBK 编码为0xC4 0xE3)。 - 错误位置与类型(Position & Reason):
in position 0: invalid start byte指明了解码失败发生在第 0 个字节偏移处,直接原因是“无效的起始字节”。
二、排查与修复的五个标准步骤
排查 UnicodeDecodeError 时,建议遵循从错误捕获、调用定位到真实编码检测的闭环流程,切忌在未查明源编码前盲目更换编码参数或忽略错误。
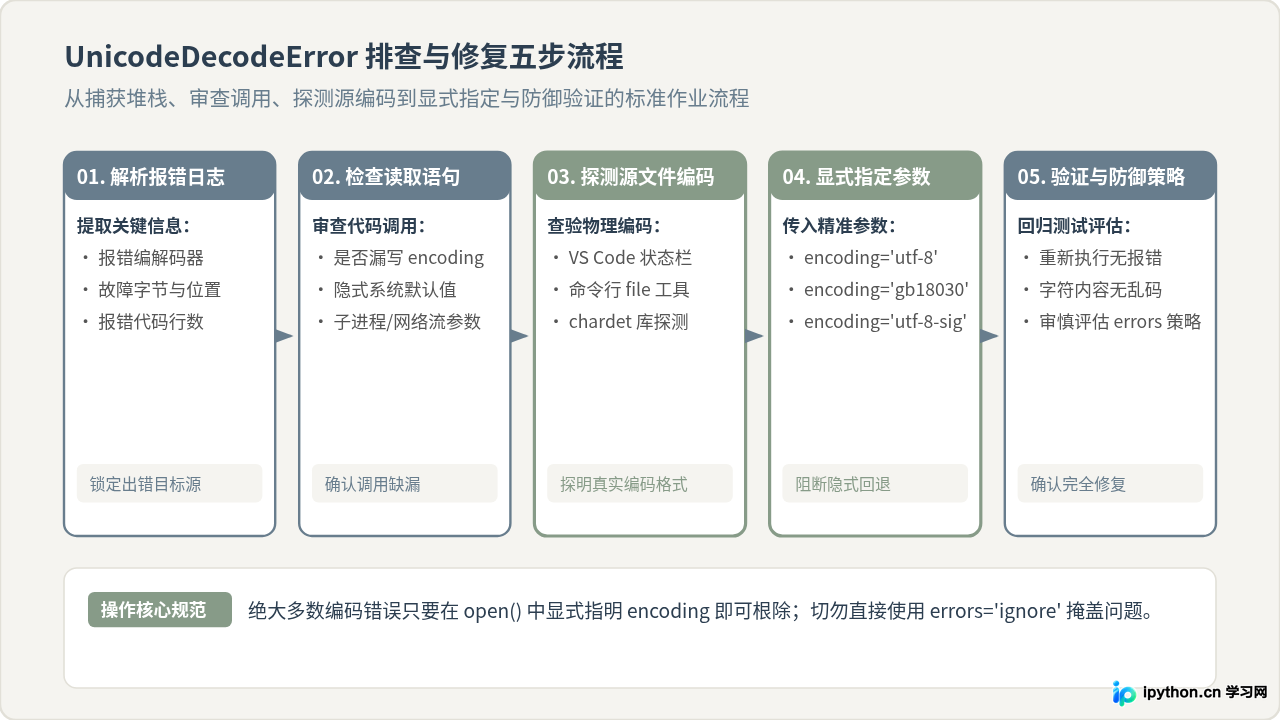
步骤一:提取报错堆栈中的关键信息
仔细查看错误回溯信息,记录出错的代码行、调用的具体函数(如 read()、readline() 或 json.load()),以及具体的编码名称和出错字节。
步骤二:审查数据读取调用语句
检查代码中打开该文件的语句。许多初学者习惯写出没有指定编码的简写代码:
# 存在隐患的写法:依赖操作系统默认编码
with open("data.txt", "r") as f:
    text = f.read()
当省略 encoding 参数时,Python 3 会调用内置的 locale.getpreferredencoding(False) 来决定解码方式。在 Linux 和 macOS 环境下,该函数默认返回 'UTF-8';而在中文 Windows 系统下,它默认返回 'cp936'(即 GBK)。这种依赖环境的隐式行为是跨平台脚本频频出现编码崩溃的主因。
步骤三:查明目标文件的物理存储编码
如果无法确定外部文件的编码格式,可以通过以下三种方法进行核验:
- 现代文本编辑器查看:使用 VS Code、Sublime Text 或 Notepad++ 打开该文件,观察右下角状态栏显示的编码标记(如 UTF-8、GBK 或 UTF-8 with BOM)。
- 系统终端命令检测:在 macOS 或 Linux 终端中运行
file -I data.txt,系统将输出 MIME 格式与字符集(例如text/plain; charset=utf-8或charset=iso-8859-1)。 - 使用 Python 探测库 chardet:当文件来源多样或属于动态上传时,可以使用
chardet读取部分二进制内容做概率分析:
import chardet

with open("data.txt", "rb") as f:
    raw_content = f.read(2048)  # 仅读取前 2048 个字节用于检测
    detected = chardet.detect(raw_content)
    print("探测到的编码:", detected["encoding"], "置信度:", detected["confidence"])
步骤四:显式传入 encoding 参数进行修复
明确真实编码后,在代码调用处显式声明参数。常见的标准修复写法如下:
# 目标文件为 UTF-8 时
with open("data.txt", "r", encoding="utf-8") as f:
    text = f.read()

# 目标文件为简体中文 Windows 导出的 GBK/GB2312 文本时
# 推荐使用 gb18030,它是 GBK 的国家超集,能容纳更多汉字及符号
with open("data.txt", "r", encoding="gb18030") as f:
    text = f.read()
步骤五:重新运行并验证内容完整性
修改完成后重新运行脚本,观察控制台输出或后续数据处理步骤。确认程序不再报错,并核对读取出的中文字符、特殊符号无乱码、截断或丢失。
三、两种处理方案的关键差异对比
在实际开发中,面对编码错误,部分开发者可能会选择配置 errors='ignore' 或 errors='replace' 来跳过报错。为了帮助读者清晰判断两者的差异,我们在完全一致的输入条件下对这两种方案进行对比。
实验基准条件:存在一个实际保存格式为 GBK 编码的文本文件 notice.txt,内容为中文字符串“系统更新”。其底层存储的十六进制字节为:0xCF 0xB5 0xCD 0xB3 0xB8 0xFC 0xD0 0xC2(共 8 个字节)。
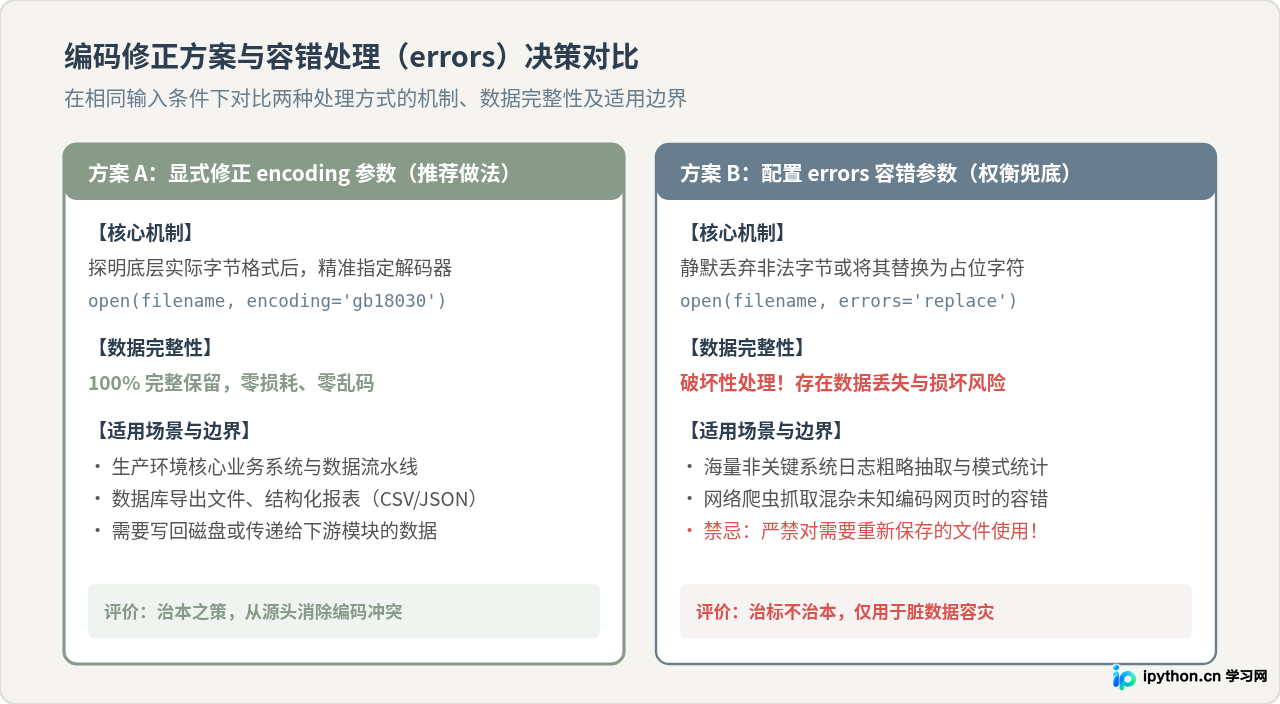
方案 A:显式指定真实编码(如 encoding='gb18030')
with open("notice.txt", "r", encoding="gb18030") as f:
    text = f.read()
print(text)       # 准确输出:"系统更新"
print(len(text))  # 输出字符长度:4
这种做法直接满足了解码器的规则要求,所有字节被准确映射为 Unicode 码点。数据保持 100% 完整,后续无论是做分词、入库还是写入新文件,都不会引入任何脏数据。
方案 B:错误使用 errors 容错模式(如 errors='ignore' 或 'replace')
# 尝试通过 ignore 压制 UTF-8 解码异常
with open("notice.txt", "r", encoding="utf-8", errors="ignore") as f:
    text = f.read()
print(text)       # 输出为空白字符串:""!所有中文字符全部被静默丢弃!

# 尝试通过 replace 替换非法字节
with open("notice.txt", "r", encoding="utf-8", errors="replace") as f:
    text = f.read()
print(text)       # 输出乱码:""(8个 Unicode 替换字符 U+FFFD)
从上面的输出可以看出:
- 使用
errors='ignore'会直接将不符合 UTF-8 规范的字节抛弃,导致业务数据凭空消失; - 使用
errors='replace'则会将无法解析的字节替换为占位符号;若该内容在后续逻辑中被存入数据库或写回磁盘,原始数据将遭受不可逆的永久破坏。
因此,在生产环境中,errors 只能用于网络爬虫清洗残缺文本、解析不可控的海量系统原始日志等非核心场景,绝对不能作为常规修复 UnicodeDecodeError 的首选方案。
四、四种高频特殊场景的应对方案
场景 1:UTF-8 文件首字符出现 \ufeff(BOM 头问题)
在 Windows 环境下使用记事本、早期 Excel 或某些工业软件导出的 CSV/TXT 时,系统常常会在文件开头自动添加 3 个字节的 BOM(Byte Order Mark,十六进制为 0xEF 0xBB 0xBF)。如果直接使用 encoding='utf-8' 读取,Python 会将这 3 个字节解码为 Unicode 零宽无间断空格 \ufeff,导致解析字典键或数值时失败:
# 出现 BOM 头问题的现象
import json

# 若文件以 BOM 开头,json.loads 或访问首列可能报错
# 解决方案:使用专用编解码器 'utf-8-sig'
with open("config.json", "r", encoding="utf-8-sig") as f:
    data = json.load(f)  # Python 自动检测并剥离 BOM 头,正常解析
场景 2:控制台标准输出或重定向引发异常
在 Windows 命令提示符(CMD)或 PowerShell 中执行脚本时,有时打印包含特殊字符的文本会触发 UnicodeEncodeError 或通过管道读取时触发解码失败。这是因为标准输入输出流继承了控制台代码页(通常为 CP936)。
解决方案:在脚本初始化阶段重新配置输出流,或者配置环境变量:
import sys

# Python 3.7+ 推荐写法:动态重设标准输出流编码
if sys.stdout.encoding.lower() != "utf-8":
    sys.stdout.reconfigure(encoding="utf-8")
也可以在运行脚本前通过终端临时声明环境变量:
# Linux / macOS 终端
export PYTHONIOENCODING=utf-8

# Windows CMD 终端
set PYTHONIOENCODING=utf-8
场景 3:调用 subprocess 执行系统命令时的输出解码
通过 subprocess.check_output() 或 subprocess.Popen() 与系统子进程交互时,外部进程输出的是原始字节流。若直接使用 text=True 而未声明编码,在 Windows 上也会因为系统默认代码页不匹配而崩溃:
import subprocess

# 推荐写法:明确为子进程流指定平台终端对应的编码
proc = subprocess.run(
    ["ping", "127.0.0.1"],
    capture_output=True,
    text=True,
    encoding="gbk",  # Windows 系统命令回显大多采用 GBK
    errors="replace" # 避免系统输出生僻字符导致主程序退出
)
print(proc.stdout)
场景 4:将二进制文件误作为文本文件读取
当尝试读取图片(PNG/JPG)、PDF、ZIP 压缩包或 Word/Excel 二进制格式(.docx/.xlsx 实际上是 zip 容器)时,如果误用了文本模式 'r',解码器遇到二进制压缩头就会抛出 UnicodeDecodeError。
解决方案:明确文件类型,对于非纯文本格式,必须使用二进制模式 'rb' 打开:
# 读取图片或二进制数据流
with open("picture.png", "rb") as f:
    binary_bytes = f.read()  # 读取到的是 bytes 对象,不进行文本解码
五、工程编码规范与预防速查
为彻底阻断跨平台开发中的字符编码隐患,建议在工程团队中推广“Unicode 三明治”模型,并遵循统一的代码规范。
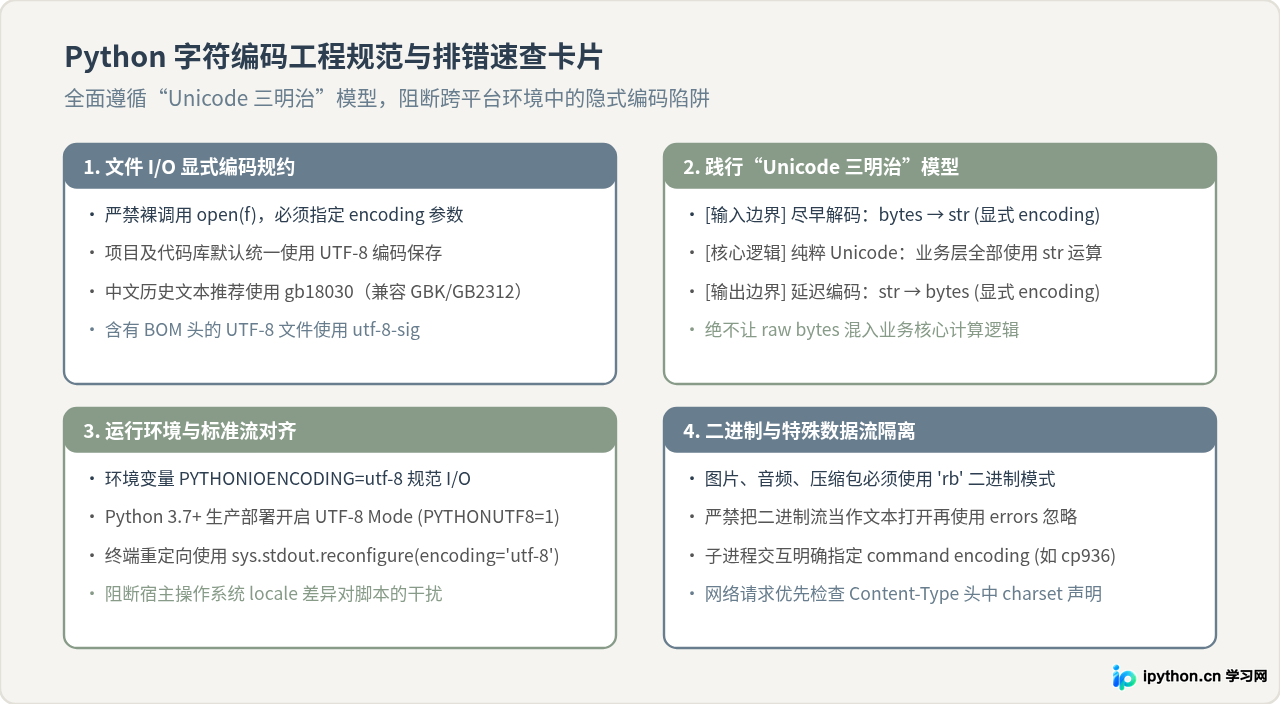
常见文本编码场景及推荐参数速查表
| 数据源类型 | 典型保存格式 | 推荐 open() 参数 | 主要注意事项 |
|---|---|---|---|
| 跨平台现代项目源码与文档 | UTF-8 (无 BOM) | encoding="utf-8" |
国际通用标准,团队开发应强制默认统一 |
| Windows 记事本 / 导出的 CSV | UTF-8 (带 BOM) | encoding="utf-8-sig" |
自动剔除首字节 \ufeff,防止解析异常 |
| Windows 历史中文软件数据 / Excel 导出 | GBK / GB2312 / CP936 | encoding="gb18030" |
使用 gb18030 完全兼容生僻汉字与扩展符号 |
| 多语种欧陆文本数据源 | ISO-8859-1 / Latin-1 | encoding="latin-1" |
单字节编码,每个字节均映射有效码点 |
| 图片 / 音视频 / 压缩包 | 纯二进制格式 | mode="rb" |
禁止传入 encoding,保持 raw bytes 流传输 |
总结而言,遇到 UnicodeDecodeError 时,应明确其是由于“输入字节流”与“指定解码规则”失配所致。只要按照“查清源编码、显式补齐 encoding 参数、验证数据完整性”的标准流程操作,就能从根本上解决编码错误,保障 Python 脚本在不同操作系统间的稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









