

Python缩进错误和编码问题怎么解决

encoding='utf-8'、内外部边界严格进行 str 与 bytes 转换”三项准则便能从容化解。
一、Python 缩进错误的排查与修复方法
与使用大括号 {} 划定代码作用域的语言不同,Python 依靠每一行开头的空白字符深度来组织代码层级。这种机制让代码显得规整,但也意味着多一个空格或混用一个制表符就会导致语法解析中断。缩进错误主要由 Python 解释器的词法分析器抛出,通常在代码尚未执行前就已发生。
1. 常见缩进报错形态与诱因
在编写或修改代码时,常见的缩进错误通常体现为以下三种明确的异常:
IndentationError: unexpected indent(意外缩进):某一行代码的前面出现了本不该有的空格。例如在模块顶层语句前敲了空格,或者两行平级语句中第二行多缩进了一两个空格。IndentationError: expected an indented block(缺少缩进块):当出现if、for、def、class、try、with等复合语句引导的冒号:后,下一行必须进入更深一层的缩进;如果下一行未缩进或只写了空注释,解释器便会抛出此错误。TabError: inconsistent use of tabs and spaces in indentation(制表符与空格混用):代码中部分行使用了 Tab 键缩进,而另一部分行使用了空格。在某些编辑器中 Tab 显示为 4 个字符宽,肉眼看似整齐对齐,但 Python 解释器在严格解析字节时发现字符不同,直接判定为语法错误。
2. 缩进错误的现场定位与修复步骤
遇到缩进错误时,不要盲目逐行按退格键尝试,建议按如下四个标准步骤排查:
- 锁定终端报错行号:Python 终端输出的 Traceback 末行会标出出错的文件名和具体行号,并在上方用小箭头
^指向发生异常的具体字符。 - 检查上下文结构:如果报错提示
expected an indented block,检查上一行是否遗留了未完成的if/else逻辑;若该代码块暂时为空,应先填入pass占位语句。 - 开启编辑器不可见字符显示:在 VS Code、PyCharm 等编辑器中开启“显示空格与制表符”(Render Whitespace),制表符会显示为箭头(
➔),空格显示为小圆点(·),混用情况一目了然。 - 批量转换制表符为 4 空格:绝大多数现代编辑器都提供“Convert Indentation to Spaces”(将缩进转换为对应空格)功能,一键将历史代码中的制表符统一转为 4 个空格。
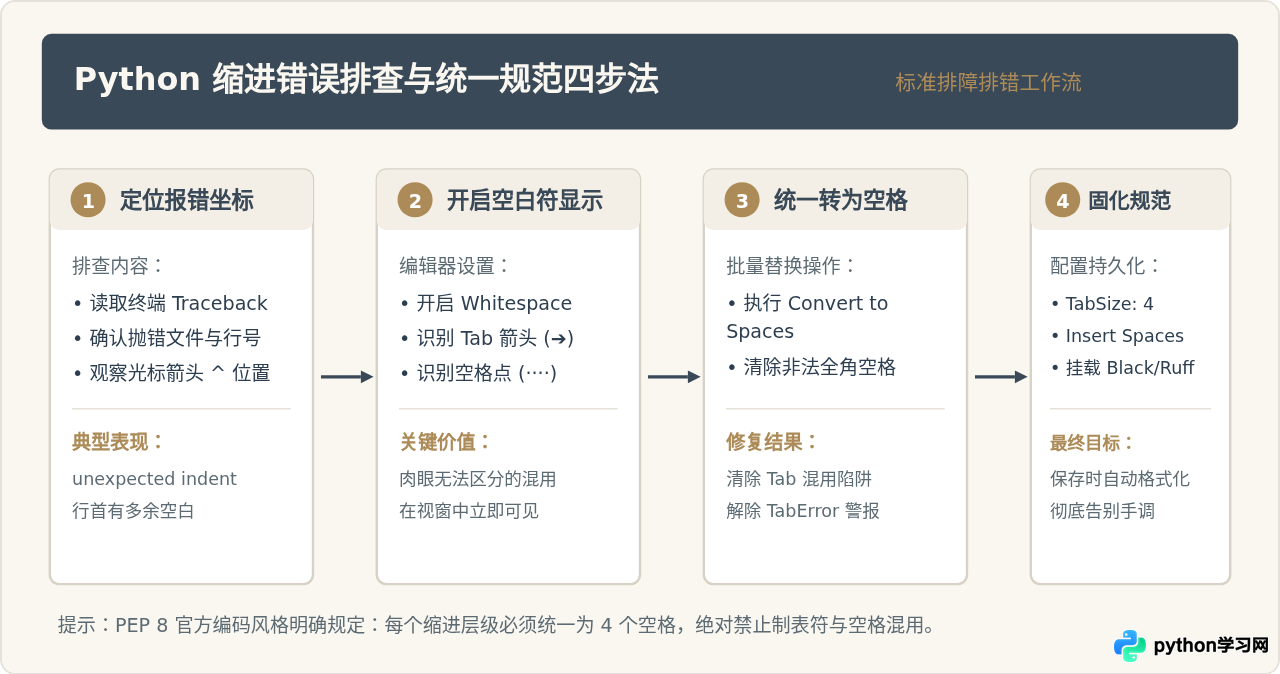
以一段包含缩进错误的典型代码为例:
# 错误示例:混合缩进与缺少缩进块
def calculate_discount(price, is_member):
    if price > 100:
	if is_member:          # 此处使用了 Tab(制表符)
        return price * 0.8 # 此处使用了 8 个空格,触发 TabError
    else:
                           # 冒号后未书写任何有效语句,触发 IndentationError
print("Done")              # 缺少缩进块直接衔接外部语句
对上述问题代码进行规范重构后的正确写法:
# 正确示例:严格统一使用 4 个空格,结构完整
def calculate_discount(price, is_member):
    if price > 100:
        if is_member:
            return price * 0.8
        return price * 0.9
    else:
        pass  # 暂无其他处理时使用 pass 显式占位,保证语法块成立

print("Done")
二、Python 编码问题的成因与排查解决
在 Python 3 中,所有字符串(str)在解释器内存中均以 Unicode 码位表示。然而,当这些字符需要持久化写入磁盘、通过网络套接字发送,或在终端输出时,必须被编码(Encode)为由二进制字节组成的 bytes 对象。反之,读取外部数据时必须将 bytes 解码(Decode)为 str。编码问题本质上就是在这个转换过程中,编码格式的不匹配或外部字符超出了目标编码表的表示范围。
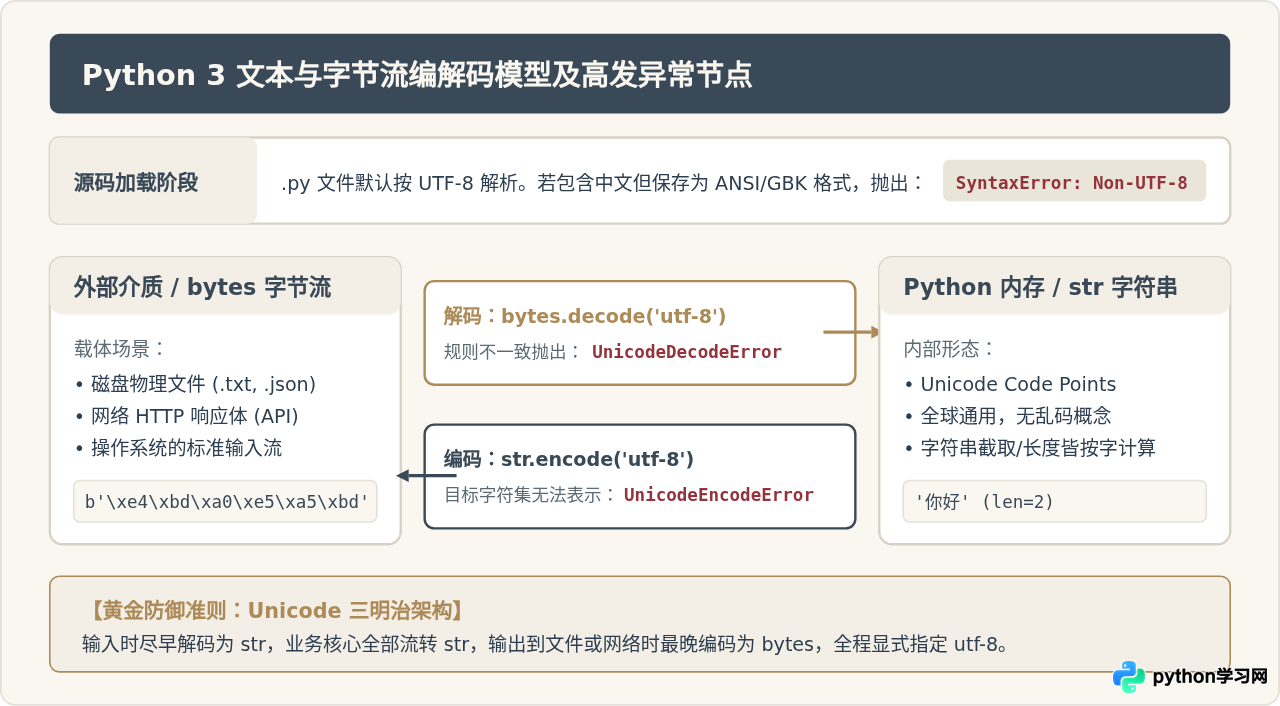
1. 源码文件本身的编码异常与解决
在 Python 3 中,解释器默认要求所有 .py 源代码文件使用 UTF-8 编码。当你在代码中编写了中文字符串、中文注释,而文本编辑器(例如 Windows 记事本或其他老旧编辑器)默认将文件保存为 GBK 或 ANSI 格式时,执行脚本会直接在第一行抛错:
SyntaxError: Non-UTF-8 code starting with '\xc4' in file test.py on line 1, but no encoding declared; see https://peps.python.org/pep-0263/ for details修复方案有两种:
- 方案 A(现代通用):在编辑器底部状态栏将文件编码格式切换为 UTF-8 并重新保存文件。这是现代 Python 项目的强制标准。
- 方案 B(兼容旧系统):若受限于环境必须保留 GBK 编码,则必须在脚本的最上方第一行(或第二行)加入 PEP 263 规范的编码魔术声明:
# -*- coding: utf-8 -*-
# 或者声明为:# -*- coding: gbk -*-
2. 文件读写时的 UnicodeDecodeError / UnicodeEncodeError
这是开发中最常遇到的运行时异常。核心诱因是:在调用内置函数 open() 时,如果未传入 encoding 参数,Python 会自动采用操作系统的默认编码(locale.getpreferredencoding())。在中文 Windows 系统下,该默认编码往往是 cp936(即 GBK),而在 Linux/macOS 下通常是 utf-8。这种隐式机制是导致“本地运行正常、服务器部署报错”的头号杀手。
# 危险写法:依赖环境隐式编码,跨平台易崩溃
with open("data.txt", "r") as f:
    content = f.read()
# 当 data.txt 是 UTF-8 格式但在 Windows 下执行时,常抛出:
# UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position ...: illegal multibyte sequence

# 标准写法:永远显式传参指定 UTF-8
with open("data.txt", "r", encoding="utf-8") as f:
    content = f.read()

# 写入时同理:
with open("result.txt", "w", encoding="utf-8") as f:
    f.write("输出中文内容")
3. 容错策略与不可控字节流处理
当读取第三方爬虫抓取的数据、破损日志或网络流时,字节流中偶尔会夹杂个别非法的损坏字节。如果直接解码会导致整个任务中断。此时可以通过 open() 或 bytes.decode() 的 errors 参数设置安全的容错策略:
errors="strict":默认行为,遇到非法字节立刻抛出UnicodeDecodeError。errors="ignore":直接丢弃无法解码的非法字节(慎用,可能丢失关键字符)。errors="replace":推荐做法。将无法解析的非法字节替换为 Unicode 替代字符,既保留了上下文的完整性,又避免了程序奔溃。
# 安全解码不可控的字节流
raw_bytes = b"\xe4\xbd\xa0\xff\xe5\xa5\xbd" # 中间含有一个非法损坏字节 0xff
safe_text = raw_bytes.decode("utf-8", errors="replace")
print(safe_text)  # 输出:你好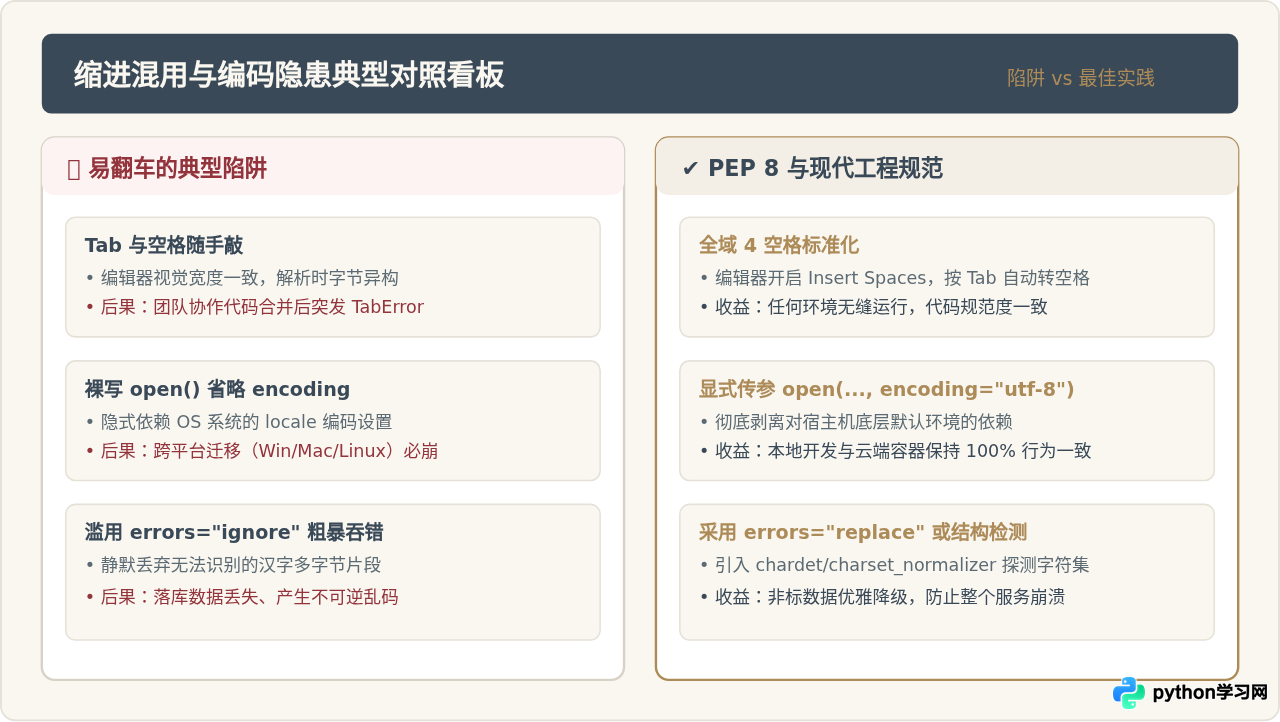
三、开发环境与工程化防御配置
要彻底避免缩进与编码错误,单纯依赖开发者的手工检查是不可靠的。工业级工程的最佳实践是在 IDE 编辑器、版本控制以及自动化工具链上设置多层防御网。
1. VS Code 与 PyCharm 核心配置项
| 配置目标 | VS Code 配置项 (settings.json) | PyCharm 菜单路径 |
|---|---|---|
| 缩进大小与格式 | "editor.tabSize": 4"editor.insertSpaces": true |
Settings > Editor > Code Style > Python > Tabs and Indents (Tab size: 4, Use spaces) |
| 空白符高亮可见 | "editor.renderWhitespace": "all" |
Settings > Editor > General > Appearance > Show whitespaces (勾选) |
| 全局文件编码 | "files.encoding": "utf8" |
Settings > Editor > File Encodings > Global / Project Encoding 均设为 UTF-8 |
| 保存时自动格式化 | "editor.formatOnSave": true |
Settings > Tools > Actions on Save > Reformat code (勾选) |
2. 工具链静态扫描与格式化
在项目中引入自动化格式化工具可以一键扫除历史代码的所有缩进与编码隐患:
- Ruff / Flake8:通过执行
ruff check .可以立即检查出代码中的全角字符、非法缩进、未闭合编码等问题。 - Black:被称为“不妥协的 Python 代码格式化工具”。运行
black file.py会自动将代码中所有的混用制表符强制替换为符合 PEP 8 规范的 4 个空格,并重新对齐多层嵌套逻辑。 - 检测未知文件编码:当必须处理未知来源的文本文件且无法确定编码时,切忌瞎猜。可以使用 Python 第三方库
charset-normalizer进行高精度检测:
from charset_normalizer import from_bytes

with open("unknown_data.bin", "rb") as f:
    raw_content = f.read()

# 自动推断最匹配的编码格式
match_result = from_bytes(raw_content).best()
if match_result:
    print(f"推断文件编码为: {match_result.encoding}")
    text = match_result.output()
    print(text)
四、常见问题速查与排障总结
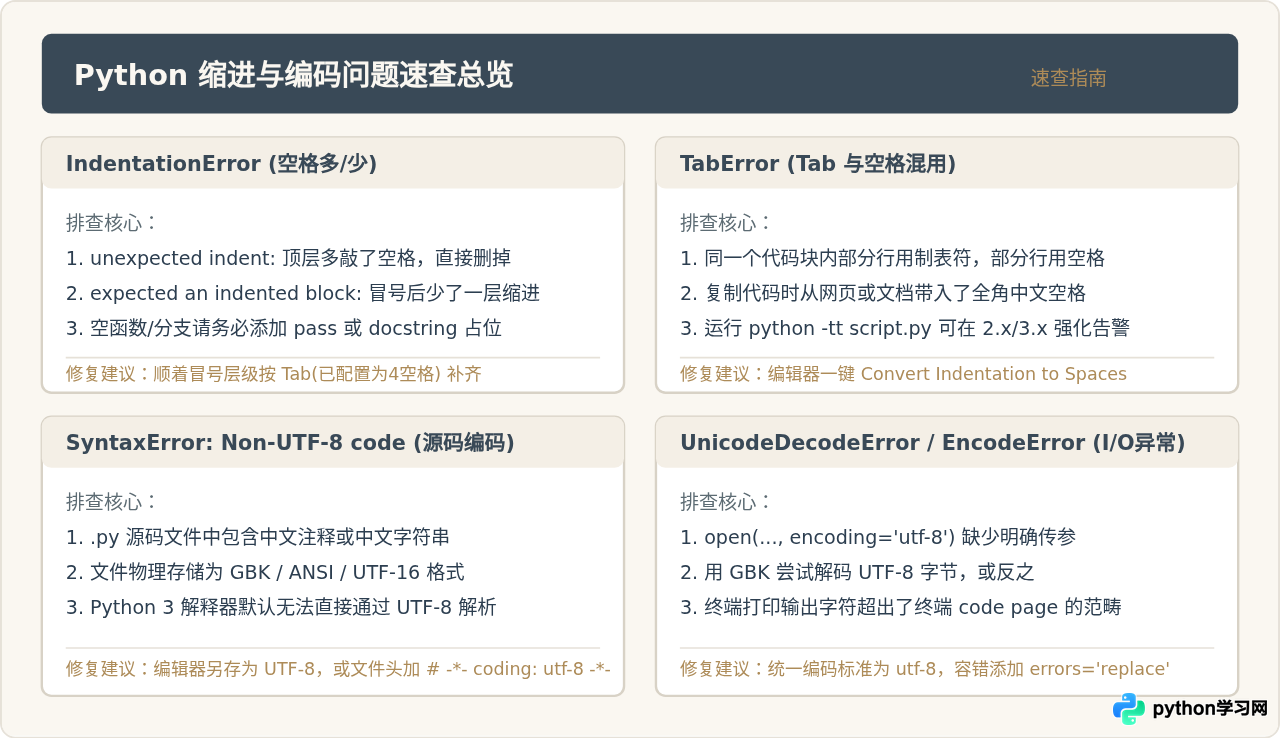
防错总结清单:
- 拒绝纯手工排版:将编辑器默认 Tab 行为锁死为 4 个空格,开启保存时自动格式化。
- 显式优于隐式:每次使用
open()读写文本时,务必将encoding="utf-8"显式写入参数,彻底切断对底层环境编码的盲目依赖。 - 划清字符与字节界限:外部接收数据第一步
.decode("utf-8")为文本;输出或落盘最后一步.encode("utf-8")为字节。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









