

python类型注解和静态语言类型区别
深入解析Python类型注解与静态语言类型的本质区别。从运行机制、静态分析、内存布局到实际工程落地与认知误区剖析,帮助开发者真正理解动态语言类型提示与编译期类型契约的差异。
一、执行时机与生命周期的本质差异
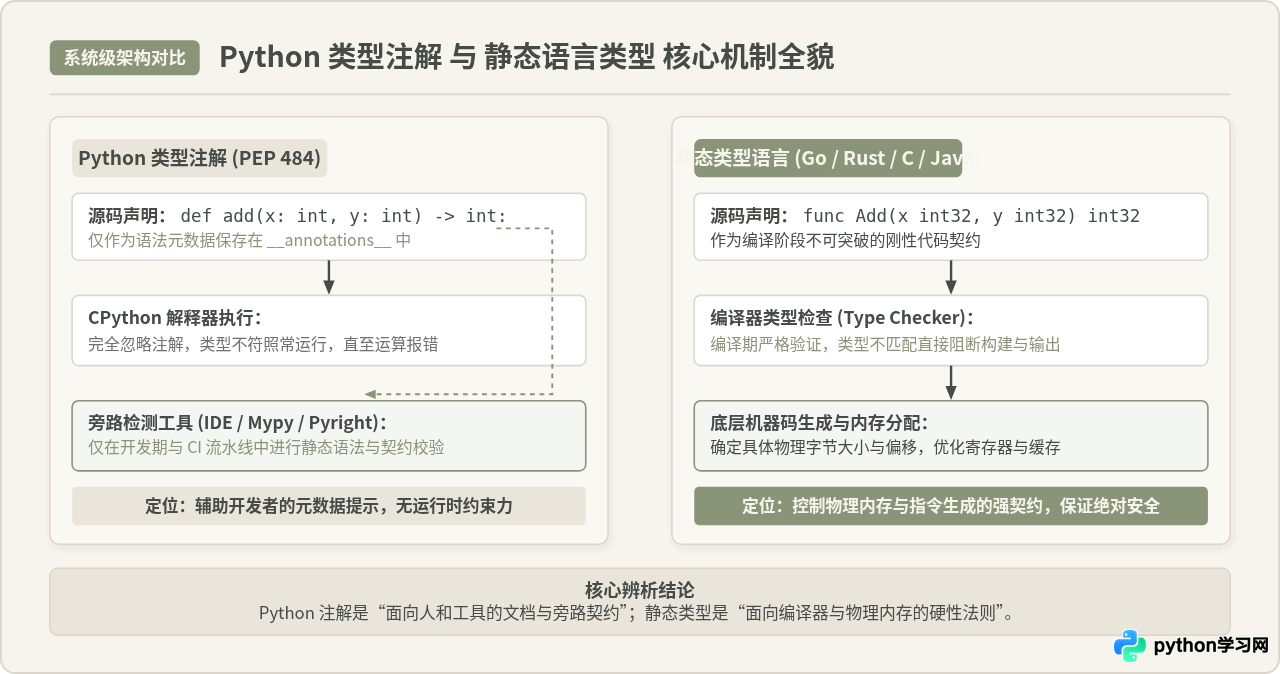
理解二者区别的第一步,是看类型信息在代码生命周期的哪个环节生效。很多初学者在 Python 中写下带有类型的函数声明时,常以为它获得了与 C 或 Go 相同的防护能力,但两者的运行底层有着根本不同。
1. 静态语言:编译期不可逾越的硬性门禁
在静态语言中,类型检查是编译管道中绝对不可绕过的步骤。以 Go 语言为例,如果在函数调用中传入了不匹配的类型,代码在构建阶段就会直接失败,根本无法生成任何二进制可执行文件:
package main

import "fmt"

func CalculateTotal(price int32, count int32) int32 {
    return price * count
}

func main() {
    // 编译错误:类型不匹配,无法将字符串隐式转为 int32
    CalculateTotal("100", 2)
}
执行编译命令后,编译器立刻终止并输出错误:
$ go build main.go
./main.go:10:20: cannot use "100" (untyped string constant) as int32 value in argument to CalculateTotal
2. Python:运行期完全忽略注解的动态执行
再看 Python。Python 自 3.5 版本引入 PEP 484 类型注解后,允许开发者使用类似静态语言的语法标注类型。然而,CPython 解释器在语法解析后,仅将类型注解存入函数的 __annotations__ 字典属性中,在实际生成字节码和执行时会将其全部忽略:
def calculate_total(price: int, count: int) -> int:
    return price * count

# 错误入参:传入字符串 "100",但 Python 不会抛出类型错误,而是触发字符串重复运算!
result = calculate_total("100", 2)
print("计算结果:", repr(result))  # 输出: '100100'

# 查看底层存储的元数据
print("函数注解元数据:", calculate_total.__annotations__)
$ python3 demo.py
计算结果: '100100'
函数注解元数据: {'price': <class 'int'>, 'count': <class 'int'>, 'return': <class 'int'>}
从上述输出可以看到两点关键事实:第一,传入与注解完全相反的参数,Python 解释器没有任何告警或报错,而是按照 Python 动态对象的运算规则执行了乘法重载;第二,类型注解并未消失,它以字典形式挂载在对象属性上,专门供外部反思(Reflection)与静态分析工具读取。
二、内存模型与执行效率的物理鸿沟
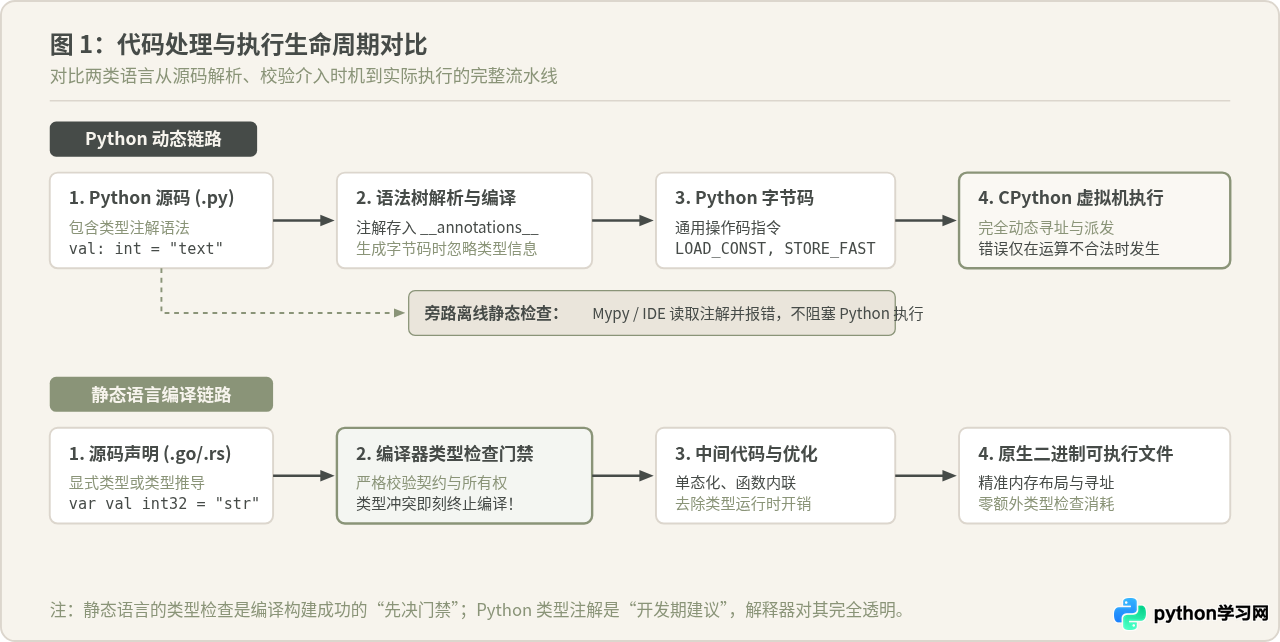
除了校验时机之外,另一个常被忽视的核心区别是物理内存的组织形态。在静态语言中,类型直接决定了计算机底层如何分配字节;而在 Python 中,无论是否声明类型,对象的物理结构都不会发生任何改变。
1. 静态语言的“原始内存与零额外开销”
在 C、Rust 或 Go 中,当声明一个 int32 局部变量时,编译器会在栈帧上直接规划出连续的 4 个字节,并将数值的二进制补码写入这片内存。
- 无包装头信息:没有对象头,没有类型指针,没有垃圾回收的引用计数元数据。
- 寄存器直传:CPU 可以直接将这 4 个字节读入运算寄存器(如 x86-64 的
%eax),执行单周期硬件加法指令。 - 缓存行友好:结构体和数组在内存中是连续紧密排列的,能够最大限度利用 CPU L1/L2 缓存。
2. Python 的“全装箱对象模型”
在 Python 中,所有东西都是对象(Everything is an Object)。当在 Python 中写下 a: int = 42 时,变量名 a 本身只是一个 8 字节的栈指针,它指向堆区动态分配的一个完整的 C 语言结构体 PyLongObject:
struct _longobject {
    PyObject_VAR_HEAD  // 包含 8 字节 ob_refcnt(引用计数) + 8 字节 *ob_type(类型指针) + 8 字节 ob_size
    digit ob_digit[1]; // 4 字节,实际存储数值
};
即使标注了 : int,一个最小的 Python 整数也固定消耗 28 个字节的堆内存。当两个整数相加时,Python 虚拟机必须先进行指针解引用,检查 ob_type 是否匹配,再调用类型对象绑定的加法函数,最后分配一个新的 PyLongObject 包装返回值。类型注解在此过程中无法减少哪怕 1 字节的装箱内存,也无法跳过任何动态派发步骤。
三、常见认知误区与针对性辨析
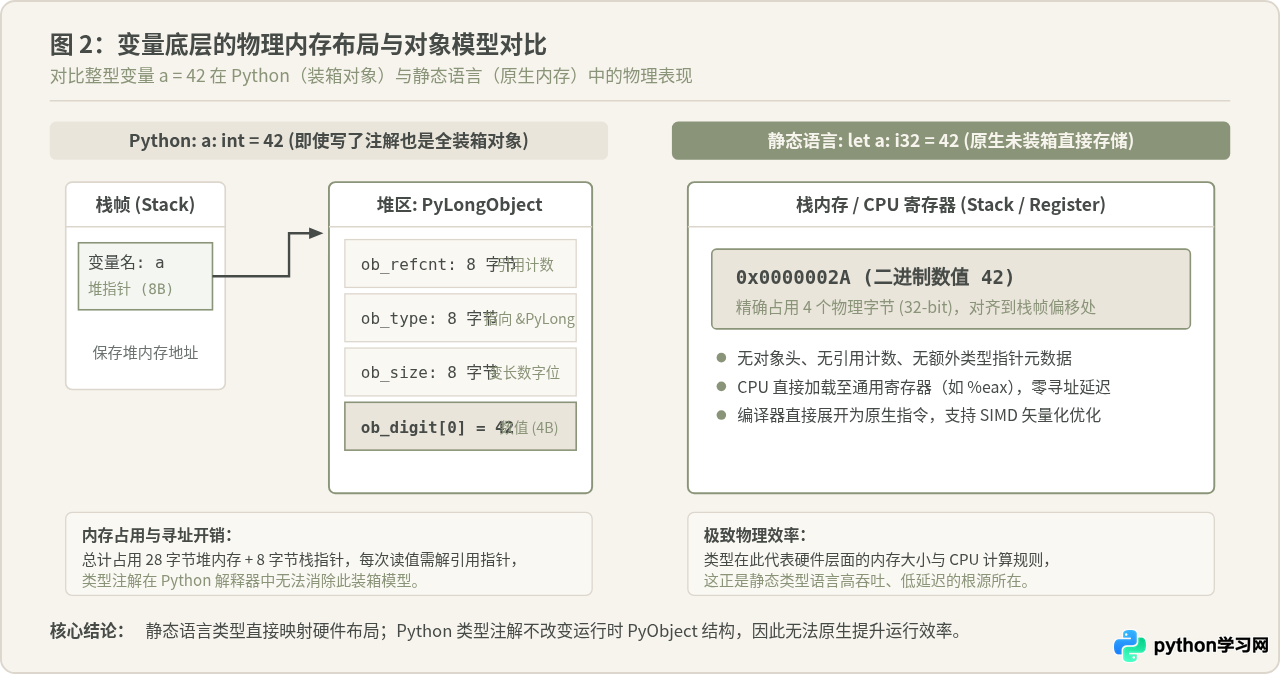
关于 Python 类型注解,在开发者社区中流传着几个看似合理、实则存在认知偏差的说法。理解这些说法的局限性,有助于更准确地在生产中落地类型体系。
为什么看似合理:代码看起来和 Java、TypeScript 甚至 C# 非常相似,都有变量后置或前置类型标注。
实际情况:Python 始终是动态强类型语言。在 Python 中,类型属于“运行时的对象”,而不属于“承载对象的变量名”。变量名只是一个标签,可以在运行时随时重新指向不同类型的对象(如先赋整数再赋字典)。类型注解是可选的语法糖与元数据,并没有从语法机制上改变 Python 动态绑定的核心本质。
为什么看似合理:在静态语言中,类型明确的代码执行效率极高,因此直觉上认为提供了类型就能帮助解释器加速。
实际情况与适用条件:在标准 CPython 官方解释器下,这种加速收益为 0%。因为 CPython 运行时完全丢弃类型信息走通用解释分支。
何种条件下才成立:只有当使用专门针对类型提示进行编译优化的非官方工具链时,该说法才成立。例如:
- Mypyc:将带有严格类型注解的 Python 代码编译为 CPython C 扩展模块,将动态查找替换为 C 原生指针和类型计算,通常可获得 2x ~ 5x 的性能提升。
- Cython:通过在代码中指定类型,生成 C 代码并调用 C 编译器,获得极致性能。
- 标准库与第三方库(如 Pydantic)可以读取
__annotations__来自动做数据反序列化与校验,但这是在 Python 层用代码主动调用的逻辑,并非 CPython 内部加速。
为什么看似合理:在静态编译语言中,只要编译通过,通常不会发生方法缺失或传参类型错误。
实际情况:在 Python 中,类型安全防线容易受到外部“动态污染”。例如通过 json.loads() 读取的网络请求返回的是任意字典,静态工具无法得知其运行时的确切字段类型;或者项目中混用了未标注类型的第三方库、过度使用 Any 类型时,类型检查器就会出现分析盲区,运行期依然可能抛出 AttributeError 或 KeyError。
四、在 Python 中获得接近静态语言的安全保障:实操流水线
虽然 Python 解释器不强制执行类型,但在工程实践中,我们可以通过建立一套现代化的“旁路静态工具链”,使大型 Python 项目获得与静态编译语言同等严格的质量防护。
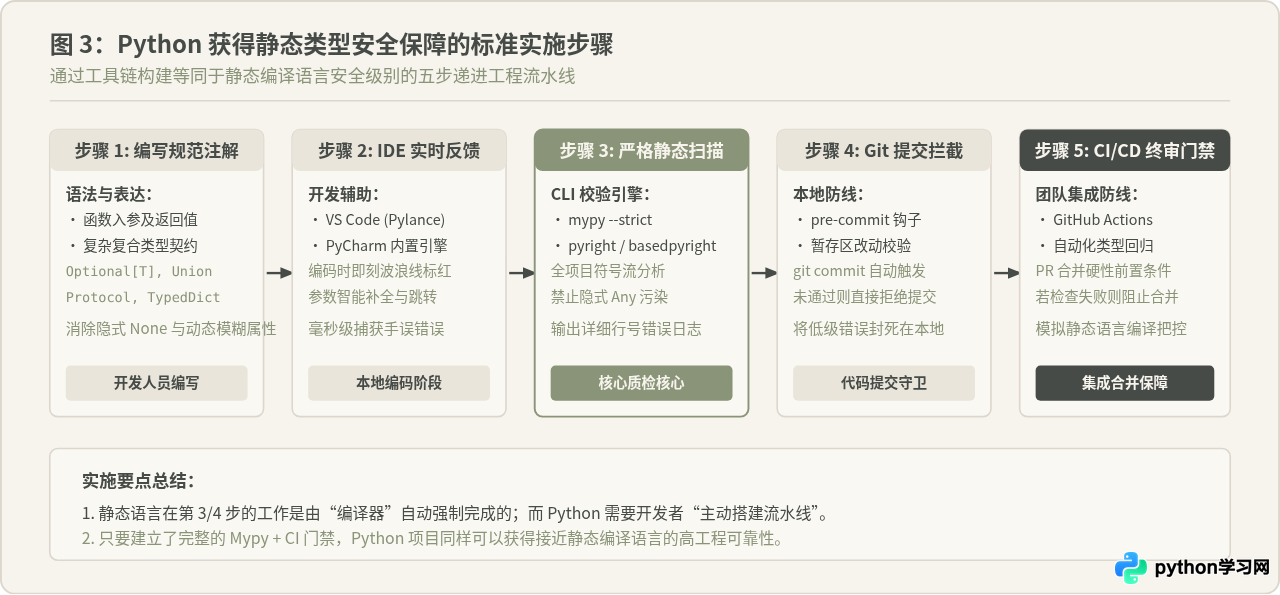
实操步骤一:规范化定义类型契约
使用 Python 标准库 typing 模块(Python 3.9+ 支持内置泛型语法,如 list[int]、dict[str, Any])。对于需要支持鸭子类型的场景,优先使用 Protocol 而非硬编码具体继承类:
from typing import Protocol, Optional

class Serializable(Protocol):
    def to_json(self) -> str: ...

def send_payload(target_url: str, data: Serializable, timeout: Optional[float] = 5.0) -> bool:
    payload = data.to_json()
    # 执行实际网络请求逻辑...
    return True
实操步骤二:配置 IDE 实时反馈
在 VS Code 中安装 Pylance 插件,并将类型检查模式调整为严格模式。在项目根目录 .vscode/settings.json 中写入:
{
  "python.analysis.typeCheckingMode": "strict",
  "python.analysis.diagnosticMode": "workspace"
}
实操步骤三:引入 Mypy 静态检测工具
安装行业标准的静态类型检查器 Mypy,并在命令行进行全项目扫描:
# 安装 mypy
pip install mypy

# 执行严苛类型检测
mypy --strict src/
如果在代码中存在潜在的类型错误,Mypy 会像静态语言编译器一样,精准指出文件名、行号及类型冲突原因:
src/service.py:12: error: Argument 2 to "send_payload" has incompatible type "dict[str, str]"; expected "Serializable"  [arg-type]
src/service.py:12: note: "dict[str, str]" lacks attribute "to_json"
Found 1 error in 1 file (checked 12 source files)
实操步骤四:配置 Git 提交拦截(pre-commit)
在项目根目录下配置 .pre-commit-config.yaml,确保开发者在本地执行 git commit 时,必须通过类型扫描,否则提交动作被自动终止:
repos:
  - repo: https://github.com/pre-commit/mirrors-mypy
    rev: 'v1.8.0'
    hooks:
      - id: mypy
        args: [--strict]
        additional_dependencies: [types-requests, types-PyYAML]
实操步骤五:CI/CD 终审流水线门禁
在 GitHub Actions 或 GitLab CI 中加入 Mypy 任务,作为 Pull Request 允许合并的必要前置条件。至此,虽然底层解释器仍是动态的,但整个工程流程已经具备了静态编译语言级别的安全屏障。
五、全维度对比总结与技术选型指南
为了帮助开发者在架构规划与语言选型时建立清晰边界,下表系统总结了 Python 类型注解与典型静态语言类型的全维度差异:
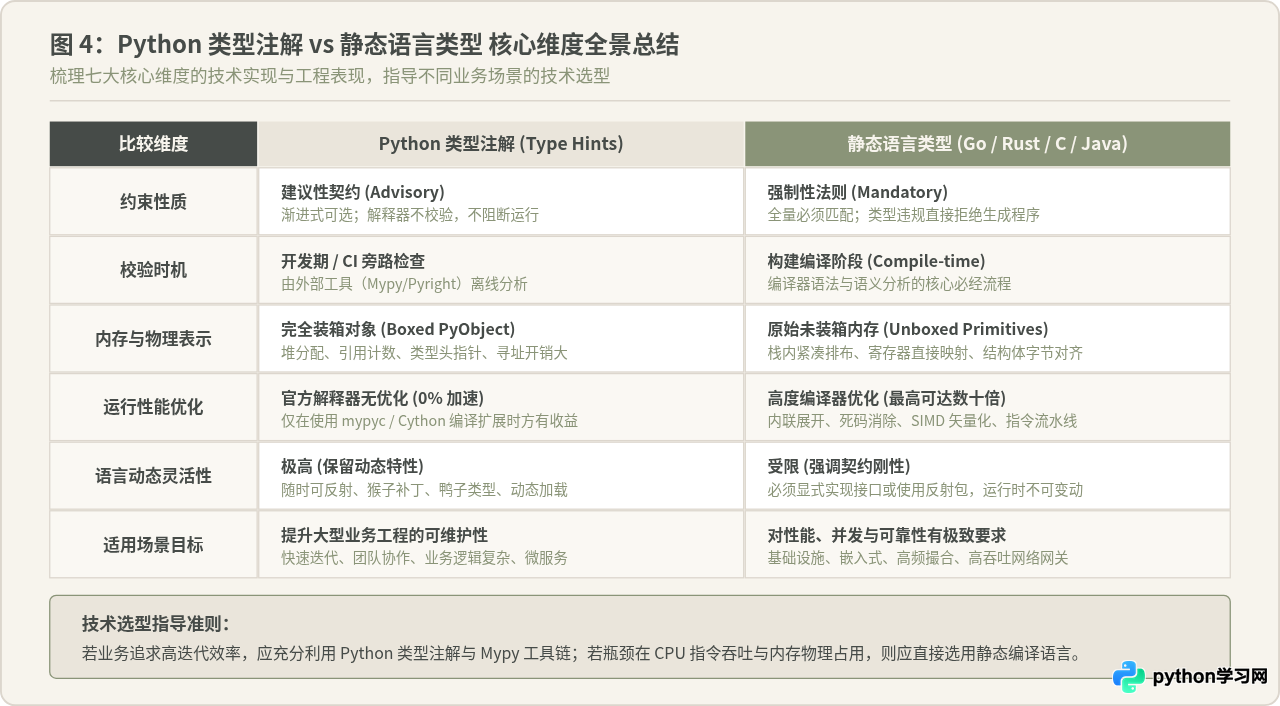
| 对比维度 | Python 类型注解 (PEP 484) | 静态编译语言 (Go / Rust / C / Java) |
|---|---|---|
| 核心本质 | 语法级元数据提示,用于工具分析与文档规范 | 硬件内存模型与编译期刚性契约 |
| 校验时机 | 离线旁路(IDE、Mypy、CI 脚本,需手动触发) | 构建编译时(编译器必须流程,不通过无法出包) |
| 运行时表现 | CPython 默认完全忽略,不阻断异常调用 | 完全执行已验证的机器指令,零类型误配运行 |
| 内存模型 | 始终是堆分配的装箱对象(每个整型 28 字节) | 未装箱原生物理存储(整型紧凑占用 4 字节) |
| 性能收益 | 原生解释器 0% 加速;仅在 Mypyc 下有提升 | 深度编译器优化(内联、寄存器优化、SIMD) |
| 动态灵活性 | 保留动态特性(热修补、鸭子类型、动态属性) | 类型系统严格受限,必须通过接口或反射实现 |
| 学习与迁移 | 渐进式引入,老项目可以逐步从无注解过渡 | 全量必须具备类型,语法前置学习成本较高 |
选型与使用建议
- 坚决拥抱 Python 类型注解的场景:中大型后端业务服务、团队协作项目、快速迭代的 SaaS 应用。在此类场景中,代码的可维护性、自解释能力和重构安全性是主要矛盾,通过“Python + 规范注解 + Mypy CI 门禁”,可以兼得动态语言的超高开发效率与静态语言的工程可控度。
- 必须转向静态编译语言的场景:底层存储引擎、高频撮合交易系统、音视频编解码、硬件资源严格受限的边缘计算设备。在这些场景中,性能瓶颈来自于 CPU 指令周期的消耗与内存碎片开销,必须依赖静态语言编译器生成的未装箱原生机器码来满足极端性能指标。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









