

pandas读取CSV中文乱码怎么办?encoding参数设置详解
针对使用 pandas 的 read_csv 函数读取中文 CSV 文件时常出现的 UnicodeDecodeError 报错及字符乱码问题,系统剖析底层编码成因,详解 encoding 参数配置方案,并提供从快速排查、自动探测到数据保存导出的完整实战流程。
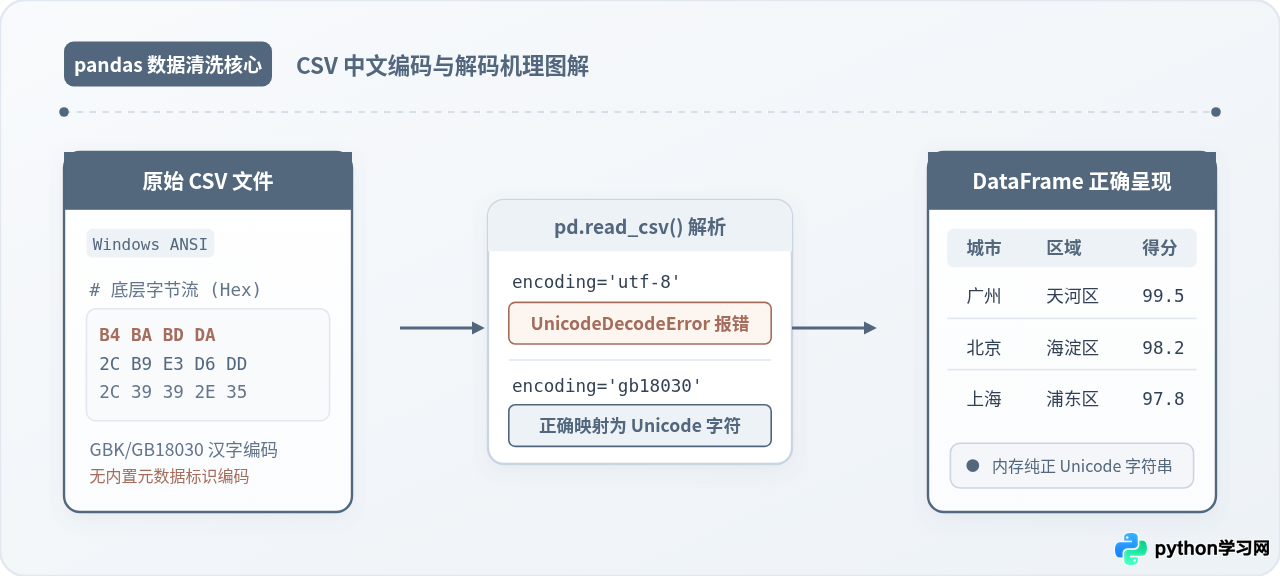
pd.read_csv() 读取带有中文字符的 CSV 文件时,最直接的表现通常是抛出 UnicodeDecodeError: 'utf-8' codec can't decode byte... 异常终止运行,或者能够读取成功但中文字符全部变成形如 文件 的乱码。这个问题的本质并非文件损坏,而是文件的物理存储编码与 pandas 默认采用的 utf-8 解码规则不一致。解决的核心是使用 encoding 参数明确指定匹配的字符集。绝大多数情况下,使用 encoding='gb18030'(针对 Windows ANSI 格式)或 encoding='utf-8-sig'(针对 Excel 导出的带 BOM UTF-8)即可直接解决;对于特殊场景,配合字节探测工具 chardet 与容错参数能彻底杜绝乱码。
一、乱码与解码报错的根源
要解决乱码,首先需要厘清计算机如何存储和读取文本。CSV 本质上是纯文本文件,其在磁盘中仅保存为一长串二进制字节流(十六进制表示如 0xB4 0xBA)。与部分富文本格式不同,标准 CSV 文件的文件头中并没有预留固定字段用于声明“本文件采用了哪种编码”。
当使用 pandas.read_csv() 加载数据时,程序内部调用 C 语言或 Python 的文本解析引擎。在没有显式传递 encoding 参数的情况下,pandas 会默认采用系统标准的 utf-8 规范尝试将字节翻译为字符。如果该 CSV 文件是由中文版 Windows 系统的 Excel 直接“另存为”生成的,或者源自旧版企业 ERP、财务软件,其默认采用的往往是微软中文环境下的 ANSI 编码(即 GBK 或 GB2312)。
这两种编码规则在多字节序列的设计上有根本差异:
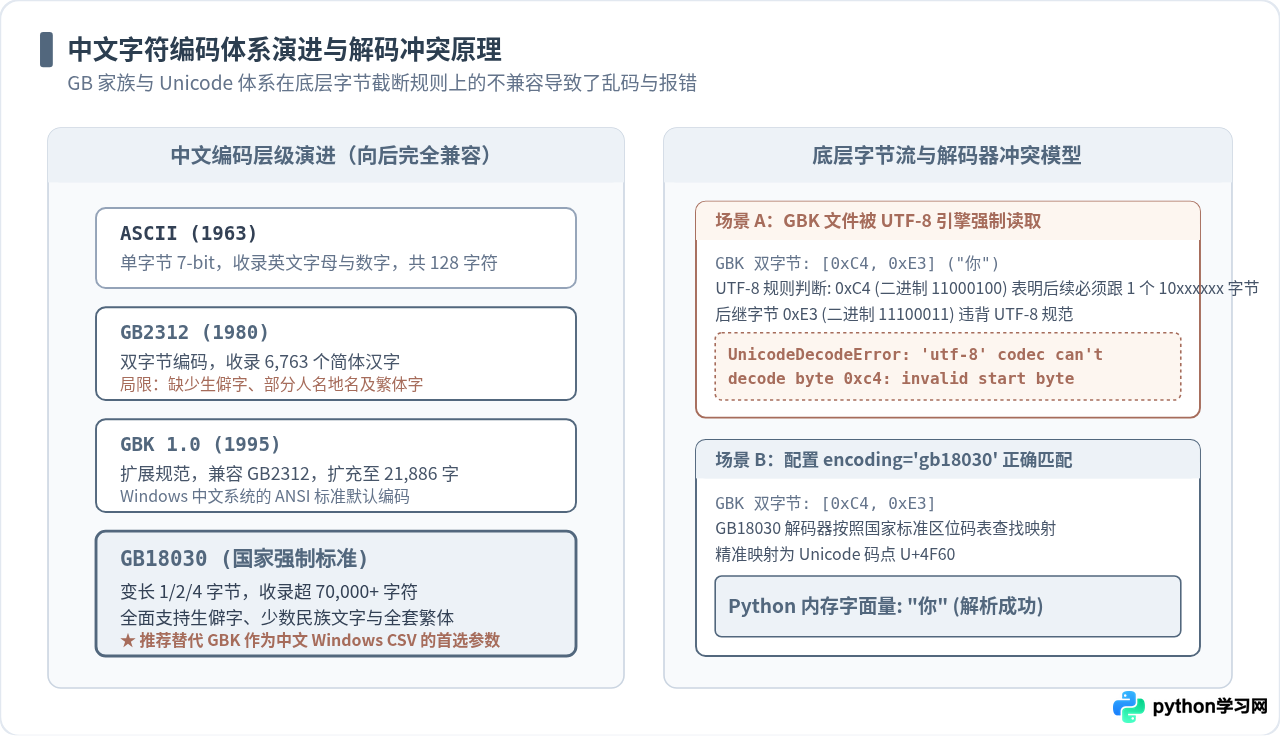
- UTF-8 规则:采用可变长编码(1 至 4 字节)。中文字符在 UTF-8 中通常占用 3 个字节,且首字节的前三位有严格的二进制特征(如
1110xxxx),紧随其后的字节必须以10xxxxxx开头。 - GBK / GB18030 规则:汉字使用双字节或四字节存储。其首字节最高位通常为 1(数值大于 127),但第二个字节的取值范围与 UTF-8 的后续字节规则冲突。
当 UTF-8 解码器读到 GBK 的第一个字节时,它会按照 UTF-8 的模板去期待后续字节;一旦后续字节不符合该模板,解码器就会立刻判定该处存在非法字节,抛出 UnicodeDecodeError 并中断程序。
二、常用 encoding 参数对比与选用考量
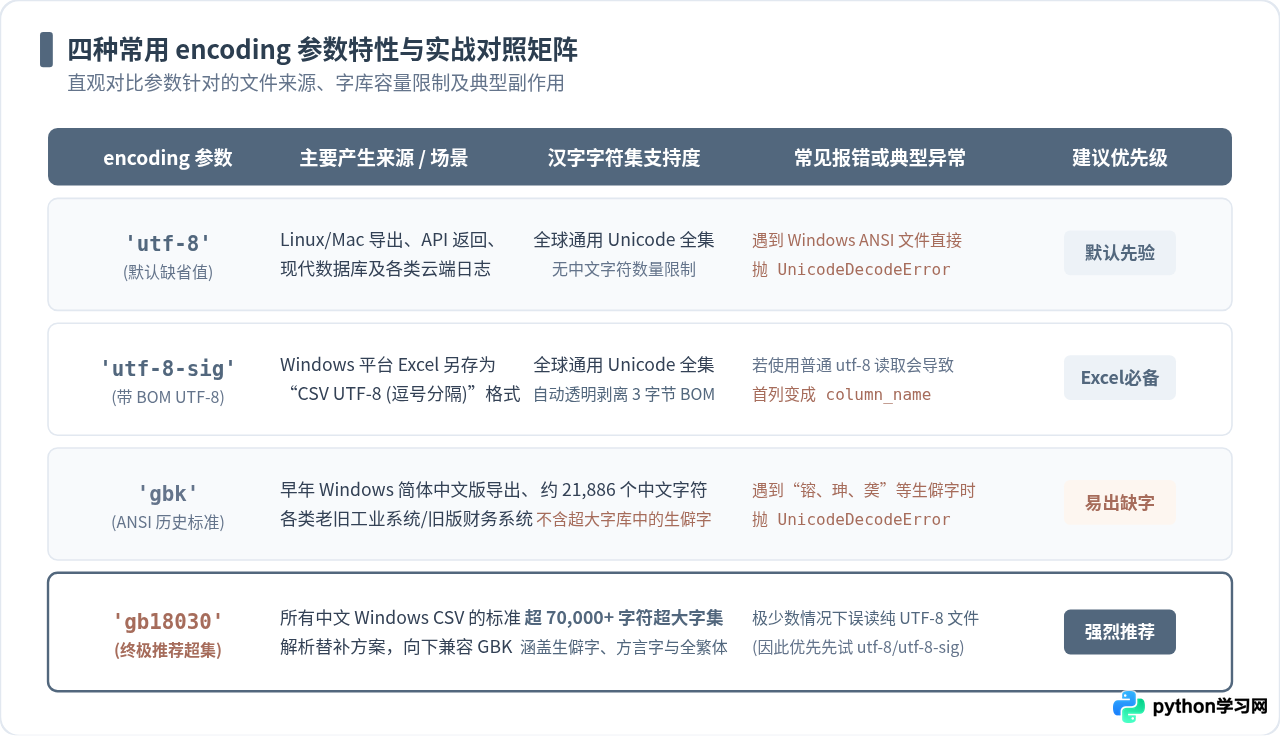
在调用 pd.read_csv() 时,encoding 参数接收一个表示字符集名称的字符串。针对中文处理,最常涉及的参数主要有四个:utf-8、utf-8-sig、gbk 和 gb18030。
1. encoding='utf-8'
这是 pandas 的默认缺省参数。适用于 Linux 服务器日志、开源数据集平台(如 Kaggle)、现代 Web API 导出的数据。如果确定文件本身是以无 BOM 的标准 UTF-8 编码保存的,无需额外设置该参数。但在面对 Windows 本地生成的文件时,使用该参数极易触发报错。
2. encoding='utf-8-sig'
这是排查 Excel 导出文件的利器。在 Windows 环境下,通过 Excel 将表格保存为“CSV UTF-8(逗号分隔)”时,Excel 会在文件最开头的 3 个字节写入一个被称为 BOM(Byte Order Mark,字节顺序标记,十六进制为 0xEF 0xBB 0xBF)的标识符。
如果直接使用默认的 utf-8 读取带 BOM 的文件,虽然正文不会报错,但该 BOM 会被原封不动地解析成不可见的 Unicode 字符 ,并拼接到第一列的列名最前面。例如原本的列名是 id,在代码中就会变成 id,导致 df['id'] 访问时抛出 KeyError。而传递 encoding='utf-8-sig' 时,解码器会自动识别并在内存中剔除该标记,保持列名干净。
3. encoding='gbk' 与 encoding='gb18030' 的关键区别
许多开发者在遇到报错时第一反应是传入 encoding='gbk'。在多数只有常用字的数据中,这确实能恢复正常显示。然而,在真实业务数据中,gbk 存在明显的短板。
GBK 是 1995 年制定的规范,仅收录了 21,886 个字符。当表格中包含人名、地名、金融票据中的生僻字(例如“镕”、“珅”、“䶮”、“赟”),或者包含特定的繁体字、中文特殊符号时,GBK 编码表中没有对应的码位。这会导致程序在读取到该行时依然抛出 UnicodeDecodeError: 'gbk' codec can't decode byte...。
而 GB18030 是我国现行的国家强制性标准,它在结构上完全向后兼容 GBK 和 GB2312,同时通过 4 字节编码机制扩充到了 7 万多个字符,完全覆盖了 Unicode 中文字符集。
encoding='gb18030' 替代 encoding='gbk'。两者的运行性能没有差异,但 gb18030 具备更宽广的字库覆盖度,能有效避免数据因个别生僻字而中断解析。
三、4 步系统排查与解决流程
当面对一份来源未知的中文 CSV 文件且读取报错时,盲目猜测编码效率很低。推荐遵循以下决策流程分步操作:
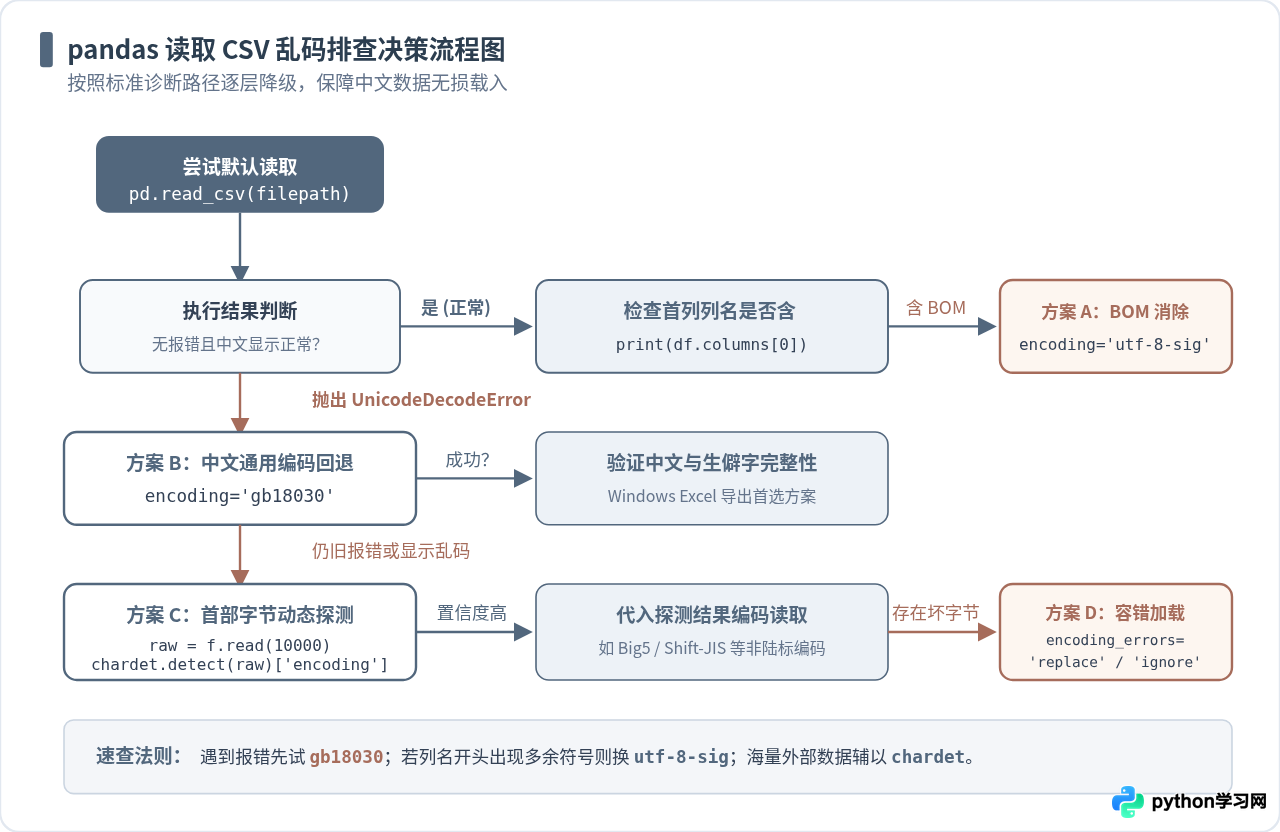
第 1 步:优先尝试标准通用解码(90% 覆盖率)
绝大多数中文办公表格均由 Windows 导出,第一步应优先测试 gb18030。如果文件是由新版 Excel 导出的 UTF-8,则测试 utf-8-sig:
import pandas as pd

file_path = "sales_data.csv"

# 方案 1:针对绝大多数 Windows 中文本地 CSV
try:
    df = pd.read_csv(file_path, encoding='gb18030')
    print("使用 gb18030 读取成功!")
except UnicodeDecodeError:
    # 方案 2:针对 Excel 导出的带 BOM 编码
    df = pd.read_csv(file_path, encoding='utf-8-sig')
    print("使用 utf-8-sig 读取成功!")
第 2 步:核对字段名与首行是否存在不可见字符
读取完成后,不要仅看打印的数据切片,必须打印列名列表确认首列键名是否正常:
# 打印列名列表,检查是否存在  前缀
print("当前字段列表:", list(df.columns))

# 示例输出(如果未加 -sig 处理,可能出现如下情况):
# ['订单号', '客户名称', '交易金额']
# 示例检查输出 当前字段列表:['订单号', '客户名称', '交易金额']
如果字段名显示正常,说明解码完全吻合。
第 3 步:使用 chardet 对未知大文件进行局部采样探测
如果既不是 GB18030 也不是 UTF-8(例如台湾地区的繁体中文系统导出的 Big5,或者日资外企系统导出的 Shift-JIS),不建议一次次手工试错。可以借助 Python 内置的二进制读取能力配合 chardet 库进行采样。
注意:切勿对数个 G 的大文件做全量字符分析,那会耗尽内存和 CPU。只需以二进制模式读取文件前 10,000 个字节进行推断即可:
import chardet
import pandas as pd

file_path = "sales_data.csv"

# 二进制模式只读前 10000 字节
with open(file_path, 'rb') as f:
    raw_sample = f.read(10000)
    detection_result = chardet.detect(raw_sample)

detected_encoding = detection_result['encoding']
confidence = detection_result['confidence']

print(f"探测结果:编码为 {detected_encoding},置信度为 {confidence:.2f}")

# 将探测到的编码传入 pandas
df = pd.read_csv(file_path, encoding=detected_encoding)
# 示例执行结果 探测结果:编码为 GB2312,置信度为 0.99 # 由于 GB18030 兼容 GB2312,此处传入 GB2312 或 GB18030 均能完美读取
第 4 步:应对破损文件或混合编码——启用容错模式
在爬虫抓取的数据、日志汇总或经历多次系统流转的文件中,可能存在极少数损坏的十六进制字节(例如传输中断、字段截断导致双字节被腰斩)。此时即便指定了正确的编码,只要遇到一个损坏字节,pandas 依然会全盘崩溃。
在 pandas 1.3.0 及以上版本中,pd.read_csv() 新增了 encoding_errors 参数(对应底层 Python open() 函数的 errors 参数):
encoding_errors='replace':将无法识别的字节替换为标准的 Unicode 替换字符(如),程序不报错,保证有效数据全部读入。encoding_errors='ignore':直接跳过无法识别的损坏字节,继续解析剩余部分。
# 容错加载方案:遇到损坏字节替换为占位符,避免整个任务崩溃
df = pd.read_csv(
    file_path,
    encoding='gb18030',
    encoding_errors='replace'
)

# 查看是否包含被替换的标记
bad_rows = df[df.apply(lambda row: row.astype(str).str.contains('�').any(), axis=1)]
print(f"包含修复标记的行数:{len(bad_rows)}")
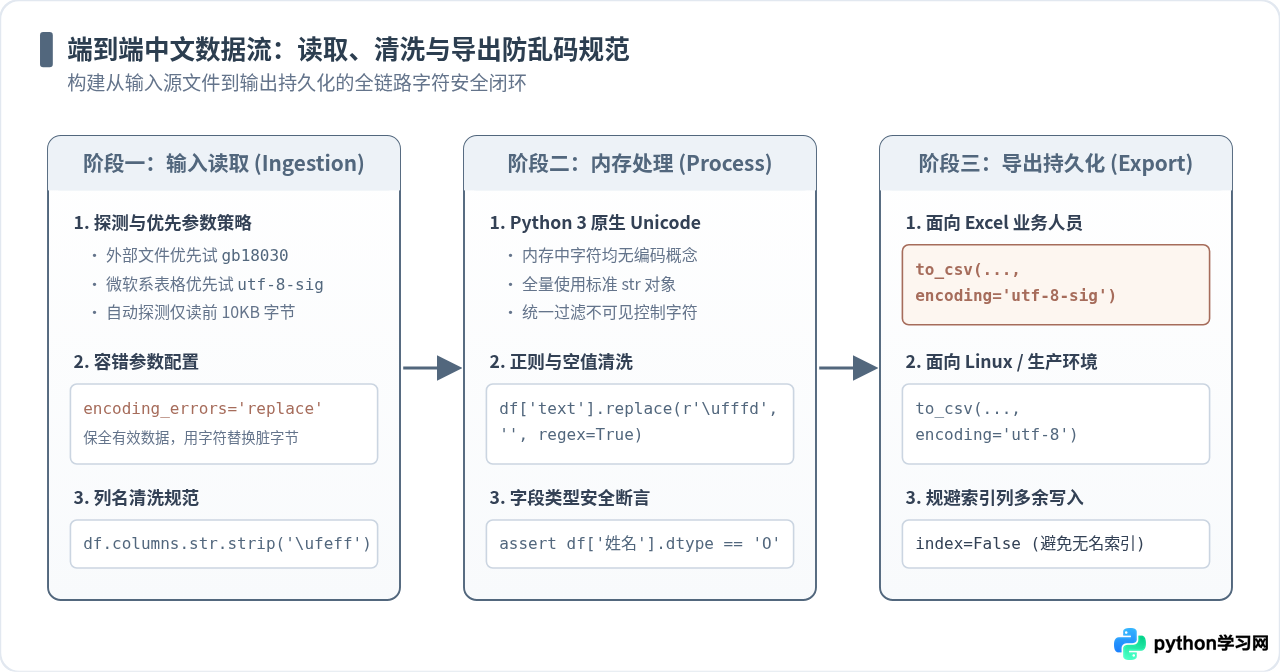
四、数据持久化:写入 CSV 时的编码防坑闭环
在数据处理完成后,很多开发者会使用 df.to_csv('result.csv', index=False) 将结果导出。然而,当把这个文件发给使用 Windows Excel 的同事或业务人员时,对方一打开往往再次出现满屏乱码。
这是因为 pandas 的 to_csv() 默认采用无 BOM 的 utf-8。Windows 系统的 Excel 在双击打开 .csv 文件时,默认不会将其识别为 UTF-8,而是以系统 ANSI 代码页直接解析,从而造成“自己写出自己读正常,但在 Excel 里看乱码”的现象。
防范这一问题的标准做法是明确区分交付对象:
- 若交付给业务人员使用 Excel 打开:必须在导出时指定
encoding='utf-8-sig'。带有 BOM 头的文件能被 Excel 自动识别为 UTF-8,保证各类中文字符正常渲染。 - 若交付给 Linux 服务端或作为数据库导入媒介:使用默认的
encoding='utf-8',避免 BOM 标记对自动化解析脚本造成干扰。
# 推荐的导出规范(兼顾 Excel 双击打开不乱码)
df.to_csv(
    "clean_sales_data.csv",
    index=False,
    encoding='utf-8-sig'
)
五、常见问题排查对照速查
| 异常现象 / 报错信息 | 底层核心成因 | 针对性解决方案 |
|---|---|---|
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x... |
文件实为 Windows ANSI (GBK/GB18030),默认以 UTF-8 读取导致字节冲突。 | 设置 encoding='gb18030'。 |
KeyError: 'id'(首列访问异常) |
文件开头包含 Excel 写入的 3 字节 BOM 标记,被解析为正文字符。 | 改用 encoding='utf-8-sig' 自动剥除。 |
UnicodeDecodeError: 'gbk' codec can't decode byte 0x... |
指定了 gbk,但数据中存在生僻人名、特殊繁体字或行业符号。 | 升级为 encoding='gb18030'。 |
| 个别文本行存在脏数据,排查后所有编码均报错 | 网络传输中断或上游系统导出截断,存在破损的不完整多字节。 | 添加 encoding_errors='replace' 容错读入。 |
| Python 导出 CSV 后,同事用 Excel 双击打开是乱码 | Excel 无法自适应无 BOM 的 UTF-8 文本文件。 | 导出时显式指定 to_csv(..., encoding='utf-8-sig')。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









