

Python高效切分GB级大文本文件的方法
针对几GB乃至几十GB的大文本文件,详解Python高效切分的核心策略,包括按行流式切分、带行对齐的字节块切分、表头复用及缓冲区IO调优实践。
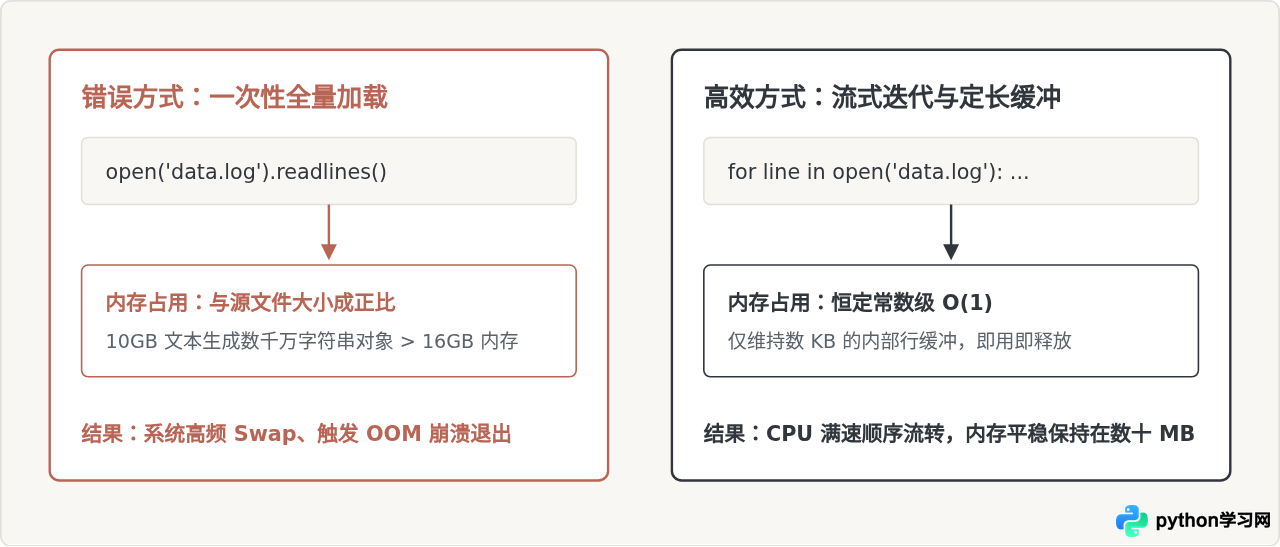
处理数GB至数十GB的大型文本文件时,最基础也最关键的技术原则是:绝对不要一次性将整个文件或其全部行结构读入内存。常规开发中习惯调用的 read() 或 readlines() 会直接将文件完全反序列化为内存字符串对象,瞬间耗尽物理内存并引发系统崩溃。正确的高效解决路径是采用流式迭代(Streaming Iteration)或固定块缓冲区(Chunk Buffering),维持常数级的低内存消耗,配合合理的 I/O 缓冲区设置,将大文件按目标行数或文件体积平稳切分到多个独立分卷中。
一、基于行数的流式切分实现
按行切分最适合 CSV、TSV、JSON Lines(每行一个 JSON)以及系统排查日志等结构化文本。因为每一行本身就是一个独立的业务实体,切分时绝不能破坏行边界。
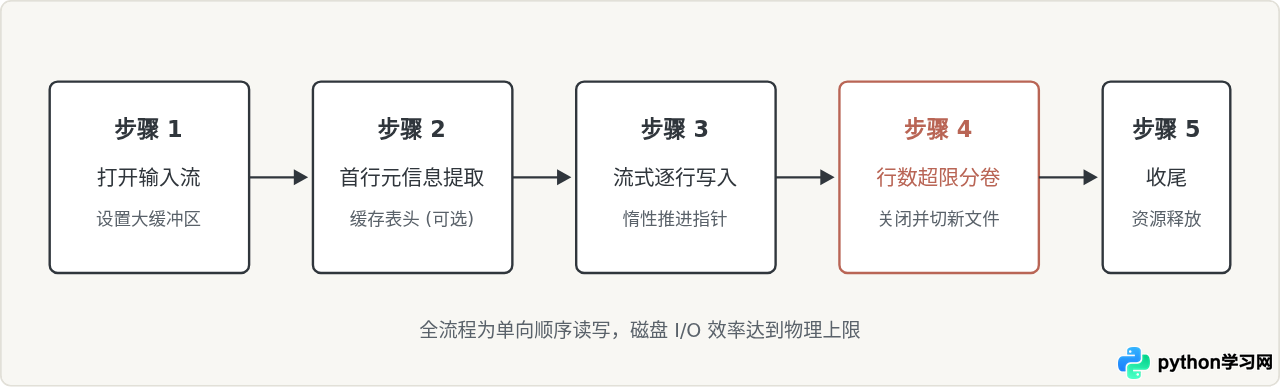
Python 的文件句柄本身就是一个标准的迭代器。使用 for line in file_obj: 时,Python 会在底层的 C 层面维护读取缓冲区,惰性返回每一行,内存中永远只保留当前行及其微小的输入缓冲。以下是标准、健壮的按行切分函数:
import os

def split_by_line_count(source_file, lines_per_file=1000000, output_dir="output_chunks"):
    """
    按指定行数流式切分文本文件
    :param source_file: 源文件绝对路径或相对路径
    :param lines_per_file: 每个切片文件的目标行数,默认 100 万行
    :param output_dir: 切片文件输出目录
    """
    if not os.path.exists(output_dir):
        os.makedirs(output_dir)

    base_name = os.path.basename(source_file)
    name, ext = os.path.splitext(base_name)

    part_num = 1
    current_lines = 0
    current_out_file = None

    try:
        # 使用 utf-8 编码,并设定 16MB 的自定义 I/O 缓冲区
        with open(source_file, 'r', encoding='utf-8', buffering=16 * 1024 * 1024) as src:
            for line in src:
                # 当达到分卷行数上限或尚未创建文件时,打开新分卷
                if current_out_file is None or current_lines >= lines_per_file:
                    if current_out_file:
                        current_out_file.close()
                    out_path = os.path.join(output_dir, f"{name}_part_{part_num:04d}{ext}")
                    current_out_file = open(out_path, 'w', encoding='utf-8', buffering=16 * 1024 * 1024)
                    part_num += 1
                    current_lines = 0

                current_out_file.write(line)
                current_lines += 1
    finally:
        # 确保最后一个分卷被正确关闭与落盘
        if current_out_file and not current_out_file.closed:
            current_out_file.close()
在这个实现中,通过维持 current_lines 计数,当行数达到预定阈值(如 100 万行)后安全刷新并关闭当前句柄,再顺延创建下一个标号文件。整个流程无论源文件是 2GB 还是 200GB,运行内存始终稳定在 30MB 左右。
进阶细节:CSV 文件的表头(Header)保持
在切割 CSV 文件时,若切出的后续分卷缺失首行表头,后续由 Pandas 或 Spark 读取时通常会导致字段错位。可以在读取源文件前先执行 header = src.readline(),然后在每次实例化 current_out_file 时先写入该 header,以保证所有分卷的数据自解释完整性。
二、基于文件大小与行边界对齐的切分
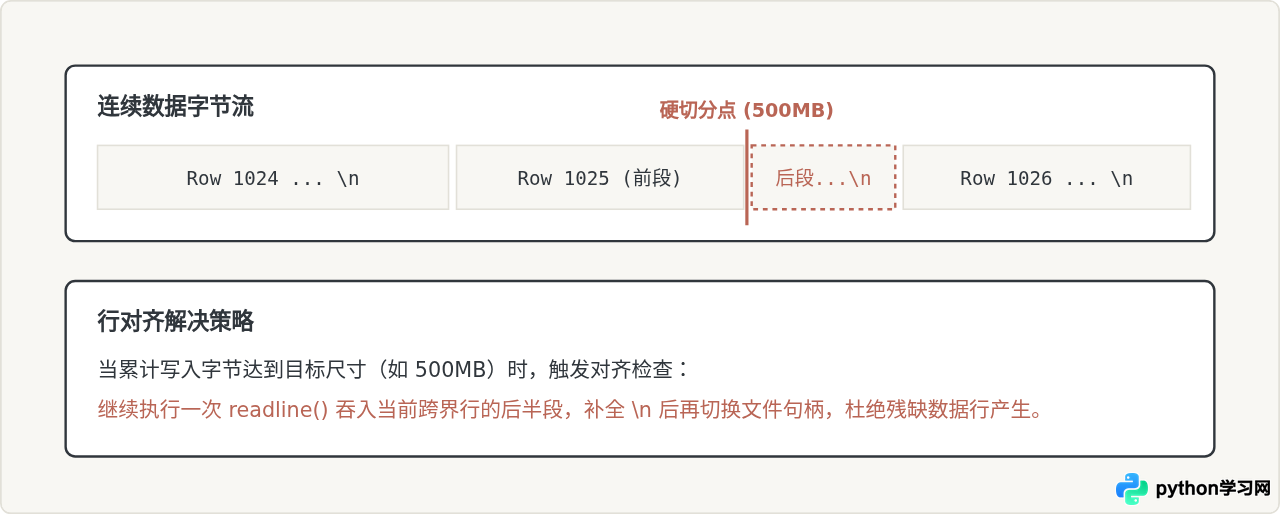
如果切分的目标要求是“每个文件不超过 500MB”,情况就比按行切分复杂一些。单纯以字节为单位进行二进制定长切割(f.read(chunk_size))会导致换行符被腰斩,产生损坏的残缺行(例如一条长 JSON 的前半段落在 part1,后半段落在 part2)。
为了兼顾“控制文件大小”与“保持行数据完整”,核心解决方案是分块读取 + 行对齐延伸(Line Alignment Extension):当当前输出文件的写入字节累计超过设定阈值后,不强行截断,而是额外调用一次 readline() 读取并写入直至遇到当前行末尾的 \n,随后再优雅切换至下一个分卷。
以下为结合行对齐的定长体积切分代码:
import os

def split_by_size_aligned(source_file, target_size_mb=500, output_dir="output_chunks"):
    """
    按文件大小切分,同时保证末尾行完整性
    :param source_file: 源文件路径
    :param target_size_mb: 每个分卷目标大小(MB)
    :param output_dir: 输出目录
    """
    if not os.path.exists(output_dir):
        os.makedirs(output_dir)

    target_bytes = target_size_mb * 1024 * 1024
    base_name = os.path.basename(source_file)
    name, ext = os.path.splitext(base_name)

    part_num = 1
    current_bytes = 0
    current_out_file = None

    try:
        # 使用二进制模式 'rb' 读取,跳过复杂的 utf-8 解码开销,速度提升 3-5 倍
        with open(source_file, 'rb', buffering=32 * 1024 * 1024) as src:
            for line in src:
                if current_out_file is None:
                    out_path = os.path.join(output_dir, f"{name}_part_{part_num:04d}{ext}")
                    current_out_file = open(out_path, 'wb', buffering=32 * 1024 * 1024)
                    part_num += 1
                    current_bytes = 0

                current_out_file.write(line)
                current_bytes += len(line)

                # 仅在完整写入当前行之后,再判断是否需要切换分卷
                if current_bytes >= target_bytes:
                    current_out_file.close()
                    current_out_file = None
    finally:
        if current_out_file and not current_out_file.closed:
            current_out_file.close()
三、吞吐量调优:I/O 缓冲区与二进制模式
对于 10GB 以上的文件切分任务,CPU 计算通常不是瓶颈,实际瓶颈集中在磁盘物理顺序读取带宽与Python 用户态/内核态系统调用频率。针对处理性能,以下三项设置具有显著提速效果:
1. 开启二进制读写模式('rb' / 'wb')
如果在切分过程中不需要对文本内容进行修改或按列过滤,应一律使用 'rb' 和 'wb' 模式。在文本模式下,Python 的 io.TextIOWrapper 需要在内存中实时解码 UTF-8 字节并统一转换跨平台的 \r\n 换行符。直接使用二进制模式可以跳过所有字符集解析,仅在字节层面识别 b'\n' 分隔符,吞吐率通常可直接提高 2 至 4 倍。
2. 扩大底层缓冲区(buffering 参数)
Python 默认的缓冲区大小为系统页大小(通常为 4KB 或 8KB)。频繁以几 KB 为单位触发 read 和 write 系统调用会导致大量上下文切换开销。将 open() 的 buffering 参数设置为 16*1024*1024(16MB)或 32*1024*1024(32MB),能让操作系统在块设备层面以更大的簇进行连续读写,充分利用现代 NVMe SSD 的顺序写缓存。
3. 多进程处理的限制与边界
不少开发者会尝试使用 multiprocessing 多进程来加速切分,但在单块普通机械硬盘或单通道 SSD 上,多个进程同时读取和写入同一个物理磁盘往往会导致磁盘磁头频繁寻道或控制器并发队列堵塞,性能反而不如单进程顺序流式处理。只有在输入源与输出目标位于两块完全独立的物理固态硬盘时,多进程预计算指针分段才具有实际加速意义。
四、方案对比与选型决策
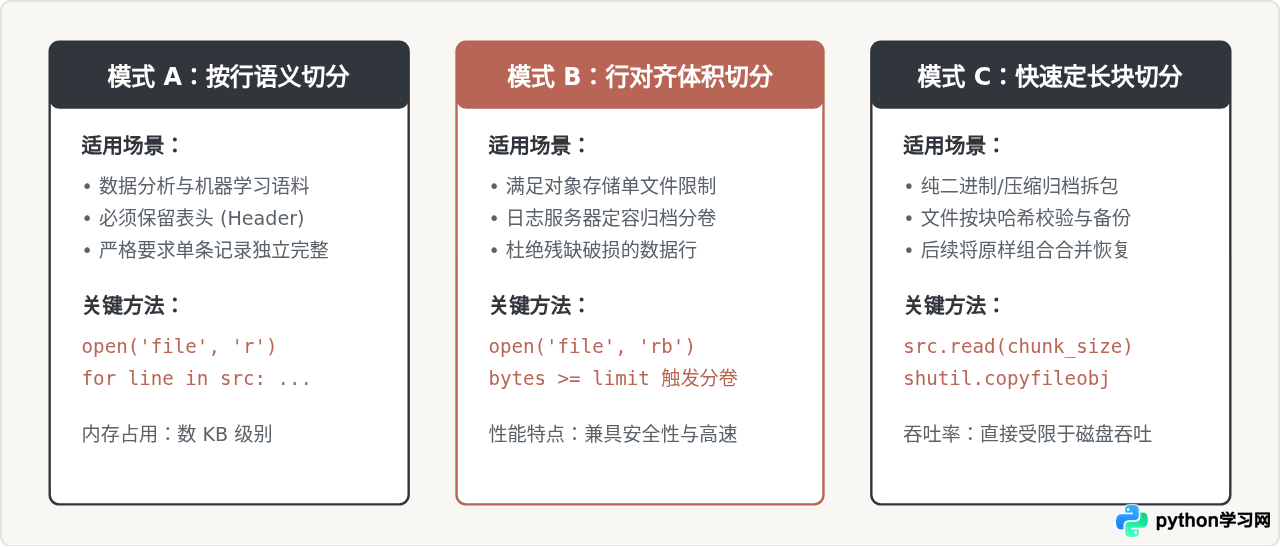
面对具体的大文本文件处理场景,不同切分方案的适用边界如下表所示:
| 方案类型 | 核心实现机制 | 内存占用表现 | 数据完整性保证 | 推荐适用业务 |
|---|---|---|---|---|
| 按行流式切分 | for line in src 逐行遍历 |
恒定 < 30MB | 极高(天然保持行完整) | CSV/TSV、结构化日志、JSONL 训练集 |
| 带行对齐的字节切分 | 二进制流累计大小 + 完整行闭合 | 恒定 < 50MB | 极高(按字节达标后安全截断) | 按上传限制(如 500MB 分卷)拆分日志 |
| 纯二进制定长块切分 | src.read(chunk_size) 直接复制 |
等于 Chunk 设定值 | 低(无法保留文本行语义) | 纯二进制归档、压缩分包、无语义大文本 |
五、生产环境核心注意事项
- 磁盘剩余空间检查:大文件切分在默认情况下是生成新的分卷文件,磁盘上将同时存在一份原始完整文件与若干分卷。切分前必须确保目标存储盘拥有至少等于源文件大小的可用空间,避免写满磁盘导致系统服务停摆。
- 资源安全释放:切分过程中如果触发不可预测的异常(如磁盘满、进程被杀),应当在
finally块中或者利用上下文管理器确保已经打开的文件句柄安全闭合,防止数据损坏。 - 文件命名排序:分卷命名建议使用固定宽度的格式化字符串(如
{part_num:04d}生成 0001, 0002),这样在后续通过glob或系统命令检索时,能够保证天然的字母顺序与原数据顺序一致。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









