

Python实现文本翻译常用哪些第三方库

详细梳理Python实现文本翻译的常用第三方库,涵盖deep-translator聚合库、Argos Translate离线库、Transformers深度学习模型及商业SDK,提供清晰的技术选型对比与代码实战。
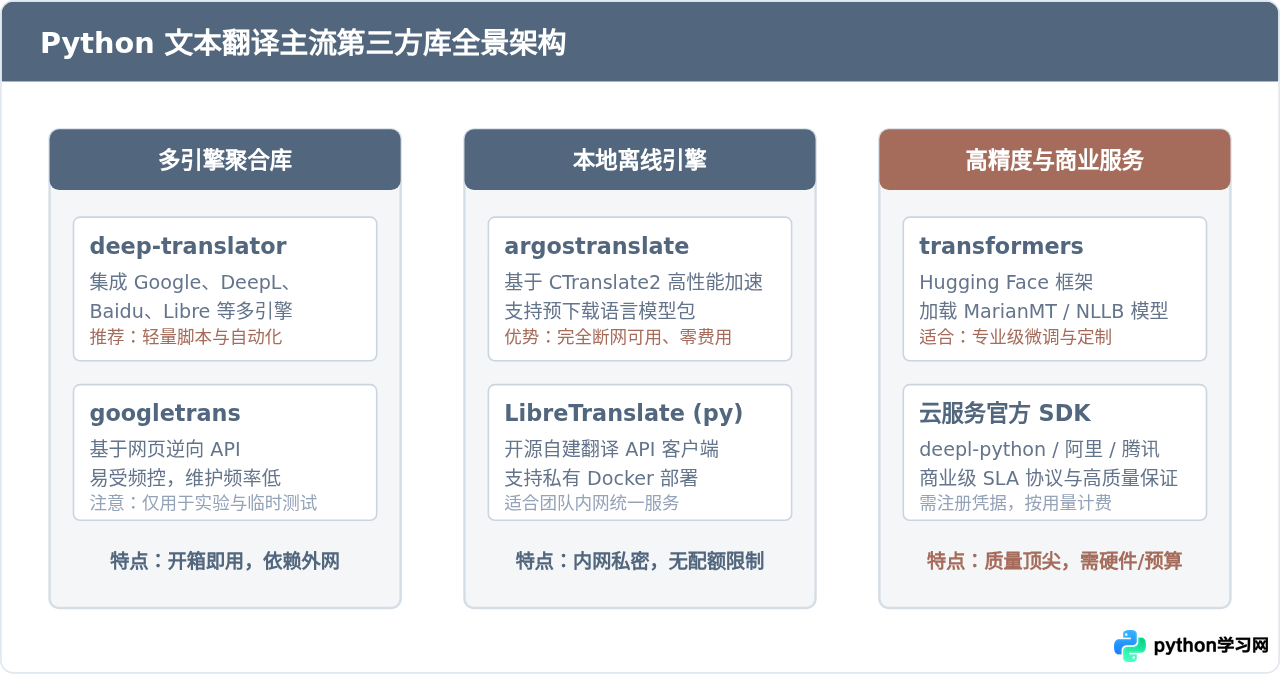
在 Python 生态中实现文本翻译,主要分为三条技术路径:一是基于网络接口的聚合客户端库(如 deep-translator 和曾经广泛使用的 googletrans),二是不依赖外部网络的本地离线机器翻译库(如基于 CTranslate2 的 argostranslate),三是基于深度学习预训练模型的私有化推理框架(如 Hugging Face transformers)。不同方案在网络依赖、调用成本、响应延迟及数据保密性上各有侧重,开发者需要根据具体应用场景进行合理选型。
一、Python 文本翻译方案全景与分类
很多初学者在寻找翻译方案时,往往首先接触到针对单一接口的爬虫类库,但随着接口反爬机制更新,这类方案极易失效。理解当前成熟的第三方库体系,是构建稳定翻译服务的前提。
二、轻量与敏捷开发:使用 deep-translator 聚合多引擎
对于个人爬虫、文本分析、小型自动化脚本等场景,安装维护成本低、开箱即用的库是首选。目前最成熟稳定的聚合库是 deep-translator。
早年 Python 开发者常用 googletrans,但其底层通过逆向抓取 Web 端未公开接口,经常由于 Google 的 Token 算法调整或 IP 频率限制而抛出 AttributeError: 'NoneType' object has no attribute 'group' 等解析异常。相比之下,deep-translator 提供了统一的 API 封装,不仅支持 Google 免费接口,还支持 DeepL、Baidu、MyMemory、LibreTranslate 等多种引擎,切换成本极低。
1. 安装与基础调用
pip install deep-translator使用 GoogleTranslator 进行中英互译的最小示例:
from deep_translator import GoogleTranslator

# 初始化翻译器:自动检测源语言,目标语言为中文
translator = GoogleTranslator(source='auto', target='zh-CN')

# 单句翻译
text = "Python is an interpreted, high-level and general-purpose programming language."
translated = translator.translate(text)
print("翻译结果:", translated)
# 输出:Python 是一种解释型、高级且通用的编程语言。
2. 批量处理与引擎切换
deep-translator 允许传入列表进行批量翻译,同时其接口保持高度一致。例如切换为 MyMemory 翻译器或接入 DeepL:
from deep_translator import MyMemoryTranslator

# 切换为 MyMemory 引擎
memory_trans = MyMemoryTranslator(source='en-US', target='zh-CN')
sentences = [
    "Hello world",
    "Machine translation has evolved rapidly."
]
results = memory_trans.translate_batch(sentences)
for original, res in zip(sentences, results):
    print(f"{original} -> {res}")
三、稳健生产实践:长文本切分与异常重试流程
无论使用哪种网络翻译库,免费接口与商业接口均存在单次请求字符上限(通常在 2000 到 5000 字符之间)以及网络瞬时波动的限制。直接将上万字的长文本整段传入,会导致接口拒绝或超时失败。
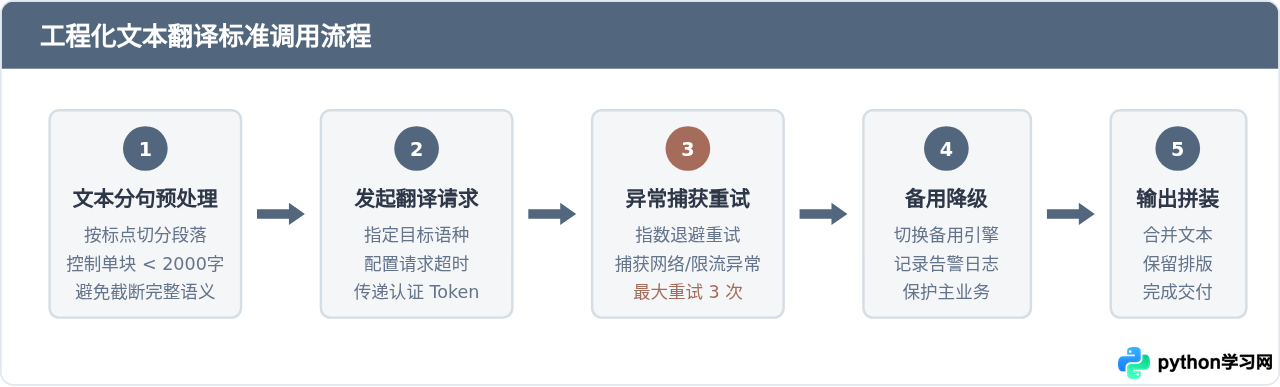
以下是具备重试与文本按行切分的工业级示例函数:
import time
from deep_translator import GoogleTranslator
from deep_translator.exceptions import TranslationNotFound, RequestError

def safe_translate_text(text: str, max_retries: int = 3) -> str:
    """带自动重试与异常保护的翻译包装函数"""
    translator = GoogleTranslator(source='auto', target='zh-CN')
    lines = [line.strip() for line in text.split('\n') if line.strip()]
    translated_lines = []

    for line in lines:
        for attempt in range(max_retries):
            try:
                # 单行过长时应进一步按句号拆分
                result = translator.translate(line)
                translated_lines.append(result)
                time.sleep(0.3)  # 控制请求速率,防止触发防护机制
                break
            except (RequestError, Exception) as err:
                if attempt == max_retries - 1:
                    print(f"翻译失败 [{line[:15]}...]: {err}")
                    translated_lines.append(line)  # 失败保底保留原文
                else:
                    time.sleep(1.5 * (attempt + 1))  # 线性退避重试

    return '\n'.join(translated_lines)
四、隐私与离线场景:Argos Translate 零网络实现
当处理涉及商业机密、内部日志或部署在无外网环境(如专网服务器、保密机房)时,向外部 API 发送数据不符合安全规范。此时可以使用 argostranslate。
argostranslate 是一个开源的离线神经机器翻译库。它底层使用 CTranslate2(针对 Transformer 模型高度优化的 C++ 推理引擎)和 SentencePiece 分词,完全运行在本地 CPU 或 GPU 上,不需要联网即可翻译。
1. 安装核心库与更新包管理器
pip install argostranslate2. 下载安装语言包与执行翻译
Argos Translate 将不同语言对(如 en -> zh)打包成独立模型文件。首次使用需下载对应语言模型包,之后即可永久脱机运行:
import argostranslate.package
import argostranslate.translate

def init_offline_translator(from_code='en', to_code='zh'):
    # 更新包索引列表并下载对应语言包
    argostranslate.package.update_package_index()
    available_packages = argostranslate.package.get_available_packages()

    # 查找匹配的语言包
    package_to_install = next(
        (pkg for pkg in available_packages if pkg.from_code == from_code and pkg.to_code == to_code),
        None
    )
    if package_to_install:
        argostranslate.package.install_from_path(package_to_install.download())
        print(f"已成功安装离线包: {from_code} -> {to_code}")

# 离线翻译调用
def translate_offline(text: str, from_code='en', to_code='zh') -> str:
    installed_languages = argostranslate.translate.get_installed_languages()
    src_lang = next((lang for lang in installed_languages if lang.code == from_code), None)
    dst_lang = next((lang for lang in installed_languages if lang.code == to_code), None)

    if not src_lang or not dst_lang:
        raise RuntimeError("未找到对应的本地语言包,请先安装。")

    translation = src_lang.get_translation(dst_lang)
    return translation.translate(text)

# 测试执行
# init_offline_translator('en', 'zh')  # 仅首次需要运行
sample_text = "Argos Translate is an open-source offline translation library written in Python."
print(translate_offline(sample_text, 'en', 'zh')).argosmodel 二进制包,随后拷贝到内网服务器,使用 argostranslate.package.install_from_path('xxx.argosmodel') 直接加载,全程不产生任何外网请求。
五、高质量深度学习模型:Hugging Face Transformers
如果对翻译译文质量、专业领域用词准确度有极高要求,或者有自己的专业语料库需要二次微调,使用 Hugging Face 的 transformers 是标准方案。
开源社区提供了大量成熟的机器翻译预训练模型,如赫尔辛基大学发布的 Helsinki-NLP/opus-mt-en-zh 以及 Meta 发布的跨 200 种语言互译的 facebook/nllb-200-distilled-600M。
pip install torch transformers sentencepiece基于 pipeline 的简洁翻译调用:
from transformers import pipeline

# 自动下载并加载 MarianMT 预训练模型
translator_pipeline = pipeline("translation_en_to_zh", model="Helsinki-NLP/opus-mt-en-zh")

text_to_translate = "Deep learning models provide domain-specific translation accuracy."
output = translator_pipeline(text_to_translate)

print("模型翻译结果:", output[0]['translation_text'])
该方案优势在于质量高、可控性强,支持量化推理与 GPU 加速;缺点是模型体积通常在数百兆到数吉字节之间,对服务器内存与算力有一定要求。
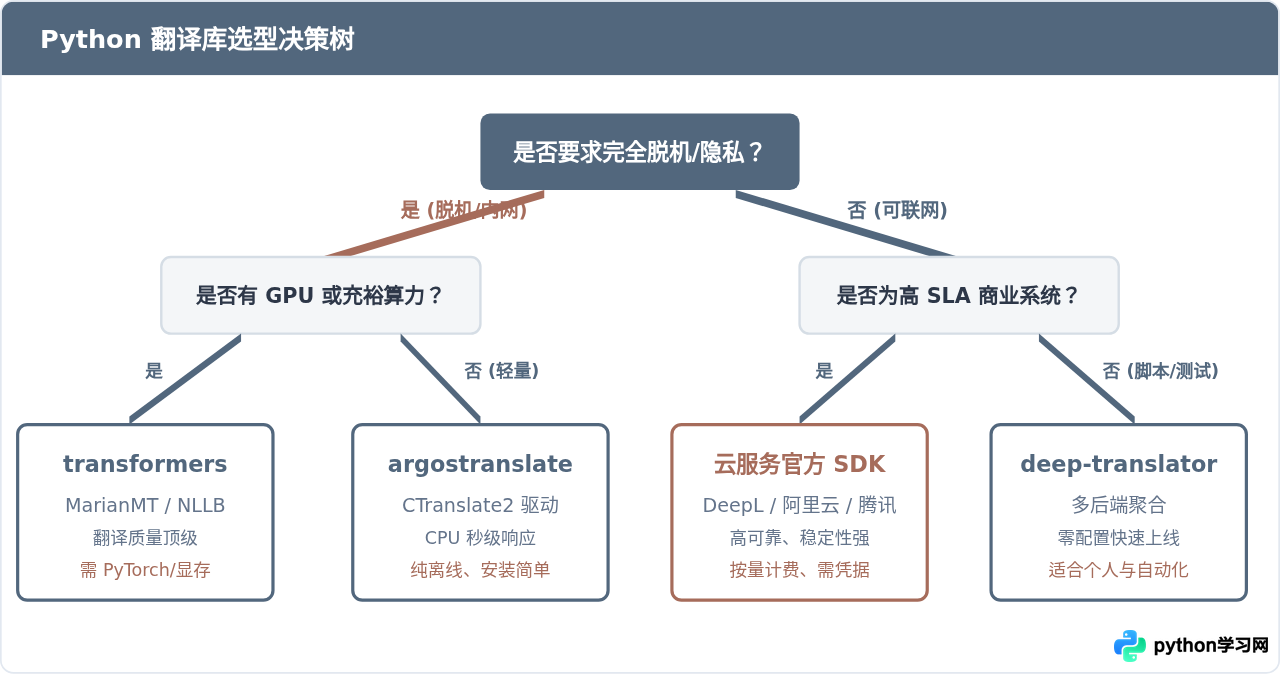
六、技术选型决策路径
面对多个选项,可以按照以下决策逻辑快速锁定适合自己业务的库:
七、核心第三方库综合对比总结
为了直观展现各方案的技术参数差异,以下将核心特性汇总如下:
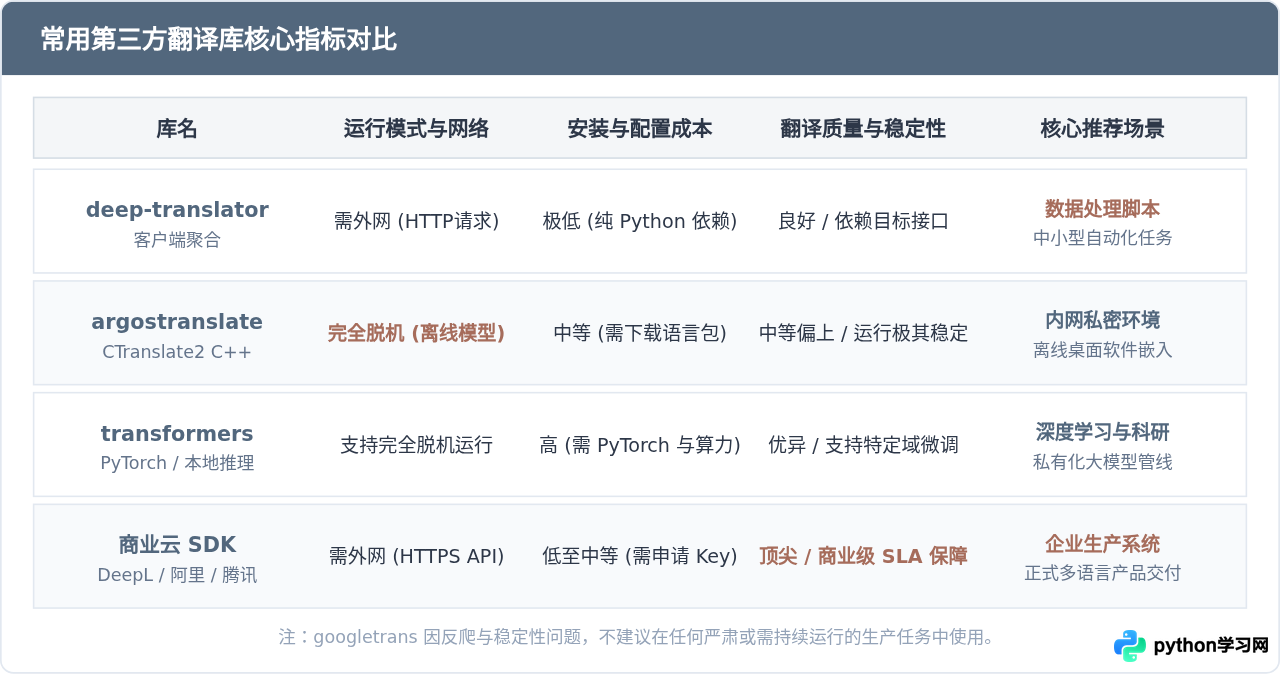
总的来说,如果是做简单工具脚本,deep-translator 是最快上手且兼顾多引擎的现代选择;如果面对纯断网或高保密业务,argostranslate 提供了极其高效的轻量离线解决方案;当有 GPU 算力且追求极致翻译质量时,Hugging Face 的 transformers 配合 MarianMT 模型能带来极高可控性;而对于高并发的正式企业级产品,接入 deepl-python 或国内云厂商官方 SDK 则是最可靠的交付路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









