

互联网大厂更看重Python还是Java?后端开发与算法岗位的招聘偏好
深度解析国内互联网大厂在后端开发与算法岗位中对Java和Python的招聘偏好,从架构体系、工业生态、考核要点到求职技能路径提供明确的分析与建议。
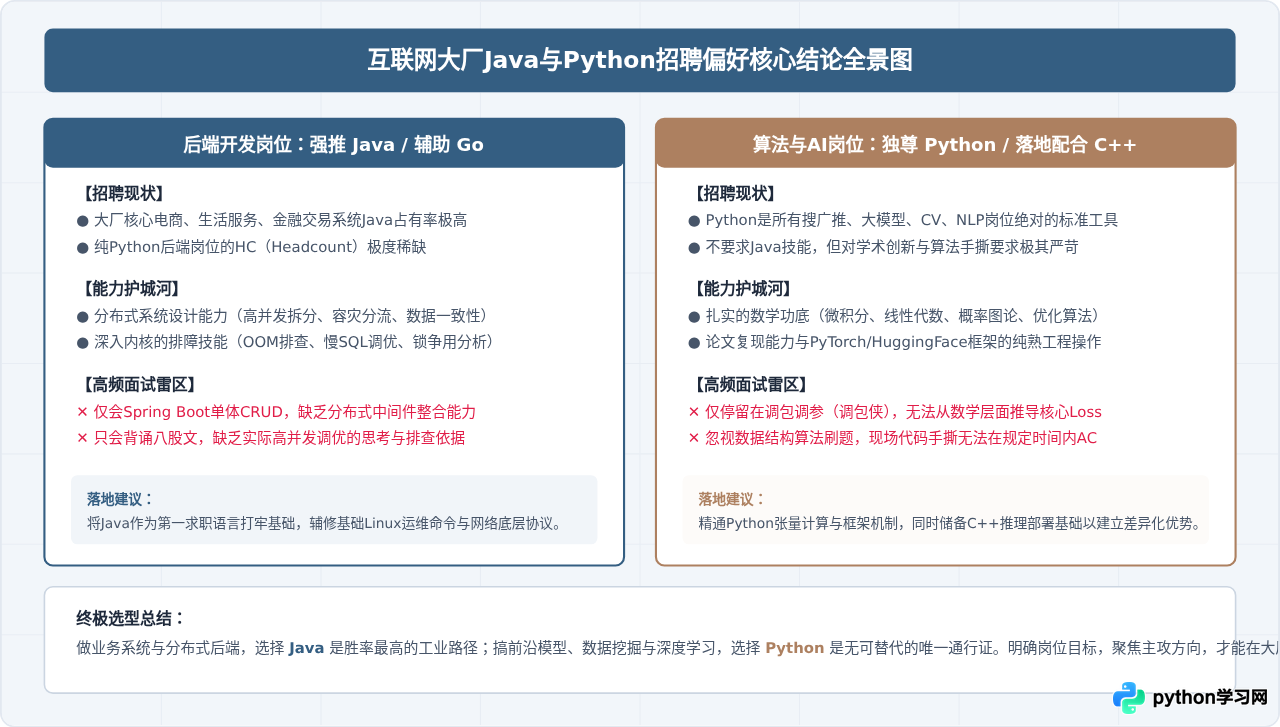
在国内主流互联网大厂(如阿里、腾讯、美团、字节跳动、百度、快手等)的技术招聘中,不存在绝对通用的“Java更吃香”或“Python更重要”,而是呈现极具工业特征的岗位强绑定偏好:后端开发岗位将Java作为主导性的工业级基石,核心业务系统几乎全量拥抱Java或Go生态;算法与AI岗位则将Python确立为事实上的绝对垄断语言,从科研论文复现到工业级模型训练全线采用Python。本文将针对这两类岗位的业务场景、工业生态、考核维度与选型路径进行全面剖析,帮助求职者建立清晰的技能规划。
一、后端开发岗位的招聘偏好:Java的工业统治力
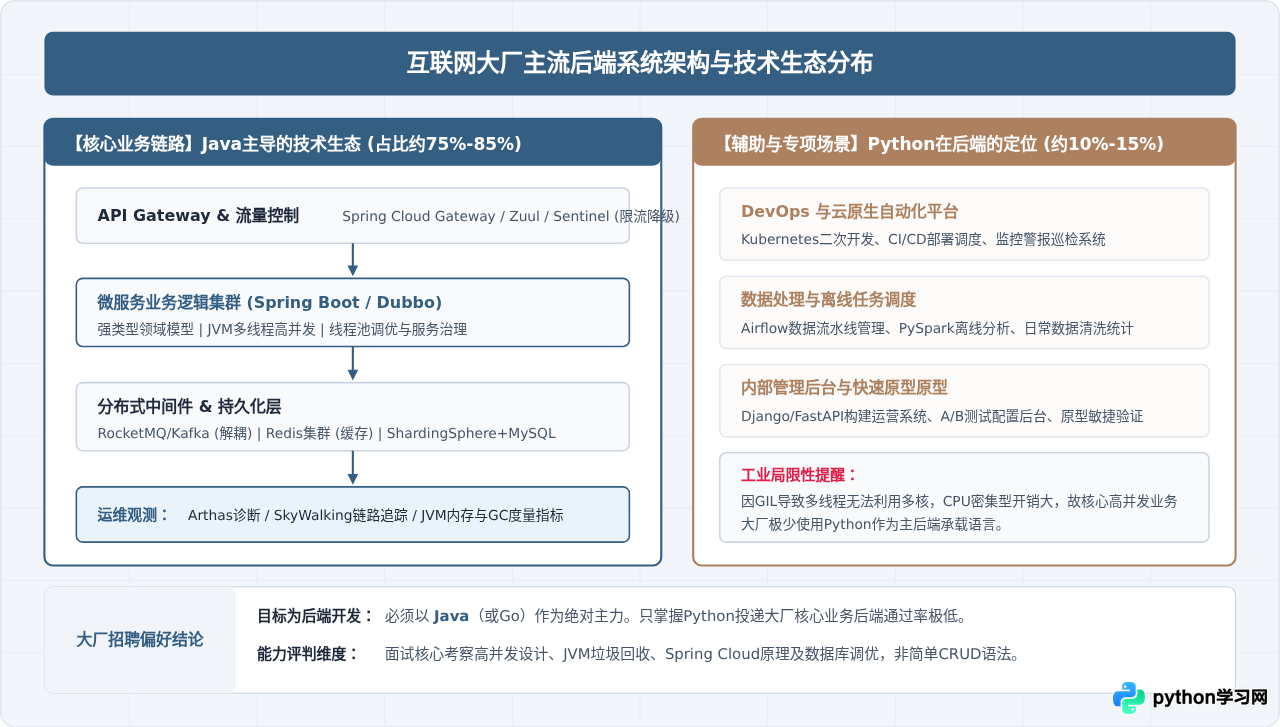
互联网大厂的后端系统核心特征是海量用户、超高并发流量以及严苛的分布式一致性要求。在双十一电商秒杀、外卖实时派单、金融交易结算等核心链路中,系统吞吐量与故障容忍度直接决定了企业的商业生命线。这种工业背景决定了大厂在后端招聘中高度倾向于静态类型且具备庞大生态支持的语言。
Java在大厂后端开发中占据主导地位的核心原因主要体现在四个工程维度:
- JVM成熟的内存管理与调优机制:Java虚拟机经过二十余年的工程打磨,拥有G1、ZGC等工业级垃圾回收器,大厂能够在高负载下对内存分配、垃圾回收停顿时间进行极其精细的度量与调优。
- 高度完善的分布式中间件生态:无论是RPC框架(Dubbo、gRPC)、分布式消息队列(RocketMQ、Kafka客户端)、分布式协调(ZooKeeper)、服务注册发现(Nacos)还是微服务脚手架(Spring Cloud),国内互联网生态的开源组件几乎全面以Java为第一公民。
- 静态强类型与大型团队协作规范:大型系统通常由数百名工程师协同研发,Java严格的强类型检查、模块化封装与成熟的设计模式,能够有效降低因动态弱类型带来的运行期隐性错误,重构成本远低于解释型脚本。
- 丰富的线上故障排查工具链:如Arthas、Async-profiler、JProfiler等生产级诊断工具,能在不重启线上服务的情况下完成热点代码分析与调用栈抓取。
相比之下,Python在主流大厂核心后端业务中几乎退居次席。虽然部分外企、早期的Instagram以及国内少数特定业务(如早期豆瓣、知乎等)曾深度采用Python构建Web后端,但在大厂当前千万级QPS的压力下,Python受限于GIL(全局解释器锁)以及解释执行的单核性能瓶颈,难以直接承载核心交易业务。在大厂的后端体系中,Python更多作为辅助工具存在,广泛应用于自动化运维平台(DevOps脚本)、内部运营管理后台、数据中台离线ETL脚本以及云原生CI/CD流程中。
二、算法岗位的招聘偏好:Python的绝对主宰地位
与后端开发截然相反,在互联网大厂的算法岗位(包括搜索推荐、自然语言处理NLP、计算机视觉CV、语音识别以及当前的大语言模型LLM)中,Python是无可争议的第一生产力语言。如果求职目标是算法工程师,熟练掌握Python是准入的前提条件。
Python之所以能统治算法领域,根本原因在于其在学术界与工业界构建起的强大生态闭环:
- 深度学习框架的统一接口:PyTorch、TensorFlow、JAX、Hugging Face Transformers等业界主流框架均以Python作为标准顶层API。虽然底层算子基于C++和CUDA编写,但模型架构搭建、超参数调整、损失函数编写均在Python环境中完成。
- 极其丰富的数据科学与数值计算栈:NumPy的高性能多维矩阵操作、Pandas的高效结构化数据预处理、SciPy的数值分析工具,构成了机器学习特征工程不可替代的基座。
- 动态语言带来的快速实验优势:算法研究高度依赖“假设-实验-验证”的敏捷迭代周期。Jupyter Notebook与交互式调试环境允许工程师实时查看中间层张量形状、打印梯度,这是强类型静态编译语言难以企及的效率优势。
值得注意的是,算法工程师的编程技能考核不仅限于Python脚本编写。在实际生产落地(工程部署与在线推理)中,大厂面临严苛的延迟限制(例如搜索推荐模型必须在50毫秒内返回精排结果)。因此,算法岗位往往呈现出“Python主导训练,C++辅助高性能推理”的格局:
离线训练与数据挖掘全量使用 Python 完成模型搭建、Loss设计与参数调优;当模型上线时,工程团队或算法落地人员通常使用 C++ 配合 TensorRT、ONNX Runtime 或 Triton Inference Server 进行算子级优化与推理加速。而 Java 则负责在业务接入层调用算法服务RPC接口,两者边界分明。
三、求职者选型与准备路径:如何根据目标岗位选择核心语言
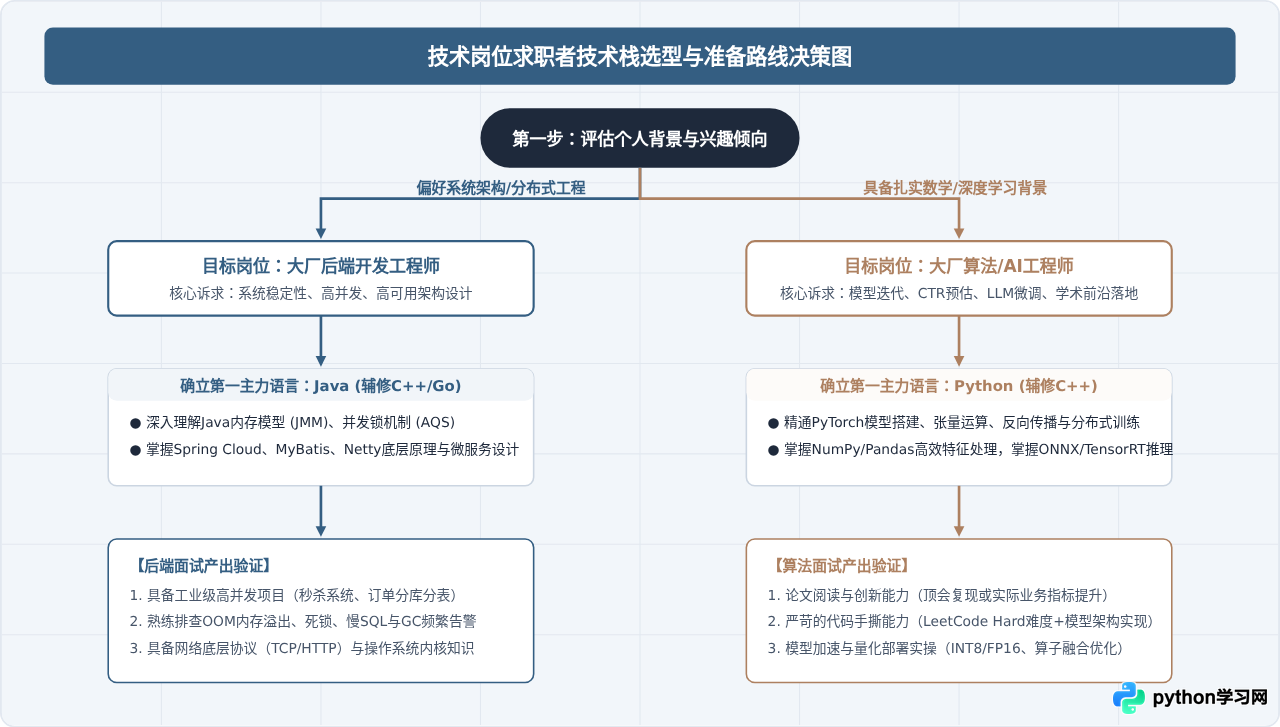
求职者在面临Java与Python的选择时,最常见的误区是“盲目求全”或“脱离岗位谈语言”。大厂招聘技术岗位的逻辑是“按岗定栈”。求职者应根据自身的数学基础、工程兴趣以及职业诉求,在校招或社招准备期明确主攻方向。
以下为求职者提供明确的选型与准备决策路径,通过步骤化的推导确定核心语言学习方案:
四、大厂技术面试考核维度的微观差异
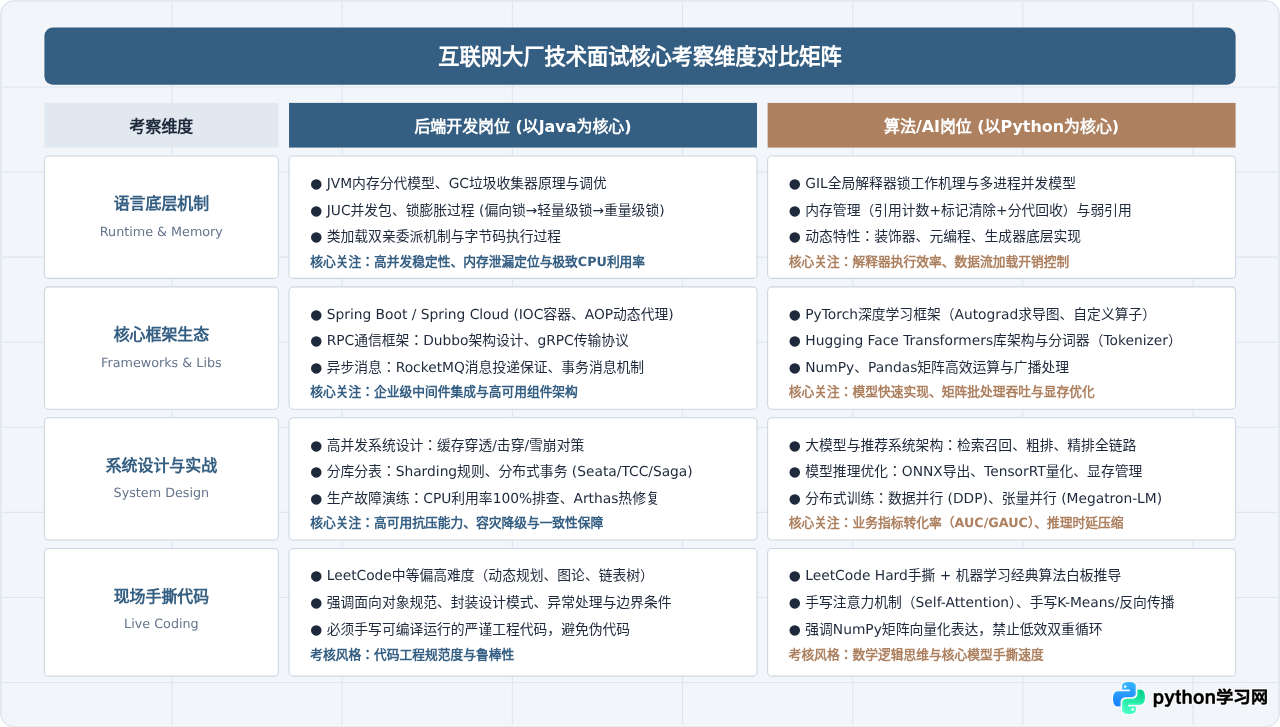
为了让准备过程具备针对性,需要进一步了解面试官在评估“Java能力”与“Python能力”时关注的核心差异点。面试官考察Java时,核心关注的是“底层运行机理与工业健壮性”;而考察Python时,核心关注的是“算法实现效率与生态工具熟练度”。
1. 后端Java面试的核心深度考点
大厂后端面试极少停留在“如何使用语法”,而是直击工程瓶颈:
- JVM垃圾回收与类加载:深入考察新生代与老年代分区算法、垃圾回收器(CMS、G1、ZGC)的并发标记过程、三色标记与漏标处理、以及双亲委派模型的打破场景。
- JUC并发编程:
AbstractQueuedSynchronizer(AQS) 的独占与共享模式实现机制、CAS无锁操作的ABA问题、线程池七大参数配置与拒绝策略选型。 - 数据库与缓存强一致性:MySQL InnoDB存储引擎的B+树结构细节、聚簇索引与覆盖索引、MVCC多版本并发控制、事务隔离级别与间隙锁,以及Redis与MySQL的双写一致性解决方案。
2. 算法Python面试的核心深度考点
大厂算法面试对Python语言本身的考察更侧重于高效率数据处理与底层交互逻辑:
- 向量化计算与广播机制:考察如何利用NumPy/PyTorch的广播规则实现无循环(Zero-loop)的矩阵运算,避免Python原生for循环带来的严重性能损耗。
- 语言底层特性:GIL对多线程的影响与多进程(multiprocessing)选型、生成器(Generator)与迭代器在超大规模数据集流式加载中的内存优化应用。
- 深度学习工程实践:PyTorch自动求导(Autograd)机制、混合精度训练(AMP)、DistributedDataParallel (DDP) 多卡分布式训练的通信开销与同步机制。
五、求职策略与总结建议
面对互联网大厂的招聘偏好,求职者不应陷入孤立的“语言优劣论”,而应建立明确的“岗位匹配论”。总结而言,针对不同的求职群体,应当遵循以下具体的行动策略:
| 求职群体 | 推荐主力语言与技术栈 | 核心竞争力构建重点 |
|---|---|---|
| 计算机专业/转码生 (主攻后端开发) |
主力:Java 辅修:Go 或 C++ |
不要停留在基于Spring Boot写单表CRUD;必须深入掌握MySQL索引与锁、Redis缓存架构、RPC与消息队列,并熟练运用JVM调优工具。以“高可用、高并发、可扩展”为核心构建真实项目经验。 |
| 理工科/AI方向硕博 (主攻算法岗位) |
主力:Python 辅助:C++ (高性能推理) |
深刻理解常见经典模型与最新顶会架构(如Transformer架构细节、扩散模型、大语言模型RLHF/微调方法);必须具备极强的数据结构刷题能力;熟练使用PyTorch与CUDA加速,掌握模型量化与部署工具。 |
| 已掌握Python 想投后端大厂者 |
战略路线:全面补修Java或Go | 如果仅凭Django/Flask/FastAPI经验投递大厂业务后端,由于HC(招聘配额)极少且竞争对手普遍具备扎实的Java分布式背景,通过率非常低。建议系统性补充Java并发与微服务知识体系。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









