

Python办公自动化实战:怎么用脚本处理Excel与批量文件
深入讲解如何使用Python标准库pathlib与openpyxl实现文件批量分类重命名、多源Excel表格自动读取、清洗合并与带样式报表生成,提供完整的实战代码与工程级容错方案。
在日常办公流程中,面对分散在多层文件夹中的成百上千个文档与表格,依靠人工点击复制不仅效率低下,而且容易遗漏错乱。使用 Python 落地办公自动化的关键并不在于复杂的算法,而是建立两项标准能力:一是使用标准库 pathlib 与 shutil 实现对批量文件与目录的扫描、匹配、规范重命名与定向归档;二是借助 openpyxl 完成对 Excel 工作簿、工作表及单元格级别的精准读取、清洗、汇总与格式化输出。本文围绕具体实战场景,详细拆解从批量文件治理到表格自动合并汇总的完整技术实现与工程防错策略。
一、批量文件梳理与自动化分类重命名
处理 Excel 自动化之前,通常需要先解决数据源文件“在哪里”以及“怎么命名”的问题。各部门提交的文件往往命名风格不一、存放层级混乱,手工收集整理耗费大量无谓精力。利用 Python 3 推荐的现代标准库 pathlib,可以通过面向对象的方式高效处理路径计算、递归检索与模式过滤。
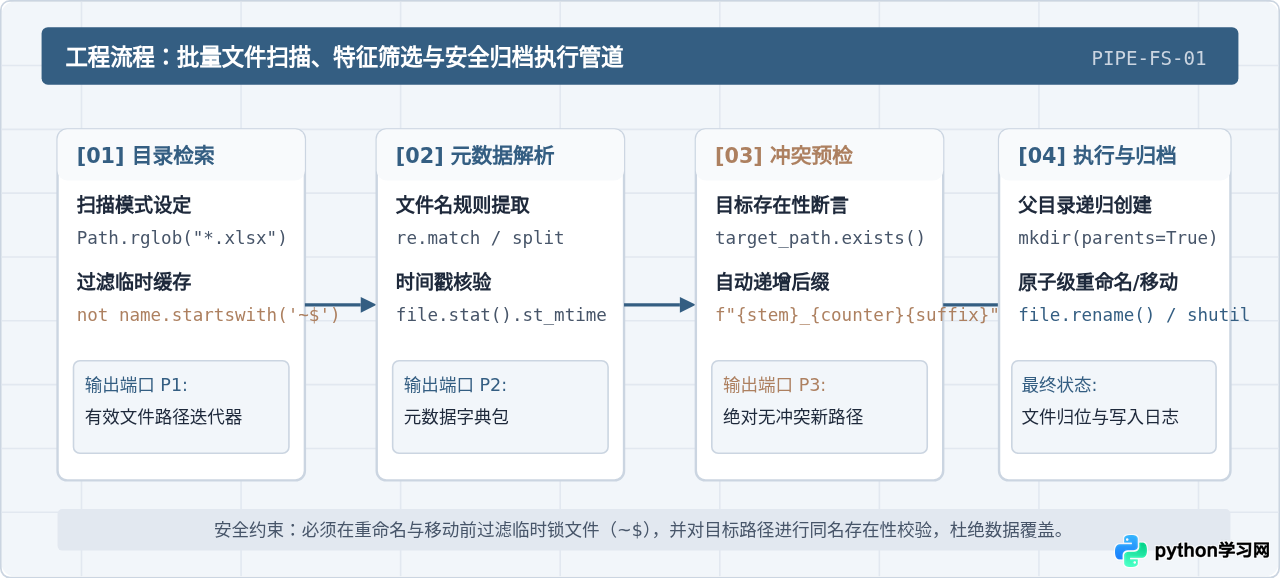
1. 批量检索与分类归档完整代码
假设我们有一批来自销售网点的报表,文件名类似“202603_华北_订单.xlsx”,要求按照“年份-月份/大区”两级目录进行归档,并在移动前排除已打开的 Office 临时文件(以 ~$ 开头)。
from pathlib import Path
import shutil

def organize_monthly_reports(source_directory: str, archive_root: str):
    src_dir = Path(source_directory)
    archive_dir = Path(archive_root)

    if not src_dir.exists():
        print(f"[错误] 源目录不存在: {src_dir}")
        return

    # 递归查找所有 .xlsx 文件
    matched_files = list(src_dir.rglob("*.xlsx"))
    print(f"扫描到文件总数: {len(matched_files)}")

    processed_count = 0
    skipped_count = 0

    for file_path in matched_files:
        # 1. 过滤 Office 打开时产生的隐藏锁定文件
        if file_path.name.startswith("~$"):
            skipped_count += 1
            continue

        # 2. 解析文件名规范,例如: 202603_华北_销售明细.xlsx
        parts = file_path.stem.split("_")
        if len(parts) >= 2:
            period = parts[0]   # 202603
            region = parts[1]   # 华北
            dest_folder = archive_dir / period / region
        else:
            # 命名不符合约定的放归入未分类目录
            dest_folder = archive_dir / "未分类"

        dest_folder.mkdir(parents=True, exist_ok=True)
        target_path = dest_folder / file_path.name

        # 3. 避免覆盖已存在同名文件的防冲撞机制
        counter = 1
        original_stem = file_path.stem
        while target_path.exists():
            target_path = dest_folder / f"{original_stem}_v{counter}{file_path.suffix}"
            counter += 1

        # 4. 执行文件移动
        shutil.move(str(file_path), str(target_path))
        print(f"已移动: {file_path.name} -> {target_path}")
        processed_count += 1

    print(f"处理完成!成功移动: {processed_count} 个,跳过临时文件: {skipped_count} 个")

if __name__ == "__main__":
    organize_monthly_reports("./incoming_reports", "./archived_reports")
Path.rglob() 遍历目录树非常方便,但在进行大规模 shutil.move() 或 os.rename() 操作前,务必保留一份源目录备份,或者在代码中增加一个 dry_run=True 开关先打印目标路径进行核对。
二、Excel 自动化读取与单元格级处理
整理好文件后,下一步是对 Excel 文件内部的数据进行程序化存取。在 Python 生态中,处理现代 .xlsx 格式的标准利器是 openpyxl。与简单的 CSV 文件不同,Excel 是一个复合格式,包含工作簿(Workbook)、工作表(Worksheet)、单元格(Cell)以及样式、公式和图表等属性。
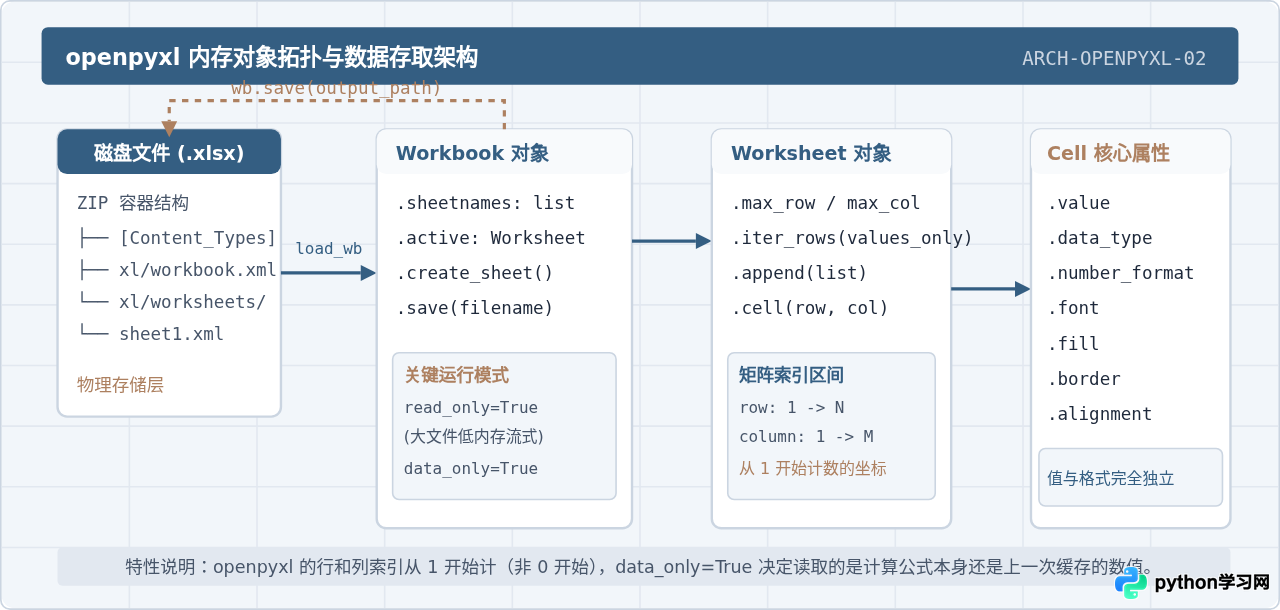
2. 精确读取与格式保留处理
很多初学者在写脚本时直接全部转为 Pandas DataFrame,但如果需要保留原表格的公式、标题格式、数字货币符号或在指定单元格插入统计函数,使用 openpyxl 的单元格 API 更加精准可靠。
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side

def process_single_report(file_path: str):
    # data_only=False 保留单元格内原始公式,若需获取上次保存的计算值可设为 True
    wb = openpyxl.load_workbook(file_path, data_only=False)
    sheet = wb.active

    print(f"当前工作表: {sheet.title}, 最大行数: {sheet.max_row}, 最大列数: {sheet.max_column}")

    # 1. 遍历有效数据行(假设第1行为表头,从第2行开始)
    total_sales = 0.0
    for row_idx in range(2, sheet.max_row + 1):
        product_name = sheet.cell(row=row_idx, column=1).value
        price = sheet.cell(row=row_idx, column=2).value
        qty = sheet.cell(row=row_idx, column=3).value

        # 数据清洗:跳过空行
        if product_name is None:
            continue

        # 类型校验与容错
        try:
            price_val = float(price) if price is not None else 0.0
            qty_val = int(qty) if qty is not None else 0
        except (ValueError, TypeError):
            print(f"[警告] 第 {row_idx} 行数据类型异常: price={price}, qty={qty}")
            continue

        subtotal = price_val * qty_val
        total_sales += subtotal

        # 在第 4 列写入金额计算结果
        sheet.cell(row=row_idx, column=4, value=subtotal)

    # 2. 写入汇总行与 Excel 公式
    summary_row = sheet.max_row + 1
    sheet.cell(row=summary_row, column=1, value="合计金额")
    # 写入动态 Excel SUM 函数
    sheet.cell(row=summary_row, column=4, value=f"=SUM(D2:D{summary_row - 1})")

    # 3. 设置美化样式(字体、背景色、边框)
    header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")
    header_fill = PatternFill(start_color="345E82", end_color="345E82", fill_type="solid")
    thin_border = Border(
        left=Side(style="thin", color="CBD5E1"),
        right=Side(style="thin", color="CBD5E1"),
        top=Side(style="thin", color="CBD5E1"),
        bottom=Side(style="thin", color="CBD5E1")
    )

    # 调整合计行样式
    for col_idx in range(1, 5):
        c = sheet.cell(row=summary_row, column=col_idx)
        c.font = Font(name="微软雅黑", size=11, bold=True, color="1E293B")
        c.border = thin_border
        c.alignment = Alignment(horizontal="right", vertical="center")

    wb.save(file_path)
    print(f"文件处理完毕并保存: {file_path}")
三、多源 Excel 数据合并与统一汇总报表
办公场景中最常见、也是最枯燥的痛点,是将下属机构、不同门店或不同月份的多张结构相同或相近的 Excel 表格合并成一张“总表”。
多表合并的难点通常不在于代码行数,而在于数据异构:有些表缺列,有些表列顺序被颠倒,有些表表头包含合并单元格。为了确保合并结果精准无误,标准流水线应包含:动态表头对齐、行规范校验、数据清洗转换与总表回写。
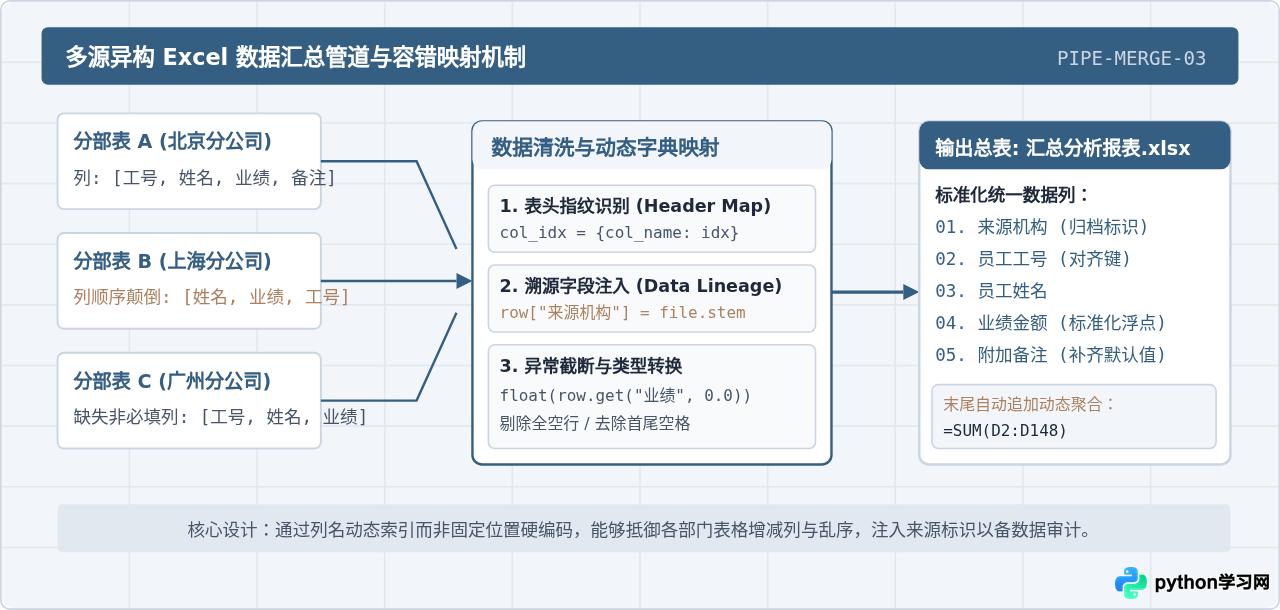
3. 健壮的多表动态合并实战脚本
下面给出一段能够抵抗列顺序错位、自动提取来源文件名作为新列、并自动生成带样式汇总总表的工程化实现:
from pathlib import Path
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side

def merge_excel_files(input_folder: str, output_filepath: str):
    folder = Path(input_folder)
    excel_files = [f for f in folder.glob("*.xlsx") if not f.name.startswith("~$")]

    if not excel_files:
        print("[提示] 目录下未找到需要合并的 Excel 文件。")
        return

    # 定义总表的标准输出列名清单
    target_headers = ["来源机构", "工号", "姓名", "业绩金额", "备注"]

    # 创建目标工作簿
    target_wb = openpyxl.Workbook()
    target_sheet = target_wb.active
    target_sheet.title = "销售汇总总表"

    # 写入总表表头
    target_sheet.append(target_headers)

    total_rows_imported = 0

    for file_path in excel_files:
        print(f"正在读取: {file_path.name} ...")
        # 以 read_only 模式快速扫描表头
        src_wb = openpyxl.load_workbook(file_path, data_only=True)
        src_sheet = src_wb.active

        # 1. 建立源文件表头与列索引的映射字典
        header_map = {}
        for col_idx in range(1, src_sheet.max_column + 1):
            val = src_sheet.cell(row=1, column=col_idx).value
            if val is not None:
                header_map[str(val).strip()] = col_idx

        # 2. 检查关键列是否存在
        if "姓名" not in header_map or "业绩金额" not in header_map:
            print(f"[跳过] 文件缺少关键列: {file_path.name}")
            src_wb.close()
            continue

        # 3. 逐行提取并映射为标准目标行
        file_branch_name = file_path.stem.split("_")[0]  # 例如从 "北京_1月.xlsx" 中提取 "北京"
        for row_idx in range(2, src_sheet.max_row + 1):
            name_val = src_sheet.cell(row=row_idx, column=header_map["姓名"]).value
            if not name_val:  # 空白行忽略
                continue

            emp_id = src_sheet.cell(row=row_idx, column=header_map.get("工号", 0)).value if "工号" in header_map else "--"
            raw_sales = src_sheet.cell(row=row_idx, column=header_map["业绩金额"]).value
            note_val = src_sheet.cell(row=row_idx, column=header_map.get("备注", 0)).value if "备注" in header_map else ""

            # 转换数值类型
            try:
                sales_val = float(raw_sales) if raw_sales is not None else 0.0
            except (ValueError, TypeError):
                sales_val = 0.0

            # 组装符合 target_headers 顺序的新行
            standard_row = [
                file_branch_name,
                str(emp_id).strip(),
                str(name_val).strip(),
                sales_val,
                str(note_val).strip()
            ]
            target_sheet.append(standard_row)
            total_rows_imported += 1

        src_wb.close()

    # 4. 美化总表格式与自动计算总和
    header_fill = PatternFill(start_color="345E82", end_color="345E82", fill_type="solid")
    header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")

    for col in range(1, len(target_headers) + 1):
        cell = target_sheet.cell(row=1, column=col)
        cell.fill = header_fill
        cell.font = header_font
        cell.alignment = Alignment(horizontal="center", vertical="center")

    # 末尾加入求和公式行
    sum_row = target_sheet.max_row + 1
    target_sheet.cell(row=sum_row, column=1, value="全国总计")
    target_sheet.cell(row=sum_row, column=4, value=f"=SUM(D2:D{sum_row - 1})")

    # 调整列宽
    for col in target_sheet.columns:
        max_len = max(len(str(cell.value or "")) for cell in col)
        col_letter = openpyxl.utils.get_column_letter(col[0].column)
        target_sheet.column_dimensions[col_letter].width = max(max_len + 4, 12)

    target_wb.save(output_filepath)
    print(f"合并完成!共导入 {total_rows_imported} 行记录,输出目标文件: {output_filepath}")

if __name__ == "__main__":
    merge_excel_files("./branch_data", "./汇总结果_全国.xlsx")
四、生产环境防错与工程化保障
自动化脚本在开发机上运行良好,但一旦迁移到生产环境或交给非技术同事使用时,经常会遇到各种意外情况:例如 Excel 正在被某位用户打开导致读写文件锁死、网络驱动器中断、或者非法字符导致程序崩溃。要让自动化脚本真正可用,必须建立容错闭环。
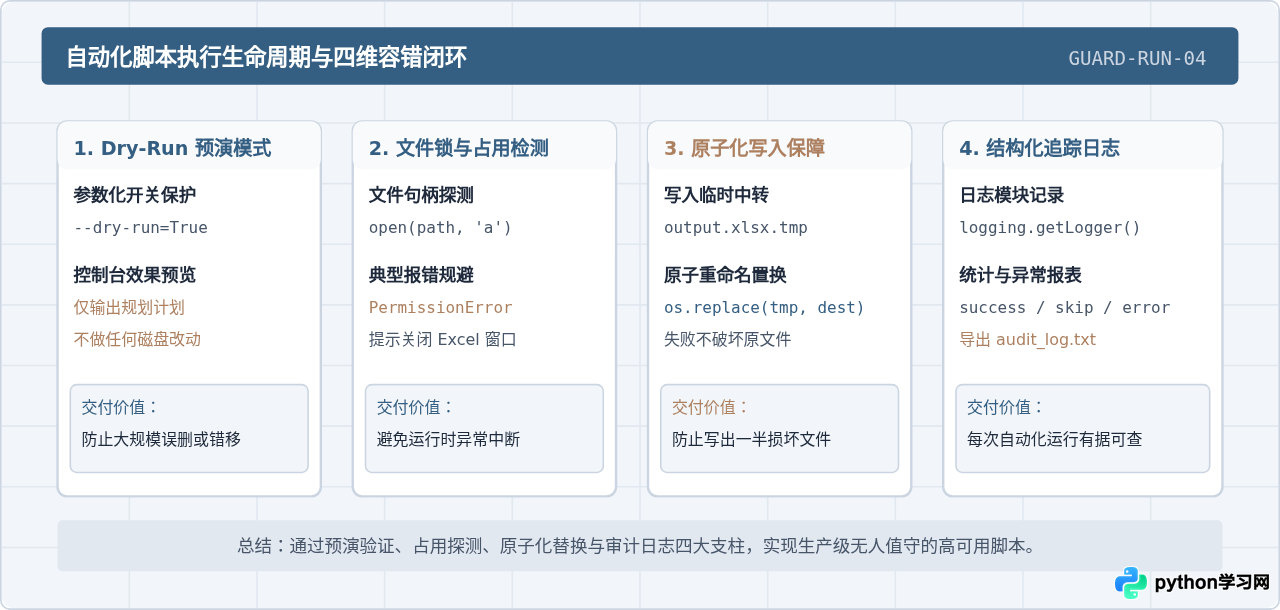
4. 常用异常规避指南
- 文件占用冲突(PermissionError):在 Windows 环境下,若某个目标 Excel 文件正在被 Excel 客户端软件打开,Python 尝试写入时会直接抛出
PermissionError: [Errno 13] Permission denied。在写入前,可通过尝试以追加模式打开文件句柄的方式提前探测,并给出友好的人性化提示:“请先关闭正在打开的 Excel 表格后重试”。 - 公式与数值的取舍:使用
openpyxl.load_workbook(path, data_only=True)读取时,单元格若是公式,则返回公式上次在 Excel 中被计算并保存的结果;若该文件是第三方程序直接生成但从未在 Excel 中打开计算保存过,data_only=True可能会读到None。如需读取公式文本本身,需设为data_only=False。 - 大数据量内存消耗(OOM):当 Excel 表格超过数万行时,常规模式会将全部 XML 结构载入内存形成对象树。此时应开启
openpyxl.load_workbook(path, read_only=True),它采用流式生成器逐行读取,内存占用始终保持在平稳的几兆字节,大幅降低资源开销。
五、实战总结
编写 Python 办公自动化脚本的核心逻辑可以概括为一个清晰的管道模型:定义文件模式 -> 安全定位筛选 -> 动态提取与结构清洗 -> 规范化回写与容错保护。利用标准库 pathlib 统一管理文件生命周期,结合 openpyxl 的强大单元格控制力,不仅能在一秒钟内完成过去需要半天的人工重复劳动,还能彻底消除人工合并时的错位与遗漏,为企业日常数字化办公提供稳定可靠的基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









