

Python写入文件时newline参数的作用及避免多余空行
详细解析Python在写入文件时open函数的newline参数机制,剖析Windows平台下CSV写入多余空行的根本原因,并提供切实可行的解决步骤与跨平台最佳实践。
在 Python 3 中使用内置的 open() 函数写入文本文件时,开发者常常会遇到生成的文件在 Windows 文本编辑器中每行之间多出一个空行的问题。这一现象在配合 csv.writer 写入表格数据时尤为频繁。该问题的根源并非系统故障,而是 Python 默认的通用换行符转换机制与模块自身的行尾写入逻辑相互叠加所致。通过在 open() 中显式指定 newline='',可以精准控制底层输出流的换行行为,彻底消除多余空行。
一、newline 参数在写入模式下的基本转换机制
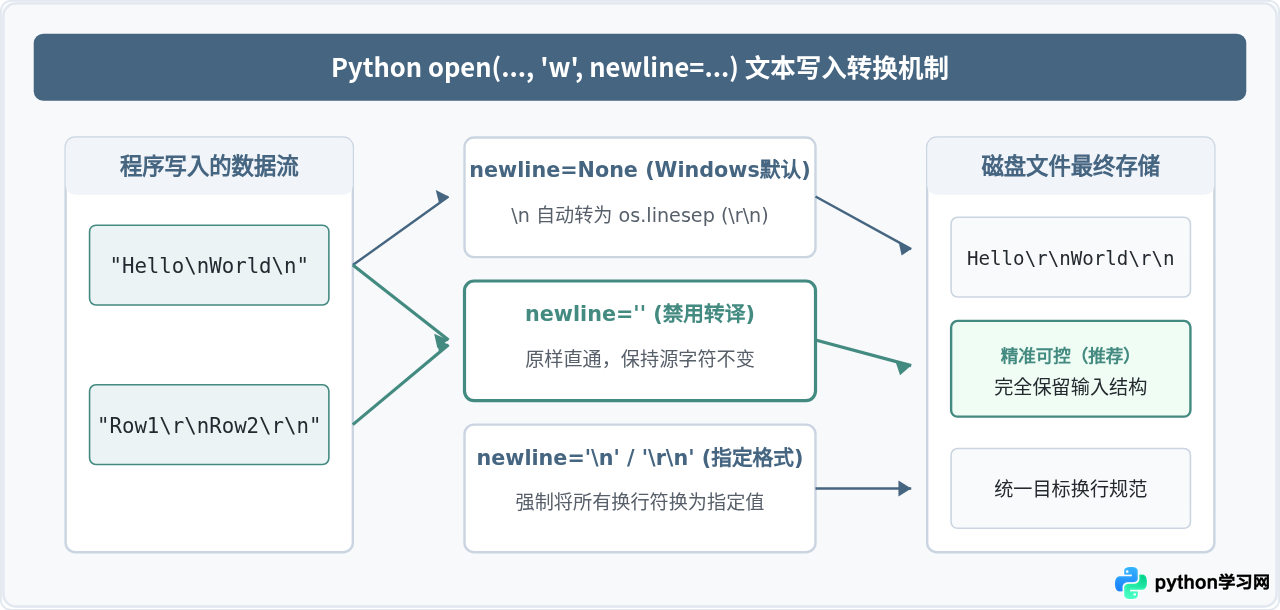
在默认文本模式(mode='w' 或 mode='a')下,Python 提供了通用换行符支持。调用 open(filename, 'w') 时,参数 newline 的默认值为 None。不同的 newline 参数值决定了向文件写入换行符时,底层运行时是否介入修改:
newline=None(系统默认):任何写入流的\n字符,都会被自动转译为目标操作系统的原生行分隔符(即os.linesep)。在 Windows 系统上,\n会被翻译成\r\n(回车符 + 换行符);在 Linux 和 macOS 上,\n保持为\n。newline=''(禁用转译):关闭换行符翻译功能。程序传入流的字符直接原样输出到底层文件。传入\n就写出\n,传入\r\n就写出\r\n,不作任何自动替换。newline='\n'或newline='\r\n'(指定特定字符):无论程序传入的是\n还是其它换行符号,统一被转换为指定的字符串写入。常用于强制生成符合特定操作系统规范的文件。
二、CSV 写入时多余空行的产生原因与解决对策
多余空行最常发生的场景是使用标准库 csv 模块。在编写如下典型代码时:
import csv

# 未指定 newline 的错误写法
with open('data.csv', 'w', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(['ID', 'Name'])
    writer.writerow(['1', 'Alice'])
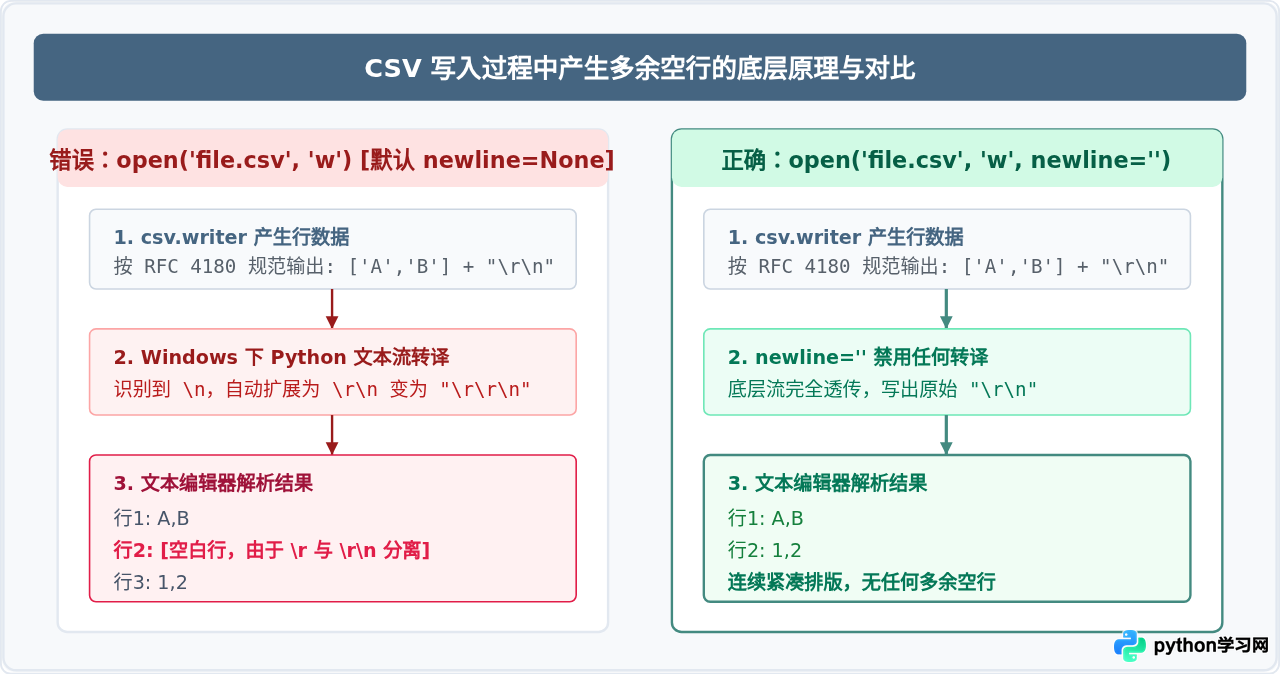
如果此代码在 Windows 上运行,生成的文件在 Excel、记事本或 VS Code 中打开时,每一行数据之间都会出现一个空白行。其背后原因为:
- 根据通用 CSV 规范(RFC 4180),CSV 行结束符规定为 CRLF(即
\r\n)。因此,csv.writer在写入一行时,默认会在末尾追加\r\n。 - 在 Windows 平台上,由于
open()默认newline=None,Python 文本流会将遇到的\n字符转义为操作系统的换行符\r\n。 - 此时,
csv.writer传入的\r\n中的\n被拦截并转换成了\r\n,最终写入文件的物理字符序列变成了\r\r\n。 - Windows 文本处理程序遇到第一个
\r时执行光标回车,紧随其后的\r\n被解析为一个完整的换行符,从而在屏幕上渲染出一个多余的空行。
Python 官方文档在 csv.writer 说明中明确规定:在以文本模式打开供 csv.writer 写入的文件时,必须传入 newline='',否则跨平台的行尾转译会导致空行或格式损坏。
三、排查与避免多余空行的操作步骤
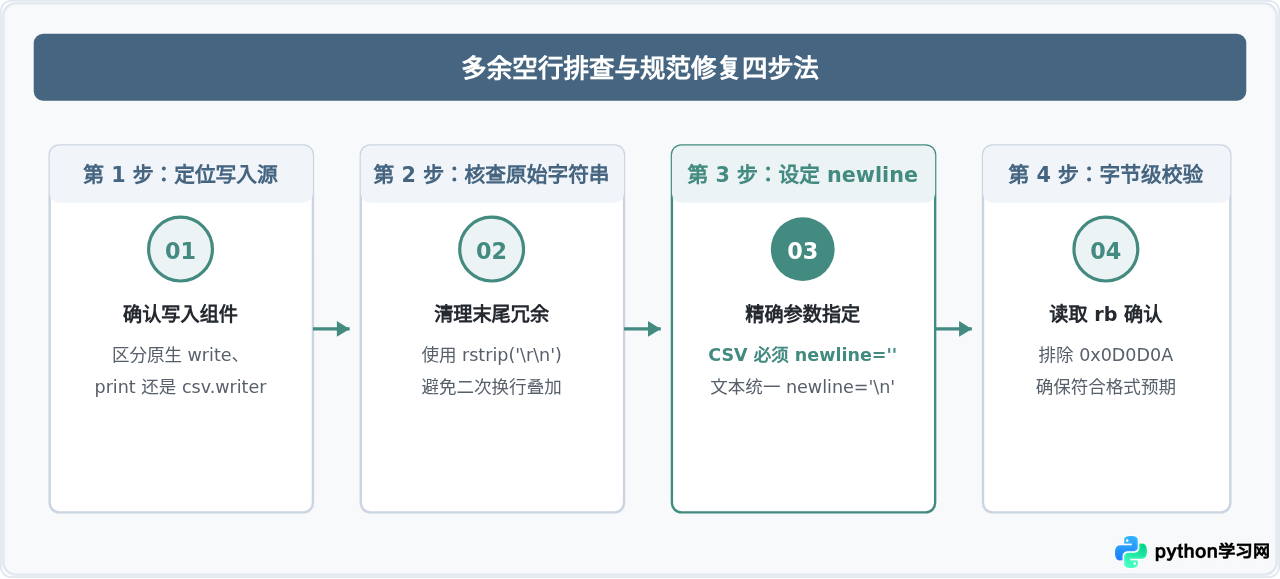
当在项目中发现生成的文件存在异常空行时,可以通过以下四个标准化步骤进行诊断与修复:
- 确认写入工具与文件格式:检查是使用原生
file.write()、print(..., file=f)还是csv.writer或第三方库(如 pandas)。对于 CSV 写入,首要检查是否缺少newline=''。 - 审查输入数据的换行符:如果写入的字符串本身来源于网络请求、剪贴板或已有文件读取,字符串尾部可能已经包含了
\r\n或\n。直接拼接\n或搭配print()会造成二次换行。 - 显式配置 open() 参数:根据业务需求显式指定
newline。跨平台项目通常推荐指定newline=''保留字符原样,或指定newline='\n'统一使用 LF 格式。 - 十六进制工具或二进制读取验证:使用
mode='rb'打开生成的文件读取二进制字节,确认文件末尾是0D 0A(CRLF)还是0D 0D 0A(CRCRLF)。
四、实际代码范例与最佳实践
1. 正确写入 CSV 文件
为确保在 Windows、macOS 和 Linux 上都能生成规范、无空行的 CSV 文件,始终在 open() 中显式传入 newline='' 和 encoding='utf-8':
import csv

data = [
    ['Name', 'Department', 'Score'],
    ['Zhang San', 'Engineering', '95'],
    ['Li Si', 'Marketing', '88']
]

# 推荐的标准写入模式:newline='' 防止自动转译二次叠加
with open('output_standard.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerows(data)
2. 跨平台纯文本写入:统一换行符标准
在跨平台协作(例如团队成员分别使用 Windows 与 Linux)时,Git 仓库常要求代码及日志文件统一使用 LF(\n)换行符。此时通过指定 newline='\n',即使在 Windows 环境下运行代码,也不会写出 \r\n:
lines = ["第一行日志内容", "第二行日志内容", "第三行日志内容"]

# 统一强制以 LF (\n) 写入文本文件,避免产生 Windows CRLF 差异
with open('server.log', 'w', newline='\n', encoding='utf-8') as f:
    for line in lines:
        f.write(line + '\n')
3. 数据源自带换行符时的清理处理
当处理从外部 API 或旧文件读取的数据时,每条记录尾部可能已带换行符。如果直接调用 print(..., file=f),print() 默认的 end='\n' 会导致双重换行:
raw_records = ["Record A\r\n", "Record B\r\n"]

with open('clean.txt', 'w', newline='', encoding='utf-8') as f:
    for item in raw_records:
        # 去除原有的尾部回车换行符后,再精准写入
        f.write(item.rstrip('\r\n') + '\n')
五、newline 参数选型场景对照与决策总结
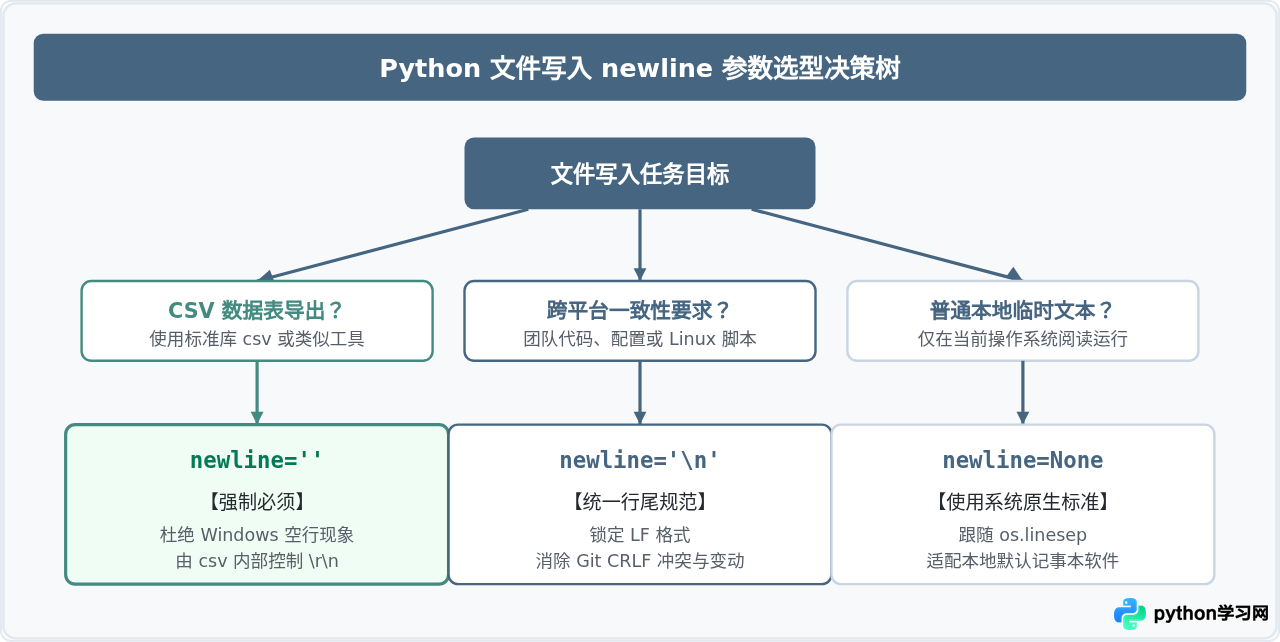
不同的应用场景对换行符的控制粒度需求不同。下表与架构决策图总结了各场景下的参数选择依据:
| 参数配置 | 写入转换规则 | 典型适用场景 | 常见风险与注意事项 |
|---|---|---|---|
newline='' |
不作任何转换,原样透传 | csv.writer 写入、需要字节级保真的文本协议输出 |
需由开发者自行保证写入字符串的换行符符合格式规范 |
newline=None(默认) |
将 \n 转换为 os.linesep |
生成只在本地操作系统消费的纯文本便签、控制台日志 | 在 Windows 下配合 CSV 写入会导致出现空行(\r\r\n) |
newline='\n' |
将所有换行符转换为 \n(LF) |
跨平台项目、Linux 部署脚本、Git 受控文本文件 | Windows 旧版记事本(Win10早期前)可能不自动折行显示 |
newline='\r\n' |
将所有换行符转换为 \r\n(CRLF) |
必须严格兼容 Windows 遗留客户端或特定硬件格式 | 非 Windows 开发者阅读时可能出现行尾 ^M 符号 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









