

大规模数据采集用哪个Python框架?Scrapy分布式爬虫解析

在面对千万级、甚至亿级网页的大规模数据采集任务时,单机爬虫程序往往会迅速遭遇吞吐量瓶颈、内存溢出以及单点故障无法恢复等问题。在众多 Python 解决方案中,Scrapy 结合其分布式扩展组件 Scrapy-Redis,是目前工业级大规模抓取场景下架构成熟、运维透明且成本可控的优选方案。本文将围绕框架选型依据、Scrapy-Redis 协同工作机制、具体代码与配置改造步骤,以及高并发环境下的关键避坑点进行完整拆解。
一、Python 常见采集工具横向选型与场景定位
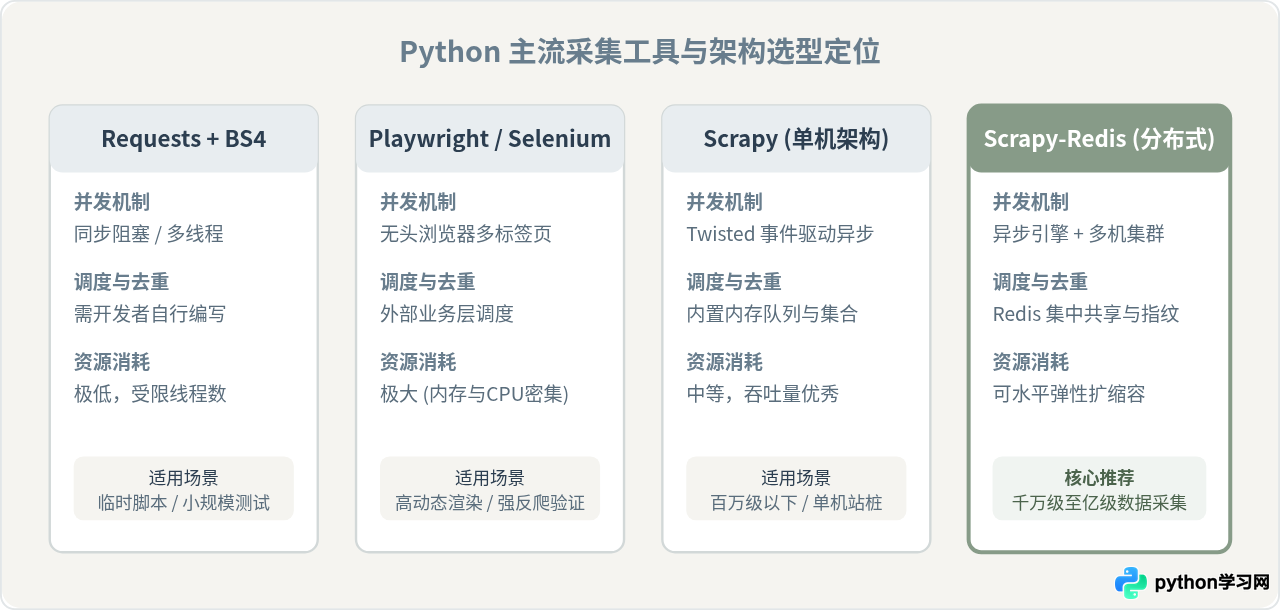
在 Python 生态中,针对网页抓取的工具主要分为三类:以 Requests 或 httpx 搭配 BeautifulSoup/lxml 为代表的脚本级组合、以 Playwright 或 Selenium 为代表的无头浏览器自动化框架,以及以 Scrapy 为代表的工业级异步爬虫框架。面对大规模数据采集,工具之间的关键差异并不在于语法是否简短,而在于其调度机制、并发模型以及资源开销控制能力。
Requests 属于阻塞式同步请求模型,如果需要提高并发,开发者通常需要手动维护线程池或进程池。在大规模抓取场景下,这种模式不仅需要自行实现 URL 去重、错误重试与持久化管道,且线程上下文切换开销巨大。Playwright 和 Selenium 则启动真实浏览器内核渲染页面,虽然可以原生执行 JavaScript,但单个页面渲染内存占用动辄上百兆,CPU 占用极高,通常只作为特定反爬页面或复杂交互的补充工具,不适合作为千万级数据的通用主力引擎。
Scrapy 基于 Twisted 异步网络框架构建,采用纯事件驱动架构,在单进程内就能维持数百个并发连接,网络 I/O 效率极高。但单机版 Scrapy 的调度队列与指纹集合均存储在本地内存中,无法跨服务器共享。由此延伸出的 Scrapy-Redis 则通过引入 Redis 作为集中式调度中心,实现了真正的横向弹性扩展。
二、Scrapy 单机与 Scrapy-Redis 分布式的关键差异
理解为什么选择分布式架构,关键在于明确单机爬虫在大数据量下的物理限制:
- 内存与去重瓶颈:单机 Scrapy 在抓取过程中,将所有请求对象的 SHA1 指纹保存在本地内存的 Set 集合中。当 URL 数量达到数千万甚至数亿时,单机内存消耗极大。一旦机器发生断电或进程异常退出,内存指纹丢失,重新启动通常意味着从零开始或产生大量重复下载。
- 带宽与单 IP 并发上限:单台服务器的上行与下行带宽是固定的。更重要的是,单台机器对外发起请求的出口 IP 往往单一,极易触发目标站点的封锁策略。分布式架构允许将抓取节点分散在不同机器甚至不同可用区,分散出口流量。
- 任务动态调配与故障隔离:单机爬虫若是崩溃,整个任务直接中断。在分布式架构中,工作节点(Worker)完全无状态化,任意一台节点发生故障退出,其余节点仍会继续从中央队列提取任务,不影响整体进度。
三、Scrapy-Redis 分布式协同工作机制
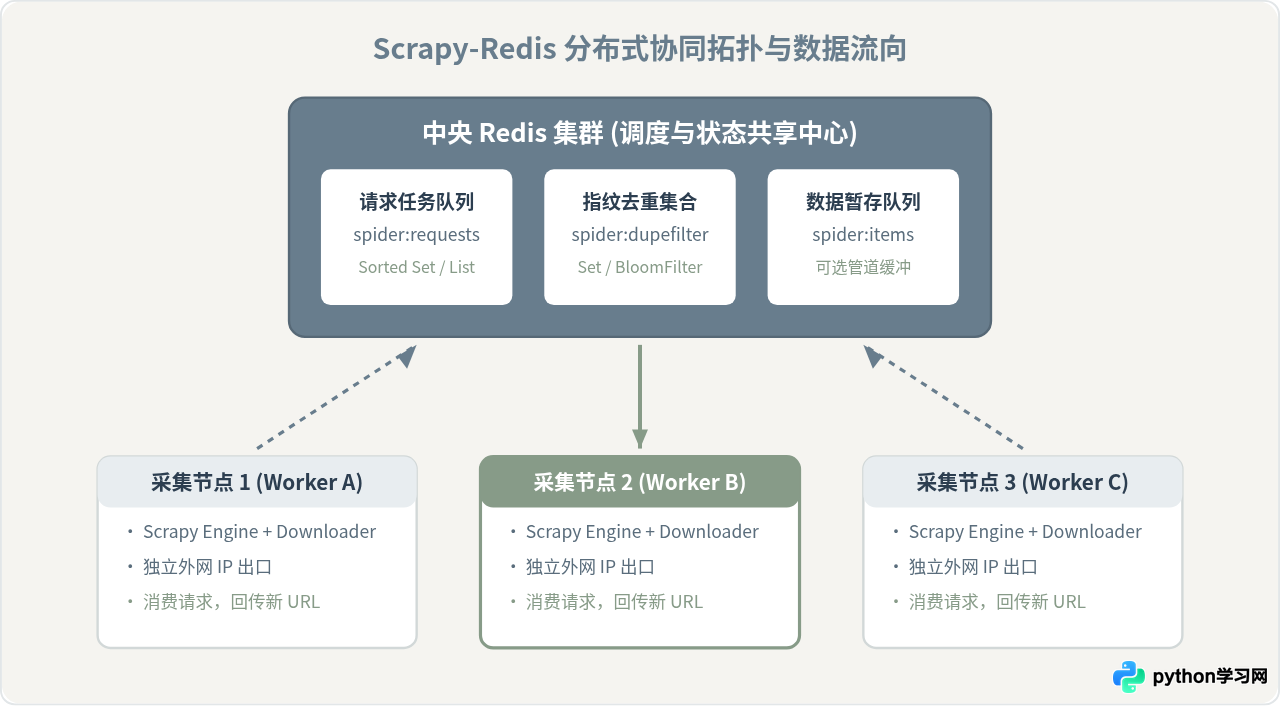
Scrapy-Redis 并不是重写了 Scrapy,而是通过实现 Scrapy 的几个核心接口(Scheduler 调度器、Dupefilter 去重器、Pipeline 数据管道),将原本保存在本地内存的数据结构重定向到了 Redis 数据库中。
整个系统的运转包含三个核心支柱:
- 共享请求队列(Requests Queue):Redis 的 List 或 Sorted Set 结构用于存放待抓取的 Request 对象。所有工作节点通过非阻塞或阻塞式的弹出命令(如 RPOP 或 BLPOP)从同一个队列获取任务。
- 中央指纹去重器(DupeFilter):当 Spider 生成新的 URL 请求时,去重器会根据请求的 Method、URL、Body 等信息计算唯一指纹(默认采用 SHA1 散列),并存入 Redis 的 Set 集合中。如果指纹已存在,该请求会被直接丢弃,确保多节点协同作业时不重复抓取。
- 集中式结果汇聚(Item Pipeline):各节点解析出来的结构化数据(Item),既可以直接在本地写入目标数据库(如 MongoDB、MySQL),也可以直接推入 Redis 的统一结果队列,由专门的数据消费服务统一落库,实现抓取与存储解耦。
四、Scrapy 分布式系统改造与实施步骤
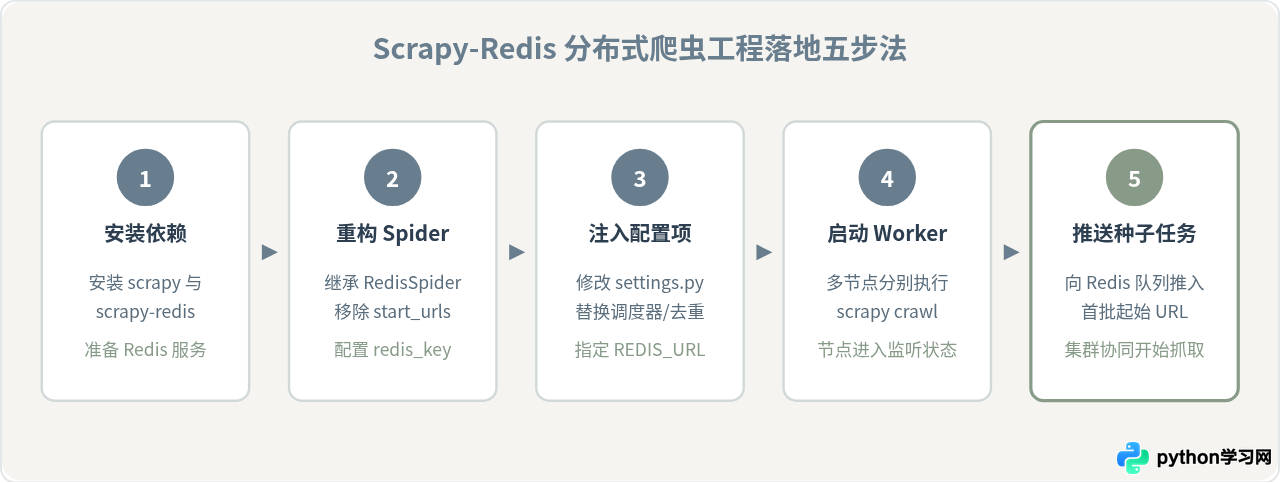
将一个现有的单机 Scrapy 项目改造成支持分布式协同的集群,核心流程分为五个具体步骤:安装运行依赖、修改爬虫基类、注入分布式配置、推入种子 URL 以及多节点集群启动。
步骤一:安装核心依赖
在所有参与分布式采集的服务器节点上,统一安装 Scrapy 及 Scrapy-Redis 依赖库:
pip install scrapy scrapy-redis redis步骤二:重构爬虫代码文件
打开项目中的爬虫文件(例如 spiders/myspider.py)。传统的单机爬虫继承自 scrapy.Spider 并定义静态的 start_urls;改造后需继承 scrapy_redis.spiders.RedisSpider,并指定一个动态监听的 redis_key:
import scrapy
from scrapy_redis.spiders import RedisSpider

class DistributedProductSpider(RedisSpider):
    name = "distributed_products"

    # 动态监听 Redis 中该键名下的 URL 列表
    redis_key = "distributed_products:start_urls"

    def parse(self, response):
        # 1. 解析目标数据项
        for item_node in response.css("div.product-item"):
            yield {
                "title": item_node.css("h2.title::text").get(),
                "price": item_node.css("span.price::text").get(),
                "url": response.urljoin(item_node.css("a::attr(href)").get()),
            }

        # 2. 提取下一页请求并继续跟进 (自动通过 Scrapy-Redis 去重排队)
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
步骤三:修改项目配置文件 settings.py
在项目的全局配置文件 settings.py 中,替换原生的调度器与去重器组件,并配置持久化与 Redis 连接参数:
# 1. 替换默认调度器为 Scrapy-Redis 调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 2. 替换默认去重类为基于 Redis 的去重组件
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 3. 开启任务持久化状态 (关闭爬虫后 Redis 队列和指纹不自动清空,支持断点续爬)
SCHEDULER_PERSIST = True

# 4. 指定 Redis 连接地址 (格式: redis://[:password@]host:port/db)
REDIS_URL = "redis://192.168.1.100:6379/0"

# 5. 可选:启用 Scrapy-Redis 内置的 Item Pipeline (统一写入 Redis 的 items 队列)
ITEM_PIPELINES = {
    "scrapy_redis.pipelines.RedisPipeline": 300,
}
步骤四与步骤五:启动节点与注入种子
在所有 Worker 节点服务器上,分别进入项目目录并执行常规抓取命令:
scrapy crawl distributed_products启动后,各个 Worker 节点的控制台会输出监听日志,显示正在等待 Redis 键 distributed_products:start_urls 中的初始链接。随后,在任意能够连通 Redis 的终端上执行推送命令:
# 示例:通过 redis-cli 注入起始爬取种子
redis-cli -h 192.168.1.100 lpush distributed_products:start_urls "https://example.com/category/1"
一旦种子进入 Redis,其中一个空闲 Worker 节点会立刻将其取出并触发请求,解析到的新链接会自动经过指纹去重后重新推入任务队列,所有 Worker 节点将协同展开高吞吐抓取。
五、大规模分布式采集生产保障与调优
在实际生产环境中,当抓取量级攀升至数千万级别时,单纯依赖默认配置很容易导致 Redis 内存耗尽或遭遇目标站点反爬封禁。以下四项保障策略是在工程落地中必须考虑的核心点:
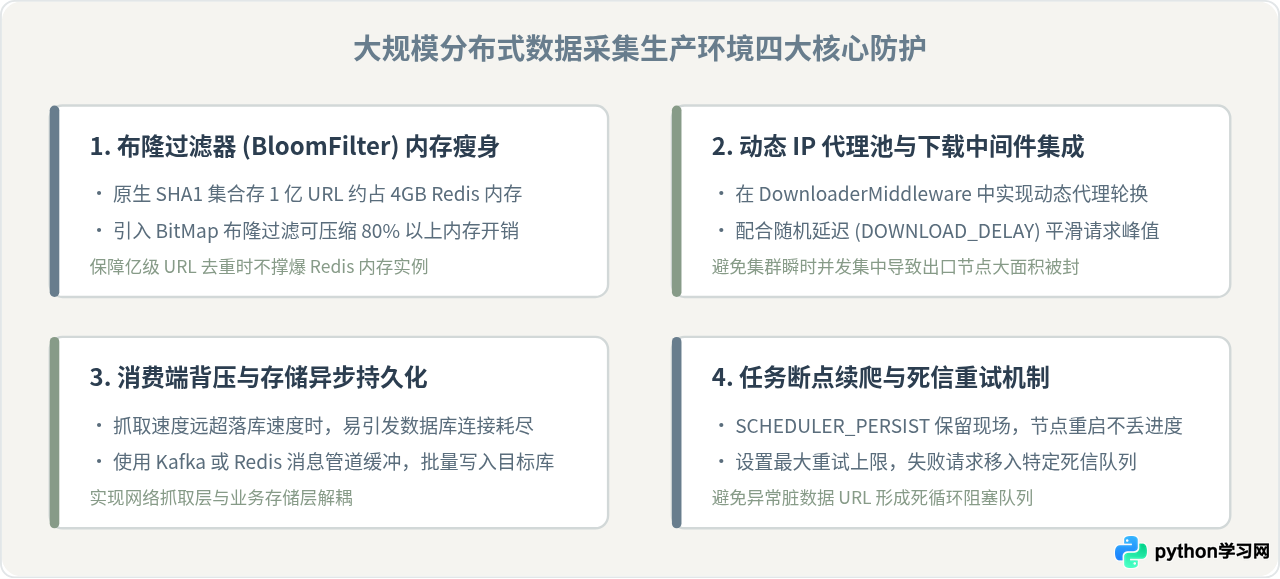
注意内存增长:在默认情况下,Scrapy-Redis 会将每个 URL 的 SHA1 哈希值完整存入 Redis Set 集合中。一个指纹占用大约 40 字节,当累积达到 1 亿个 URL 时,仅去重集合就需消耗约 4GB 纯内存。如果在极大规模场景下运行,建议引入基于位图(BitMap)的 BloomFilter 去重中间件(例如开源的 scrapy-redis-bloomfilter),能将内存占用压缩至原本的十分之一以下。
六、总结与决策建议
综上所述,针对大规模数据采集的框架选型,核心结论可以总结如下:
- 对于十万级以下、结构简单、无动态 JS 阻碍的小型抓取任务,使用 Requests/httpx 配合线程池即可快速交付,无需搭建繁重的分布式中间件。
- 对于重度依赖前端渲染、存在强滑块验证码或复杂 Canvas 交互的网站,建议使用 Playwright 集群作为渲染微服务,专门提供已渲染的 HTML,避免无头浏览器直接处理海量翻页。
- 对于千万级至亿级网页、强调吞吐量、规范化管道处理与高容灾性的大规模数据采集任务,Scrapy + Scrapy-Redis 是 Python 生态中架构最成熟、社区方案最完善的标准解法。它既保留了 Scrapy 强大的异步处理与中间件扩展能力,又借助 Redis 实现了无状态节点的横向扩展与断点续爬,是支撑工业级采集工程的坚实底座。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









