

常见反爬机制的技术原理:Python爬虫为何会被拦截?
深入剖析常见反爬机制的技术原理,从网络协议指纹、请求头检测、IP频控算法到浏览器环境探针与行为风控,全面解析Python爬虫被拦截的底层原因与排查思路。
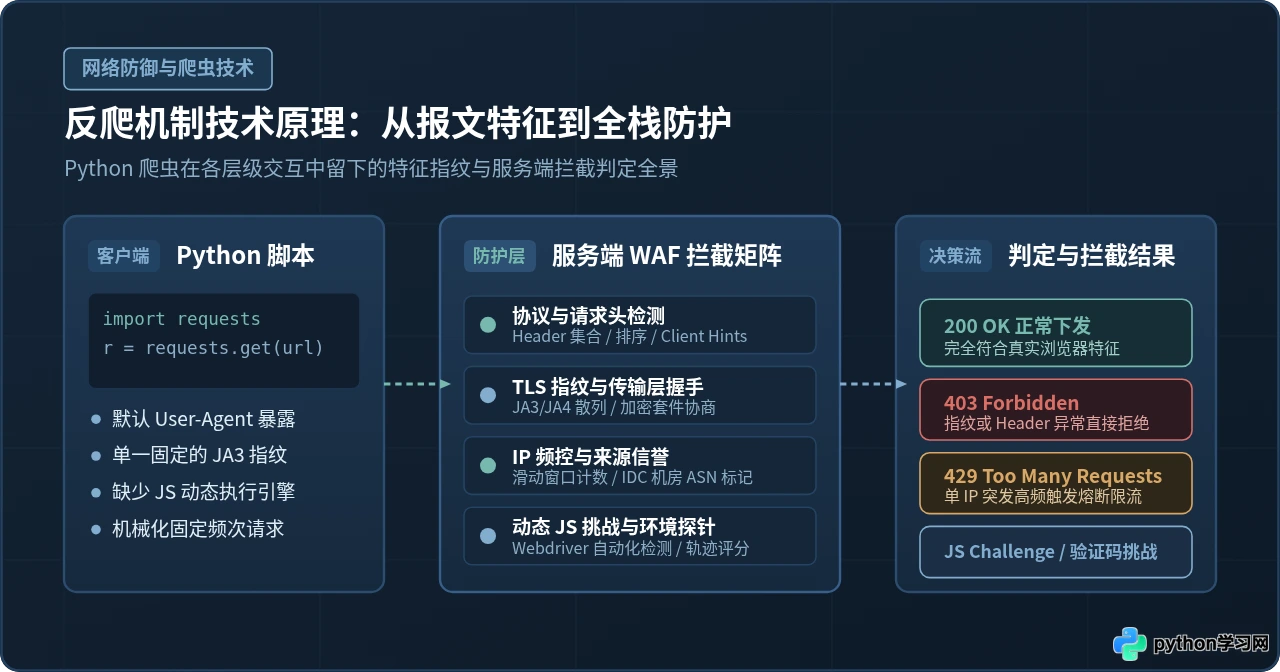
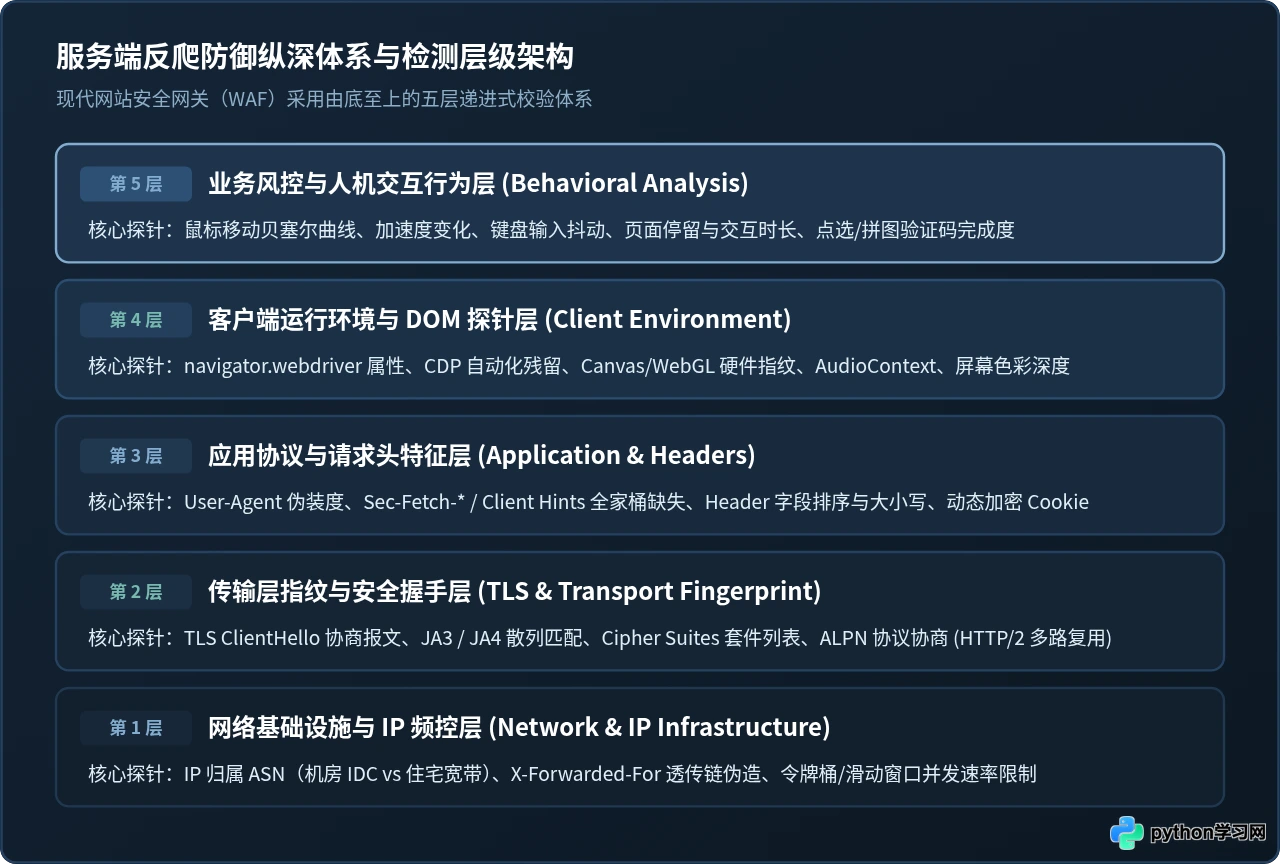
requests.get("https://example.com/data") 抓取公开数据时,经常会遇到直接返回 403 Forbidden、429 Too Many Requests,或是拿到一段经过混淆的 JavaScript 验证脚本。许多人习惯于在代码中简单添加一行 headers={"User-Agent": "Mozilla/5.0..."},却发现仍然被瞬间阻断。现代反爬虫系统并非只依靠单一字段进行判断,而是在网络接入、传输层握手、应用层报文、客户端环境探针乃至行为统计等多个维度建立起的纵深防御体系。本文将深入拆解主流反爬机制的底层技术原理,帮助你理解 Python 爬虫在各个阶段暴露的技术指纹与服务端的拦截逻辑。
一、协议与请求头层:显式特征与身份伪装的瓦解
在 HTTP 协议的交互中,服务端最先接收到的是客户端主动提交的请求报文。许多初学者认为只要伪造了浏览器名字就能通过检测,但真实的 HTTP 交互远比一个字符串复杂得多。
1. 默认 User-Agent 的直接识别
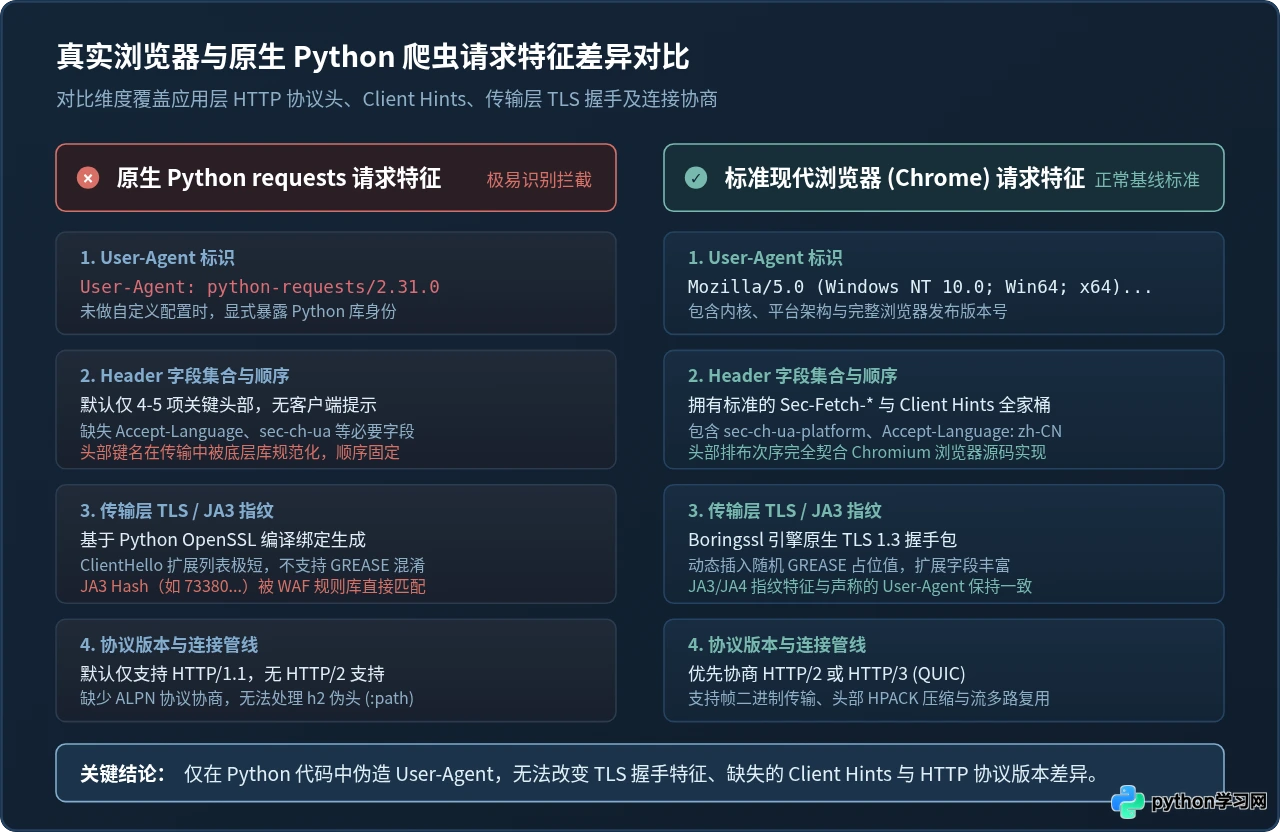
Python 常见 HTTP 客户端库在缺省状态下都有明确的内置标识。例如,requests 库的默认 Header 包含 User-Agent: python-requests/2.31.0,aiohttp 包含 Python/3.x aiohttp/3.x,Scrapy 包含 Scrapy/2.x (+https://scrapy.org)。商业 Web 应用防火墙(WAF)的首道规则就是对已知爬虫库的签名进行白名单或黑名单比对,一旦命中,直接返回 403 阻断。
2. 缺失的 Client Hints 与 Header 顺序特征
即使手动指定了主流浏览器的 User-Agent,现代现代 Chromium 内核浏览器在发起请求时还会伴随一系列结构化客户端提示(Client Hints)与防护标头:
sec-ch-ua、sec-ch-ua-mobile、sec-ch-ua-platform:用于声明浏览器品牌型号、移动端状态和操作系统架构。Sec-Fetch-Site、Sec-Fetch-Mode、Sec-Fetch-Dest:由浏览器底层安全模型严格注入,指示请求的跨域关系和资源去向。Accept-Language与Accept-Encoding:真实用户的浏览器会支持gzip, deflate, br, zstd,而原生 Python requests 默认不声明现代压缩算法(如 Brotli/zstd),且通常缺少语言偏好字段。
更为隐蔽的是 Header 字段的排列顺序。HTTP/1.1 虽然规范中对标头顺序不做严格限制,但主流浏览器内核(Chromium、WebKit、Gecko)在网络栈代码中都有各自固定的字段装配次序。许多基于 Go、Python 编写的脚本在通过哈希字典(Dict)传递请求头时,字段排序会发生打乱或呈现底层库特有的固定顺序,这会被高级 WAF 直接判定为“特征异常”。
3. 传输层 TLS 指纹与 JA3/JA4 算法
这是导致很多“明明 Headers 配得一模一样却依然被 403”的根本原因。在建立 HTTPS 连接时,客户端与服务端必须先进行 TLS 握手。客户端在发送的第一封 Client Hello 报文中,包含了:
- 支持的 TLS 协议版本(如 TLS 1.2 / TLS 1.3)
- 支持的加密套件列表(Cipher Suites)
- 支持的扩展功能(Extensions)
- 支持的椭圆曲线及签名算法(Supported Groups & EC Point Formats)
由于现代浏览器基于自己的 TLS 实现(例如 Chrome 使用 BoringSSL),其支持的加密套件组合非常丰富且支持动态 GREASE 占位值混淆。而 Python 的 urllib3 和 requests 是基于宿主机操作系统的 OpenSSL 库编译链接的。安全厂商(如 Salesforce 提出的 JA3 算法)将 Client Hello 中的版本、套件、扩展等字段提取出来用逗号连接,计算其 MD5 散列值。若一个声称是“Chrome 125”的请求,其 TLS JA3 指纹计算出来却是“Python-OpenSSL”,WAF 甚至不需要读取 HTTP 报文内容,在 TLS 握手握手完毕的毫秒级时间内就能直接阻断该 TCP 连接。
二、网络与 IP 频控层:访问速率与来源信誉度
当网络层和协议层无法直接断定客户端身份时,服务端会进一步通过来源 IP 维度进行统计学监控和访问限流。
1. 频控限流算法:令牌桶与漏桶机制
服务端通常在 Nginx、Envoy 或 Redis 缓存层部署高并发限流器,主流算法包括:
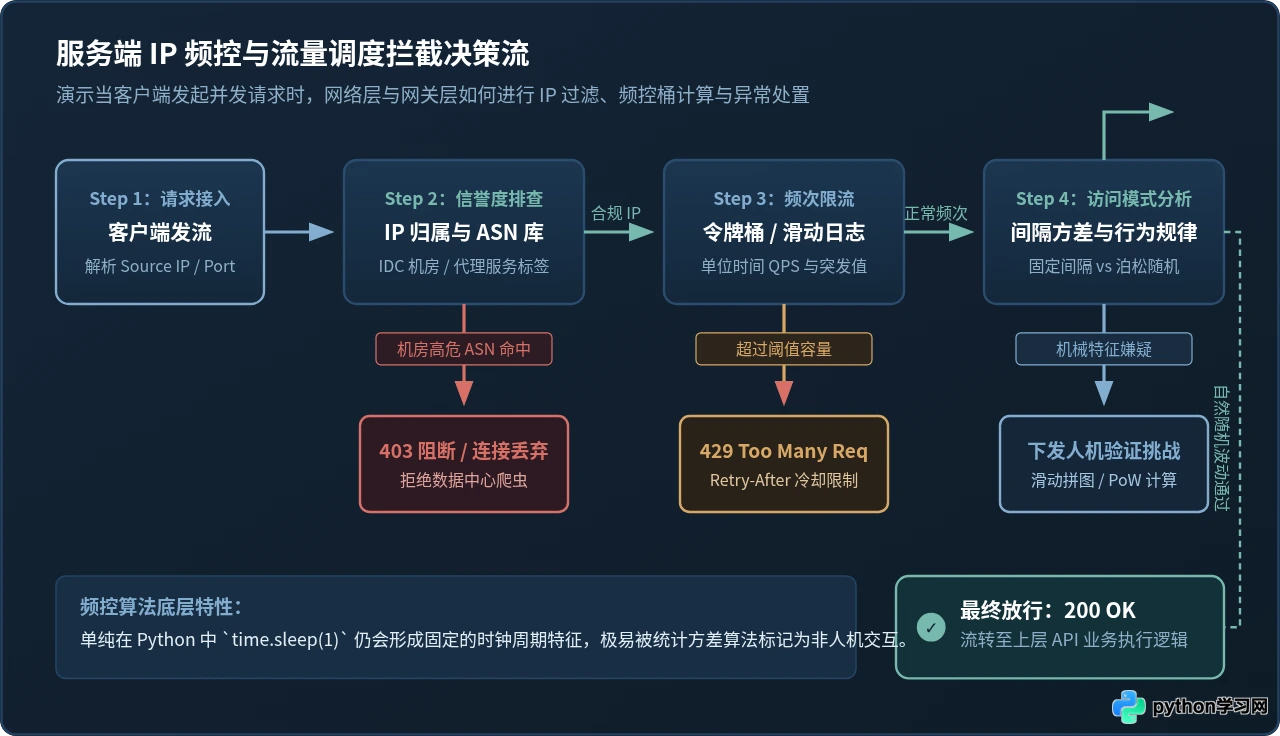
- 固定窗口与滑动窗口算法:限制单一 IP 在 1 秒或 1 分钟内的最大请求数(例如 10 次/秒)。如果短时间内超出上限,直接返回
429 Too Many Requests。 - 令牌桶算法(Token Bucket):以恒定速率向桶内放入令牌,请求需要获取令牌后才能被处理。虽然允许一定程度的突发流量(Burst),但无法承受爬虫程序高并发无休止的请求冲击。
2. 离散度与时钟特征检测
部分开发者为了避免触发频控,会在每次请求后加入 time.sleep(1)。然而,在反爬系统的统计模型中,机械式的固定时间间隔同样是极其醒目的非人特征。真实人类在浏览网页或点击分页时,由于阅读、移动鼠标、网络波动等因素,每次请求间隔具有天然的泊松分布(离散方差较大)。如果一个 IP 连续发出数十次请求,其间隔严格等于 1000 毫秒(方差接近 0),便会被风控策略打上自动化脚本标签。
3. IP 来源信誉与 ASN 标签
反爬网关会实时连接全球 IP 威胁情报数据库(如 MaxMind、IP2Location 等)。每个 IP 地址都归属于特定的自治系统编号(ASN):
| IP 类别 | 典型来源 (ASN 归属) | 安全信任评级 | WAF 策略偏向 |
|---|---|---|---|
| 数据中心 IP (IDC) | AWS、阿里云、腾讯云、DigitalOcean、Vultr | 低信任 (高危) | 高频限制严格,稍有可疑直接弹码或阻断 |
| 住宅宽带 IP (ISP) | 中国电信、中国联通、Comcast、AT&T | 高信任 (真实用户) | 容忍度较高,优先触发验证挑战而非直接封锁 |
| 移动基站 IP (Cellular) | 4G/5G 移动蜂窝网络(NAT 共享公网) | 极高信任 | 极少采取全 IP 封禁,防止误伤大批正常移动端用户 |
如果爬虫脚本部署在云服务器或便宜的机房代理节点上,哪怕请求频率很低,也极易由于数据中心 IP 的不良信誉而遭受重点关注。
三、客户端运行环境与 JavaScript 挑战:动态渲染背后的指纹
对于采用前后端分离或严格防护的网站,服务端返回的 HTTP 响应体并非最终数据,而是一段动态混淆的 JavaScript 脚本。如果客户端没有完整的 JavaScript 执行引擎与 DOM 树,就无法完成动态环境验证。
1. 动态 Cookie 与 Token 签名计算
典型机制如百度的安全验证、阿里云的“滑块/闪断防护(acw_sc__v2)”、Cloudflare 的 5 秒盾(Under Attack Mode / Turnstile)。服务端首次响应时返回 Set-Cookie: __initial=... 及一段加密代码。这段代码必须在客户端环境内解密并执行一段数学运算(如哈希碰撞或工作量证明 PoW),随后生成一个新的动态凭证(例如 token=xxx)存入 Cookie 或注入后续请求的自定义 Header 中。单纯依靠 requests 无法执行 JS,自然无法完成下一轮通信。
2. 浏览器自动化特征探测(WebDriver)
当开发者尝试使用 Selenium、Puppeteer 或 Playwright 驱动真实浏览器访问时,反爬脚本会通过注入的 JavaScript 探针探测浏览器底层特征:
navigator.webdriver属性:在默认自动化驱动下,该属性值为true,而普通浏览器下为undefined或false。- CDP (Chrome DevTools Protocol) 变量残留:自动化驱动在浏览器全局注入了一些专有方法和属性(例如
window.cdc_adoQpoasnfa76pfcZLmcfl_...或window.__webdriver_evaluate),脚本只需遍历全局变量即可察觉被自动化控制。 - 插件与语言列表异常:无头模式(Headless Chrome)在过去经常出现
navigator.plugins.length === 0或缺少字体渲染、显卡硬件信息等缺陷。
3. 硬件环境与画布指纹(Canvas & WebGL)
高级指纹技术(如 FingerprintJS)会在网页加载时静默创建一个隐藏的 <canvas> 画布,绘制包含复杂几何、色彩渐变与抗锯齿文字的图案,并提取其 Base64 图片数据。由于不同用户的操作系统、显卡硬件驱动(GPU)、字体光栅化渲染引擎存在微小差异,同一段绘图指令在不同设备上生成的像素哈希具有极高的唯一性。结合 WebGL 渲染器厂商信息(GL_RENDERER)和 AudioContext 音频频率响应曲线,服务端可以精准识别出即便清除 Cookie 也无法重置的“设备硬件唯一 ID”。
四、行为分析与人机验证(CAPTCHA):从静态特征到动态交互
在人机对抗的最前沿,静态特征的伪装已经越来越难以应对。现代防御引擎(如 Google reCAPTCHA v3、Cloudflare Turnstile、极验行为验证)将注意力转移到用户交互行为上。
1. 鼠标运动轨迹与物理学特征
真实人类在使用鼠标点击滑块或按钮时,轨迹由手臂和手腕骨骼肌肉控制,具有自然的物理惯性:
- 移动轨迹呈现平滑的贝塞尔曲线,而非严格的直线或规则折线。
- 包含明显的加速阶段、匀速阶段与到达目标前的减速对准阶段。
- 具有不可避免的手部生理微颤(Jitter)。
而早期爬虫脚本模拟的直接坐标跳跃(瞬移),或者用简单数学公式生成的一维线性平移,在服务端的机器学习轨迹分类模型(Random Forest / 神经网络)面前会瞬间判定为“机器伪造”,导致验证码拼图失败或直接弹重试。
2. 无感验证与综合风控打分(Risk Score)
新一代验证技术已经逐步废弃了传统扭曲字符图片验证码,转为“无感风控模型”。当用户在页面浏览时,后台探针持续收集页面滚动速度、点击间隔、停留时长、焦点切换等几十项指标,并在提交数据时计算出一个 0.0 到 1.0 之间的信任分。只有当信任分低于安全阈值时,才会降级弹出人机交互滑块或要求点选汉字。
五、排查与理解反爬拦截的推导路径与合规建议
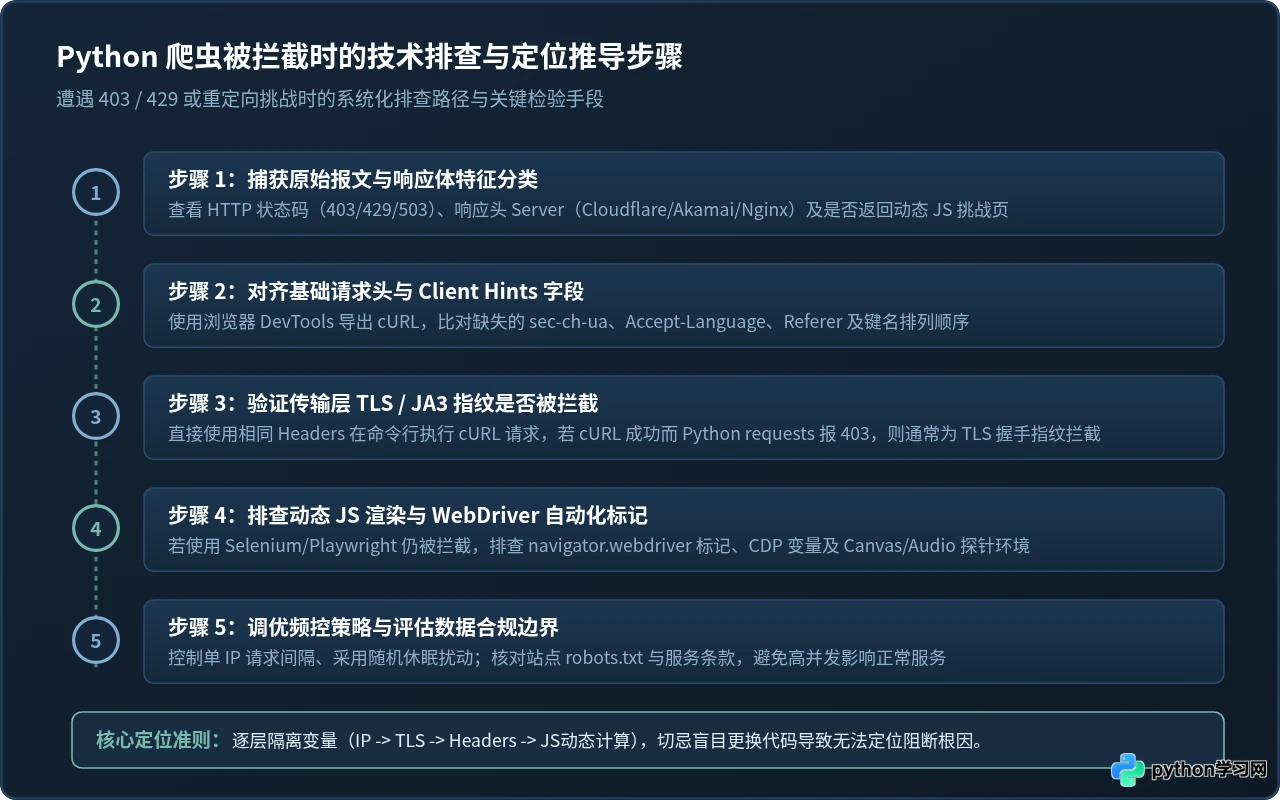
当你的爬虫程序遇到报错或无法获取数据时,如何快速定位是哪一层触发了拦截?以下推导流程可作为系统化排查的参考路径:
1. 系统化排查五步法
- 第一步:捕获原始报文与响应体分析
不要只看 Python 抛出的异常,打印完整的
response.status_code、response.headers和response.text。观察响应头中的Server字段(例如是否包含cloudflare、waf),确认返回内容是简单的 403 还是夹带了 JavaScript 验证码代码。 - 第二步:请求头基线比对(cURL 对齐法)
打开浏览器的“网络”(Network)面板,找到目标请求,右键选择“复制为 cURL (bash)”。在终端直接运行该 cURL 命令:
• 若 cURL 能成功获取数据,说明该接口没有封禁当前 IP,问题出在 Python 代码与真实浏览器请求的差异上。
• 逐步剔除 cURL 中的非必要 Header,定位出哪一个字段(如sec-ch-ua、Referer、Cookie)是服务端接口的必选依赖项。 - 第三步:排查传输层 TLS/JA3 指纹
如果在终端使用原生 cURL(较新版本带 HTTP/2 及标准 TLS)能够正常请求,而使用 Python
requests加上了一模一样的全部 Headers 依然报错 403,则极大概率是触碰了 TLS/JA3 指纹检测。此时可借由支持自定义 TLS 握手特征的工具库(如curl_cffi或基于原生浏览器内核的驱动)进行验证。 - 第四步:检查动态环境与 WebDriver 探针
若使用了 Selenium 等自动化工具被拦截,可在控制台中注入代码排查
navigator.webdriver属性是否已成功抹除,并观察是否有针对自动化环境的弹窗拦截。 - 第五步:检验并发与 IP 频控策略
将请求并发降至最低(例如单线程单次请求,并在请求之间增加带随机扰动的休眠时间),如果低频单步调试能通过而一开并发就报错 429,则属于典型的 IP 频控限制。
反爬虫机制的本质是站点保护自身服务器负载、用户数据隐私以及业务正常运行的防御工事。在学习与开发数据采集程序时,应严格遵循以下边界:
- 遵守 robots.txt 协议:尊重站点的公开抓取规范与限制目录。
- 避免高并发冲击:合理设置请求频率,严禁高并发轰炸导致目标站点服务降级或拒绝服务。
- 界定公开与非公开数据:只抓取公开合法的展示数据,切勿绕过认证机制抓取未授权的个人隐私或商业敏感信息。
六、总结
Python 爬虫之所以会被拦截,不是因为单纯的“语言弱点”,而是因为服务端反爬体系已经从最初的“字符匹配”升级到了涵盖网络层 IP 信誉、传输层 TLS 指纹、应用层报文特征、客户端环境真实度及人机行为统计学的立体防护网。理解这些技术原理,有助于开发者建立全栈的网络安全视野,在日常接口调试中准确诊断网络链路问题,同时更加规范、节制地进行数据交互与技术实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









