

Python二分查找迭代实现代码与逻辑详解
详细讲解 Python 中二分查找算法的迭代实现方案,深入剖析搜索区间定义、循环终止条件、中点索引计算技巧、指针收缩规则及常见边界陷阱。
二分查找(Binary Search)是一种针对已排序序列的高效检索算法。其迭代实现通过一个循环维护当前有效搜索区间的左右指针,每轮比对中点数值,将搜索范围缩小一半,从而在对数时间复杂度内判定目标是否存在并返回其索引。相比递归实现,迭代写法避免了额外的函数调用栈开销,空间复杂度恒定为常数级别,是工程实践中的首选实现方式。
一、二分查找的核心原理与折半缩减机制
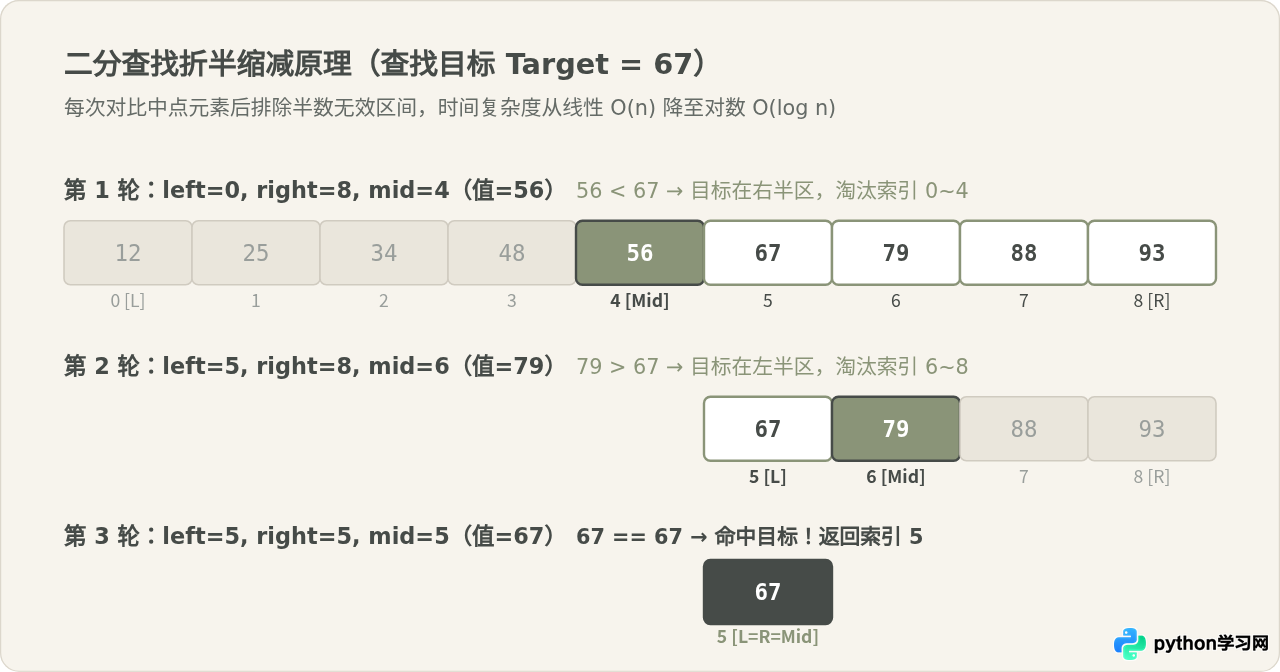
二分查找能够高效运行的核心前提是数据具备有序性以及支持O(1) 随机访问(例如 Python 中的列表结构)。在单调递增列表中,任意选定一个中点位置,其左侧所有元素均小于或等于中点值,右侧所有元素均大于或等于中点值。通过将目标值与中点值对比,可以明确排除不包含目标的一整半区间。
对于长度为 n 的有序数组,最坏情况下只需经过 log2(n) 次折半对比即可将搜索区间缩小至单个元素。如果命中则返回对应索引;若区间收缩为空仍未命中,即可确定目标值不存在。
二、Python 二分查找迭代标准实现代码
下面给出工程中最常用、逻辑最清晰的双闭区间 [left, right] 迭代实现代码。该实现包含完整的类型注解、空列表保护及测试用例。
from typing import List, Optional

def binary_search(nums: List[int], target: int) -> int:
    """
    在有序列表 nums 中迭代查找 target。

    参数:
        nums: 已按升序排列的整数列表
        target: 待查找的目标整数

    返回:
        若找到,返回目标值在列表中的索引;若未找到,返回 -1。
    """
    if not nums:
        return -1

    left = 0
    right = len(nums) - 1

    # 双闭区间 [left, right]:当 left == right 时区间内仍包含一个有效元素
    while left <= right:
        # 计算中点索引,使用整除保证索引为整型
        mid = left + (right - left) // 2
        mid_val = nums[mid]

        if mid_val == target:
            return mid
        elif mid_val < target:
            # 目标在右半区,排除 mid 自身
            left = mid + 1
        else:
            # 目标在左半区,排除 mid 自身
            right = mid - 1

    # 循环退出后仍未命中,说明列表中不存在目标元素
    return -1


if __name__ == "__main__":
    test_data = [12, 25, 34, 48, 56, 67, 79, 88, 93]
    print("查找 67 的索引 (示例命中):", binary_search(test_data, 67))  # 输出: 5
    print("查找 12 的索引 (首元素):", binary_search(test_data, 12))    # 输出: 0
    print("查找 93 的索引 (尾元素):", binary_search(test_data, 93))    # 输出: 8
    print("查找 50 的索引 (未命中):", binary_search(test_data, 50))    # 输出: -1
三、核心逻辑剖析:三大关键细节
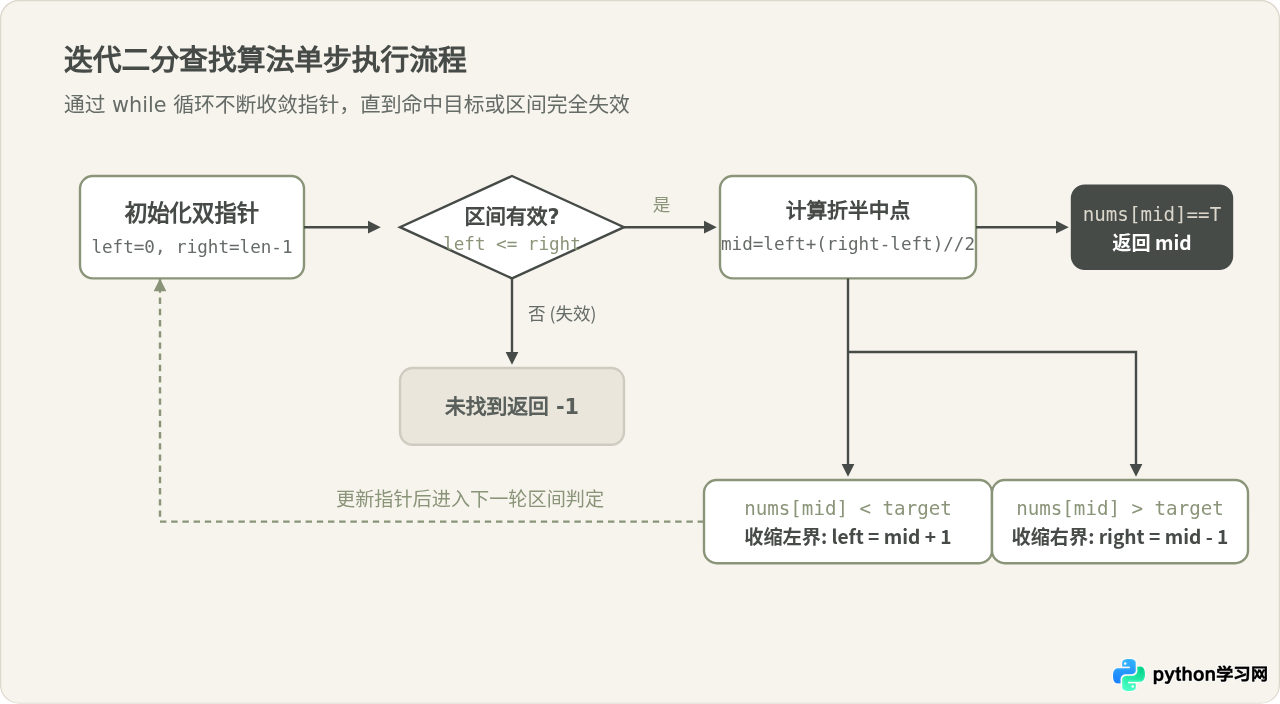
二分查找虽然代码简短,但若未深刻理解区间定义,极易出现边界越界、死循环或元素漏查问题。以下三个细节是编写该算法时必须严格把握的关键点:
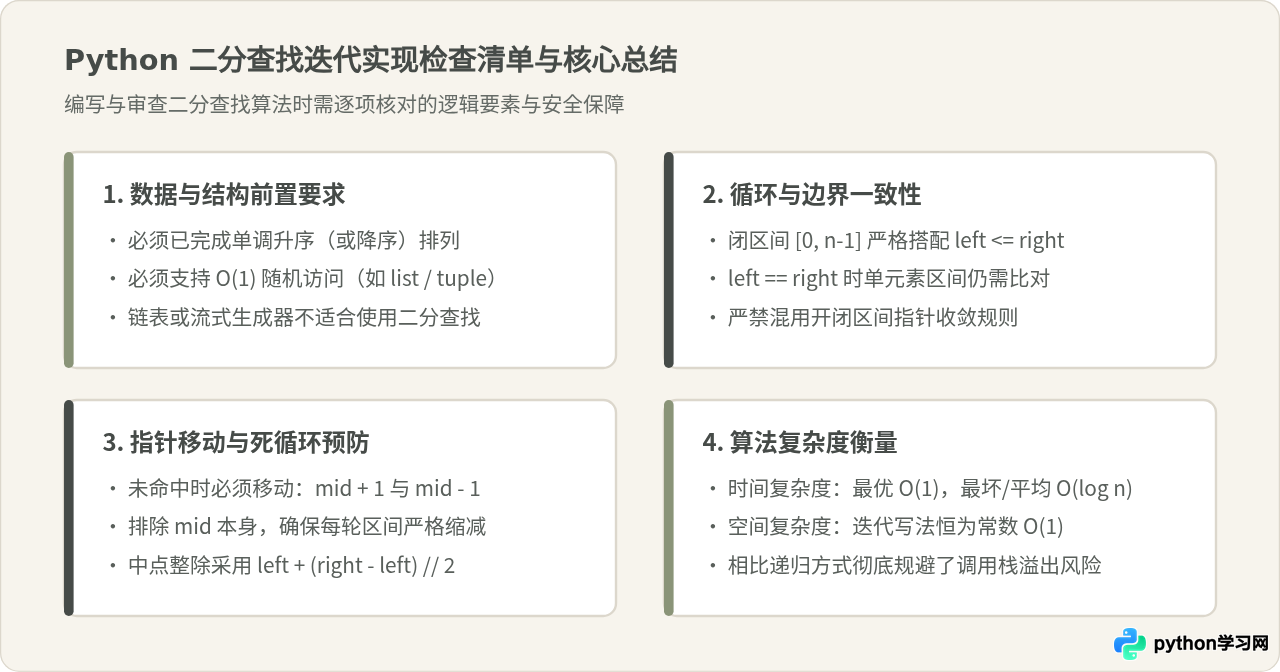
1. 循环条件为什么是 left <= right?
该条件直接由区间定义决定。当初始化 right = len(nums) - 1 时,我们维护的搜索区间是双闭区间 [left, right]。在循环执行过程中:
- 当
left < right时,区间包含 2 个及以上元素,继续折半显然合理; - 当
left == right时,区间内并非空集,而是包含恰好 1 个元素(即nums[left])。如果将条件误写为left < right,循环会直接跳出,导致区间内仅存的那一个元素从未被比对,从而漏查边界值; - 只有当
left > right(即left == right + 1)时,区间内才不存在任何合法元素,此时退出循环是唯一正确的终止时刻。
2. 中点索引计算与整除防溢出
在代码中,计算中点写为:
mid = left + (right - left) // 2在 Python 语言内部,整数具备任意精度机制,(left + right) // 2 在 Python 中通常不会像 C/C++ 或 Java 那样产生 32 位有符号整数溢出。然而,采用 left + (right - left) // 2 具有双重优势:
- 工程一致性:与主流跨语言算法规范保持一致,杜绝潜在的数值溢出隐患;
- 数学意义直观:直观体现为“从基准点
left出发,向右移动有效区间跨度的一半”,概念上更为严谨。
3. 指针更新为什么必须是 mid + 1 与 mid - 1?
在 mid_val != target 的情况下,已知 nums[mid] 绝不可能是目标值。因此在进入下一轮迭代时:
- 如果
mid_val < target,新的搜索区间必然在mid的严格右侧,更新为left = mid + 1; - 如果
mid_val > target,新的搜索区间必然在mid的严格左侧,更新为right = mid - 1。
若错误地写成 right = mid 或 left = mid,当区间只剩下两个元素且向下取整时,mid 计算结果将持续等于 left,指针无法向前推移,直接导致程序陷入无限死循环。
四、容易混淆的变体与边界方案辨析
在算法学习中,经常会遇到关于区间写法的争论。一种容易混淆的说法是:“二分查找的循环条件永远写 left < right,右边界直接写 right = mid 更加通用”。这种说法本身并不完全错误,但它脱离了区间定义的上下文。
二分查找存在两种严谨且自洽的区间模型:双闭区间 [left, right] 与 左闭右开区间 [left, right)。只要确保区间的定义、初始状态、循环退出条件以及指针移动逻辑四者严密闭环,两种写法均能得出正确结果。导致程序崩溃或死循环的真正原因往往是混用了不同模型的边界更新策略。
| 对比维度 | 双闭区间模式 [left, right](本文主推) | 左闭右开区间模式 [left, right) |
|---|---|---|
| 右指针初始化 | right = len(nums) - 1 |
right = len(nums) |
| 循环继续条件 | while left <= right |
while left < right |
| nums[mid] > target | right = mid - 1 |
right = mid(因为开区间不包含右边界) |
| nums[mid] < target | left = mid + 1 |
left = mid + 1 |
| 未找到终止状态 | left == right + 1(空集) |
left == right(空集) |
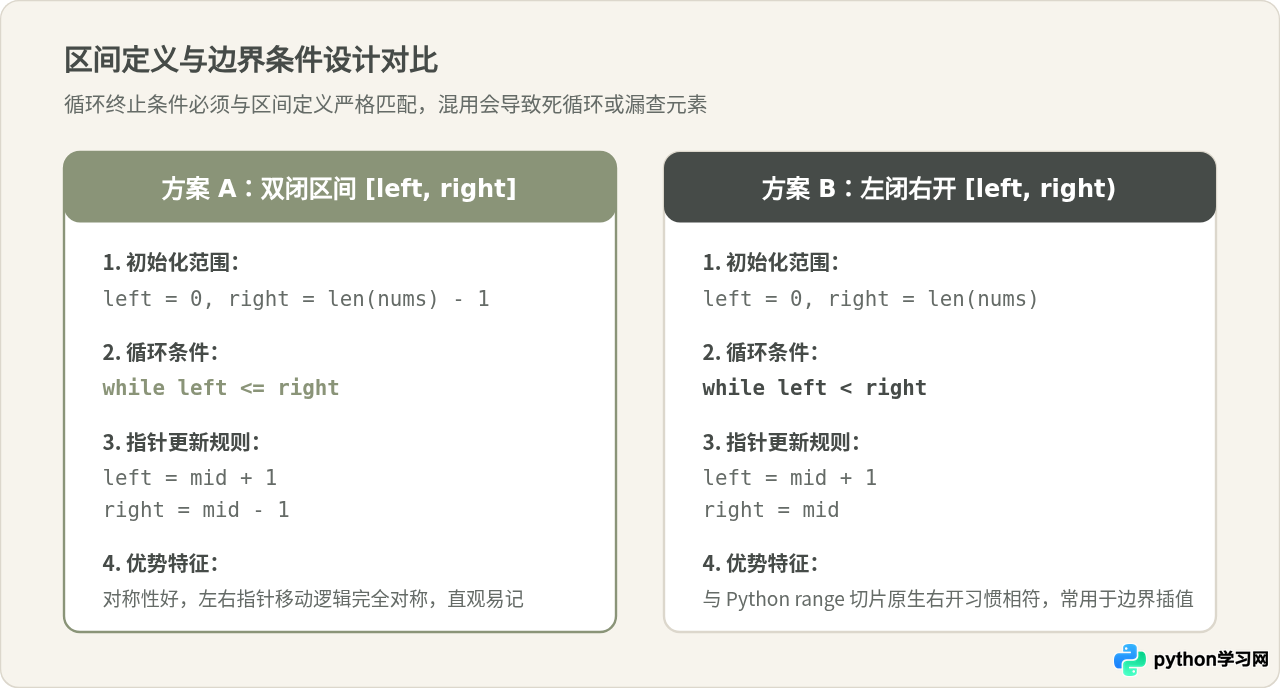
避坑提示:绝对不能在 while left <= right 下使用 right = mid,因为当 left == right 且 nums[mid] > target 时,right 将保持原值不变,导致指针永远无法交叉,程序直接卡死在死循环中。
五、适用场景与前提约束
二分查找具备卓越的理论性能,但在实际应用中必须满足以下前置条件:
- 底层数据必须支持 O(1) 随机访问:Python 列表是基于动态连续数组实现的,支持常数时间按索引取值。如果数据结构为链表(Linked List),即使节点有序,单次查找中间节点也需要 O(k) 的顺序遍历,此时二分查找的总时间复杂度将退化为 O(n),失去算法优势。
- 数据序列必须已预先排序:二分查找建立在单调性基础之上。若数据处于无序状态,盲目折半将直接淘汰可能包含目标值的区块。若数据经常变动且查询频率较低,维护排序的开销可能超过多次线性查找的总耗时。
- 关于重复元素的处理边界:上述标准二分查找在遇到重复元素时,仅保证返回任意一个匹配位置的索引。若业务需求要求返回重复元素的“第一个出现位置”或“最后一个出现位置”,则需进一步扩展为左侧边界二分查找或右侧边界二分查找。
六、边界用例验证与结果测试
为了验证迭代实现的健壮性,建议在编写完成后覆盖以下典型边界场景:
- 空列表测试:传入
[],应安全返回-1,不触发越界异常; - 单元素列表命中与未命中:传入
[5],分别查找5(应返回0)和3(应返回-1); - 列表首尾极值测试:目标元素恰好位于索引
0或len(nums) - 1,验证指针是否能收敛至极限边界; - 偶数长度与奇数长度:验证中点向下取整在不同奇偶长度下的折半表现。
通过本文阐述的双闭区间模型与细致的指针收敛控制,二分查找迭代实现不仅代码精炼,更能保持高度的数值鲁棒性与确定性,是处理大规模有序数据检索时不可或缺的基础工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









