

Python二分查找时间复杂度O(log n)的代码级解析

在一个包含 1,000,000 个有序数字的列表中查找目标值,常规的线性扫描(逐个比对)在最坏情况下需要比对 1,000,000 次,而二分查找只需要至多 20 次比对即可完成。二分查找之所以拥有如此显著的检索效率,根本原因在于其时间复杂度被压缩至了 $O(\log n)$。本文将从一段标准的 Python 二分查找实现出发,逐行拆解代码各部分的运行开销,深入推导循环体内搜索区间缩减与对数级复杂度的直接映射关系,并指出在 Python 环境中维持该时间复杂度必须守住的代码级边界。
一、标准 Python 二分查找的实现骨架
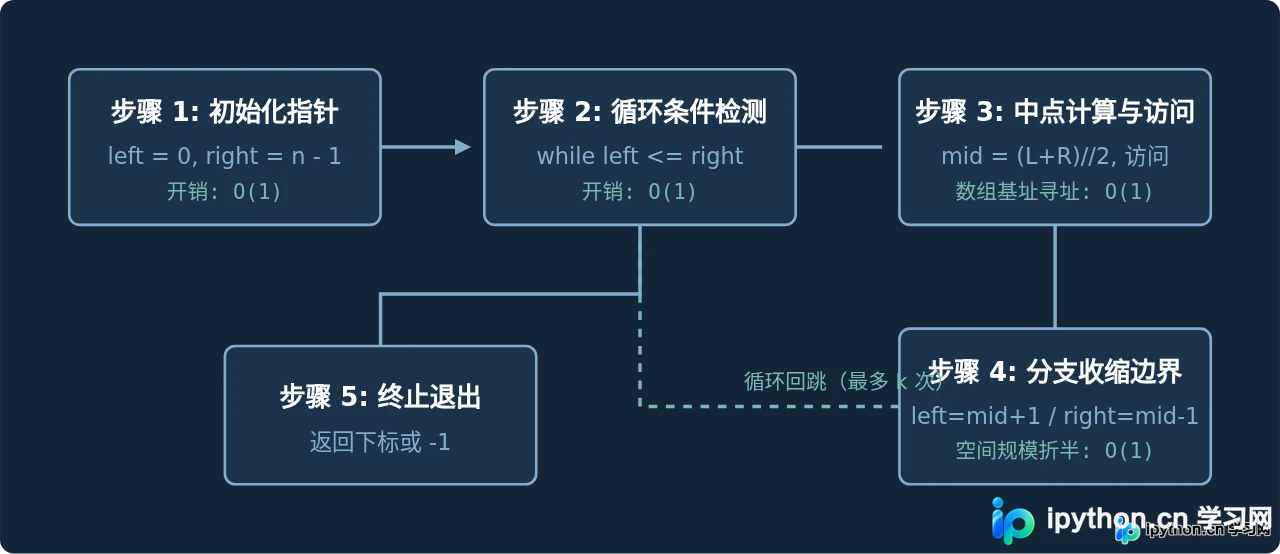
理解算法复杂度的基础是明确具体的指令执行流。以下是一个标准且严谨的 Python 二分查找实现,采用经典的闭区间 [left, right] 语义:
def binary_search(nums: list[int], target: int) -> int:
    left = 0
    right = len(nums) - 1                      # 步骤 1:初始化闭区间指针

    while left <= right:                       # 步骤 2:循环维持检索条件
        mid = (left + right) // 2              # 步骤 3:折半获取中点下标
        mid_val = nums[mid]                    # 步骤 4:常数时间随机访问

        if mid_val == target:
            return mid                         # 命中目标,立即退出
        elif mid_val < target:
            left = mid + 1                     # 目标在右侧,收缩左边界
        else:
            right = mid - 1                    # 目标在左侧,收缩右边界

    return -1                                  # 步骤 5:区间耗尽,检索未命中
在这段代码中,整个算法的耗时由两部分构成:循环外部的初始化与返回操作(属于单次执行的常数时间操作),以及 while 循环体内部单次迭代的耗时与迭代总次数的乘积。要证明总时间复杂度为 $O(\log n)$,首先需要确认单次循环内部各操作的真实时间消耗。
二、单次迭代的代码级代价分析
分析复杂度时,最容易被忽略的细节是“代码语句是否真正满足 $O(1)$ 常数时间”。在 Python 解释器底层,上述循环体中的每条语句耗时特征如下:
mid = (left + right) // 2:涉及两个整数的加法与整数地板除。由于指针数值不会超过列表长度上限,算术运算在 CPU 寄存器层面耗费固定的机器周期,执行时间为 $O(1)$。mid_val = nums[mid]:这是二分查找高效运转的关键环节。Python 的list底层由连续的 C 语言数组(指针数组)实现。通过下标mid访问元素时,可以直接通过内存基地址偏移计算目标地址:$\text{Address} = \text{Base} + \text{mid} \times \text{Size}$。这意味着下标寻址是一步到位的常数时间操作,复杂度严格为 $O(1)$。- 分支比较与指针重赋值:包括
if-elif-else条件判断,以及left = mid + 1或right = mid - 1的赋值,均为标准的原语比较与局部引用绑定,同样耗时 $O(1)$。
因为循环体内不存在嵌套循环,也不存在列表拷贝或动态切片,所以单次迭代的计算开销为严格的 $O(1)$。决定整体算法运行时间的关键,就在于该循环体最多会被触发执行多少次。
三、循环折半机制与数学推导过程
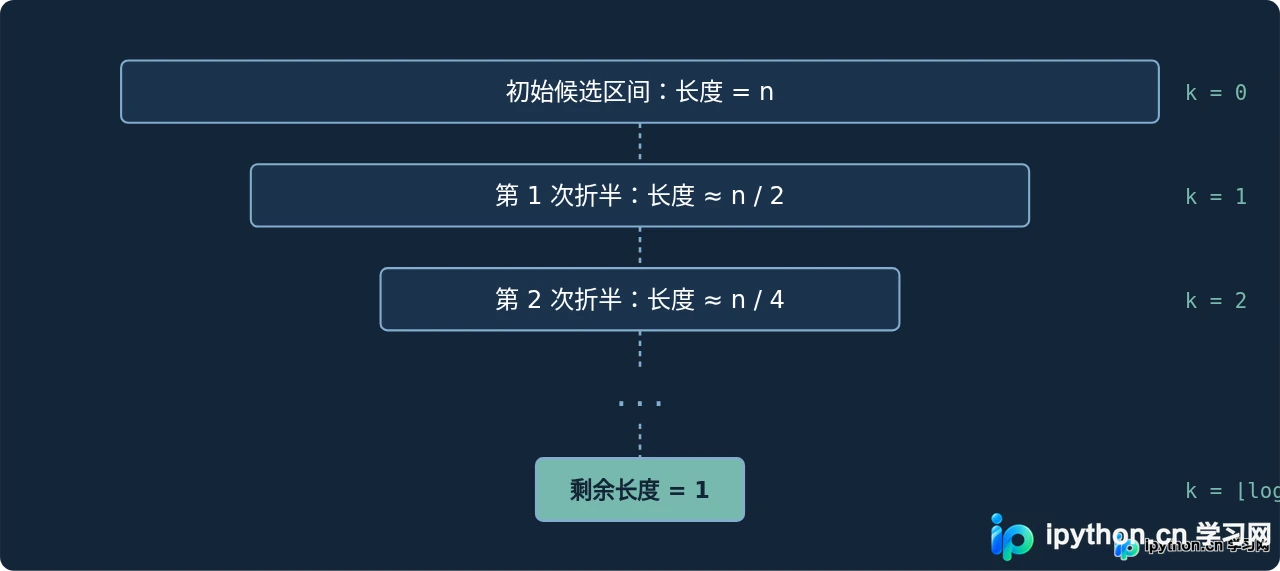
最坏情况下(即目标元素恰好在搜索区间完全收缩为 0 时才被判定不存在,或刚好在最后一步命中),算法需要经历最大迭代次数。我们通过追踪搜索区间的长度演化来进行严格推导:
- 初始状态:列表长度为 $n$,初始搜索区间包含的元素个数为 $L_0 = n$。
- 第 1 次迭代结束:中点被比对并排除,无论是
left = mid + 1还是right = mid - 1,新区间规模至多为原始的一半,即 $L_1 \le \frac{n}{2}$。 - 第 2 次迭代结束:新区间在上一轮基础上再次折半,即 $L_2 \le \frac{n}{2^2}$。
- 第 $k$ 次迭代结束:经过 $k$ 轮收缩后,候选区间的元素数量满足 $L_k \le \frac{n}{2^k}$。
循环能够持续执行的边界条件是 left <= right,即搜索区间内至少还要有 1 个元素($L_k \ge 1$)。当搜索区间缩减至只剩 1 个元素时,若该元素仍不是目标值,经过下一次边界更新,指针必定发生错位(left > right),此时区间元素个数归零,循环强制退出。
令循环结束时的临界条件成立:
$$\frac{n}{2^k} \le 1 \implies 2^k \ge n \implies k \ge \log_2 n$$
对 $k$ 向上取整,最大迭代循环次数为:
$$k = \lfloor \log_2 n \rfloor + 1$$
在渐进复杂度分析中,以 2 为底的对数底数通过换底公式 $\log_2 n = \frac{\ln n}{\ln 2}$ 可以转化为常数系数,在记号内常数项均予以忽略。因为总时间为单次循环时间与循环次数的乘积,所以:
$$T(n) = O(1) \times (\lfloor \log_2 n \rfloor + 1) = O(\log n)$$
四、代码级隐患:破坏 O(log n) 的反模式
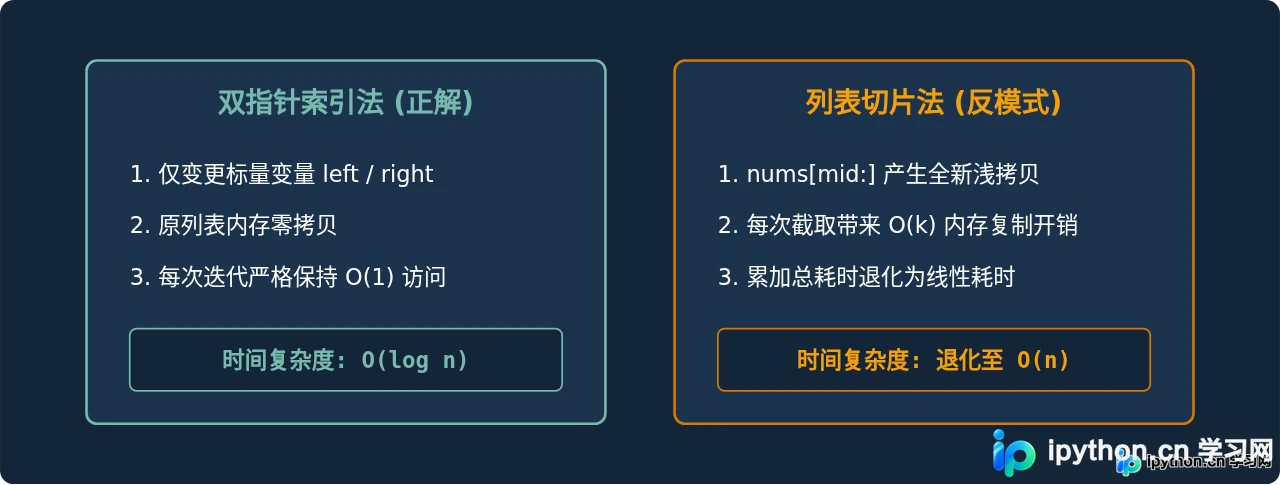
很多开发者在 Python 中实现二分查找时,虽然逻辑表面上遵循了“二分折半”,但由于对 Python 底层特性的误用,导致实际时间复杂度退化。最常见的陷阱就是在循环内部使用列表切片。
# 错误示例:误用切片导致复杂度退化为 O(n)
def bad_binary_search(nums: list[int], target: int) -> bool:
    if not nums:
        return False
    mid = len(nums) // 2
    if nums[mid] == target:
        return True
    elif nums[mid] < target:
        return bad_binary_search(nums[mid + 1:], target)  # 致命缺陷:切片拷贝
    else:
        return bad_binary_search(nums[:mid], target)      # 致命缺陷:切片拷贝
在 Python 中,nums[mid + 1:] 操作并不是创建一个轻量级的视图或指针窗口,而是在内存中全量复制切片范围内的所有指针引用,这一步的耗时与切片长度成正比,即单次递归开销为 $O(\text{len})$。
此时算法的时间递推式变为:
$$T(n) = T\left(\frac{n}{2}\right) + O(n)$$
展开后可得:
$$T(n) = n + \frac{n}{2} + \frac{n}{4} + \dots + 1 \approx 2n = O(n)$$
原本极具优势的对数级算法,直接退化成了与线性扫描耗时相当的 $O(n)$,彻底丧失了二分查找的价值。
五、复杂度与规模效应总结
对数级增长的优势随着数据规模的扩大会被急剧放大。为了直观感受 $O(\log n)$ 与线性复杂度 $O(n)$ 在最坏情况下的指令执行差异,可参考下表:
| 元素规模 $n$ | 线性扫描最坏比对次数 $O(n)$ | 二分查找最坏比对次数 $\lceil \log_2(n+1) \rceil$ | 计算量压缩比 |
|---|---|---|---|
| 16 | 16 | 4 | 4 倍 |
| 1,024 (1K) | 1,024 | 10 | 约 102 倍 |
| 1,048,576 (1M) | 1,048,576 | 20 | 约 52,428 倍 |
| 1,073,741,824 (1G) | 1,073,741,824 | 30 | 约 35,791,394 倍 |
sorted(),则排序本身的 $O(n \log n)$ 将成为瓶颈。
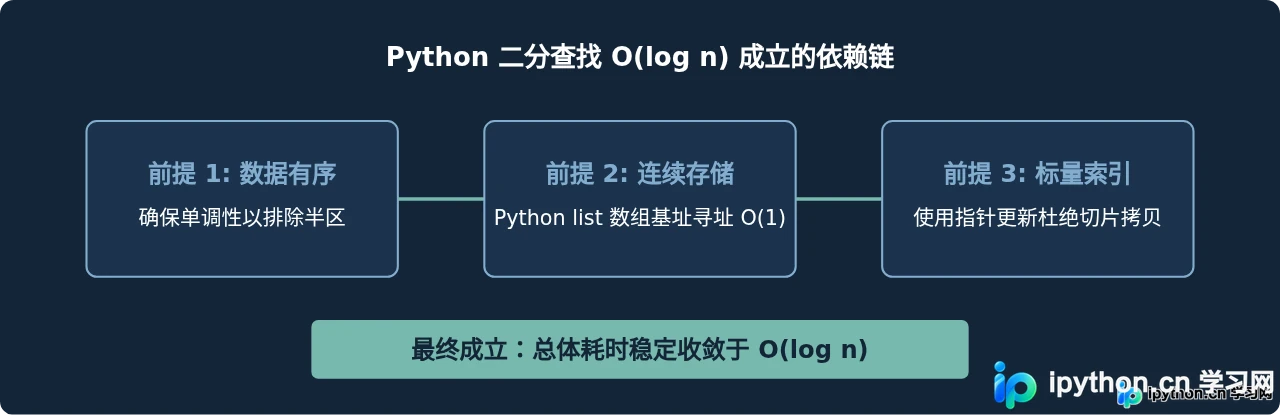
综上所述,二分查找之所以能够达到 $O(\log n)$,依赖的是“单次迭代通过标量指针移动保持 $O(1)$ 常数开销”与“每次循环将待搜索区间规模严格缩减至原来的一半”两者的结合。在 Python 编码实践中,只要杜绝切片拷贝并维护双指针语义,这一理论优势就能在实际工程中稳定兑现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









