

为什么Python切片不会索引越界?左闭右开区间解析
深入解析Python切片为何不会触发IndexError的核心机制,结合栅栏桩模型、左闭右开区间设计哲学及CPython底层边界截断规则,彻底讲透切片背后的运行逻辑。
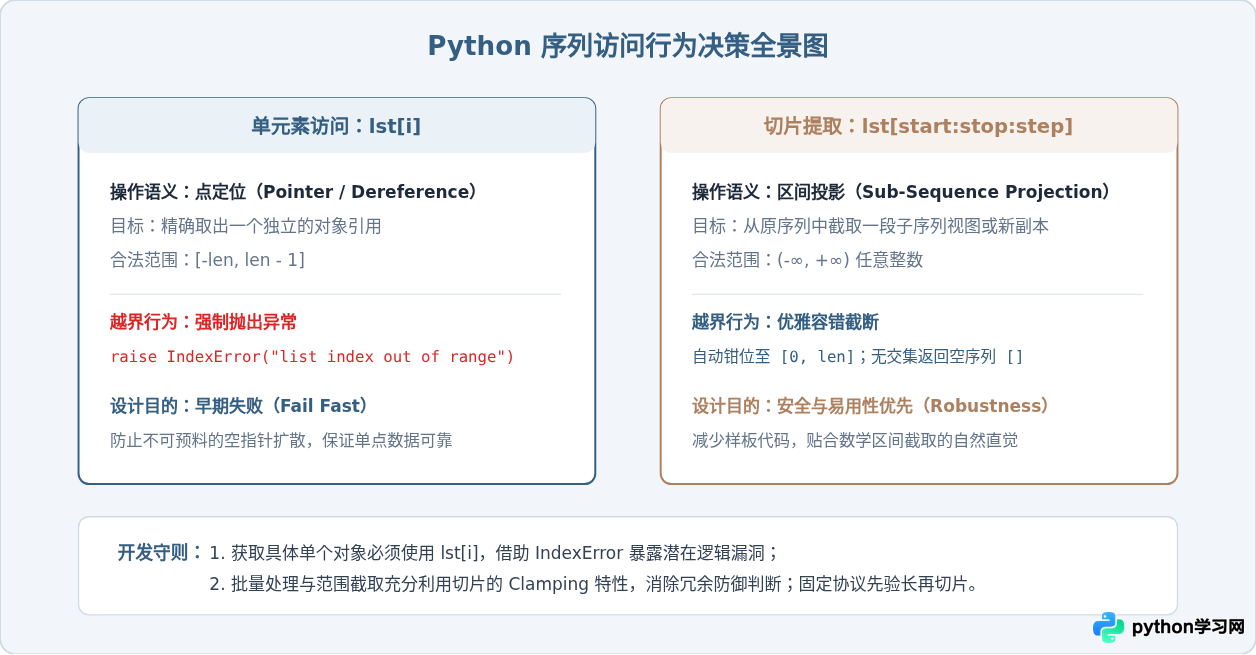
lst[i])与切片提取(lst[start:stop])是两种完全不同的语义操作。索引访问属于单点精确寻址,目标元素必须真实存在于内存槽位中,超出范围属于严重逻辑错误,因而抛出 IndexError;而切片操作本质上是子序列的投影与提取,采用“栅栏桩模型”和左闭右开区间 [start, stop) 设计。Python 底层对切片边界执行了自动钳位与截断(Clamping),将任意越界边界规整到合法有效范围内。当提取区间与原序列没有交集时,安全退化为空序列,从而消除了防御性边界判断的代码负担。
一、现象对比:单元素索引的严格与切片的宽容
初学 Python 的开发者经常会对一组行为产生疑问:为什么通过索引访问超出长度的位置会直接报错,而使用切片传出极其荒谬的超大数值却能正常执行?
我们来看一段直观的代码对比:
# 定义一个长度为 5 的列表
items = ['A', 'B', 'C', 'D', 'E']

# 1. 单元素索引访问越界:立即抛出 IndexError
try:
    print(items[10])
except IndexError as e:
    print(f"索引访问触发异常: {e}")  # 输出: list index out of range

# 2. 切片越界访问:完全不报错,正常返回剩余元素
sliced_items = items[2:100]
print(f"切片提取结果: {sliced_items}")  # 输出: ['C', 'D', 'E']

# 3. 完全超出范围的切片:优雅退化为空列表
empty_slice = items[100:200]
print(f"超范围切片结果: {empty_slice}")  # 输出: []
这种差异绝非语言实现的漏洞或偶然,而是 Python 在语法概念与底层设计层面的明确区分。要真正理解它,必须从元素索引与切片边界的几何模型入手。
二、栅栏桩模型与左闭右开区间
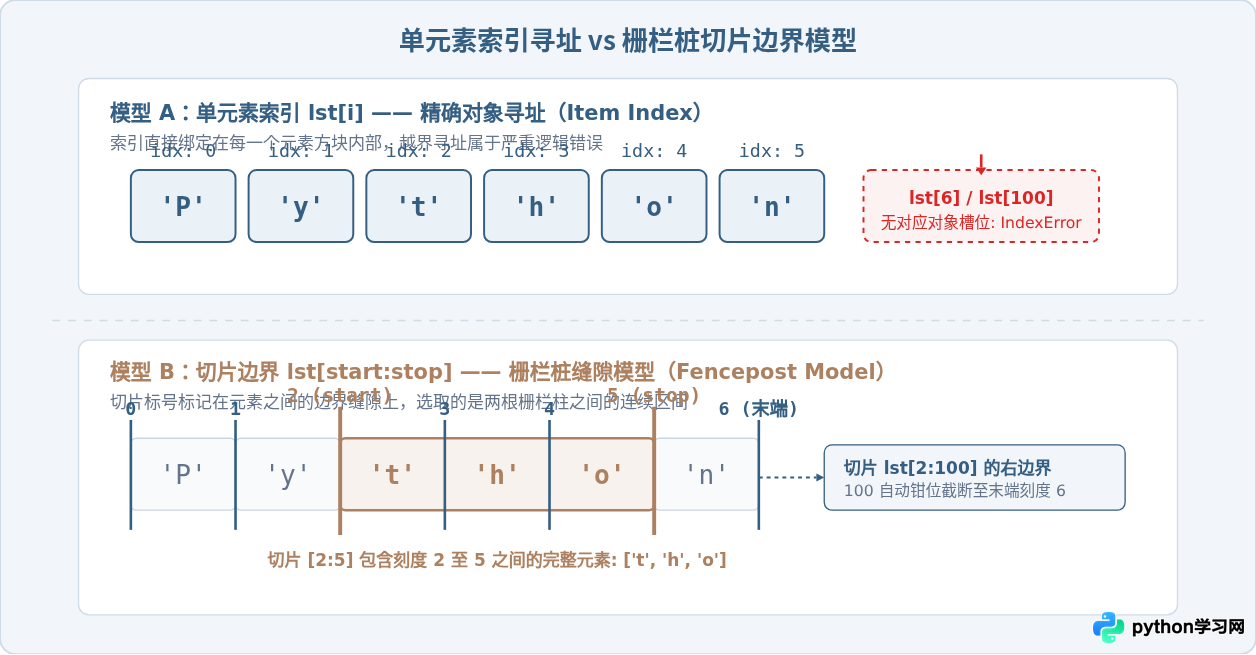
计算机科学中经典的栅栏桩问题(Fencepost Problem)解释了计数的边界差异:建一堵 5 段长的木栅栏,需要 6 根桩子。在 Python 的切片设计中:
- 元素是两根桩子之间的木板:包含具体的数据对象;
- 下标是桩子(栅栏柱):从
0开始标注在缝隙上,列表最左侧起点是桩0,第k个元素左侧为桩k,整个列表末尾为桩len(lst)。
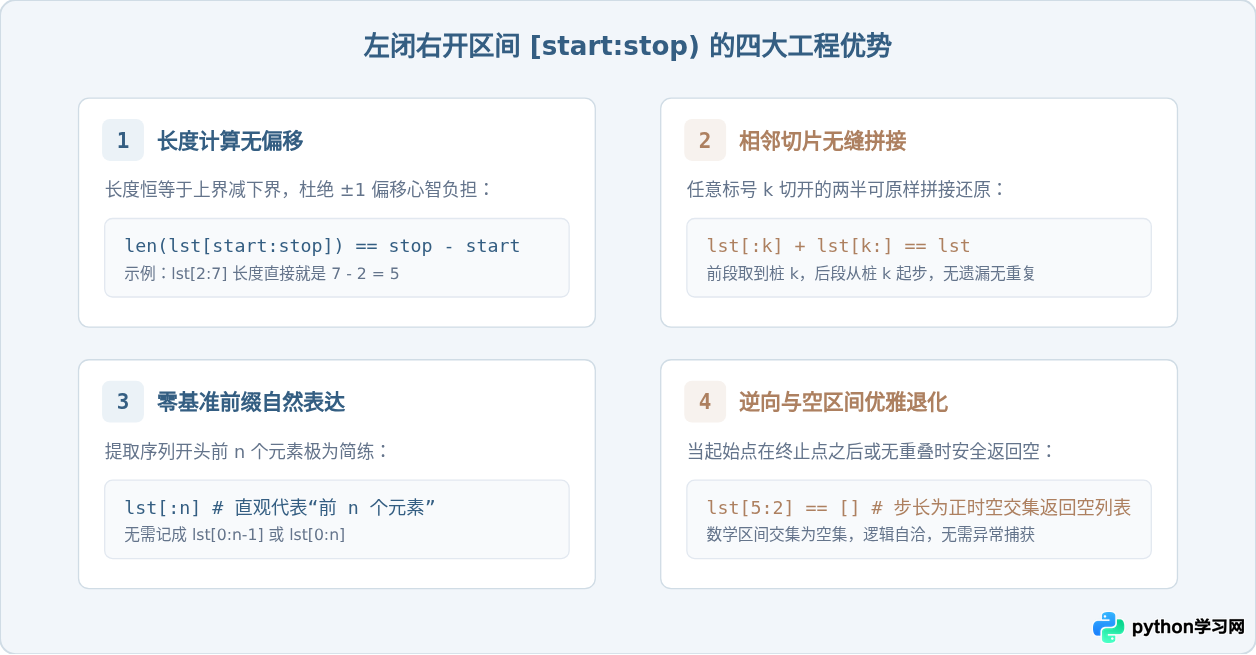
结合左闭右开区间 [start, stop),start 对应区间的起始桩,stop 对应区间的结束桩。这种设计带来了非常优雅的工程数学特性:
- 长度直接可算:子切片的元素个数恒等于
stop - start,例如items[2:5]的长度就是5 - 2 = 3,无需像双闭区间那样多写+ 1。 - 相邻切片无缝分割:任意位置
k都可以将序列切分为两个互补部分lst[:k]与lst[k:],且必然满足lst[:k] + lst[k:] == lst,中间没有任何空隙,也没有元素重叠。 - 从零起始的自然直觉:获取前
n个元素,写法直接是lst[:n],直观明了。
三、底层机制:CPython 是如何截断切片边界的?
在底层实现中,Python 究竟是如何保证切片永远不会报错的?我们可以直接考察 Python 内置的 slice 类型对象及其底层 C API。
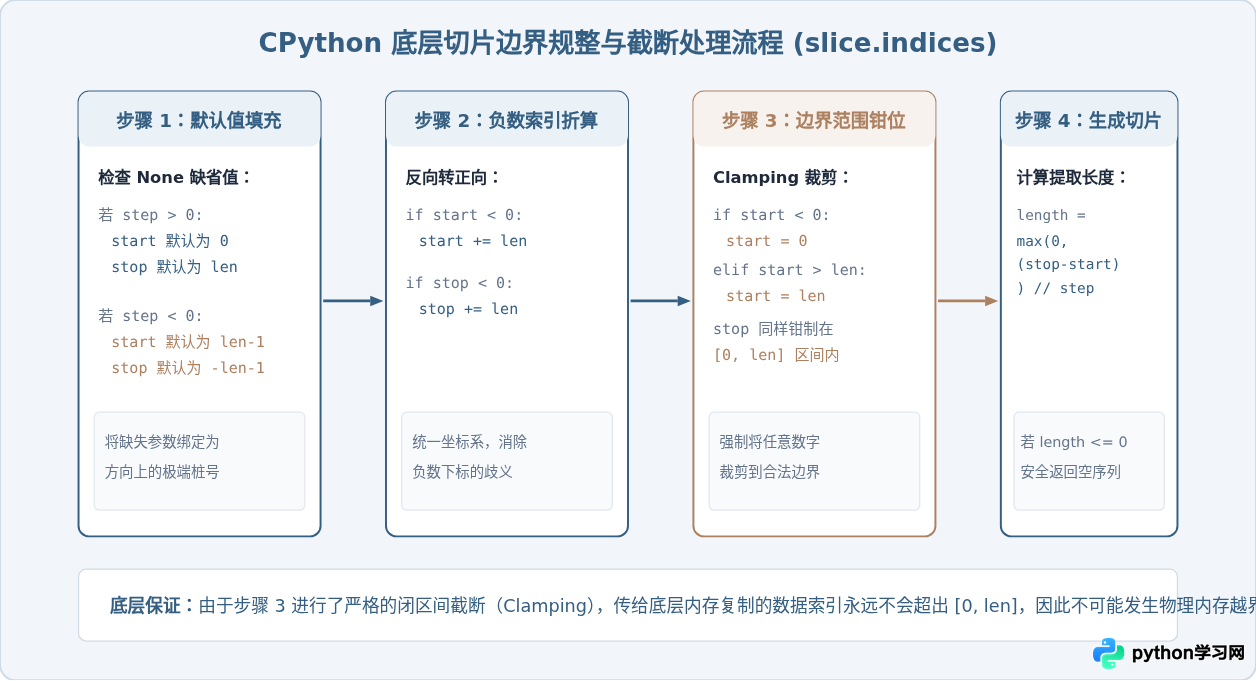
在 Python 内部,当我们写下 lst[start:stop:step] 时,解释器会调用 lst.__getitem__(slice(start, stop, step))。Python 提供了一个公开且非常核心的方法 slice.indices(length),正是它负责将所有的越界数值、负数索引以及 None 缺省值转换规整为有效合法的绝对三元组 (start, stop, step)。
# 我们可以直接使用 slice 对象的 indices 方法查看转换过程
s = slice(2, 100)
# 假定序列长度为 5
print(s.indices(5))  # 输出: (2, 5, 1)

# 即使传入极其夸张的边界
huge_slice = slice(-999, 999)
print(huge_slice.indices(5))  # 输出: (0, 5, 1)

# 当区间完全在序列之外时
out_of_bounds = slice(50, 100)
print(out_of_bounds.indices(5))  # 输出: (5, 5, 1) -> 对应 range(5, 5, 1),生成 0 个元素
在 CPython 源码中(位于 Objects/sliceobject.c),这一计算由 PySlice_GetIndicesEx / _PySlice_Unpack 驱动。处理的四个关键推导步骤如下:
四、步长为负时的边界判定
当切片引入负步长(step < 0)时,切片的方向由默认的“从左到右”逆转为“从右到左”。此时很多初学者会遇到“取不出值”或“末尾元素丢失”的困惑。
请看以下典型场景:
letters = ['a', 'b', 'c', 'd', 'e']

# 1. 完整反转序列:不写 start 与 stop,默认覆盖整个序列两端
print(letters[::-1])  # 输出: ['e', 'd', 'c', 'b', 'a']

# 2. 从索引 3 倒序取到索引 1(包含 3, 2,但不包含 1)
print(letters[3:1:-1])  # 输出: ['d', 'c']

# 3. 常见陷阱:想要倒序取到开头(索引 0)
# 如果写成 letters[3:0:-1],索引 0 会因为左闭右开特性被排除在外!
print(letters[3:0:-1])  # 输出: ['d', 'c', 'b'] (缺少 'a')

# 正确写法:stop 传 None 或留空,底层会自动填充为穿透起点的 -len-1 桩位
print(letters[3::-1]) # 输出: ['d', 'c', 'b', 'a']letters[3:-1:-1] 来试图取到第一个元素!因为在负步长下,-1 会首先根据步骤 2 折算为正索引 4(对应字母 'e')。而此时起始点是 3,从 3 往后退无论如何也无法到达 4,有效长度计算结果小于等于 0,最终只会得到一个空列表 []。当需要倒序取至序列开头时,务必将 stop 留空。
五、工程实践中的权衡:何时该依赖切片容错,何时该主动校验?
切片的不越界特性极大简化了日常代码,但在严肃的工程实践中,开发者必须清楚其适用边界:
| 场景类型 | 推荐做法 | 设计原因 |
|---|---|---|
分页查询与截取(如 data[offset:offset+limit]) |
直接使用切片容错 | 最后一页数据不足 limit 条时,切片自动返回剩余所有元素,无需额外编写 min(offset+limit, len(data))。 |
| 安全提取前缀 / 后缀(如文件扩展名、固定标记) | 直接使用切片 | 字符串切片 text[:10] 在字符串极短时不会崩溃,保证代码稳健性。 |
| 二进制网络协议包 / 固定格式报文解析 | 必须先进行长度断言校验 | 协议帧通常要求固定头部(如前 4 字节魔数、2 字节长度)。若数据包残缺,切片会静默截断为更短数据,导致后续解包错误扩散,应提前校验 len(packet) >= HEADER_SIZE。 |
| 单元素语义提取 | 必须使用单元素索引 lst[i] |
切勿用 lst[i:i+1] 伪装获取单个元素。索引越界抛出 IndexError 是重要的哨兵机制,能及早暴露出业务逻辑的空指针或数组溢出漏洞。 |
六、全文总结
回到文章最初提出的问题:为什么 Python 切片不会索引越界?
我们可以将其精炼为三层认知:
- 概念层面:索引代表“元素本身”,切片标号代表“元素缝隙(栅栏柱)”。切片提取的是两个桩子之间的区间,而非对某一个具体位置进行寻址;
- 数学层面:左闭右开区间
[start, stop)保证了len = stop - start以及s[:k] + s[k:] == s的代数自洽性,当两桩之间不存在元素时,自然退化为空序列; - 实现层面:CPython 底层通过
slice.indices()对传入的所有起止桩位进行了强制的钳位截断(Clamping),将所有超限数值裁剪到[0, len]的安全范畴内。
深刻理解这一机制,不仅能帮助我们消除对切片“异常行为”的困惑,更能在日常编码中自如运用切片的容错特性,写出既简洁优雅又坚固可靠的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









