

Python大小写转换报错:非字符串类型输入的处理方法
深入解析在Python中调用lower()或upper()时遇到非字符串类型(如None、数字、列表等)导致的AttributeError报错,并提供类型检查、防御性转换与批量数据清洗等实用处理方案。
在 Python 中对非字符串变量直接调用 lower() 或 upper() 时,程序会直接中断并抛出 AttributeError。解决这个问题的核心路径在于建立输入守卫:在调用转换前通过类型检查、安全包装函数或数据清洗逻辑,将空值、数值等非字符串对象拦截并规范化。
一、报错现象与发生原因
在处理用户输入、解析表单、读取 API 响应或分析表格数据时,开发者常常默认某个字段一定是文本,并直接调用大小写转换方法。例如:
# 常见引发报错的场景
user_input = None
print(user_input.lower())
执行后解释器会输出如下报错信息:
AttributeError: 'NoneType' object has no attribute 'lower'
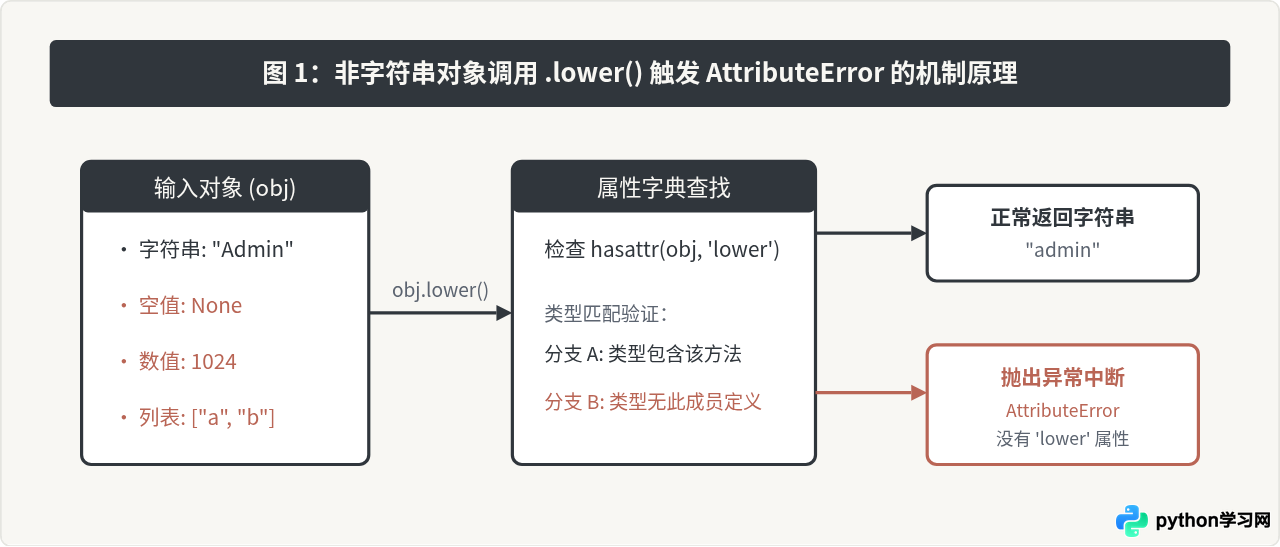
Python 是一门强类型动态语言。字符串专有的成员方法如 lower()、upper()、title()、swapcase() 仅在内置类型 str 中定义。当输入变量是 None、整数(int)、浮点数(float)、字典(dict)或列表(list)时,对象内存中不存在这些方法,Python 解释器在属性查找失败后只能抛出 AttributeError。
二、四种处理方案与适用场景
面对非字符串类型输入,不能一味通过盲目强转解决。根据业务诉求是“保留空值”、“静默忽略”还是“全部转为文本”,我们有四种明确的处理方案。
1. 类型守卫:isinstance 显式检查
这是最稳健且符合 Python 规范的做法。当且仅当对象为 str 类型时执行转换,否则根据业务需要返回预设的默认值(例如空字符串或 None)。
def safe_lower(val, default=""):
    if isinstance(val, str):
        return val.lower()
    return default

# 示例验证
print(safe_lower("HELLO"))     # 输出: hello
print(safe_lower(None))        # 输出: ""
print(safe_lower(12345, None)) # 输出: None
2. 强制转换:str() 先转文本后变大小写
如果业务场景允许将数字等标量信息转为文本(例如将用户输入的订单号 10098 转为字符串 "10098"),可以使用 str() 转换。但必须特别注意:str(None) 会得到字符串 "None",这通常不是业务期望的结果,因此需先排除 None。
def to_lower_string(val):
    if val is None:
        return ""
    return str(val).lower()

# 示例验证
print(to_lower_string(1024))   # 输出: 1024
print(to_lower_string("JSON")) # 输出: json
print(to_lower_string(None))   # 输出: ""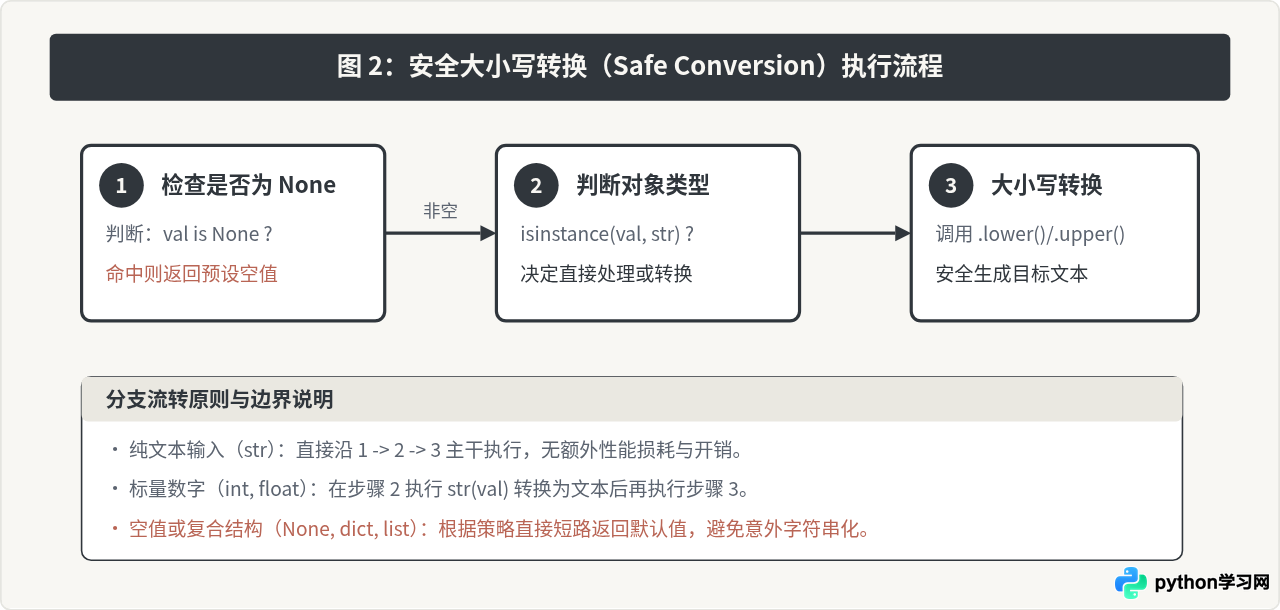
3. 异常捕获:try-except 兜底
在不便频繁进行前置判断的代码块中,可以使用 try-except AttributeError 捕获异常。这种方式遵循 Python 的 EAFP(请求宽恕比取得许可更容易)原则,特别适合绝大多数输入为字符串、仅极少部分出现异常类型的高频执行场景。
def try_lower(val):
    try:
        return val.lower()
    except AttributeError:
        # 当 val 没有 lower 属性时触发
        return ""
4. 特征检测:hasattr 动态反射
如果你不仅需要支持 Python 自带的 str,还需要兼容自定义的富文本对象、代理类(Proxy)或封装类,可以使用 hasattr(val, "lower") 判断目标是否具有该属性:
def duck_lower(val):
    if hasattr(val, "lower") and callable(val.lower):
        return val.lower()
    return ""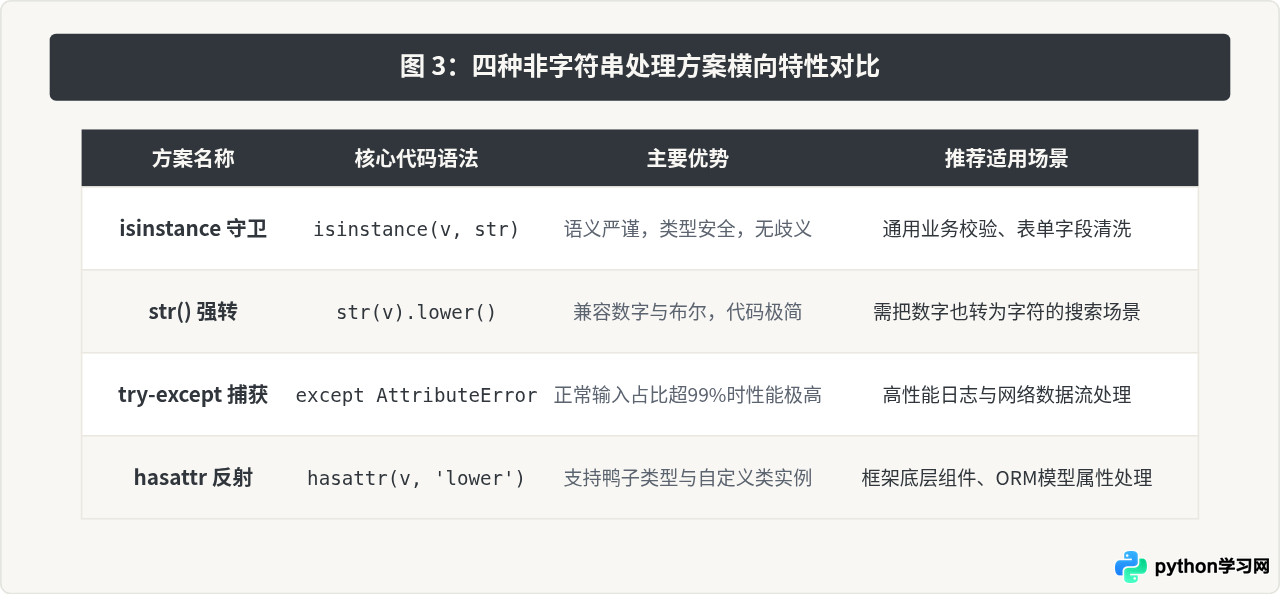
三、批量数据与 Pandas 容器中的场景应对
在真实项目中,大小写转换往往不是针对单个变量,而是对列表、字典或数据分析表格(Pandas DataFrame)进行批量清洗。
1. 列表推导式中的条件过滤
处理包含混合类型的列表时,可以在列表推导式中直接内嵌条件表达:
raw_tags = ["Python", 2024, None, "Django", ["web"]]

# 仅转换字符串项,其余保留原值
cleaned_tags = [item.lower() if isinstance(item, str) else item for item in raw_tags]
print(cleaned_tags)
# 示例输出: ['python', 2024, None, 'django', ['web']]
2. Pandas 数据列的特殊处理
在 Pandas 中,包含文本的列其 dtype 往往被推断为 object。如果列中夹杂了缺失值 NaN(属于浮点数),直接执行 df['col'].str.lower() 是安全的,因为 Pandas 的 .str 访问器会自动跳过 NaN 并保持其为 NaN;但如果直接用 apply(lambda x: x.lower()),就会因为 float 类型抛出 AttributeError。
import pandas as pd
import numpy as np

s = pd.Series(["Admin", np.nan, "Root", 123])

# 正确推荐做法:使用向量化 .str 访问器
result = s.astype(str).str.lower()
# 或者保留空值:
result_preserve_na = s.apply(lambda x: x.lower() if isinstance(x, str) else x)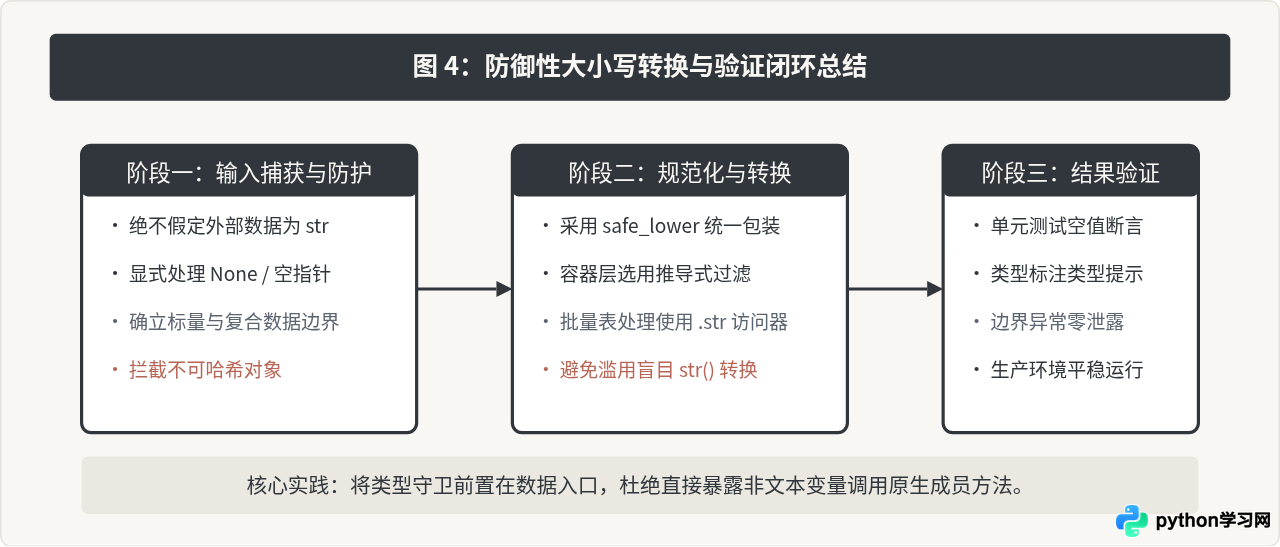
四、总结与开发建议
开发自查清单:
- 拒绝裸调方法:禁止在未经类型确认的外部入参上直接链式调用
.lower()或.upper()。 - 警惕
str(None)陷阱:避免使用str(val).lower()偷懒,否则会将空值变成字符串"none",引入难以排查的业务逻辑隐患。 - 利用类型标注:在函数签名中声明类型提示(如
val: Optional[str]),借助mypy等静态类型检查工具在编译期提前暴露潜在的非字符串调用风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









