

Python能实现哪些办公自动化?批量处理Excel与文件管理实例
本文系统梳理Python在办公自动化中的核心应用场景,结合完整的代码实例,深入讲解批量处理Excel表格与自动化文件整理的具体实现方法与避坑技巧。
在日常办公中,大量重复且机械的操作消耗了从业人员极多精力,例如汇总几十个部门上报的销售报表、根据员工姓名提取特定凭单、按月份与部门分类归档成百上千个文档等。Python凭借简洁的语法生态和丰富的第三方库,能将这套繁琐的手工流程转化为标准化、秒级执行的确定性程序。本文将系统梳理Python在办公自动化领域的典型能力边界,并以最常见的“批量处理Excel”与“多层级文件管理”为核心场景,提供具备完整上下文的可执行方案。
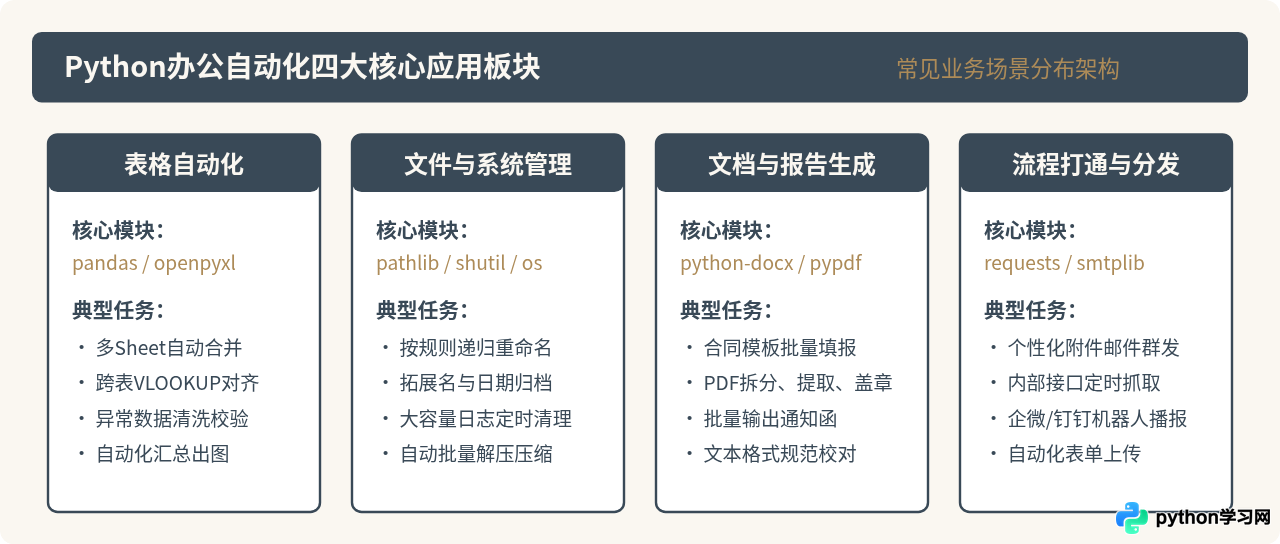
一、Python能覆盖哪些办公自动化场景?
办公自动化的本质并非替代人工思考,而是将规则明确、步骤可重复、数据量大的工作流交给脚本执行。在实际办公环境中,Python能够有效替代人工的工作主要分为以下几大场景:
- 表格批量加工与对账:当数据分布在十几个甚至上百个Excel文件中时,手工复制粘贴极易错行漏项。通过Python可在内存中直接完成对齐匹配、多维透视、格式检查与异常筛查。
- 非结构化与结构化文件管理:如根据客户发来的文件名(如“2026-10-发票-张三.pdf”)提取关键词,按归属年份、部门及文件类型自动分流建立文件夹存放,避免桌面混乱。
- 模板化文书与报告生成:如劳动合同、客户询价单、成绩单等,只需维护一份Word/PDF模板与Excel名单,便可批量套打并生成专属文件。
- 信息采集与消息触达:自动定时从公司内网系统下载前日数据,生成图表邮件,并在企业微信或邮件中向相关责任人精准派发专属报表。
二、场景一:批量处理Excel表格实战
在处理Excel自动化时,很多初学者容易混淆库的选择。我们需要根据任务属性做出恰当选型:
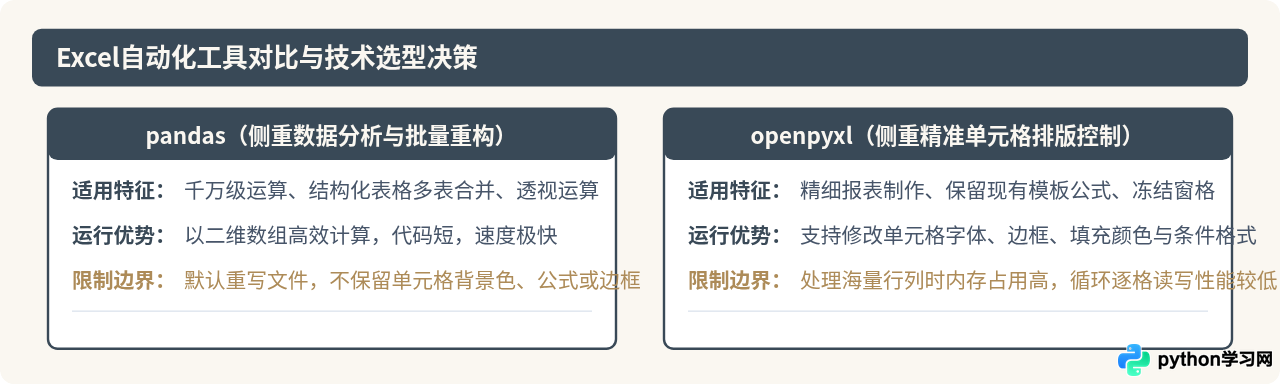
实例:跨门店月度销售表自动合并与汇总
业务场景:总部每月要求下属20个门店分别上报销售明细Excel,保存在统一的 ./reports 目录下。每个文件的列包含“商品编码”、“商品名称”、“销售量”、“单价”。我们需要合并为一个汇总文件,并计算各商品的全国总销售额。
执行步骤与逻辑流程:
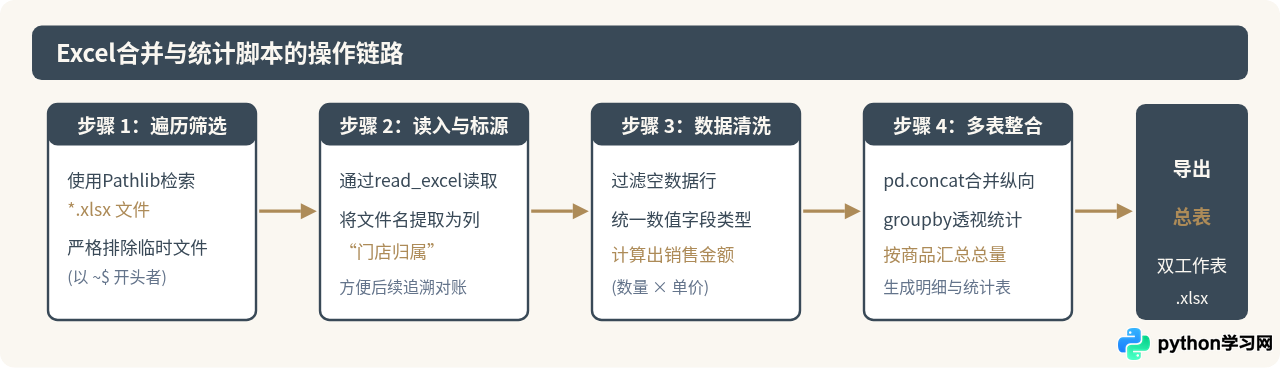
完整实现代码:运行前需确保已安装依赖:pip install pandas openpyxl。
import pandas as pd
from pathlib import Path

def merge_store_reports(input_dir: str, output_path: str):
    source_folder = Path(input_dir)
    all_records = []

    # 遍历目标目录下所有的xlsx文件,过滤临时锁文件(以~$开头)
    for file_path in source_folder.glob("*.xlsx"):
        if file_path.name.startswith("~$"):
            continue

        try:
            # 读入单个门店上报的数据
            df = pd.read_excel(file_path)

            # 校验必需的列是否存在,避免格式不一致导致静默错误
            required_columns = {"商品编码", "商品名称", "销售量", "单价"}
            if not required_columns.issubset(df.columns):
                print(f"[警告] 文件 {file_path.name} 缺少必要列,已跳过")
                continue

            # 增加来源标识列
            store_name = file_path.stem.replace("销售报表_", "")
            df["门店名称"] = store_name

            # 数据清洗:丢弃关键字段为空的脏数据
            df = df.dropna(subset=["商品编码", "销售量", "单价"]).copy()
            df["销售量"] = pd.to_numeric(df["销售量"], errors="coerce").fillna(0)
            df["单价"] = pd.to_numeric(df["单价"], errors="coerce").fillna(0.0)
            df["销售金额"] = df["销售量"] * df["单价"]

            all_records.append(df)
        except Exception as err:
            print(f"[错误] 解析 {file_path.name} 失败: {err}")

    if not all_records:
        print("[提示] 未找到符合要求的报表数据")
        return

    # 合并纵向数据为总明细表
    merged_df = pd.concat(all_records, ignore_index=True)

    # 按照商品聚合出汇总表
    summary_df = merged_df.groupby(["商品编码", "商品名称"], as_index=False).agg(
        总销售量=("销售量", "sum"),
        总销售额=("销售金额", "sum")
    ).sort_values(by="总销售额", ascending=False)

    # 写入至同一个Excel文件的不同Sheet
    with pd.ExcelWriter(output_path, engine="openpyxl") as writer:
        merged_df.to_excel(writer, sheet_name="全国明细汇总", index=False)
        summary_df.to_excel(writer, sheet_name="商品聚合分析", index=False)

    print(f"[完成] 汇总报表已成功生成至: {output_path}")

# 执行示例
if __name__ == "__main__":
merge_store_reports(input_dir="./reports", output_path="./全国销售汇总_202610.xlsx")pd.read_excel 中指定 dtype={"商品编码": str}。
三、场景二:自动化文件整理与分类归档实例
办公室常见的另一类耗时痛点是下载文件夹、桌面堆积的杂乱文件。手动根据扩展名、文件生成日期或文件名中的关键字建文件夹移动,极其繁琐且容易误拖拽。
Python 3.4起引入的 pathlib 模块相比于传统的 os.path,提供了完全面向对象且兼顾Windows与macOS路径规范的标准接口,配合 shutil 可以稳健完成文件分类。
实例:根据“日期+部门”关键字自动分流规整文档
业务场景:在“收件箱”文件夹下存放着大量来自不同业务线的文件,命名格式多为 财务部_2026-09结算单.pdf、市场部_第三季度策划.docx 等。目标是将它们归档到 已归档/所属年份/所属部门/ 的层级目录中,遇到未知格式的文件则移入 其他待核查/。
完整实现代码:
import re
import shutil
from pathlib import Path

def organize_inbox(inbox_dir: str, archive_root: str):
    inbox = Path(inbox_dir)
    archive = Path(archive_root)

    # 匹配文件名中的部门与年份(例如:财务部_2026-09结算单.pdf)
    rule_pattern = re.compile(r"^(?P<dept>[\u4e00-\u9fa5]+)_(?P<year>\d{4})")

    for item in inbox.iterdir():
        # 排除目录自身及隐藏文件
        if not item.is_file() or item.name.startswith("."):
            continue

        match = rule_pattern.match(item.stem)
        if match:
            dept = match.group("dept")
            year = match.group("year")
            # 构建分层归档路径:已归档/2026/财务部/
            target_folder = archive / year / dept
        else:
            # 未按规范命名的文件,移动至待审阅目录
            target_folder = archive / "未分类待核查"

        # 确保目标各级目录均已安全创建
        target_folder.mkdir(parents=True, exist_ok=True)
        target_path = target_folder / item.name

        # 解决同名文件冲突:若已有同名文件,添加递增计数后缀
        counter = 1
        stem = item.stem
        suffix = item.suffix
        while target_path.exists():
            target_path = target_folder / f"{stem}_{counter}{suffix}"
            counter += 1

        # 执行移动
        shutil.move(str(item), str(target_path))
        print(f"已归档: {item.name} -> {target_path.relative_to(archive)}")

# 执行示例
if __name__ == "__main__":
    organize_inbox(inbox_dir="./收件箱", archive_root="./已归档")
四、编写自动化脚本的核心原则与总结
在设计和落地任何办公自动化程序时,不仅要追求“能跑通”,更要关注“稳定性”与“安全性”,避免出现由于异常数据导致数据丢失或文件损毁的情况。
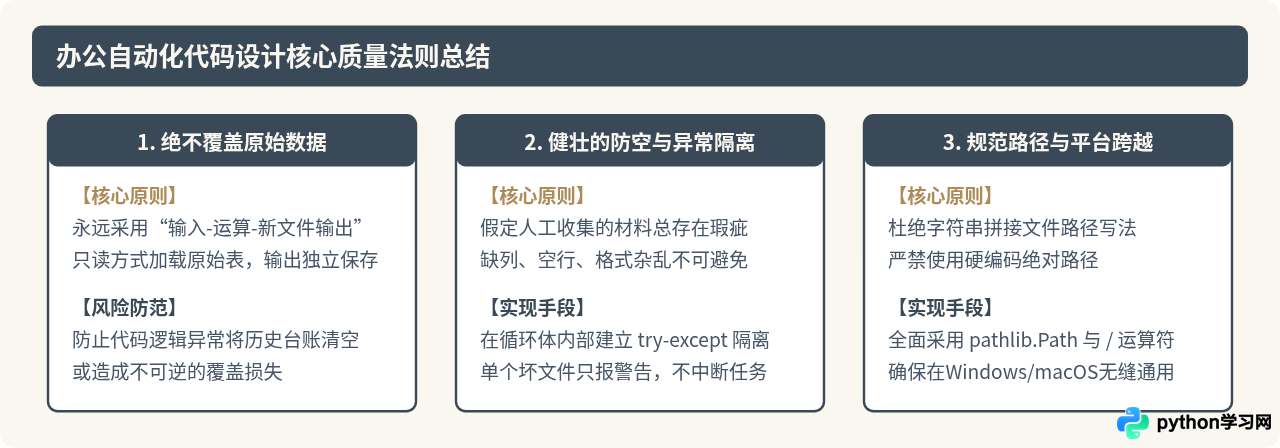
综上所述,Python在办公自动化领域的真正价值,在于把人力从低价值、易出错的重复性动作中释放出来。从简单的单表批量合并、文件分发起步,逐渐建立起标准化、流程化的工作习惯,不仅能将几小时的手工劳作缩短到数秒,更能根本杜绝人工处理中难以避免的漏填与误改。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









