

Python元组有什么用:不可变性带来的安全与性能优势
深入解析Python元组的核心作用,阐述不可变性如何带来数据防篡改、字典键安全等安全保障,以及CPython在紧凑内存布局与Free List对象复用上的显著性能优势。
一、不可变性构筑的数据安全屏障
在很多初学者看来,不可变性似乎是一种“能力限制”——无法执行 append()、pop() 或根据索引重赋值。但在实际软件工程中,这种不可变性恰恰是程序健壮性的关键保障。
1. 防止函数传参中的意外“副作用”
在 Python 中,所有变量传递的本质都是“传对象的引用”(Pass by object reference)。如果向一个函数传入列表等可变对象,函数内部对其进行的任何就地修改(In-place mutation),都会直接反映在调用者的外部变量上。这种隐式修改往往是复杂逻辑下难以排查的 Bug 根源。
# 环境:Python 3.8+
def process_data_list(data):
    # 模拟函数内部为了计算临时清洗或排序数据
    data.sort()
    data.pop()
    return sum(data)

def process_data_tuple(data):
    # 元组无法就地修改,如果需要排序必须显式创建新对象
    sorted_data = sorted(data)
    return sum(sorted_data[:-1])

# --- 列表的副作用表现 ---
raw_scores = [95, 82, 67, 100, 78]
result_list = process_data_list(raw_scores)
print("列表处理后原始变量被篡改:", raw_scores)
# 示例输出:列表处理后原始变量被篡改: [67, 78, 82, 95]

# --- 元组的防篡改保护 ---
fixed_scores = (95, 82, 67, 100, 78)
result_tuple = process_data_tuple(fixed_scores)
print("元组处理后原始变量完全安全:", fixed_scores)
# 示例输出:元组处理后原始变量完全安全: (95, 82, 67, 100, 78)
当业务逻辑涉及系统配置、全局基础数据或多线程共享数据时,将容器定义为元组能够从语法层直接阻断任何就地篡改代码,抛出明确的 TypeError: 'tuple' object does not support item assignment。
2. 可哈希性(Hashability):解锁字典键与集合元素
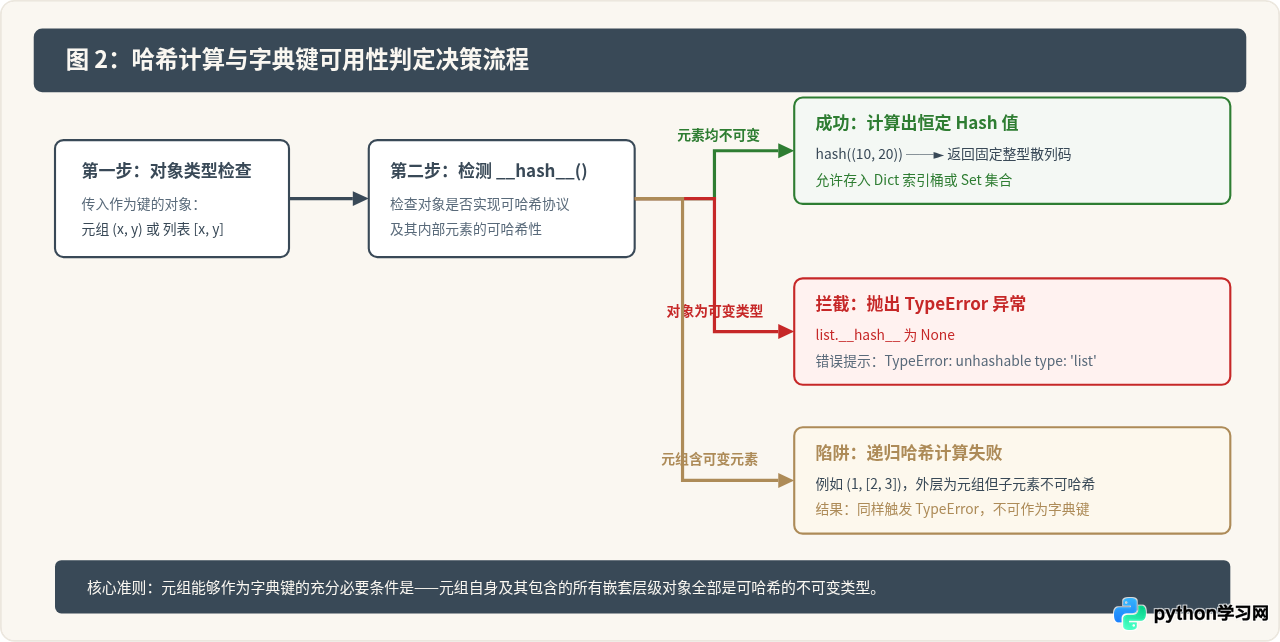
Python 的字典(dict)与集合(set)基于哈希表(Hash Table)实现,能实现近乎 $O(1)$ 的高速检索。其核心前提是:作为键的对象在其生命周期内必须拥有恒定不变的哈希值(满足 __hash__() 协议)。
如果允许列表作为字典键,一旦列表内容在外部被修改,该键的哈希值将发生变化,导致在底层哈希桶中永远无法根据旧键找到原数据,哈希表将彻底崩溃。因此,Python 严禁可变对象实现哈希协议。元组因其不可变性,成为了标准库中唯一支持多项组合的复合可哈希序列。
# 场景:利用坐标元组作为地图方格数据或图论权重的复合键
grid_weights = {}

# 使用元组作为二维坐标键(有效且语义清晰)
coord_tuple = (12, 45)
grid_weights[coord_tuple] = "Waypoint A"
print("字典按元组键读取成功:", grid_weights[(12, 45)])
# 示例输出:字典按元组键读取成功: Waypoint A

# 尝试使用列表作为键将直接报错
try:
    coord_list = [12, 45]
    grid_weights[coord_list] = "Waypoint B"
except TypeError as e:
    print("列表键执行异常:", e)
    # 示例输出:列表键执行异常: unhashable type: 'list'
元组的不可变性严格定义为:元组内部各个槽位所保存的内存地址(指针)不可变更。如果元组的某个槽位指向了一个可变对象(例如 t = (1, [2, 3])),虽然你无法将该槽位重新指向其他对象,但这个被指向的列表对象本身仍然可以被 t[1].append(4) 修改。此时该元组的哈希值将无法保持恒定,因此此类“包含可变对象的元组”在 Python 中会被禁止计算哈希。
二、不可变性带来的运行性能与内存优势
除了代码语义和数据安全,不可变性在解释器底层为元组换来了巨大的性能红利。主要体现在两方面:内存足迹的精简与对象创建/销毁的加速。
1. 紧凑的单块内存布局,零超额分配损耗
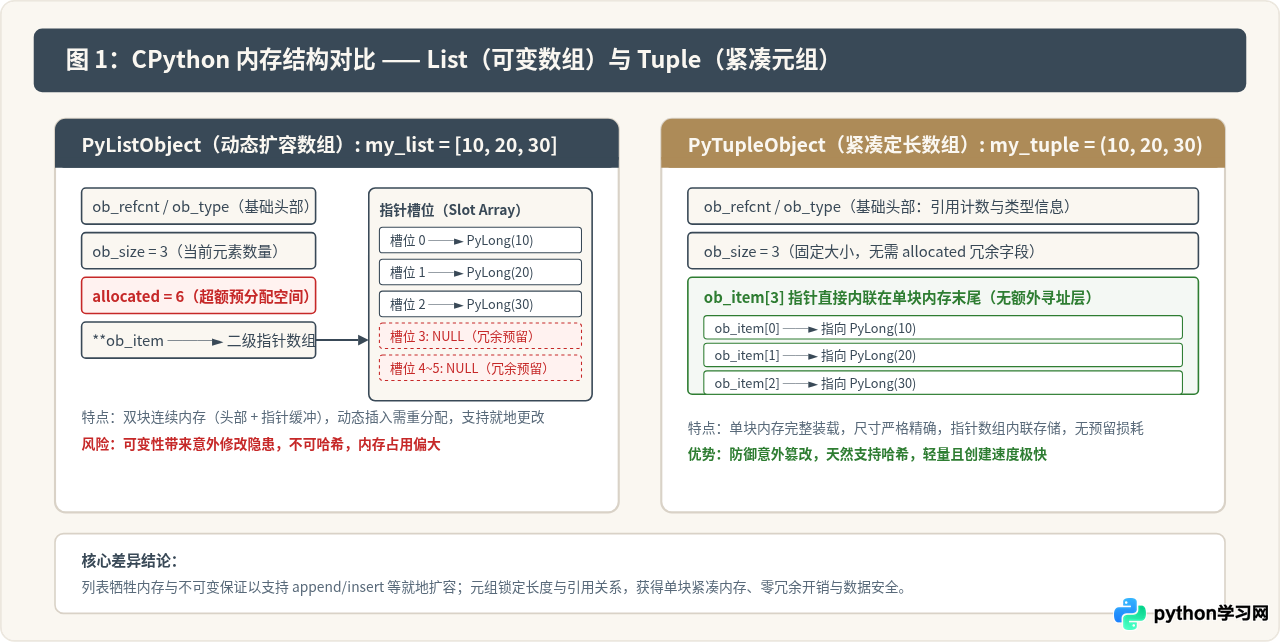
Python 列表是动态数组,为了在执行 append() 时维持均摊 $O(1)$ 的时间复杂度,CPython 采取了“超额预分配”(Over-allocation)策略。一个包含 3 个元素的列表,底层可能预留了容纳 6 个甚至更多元素的指针槽位。此外,列表分为 PyListObject 头部结构体和外部存储指针数组两块分散的内存空间。
而元组在初始化时长度就已固定,CPython 在创建 PyTupleObject 时,会将元素指针数组直接作为柔性数组嵌入在结构体末尾。这意味着:
- 单次分配:创建元组只需要调用一次系统内存分配函数,减少堆碎片。
- 零冗余插槽:完全没有空置的预留槽位,内存利用率达到 100%。
- 缓存友好:结构体与指针紧凑连续排列,利于 CPU L1/L2 高速缓存预取。
import sys

# 对比空容器与固定长度容器的内存字节数 (64位 CPython 3.10+)
empty_list = []
empty_tuple = ()

small_list = [1, 2, 3]
small_tuple = (1, 2, 3)

print("空列表内存字节:", sys.getsizeof(empty_list))      # 示例输出:56
print("空元组内存字节:", sys.getsizeof(empty_tuple))     # 示例输出:40

print("3元素列表内存字节:", sys.getsizeof(small_list))   # 示例输出:88
print("3元素元组内存字节:", sys.getsizeof(small_tuple))  # 示例输出:64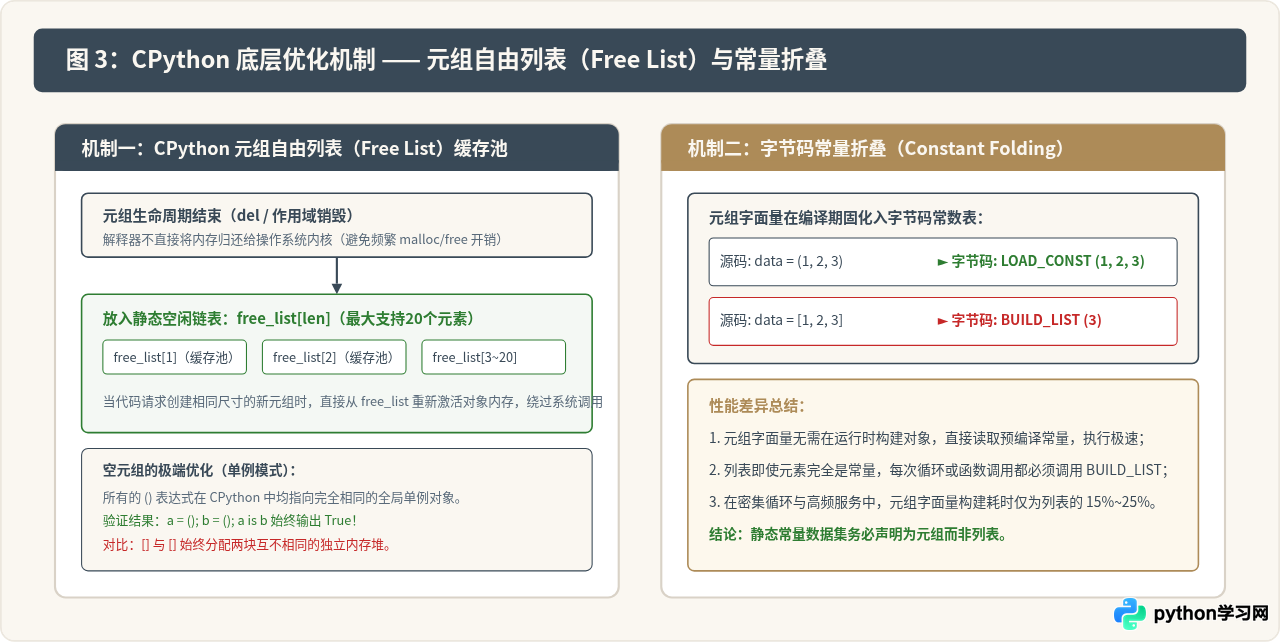
2. CPython 自由列表与常量折叠带来的构建提速
不可变性意味着元组一旦创建就不必担心状态被外部篡改。基于这个前提,CPython 内部对元组实施了极富成效的微架构优化:
- 空元组单例:由于空元组不可变且无状态,无论代码中创建多少次
()或tuple(),解释器均返回同一个单例对象(a = (); b = (); a is b 为 True)。而对于列表,[] is []则恒为False,必须次次分配堆内存。 - Free List 内存池复用:长度在 1 到 20 之间的元组在被回收时,CPython 维护了一个长度为 20 的空闲链表数组。元组销毁时不释放内存回操作系统,新元组创建时直接复用旧插槽,节约了极其昂贵的
malloc系统调用开销。 - 编译期常量折叠:编写
a = (1, 2, 3)时,Python 编译器在生成字节码阶段就直接将其作为一个固化常量写入co_consts,运行时仅需单条LOAD_CONST指令;而a = [1, 2, 3]则必须在运行时执行BUILD_LIST进行动态堆分配与逐个元素填装。
import timeit

# 在相同环境下分别执行 10,000,000 次字面量初始化
tuple_time = timeit.timeit(stmt="(1, 2, 3, 4, 5)", number=10_000_000)
list_time = timeit.timeit(stmt="[1, 2, 3, 4, 5]", number=10_000_000)

print(f"元组构建总耗时: {tuple_time:.4f} 秒")
print(f"列表构建总耗时: {list_time:.4f} 秒")
print(f"元组相比列表提速约为: {list_time / tuple_time:.2f} 倍")

# 典型硬件平台测试示例输出:
# 元组构建总耗时: 0.0825 秒
# 列表构建总耗时: 0.4351 秒
# 元组相比列表提速约为: 5.27 倍
三、典型工程场景与选型决策指南
掌握了底层机制后,我们来看在真实的生产代码中,元组究竟应该在哪些场景下大显身手。
1. 函数多返回值与优雅的解包赋值
Python 语法允许函数在 return 处直接用逗号隔开多个变量,例如 return x, y, status。这里解释器实际上是将它们打包(Pack)成了一个元组返回。接收端配合解包(Unpack)语法,既保证了返回数据不会在传输过程中被意外修改,又使代码表现力高度清晰:
def fetch_user_location(user_id: int):
    # 模拟从传感器或数据库读取数据
    lat = 39.9042
    lng = 116.4074
    city = "Beijing"
    return lat, lng, city  # 隐式构造元组 (lat, lng, city)

# 优雅解包
latitude, longitude, city_name = fetch_user_location(1001)
print(f"解析成功: {city_name} -> 经度:{longitude}, 纬度:{latitude}")
# 示例输出:解析成功: Beijing -> 经度:116.4074, 纬度:39.9042
2. 结构化记录(Records)与 NamedTuple 语义进阶
在传统编程中,列表通常用来保存同构数据(Homogeneous Data,即一组同类事物的集合,如一列待办任务);而元组更适合用来表达异构记录(Heterogeneous Records,即一条数据中的多个固定字段,如员工档案 (name, age, department))。
如果纯元组通过数字索引 record[0]、record[1] 访问导致代码可读性下降,可以使用标准库 collections.namedtuple 或 typing.NamedTuple。它们完全继承了元组不可变性与紧凑低内存的性能优势,同时赋予了字段名属性访问支持:
from typing import NamedTuple

class ConnectionPoint(NamedTuple):
    host: str
    port: int
    timeout: float = 5.0

# 实例化结构化记录
endpoint = ConnectionPoint(host="192.168.1.100", port=8080)

# 支持属性名访问,语义清晰
print(f"连接目标: {endpoint.host}:{endpoint.port}")
# 示例输出:连接目标: 192.168.1.100:8080

# 依然保留不可变安全约束
try:
    endpoint.port = 9000
except AttributeError as e:
    print("安全拦截:", e)
    # 示例输出:安全拦截: can't set attribute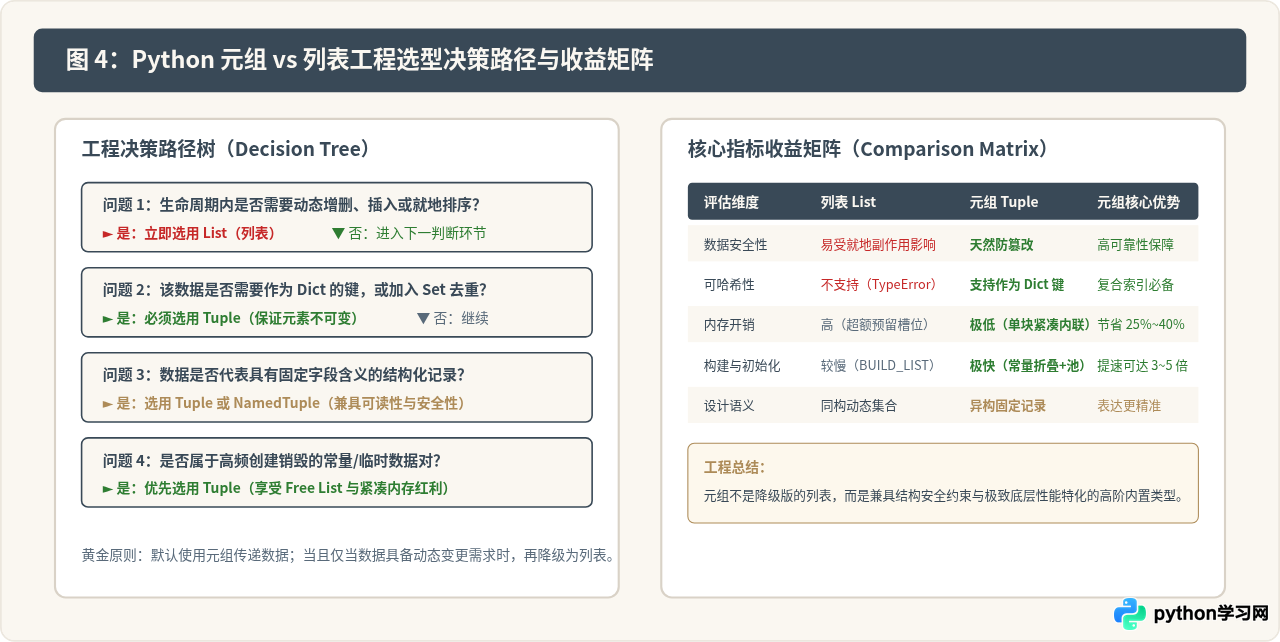
四、避坑指南:容易混淆的常见陷阱
1. 单元素元组的逗号陷阱
在 Python 中,真正定义元组的符号是逗号,而不是圆括号。圆括号通常仅充当语法优先级分组运算符。因此:
# 错误写法:没有逗号,括号被当成数学优先级括号
not_a_tuple = (42)
print(type(not_a_tuple))
# 示例输出:<class 'int'>

# 正确写法:末尾必须保留逗号
real_single_tuple = (42,)
print(type(real_single_tuple))
# 示例输出:<class 'tuple'>
2. 元组“拼接”并不违反不可变性
初学者有时会看到这样的代码:
t = (1, 2)
t += (3, 4)
print(t)  # 输出 (1, 2, 3, 4)
这是否意味着元组被就地修改了?并没有。通过 id() 检查可以发现:执行 += 之后,变量 t 绑定的是由解释器分配的一块全新的内存空间,旧的 (1, 2) 对象并没有被修改,而是引用计数减一等待垃圾回收。如果在高频循环中不断通过 += 拼接元组,会频繁创建销毁对象,此时应使用列表收集元素,最后再通过 tuple(list_data) 批量固化。
五、总结
回到文章开头的核心问题——“Python 元组有什么用”:
- 在语义与安全层面:不可变性向代码阅读者和运行环境给出了强烈的“只读”承诺,有效切断了函数间共享可变引用的意外副作用,同时天然满足可哈希协议,成为构建多维字典键与集合去重的基石。
- 在底层性能层面:不可变性使 CPython 摆脱了动态扩容的冗余负担,实现了无额外指针跳转的单块紧凑内存布局;借助编译期常量折叠与自由列表(Free List)对象复用,带来了极低的内存消耗与显著的构建速度优势。
在日常开发中,对于只读的常量配置、坐标或维度信息、数据库记录行以及函数多返回值,养成优先使用元组(或其衍生品 NamedTuple)的习惯,能够让你的 Python 程序兼具更高的健壮性与更优异的执行效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









