

NumPy、SciPy与PyTorch:Python矩阵运算库怎么选
深入对比NumPy、SciPy与PyTorch三大Python矩阵运算库的底层机制、硬件加速能力、稀疏计算与自动微分特性,提供清晰的选型决策树与工程实践指南。
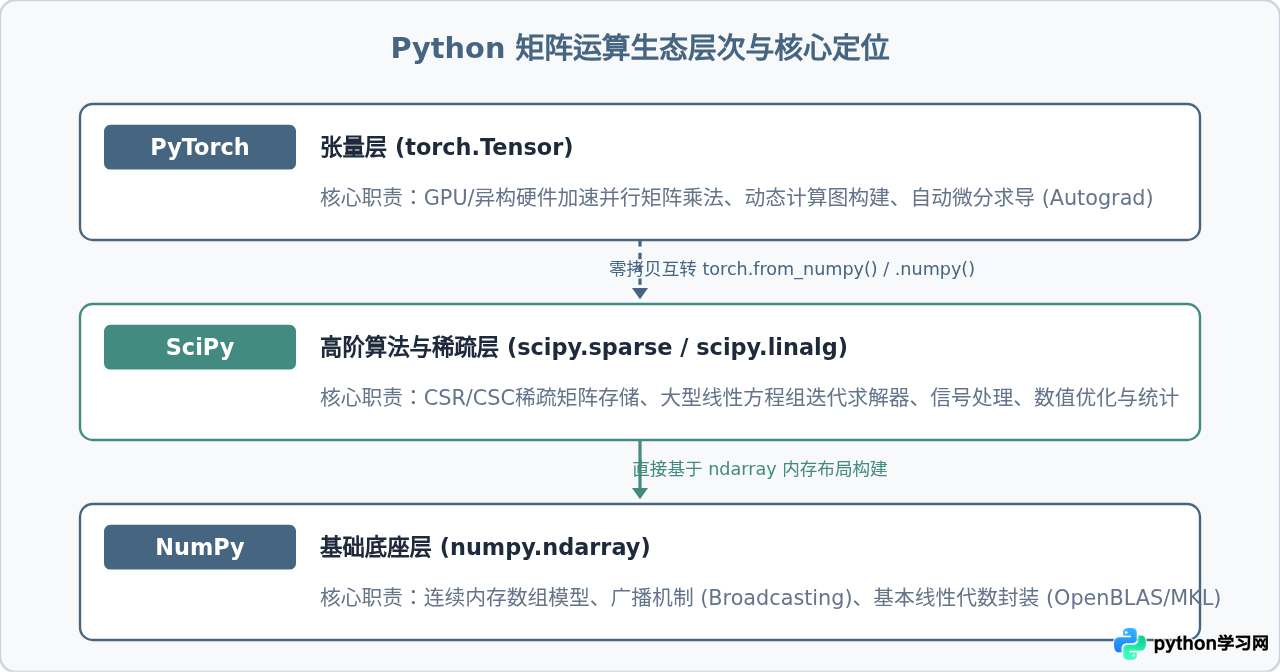
在 Python 数值计算与工程建模中,NumPy、SciPy 和 PyTorch 并不是非此即彼的排他竞争关系,而是一套分工明确、层级互补的工具矩阵。NumPy 构成了整个 Python 科学计算的连续内存数组底座,提供轻量、低开销的常规矩阵操作;SciPy 在 NumPy 的基础上承接复杂科学算法,以高阶稀疏矩阵和专业数值求解器见长;而 PyTorch 则跳出传统 CPU 局限,利用张量结构提供原生硬件加速(GPU/TPU/NPU)与动态自动微分支持。选型的核心依据在于三个明确条件:计算规模与硬件平台、数据是否具备高稀疏性与高阶数学运算需求,以及是否涉及梯度推导与参数优化。
一、三大库的核心定位与底层对象区别
理解选型的第一步是明确它们在内存中所操作的核心数据结构。很多开发者容易将张量(Tensor)与多维数组(ndarray)混为一谈,但两者的底层设计目标存在本质差异:
- NumPy(核心对象:ndarray):专注基于 CPU 的紧凑、连续多维数组。其底层通过 C 语言结构体维护数据指针、步长(Strides)与数据类型(dtype),直接调用底层系统 BLAS/LAPACK 库执行稠密矩阵乘法。其优势是无任何深度学习框架的初始化包袱,内存开销极低。
- SciPy(核心对象:sparray 与 ndarray):定位于高阶科学算法库。除直接兼容 NumPy 数组外,SciPy 提供专门的稀疏矩阵结构(如 CSR、CSC、COO 等)。当矩阵规模达到数万维甚至百万维、但非零元素极少时,SciPy 能以极小的内存占用完成矩阵求解。
- PyTorch(核心对象:torch.Tensor):定位于异构加速计算与可微张量。PyTorch 张量在结构上记录了设备位置(CPU/CUDA/MPS)以及计算历史有向无环图(DAG),每个前向矩阵操作都会按需构建反向求导节点。
二、维度一:算力硬件与计算规模(CPU vs GPU)
决定选择 NumPy 还是 PyTorch 的最显著硬件界限是加速芯片(GPU/TPU)的可用性与矩阵乘法的吞吐量需求。
对于中小型稠密矩阵(如维度在 2000×2000 以内),NumPy 在现代多核 CPU(配备 AVX2/AVX-512 指令集与 Intel MKL 或 OpenBLAS)上的表现已经非常优秀。此时盲目将数据送入 PyTorch GPU 运算,往往会导致更慢的实际执行时间。原因在于主机内存(Host RAM)与显存(Device VRAM)之间的 PCIe 数据搬运开销(Host-to-Device 传输)远高于小规模矩阵运算本身的时间消耗。
当满足以下两个条件时,PyTorch 才是绝对优势方案:
- 矩阵维度达到数万阶,或者批处理矩阵乘法(Batch Matrix Multiplication,形如
[B, N, K] × [B, K, M])规模极大,能够充分填满显卡成千上万个流处理器。 - 数据常驻显存,连续进行链式矩阵运算,单次数据传输开销被多次矩阵计算平摊。
import numpy as np
import torch
import time

# 示例:NumPy CPU 矩阵乘法 vs PyTorch GPU 矩阵乘法
size = 4000

# 1. NumPy (运行在 CPU 上,调用系统底层 BLAS 线程池)
A_np = np.random.randn(size, size).astype(np.float32)
B_np = np.random.randn(size, size).astype(np.float32)

t0 = time.perf_counter()
C_np = A_np @ B_np
print(f"NumPy CPU 耗时: {time.perf_counter() - t0:.4f} 秒")

# 2. PyTorch (运行在 GPU 上,需注意显存传输与异步执行同步)
if torch.cuda.is_available():
    # 零拷贝将内存映射为 CPU 张量,再转移至 CUDA
    A_th = torch.from_numpy(A_np).cuda()
    B_th = torch.from_numpy(B_np).cuda()
    torch.cuda.synchronize()

    t1 = time.perf_counter()
    C_th = torch.matmul(A_th, B_th)
    torch.cuda.synchronize() # 必须同步等待 GPU 流完成,测量真实耗时
    print(f"PyTorch CUDA 耗时: {time.perf_counter() - t1:.4f} 秒")
注意数值默认精度的差异:NumPy 在浮点数创建时默认采用双精度 float64(64 位),而 PyTorch 为了兼顾神经网络训练的显存利用率与算力吞吐,默认采用单精度 float32(32 位)。对比两库性能前,务必统一样本的数据类型,否则测试结果会出现严重失真。
三、维度二:稀疏矩阵与高阶科学求解(SciPy 的独占优势)
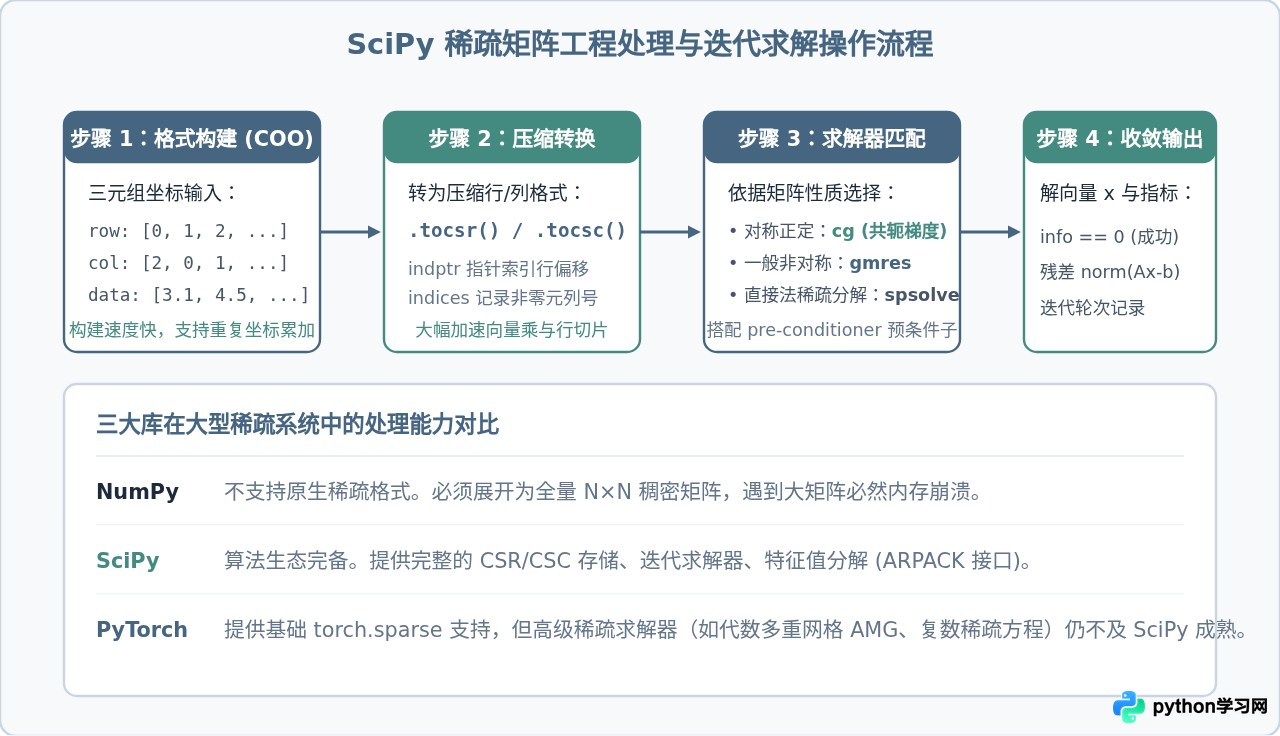
当遇到图计算(邻接矩阵)、网格离散化、有限元力学仿真或大型文本词频矩阵时,矩阵的维度可能高达 100,000×100,000,但其中 99% 以上的元素均为 0。若使用 NumPy 或 PyTorch 的常规稠密格式存储,仅单个矩阵就需要数十吉字节(GB)的物理内存,直接引发 OOM(内存溢出)。
这正是 SciPy 的绝对主场。SciPy 提供了 7 种专用的稀疏存储格式(如用于高效构造的 coo_array,以及用于快速矩阵运算与切片的 csr_array 和 csc_array),并在 scipy.sparse.linalg 中集成了成熟的 Krylov 子空间迭代求解器(如 GMRES、BiCGSTAB、共轭梯度法 CG)。
import scipy.sparse as sp
import scipy.sparse.linalg as spla
import numpy as np

# 示例:求解 50,000 阶大型稀疏泊松方程 Ax = b
n = 50000

# 构造主对角线与次对角线元素 (使用三对角稀疏矩阵)
main_diag = 2.0 * np.ones(n)
off_diag = -1.0 * np.ones(n - 1)

# 生成 CSR 格式稀疏矩阵(仅存储非零元素,内存占用仅数百 KB)
A_sparse = sp.diags([off_diag, main_diag, off_diag], [-1, 0, 1], format='csr')
b = np.ones(n)

# 选用 SciPy 预条件共轭梯度法 (Conjugate Gradient) 迭代求解
x, exit_code = spla.cg(A_sparse, b, rtol=1e-6)

print(f"求解状态码 (0表示正常收敛): {exit_code}")
print(f"解向量前 3 项: {x[:3]}")
四、维度三:梯度计算与可微编程(PyTorch 的核心壁垒)
在传统的矩阵代数中,我们通常关注直接求解结果;但在现代机器学习、科学机器学习(SciML,如物理信息神经网络 PINN)以及参数反演中,核心诉求是对矩阵运算链条关于某个输入矩阵求一阶偏导数(梯度)或二阶导数(Hessian 矩阵)。
NumPy 与 SciPy 本身都是无求导感知(Non-differentiable)的库。如果需要利用梯度下降优化矩阵参数,使用 NumPy 必须手动推导代数导数解析式,一旦公式变更就需要重新推导。而 PyTorch 内置的 autograd 引擎,能够在执行常规矩阵乘法、转置、SVD、求逆的同时,自动追踪前向图并在后台反向传播梯度:
import torch

# 示例:通过 PyTorch 自动微分求解矩阵方程参数拟合
# 目标:寻找最佳矩阵 W,使得 ||X @ W - Y||^2 最小
X = torch.randn(100, 10, requires_grad=False)
Y = torch.randn(100, 5)

# 初始化待学习矩阵 W,开启自动求导跟踪
W = torch.randn(10, 5, requires_grad=True)

# 前向矩阵乘法
loss = torch.sum((X @ W - Y) ** 2)

# 反向自动求导:自动计算 d(loss)/dW
loss.backward()

print("W 的梯度张量形状:", W.grad.shape)
# 随后可直接执行梯度更新:W.data -= lr * W.grad
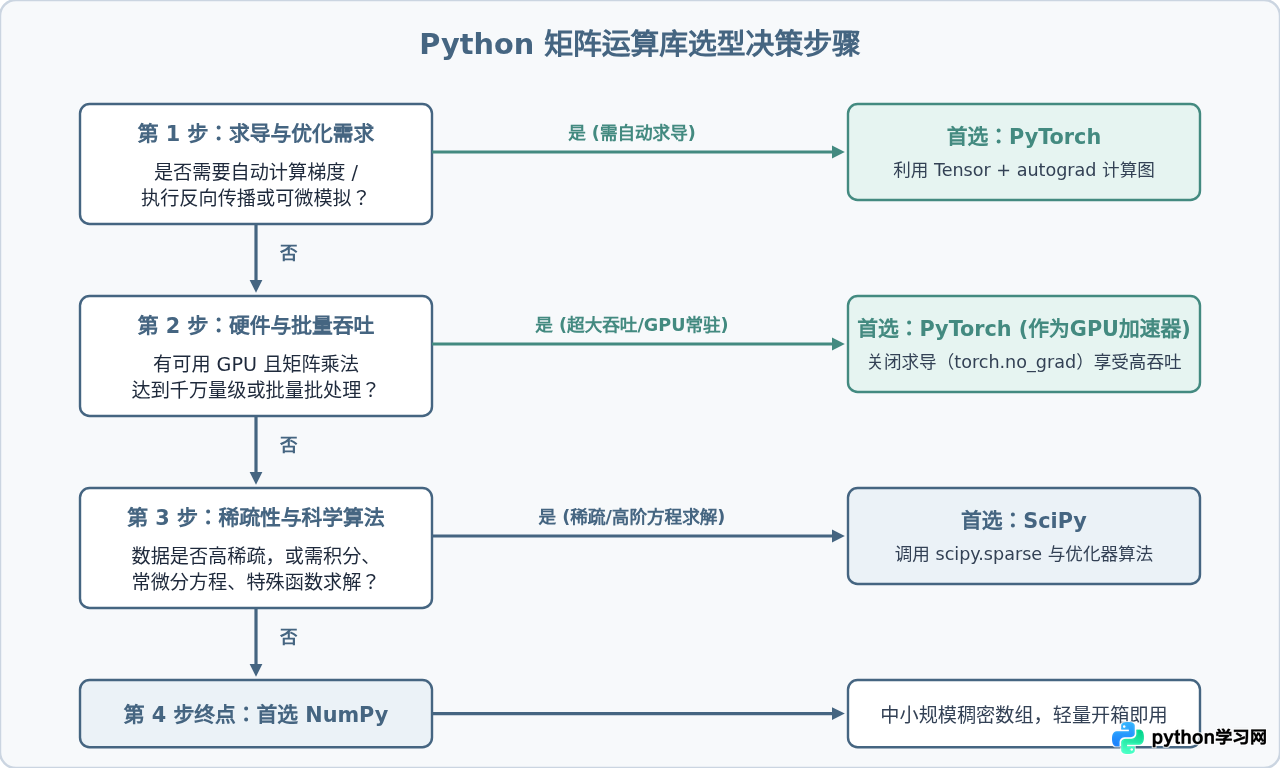
五、选型决策路径:四步推导最佳方案
为避免在实际项目启动时反复重构代码,推荐通过以下四个递进步骤完成选型推导:
六、全景对照与典型工程组合实践
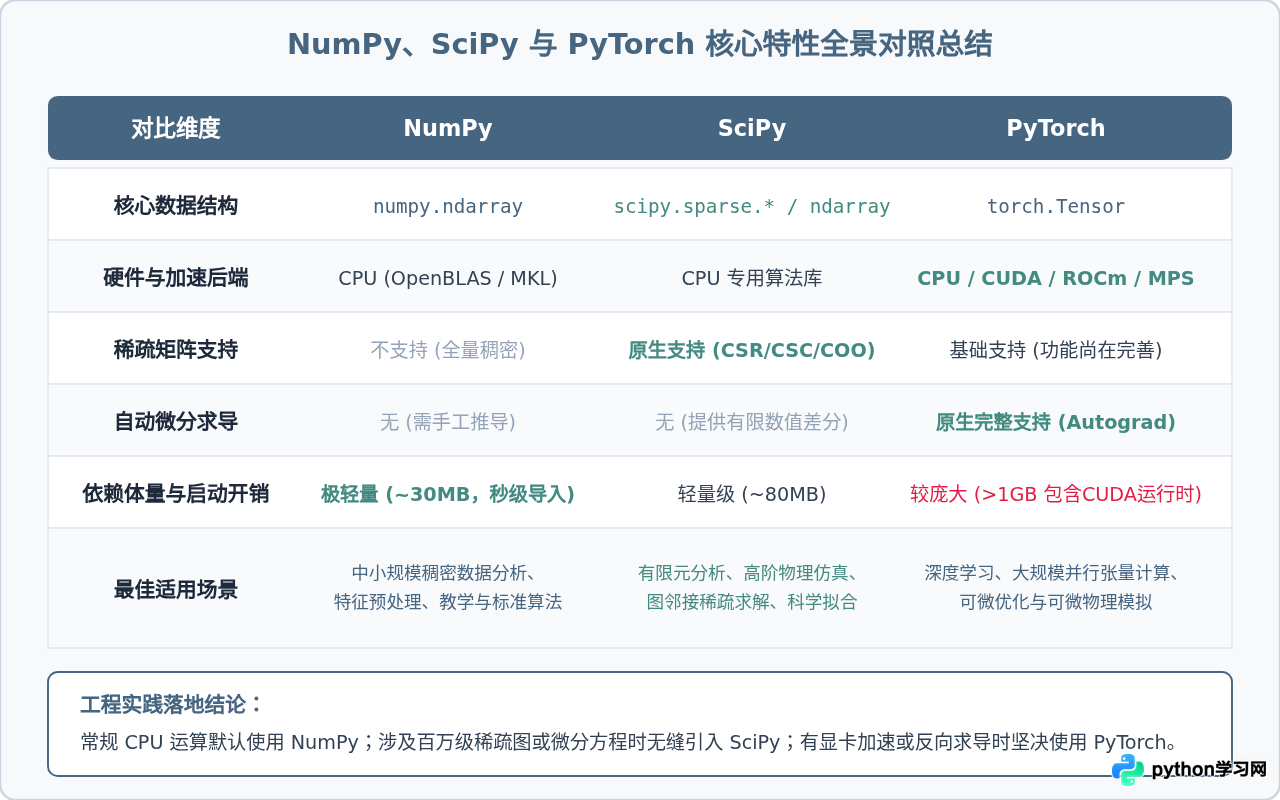
在复杂的工业级项目中,优秀的架构师往往不会局限于单选某一个库,而是采用组合流水线(Pipeline)的方式发挥各自优势。例如:
- 前端数据清洗与离散化:在 CPU 上使用 NumPy 和 Pandas 进行格式清洗与特征截断;
- 大型稀疏网络构建:使用 SciPy 建立 CSR 邻接矩阵并完成拉普拉斯算子计算与特征分解;
- 神经网络训练与推理:通过
torch.from_numpy()将经过 SciPy 处理后的密集特征无损送入 GPU 进行端到端训练。
七、选型避坑与迁移注意事项
-
内存视图(View)与副本(Copy)陷阱:
NumPy 和 PyTorch 的基本切片操作(如a[::2])默认只创建视图,与原矩阵共享底层存储指针。修改切片内容会直接污染原数据。如果需要独立副本,NumPy 需显式调用.copy(),PyTorch 需显式调用.clone()。 -
NumPy 与 PyTorch 的无缝桥接:
通过torch.from_numpy(arr)可以实现完全零内存拷贝的数据接入(只要两者均驻留在 CPU 内存上),修改其中一方会直接反映在另一方;若要在 GPU 张量转回 NumPy,必须先显式调用tensor.detach().cpu().numpy()断开计算图并同步至主机内存。 -
多线程与 OpenMP 调度冲突:
NumPy 底层由 OpenBLAS/MKL 多线程驱动,PyTorch 同样有自己的内部线程池管理。在多进程(如multiprocessing或 DataLoader)场景下混合使用时,容易出现 CPU 线程过度争用导致卡顿。建议在脚本开头通过环境变量export OMP_NUM_THREADS=1和torch.set_num_threads(1)规范线程配额。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









