

Python读取文件编码报错怎么办?io模块encoding参数设置
针对Python读取文件时频繁出现的UnicodeDecodeError编码报错,深入剖析字符编解码机制,系统讲解open与io模块中encoding参数的正确设置方法、常见编码匹配规则及errors容错策略。
UnicodeDecodeError,根本原因在于程序选用的“解码规则”与文件在磁盘上实际存储的“二进制字节编码”不匹配。核心解决方案非常直接:不要依赖操作系统的默认缺省设置,在内置 open() 或 io.open() 函数中显式传入 encoding 参数(如 encoding='utf-8' 或 encoding='gbk')。本文将系统拆解报错产生的内部机制、排查路径及容错参数的使用边界。
一、编码报错的表现与根本成因
Python 读取文件通常抛出两类最具代表性的编码异常:一类是 UnicodeDecodeError: 'gbk' codec can't decode byte... in position...: illegal multibyte sequence;另一类则是 UnicodeDecodeError: 'utf-8' codec can't decode byte... in position...: invalid start byte。
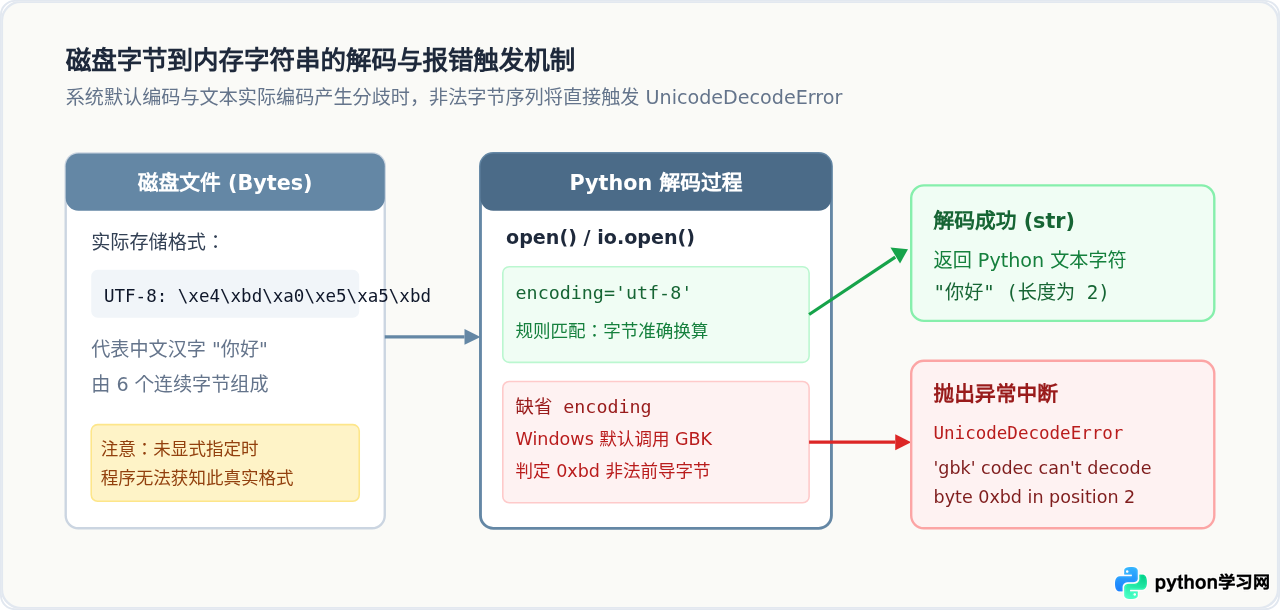
为什么会出现这种情况?计算机磁盘中保存的文件本质上只有一连串的 0 和 1(二进制字节流)。当 Python 试图将其作为文本读取时,必须经过“解码”(Decode)过程,即依据某套规则将特定字节组合转换为内存中的字符对象(str)。
在很多初学者编写的代码中,通常直接调用 open('data.txt', 'r') 而未声明编码。在 Python 3 中,当缺省 encoding 时,底层会自动调用 locale.getpreferredencoding(False) 获取操作系统当前的本地化默认编码。在中文 Windows 环境下,该默认值通常是 cp936(兼容 GBK);而在现代开发环境中,绝大多数源代码、接口数据和网页文件都采用 UTF-8 保存。这种“以 GBK 规则去解析 UTF-8 字节流”的操作,遇到多字节中文时必然会因字节模式不合规而中断崩溃。
二、核心解决步骤:使用 encoding 参数显式指定编码
在 Python 3 中,内置的 open() 实际上由标准库中的 _io 模块实现,它与 io.open() 完全等价。要在读取时消除编码报错,最基础也是最核心的动作是:无论什么操作系统,读取任何文本文件都显式传入 encoding 参数。
1. 正确的基础读取示范
当读取常见的 UTF-8 编码文件时,使用 with 语句配合显式 encoding='utf-8' 能够保证资源释放与编码确定性:
# 显式指定 encoding 参数读取标准 UTF-8 文本
file_path = "document.txt"

try:
    with open(file_path, mode="r", encoding="utf-8") as f:
        content = f.read()
        print("文件读取成功,内容前50字符:")
        print(content[:50])
except UnicodeDecodeError as err:
    print(f"解码失败: {err}")
except FileNotFoundError:
print(f"指定文件不存在: {file_path}")Python 数据处理全流程:规范配置与字符集统一设置指南。
2. 当文件原本是 GBK / GB2312 编码时
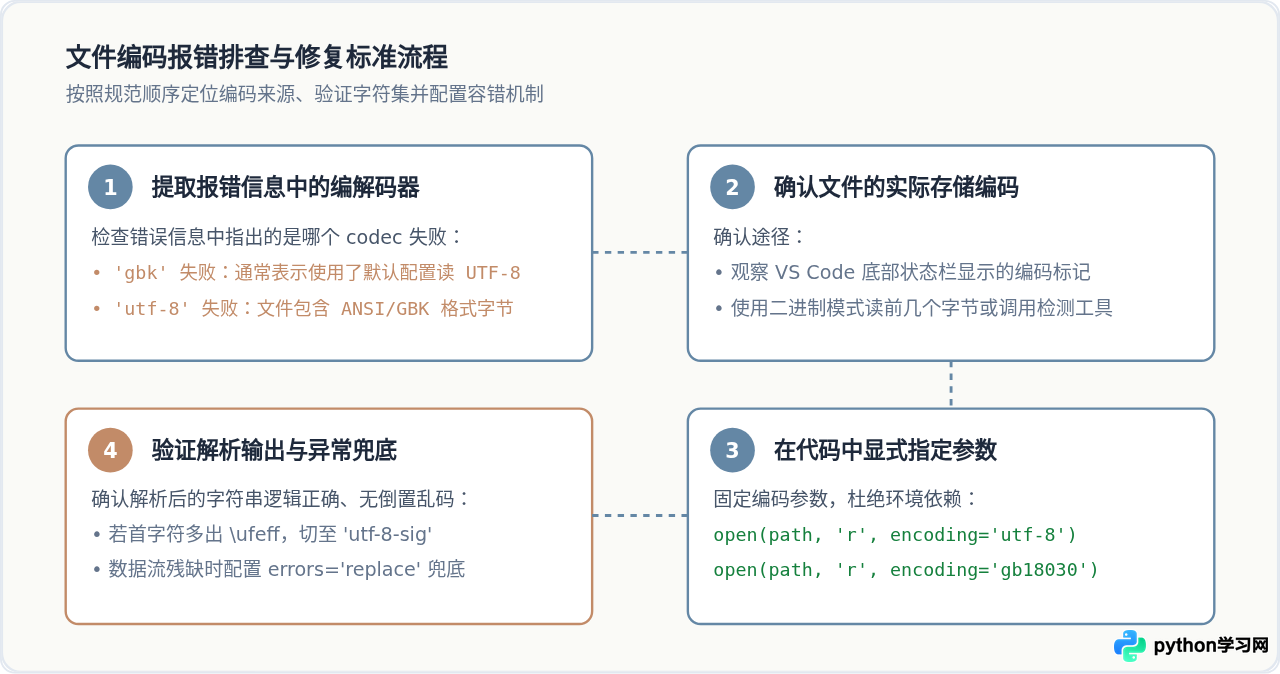
如果目标文件是老旧系统导出、Excel 保存的中文 CSV 或者历史工程遗留的文本,它的底层可能是 GBK。若此时强行使用 encoding='utf-8',控制台将报错:'utf-8' codec can't decode byte 0xc4...。此时应将参数相应更改为:
# 针对 GBK / 扩展国标编码的文件
with open("legacy_data.csv", mode="r", encoding="gbk") as f:
    data = f.read()

# 推荐写法:如果遇到生僻字,可使用字符集更全的 gb18030
with open("legacy_data.csv", mode="r", encoding="gb18030") as f:
data = f.read()gb18030 是向下完全兼容 gbk 和 gb2312 的国家标准编码,收录了更多少数民族文字和繁体、生僻汉字。如果使用 gbk 读取依然偶发报错,可直接替换为 gb18030。
三、深入特殊场景:BOM 标记与 errors 容错策略
在实际工程开发中,即便显式指定了 encoding='utf-8',依然可能遇到两类特殊障碍:其一是 Windows 系统软件写入的 BOM(Byte Order Mark) 导致首字符乱码;其二是文件损坏、网络传输截断导致的脏字节。
1. 带 BOM 的 UTF-8 文件与 utf-8-sig
Windows 记事本等工具在保存 UTF-8 文本时,经常会在文件头部写入三个不可见的标识字节:0xEF, 0xBB, 0xBF。如果直接用标准的 encoding='utf-8' 读取,Python 会将这三个字节解析为特殊的零宽无中断空格字符 \ufeff。在解析字典键名或 JSON 文件时,这会导致 KeyError: '\ufeffid' 这类难以肉眼察觉的 Bug。
解决方案:使用专门处理签名标记的 encoding='utf-8-sig'。该编码器在读取时会自动检测并跳过开头的 BOM 标记;若没有 BOM,它也能当作普通 UTF-8 正常读取。
# 自动过滤文件头部 BOM 字符的稳定写法
with open("windows_exported.txt", mode="r", encoding="utf-8-sig") as f:
    clean_text = f.read()
    # clean_text 开头不会附带 \ufeff 字符
2. errors 参数的四大策略
在 io.open() 或 open() 中,除了 encoding 之外,还有一个关键参数:errors。它决定了在遇到无法解析的字节序列时,程序应如何响应。
| 参数值 | 响应行为 | 典型适用场景 |
|---|---|---|
'strict' (默认) |
直接抛出 UnicodeDecodeError 异常中断执行 |
核心配置、严密业务数据校验,不允许丢失任何字符 |
'replace' |
用 Unicode 官方替换字符 |
日志分析、网页正文提取等允许极少量生僻字被占位的场景 |
'ignore' |
直接忽略并丢弃非法字节,静默继续解析 | 对连续文本完整度要求不高、仅需提取局部可用信息的流程 |
'surrogateescape' |
将非法字节转义存入特定高位私有码点,写回时可还原 | 系统底层工具、Linux 文件名处理(保持二进制往返一致) |
# 在允许局部容错的大文本或日志分析中组合使用
log_file = "service_runtime.log"

with open(log_file, mode="r", encoding="utf-8", errors="replace") as f:
    for line in f:
        # 非法字节被自动替换为 ,循环不会中途崩溃中断
        if "ERROR" in line:
            process_log_line(line)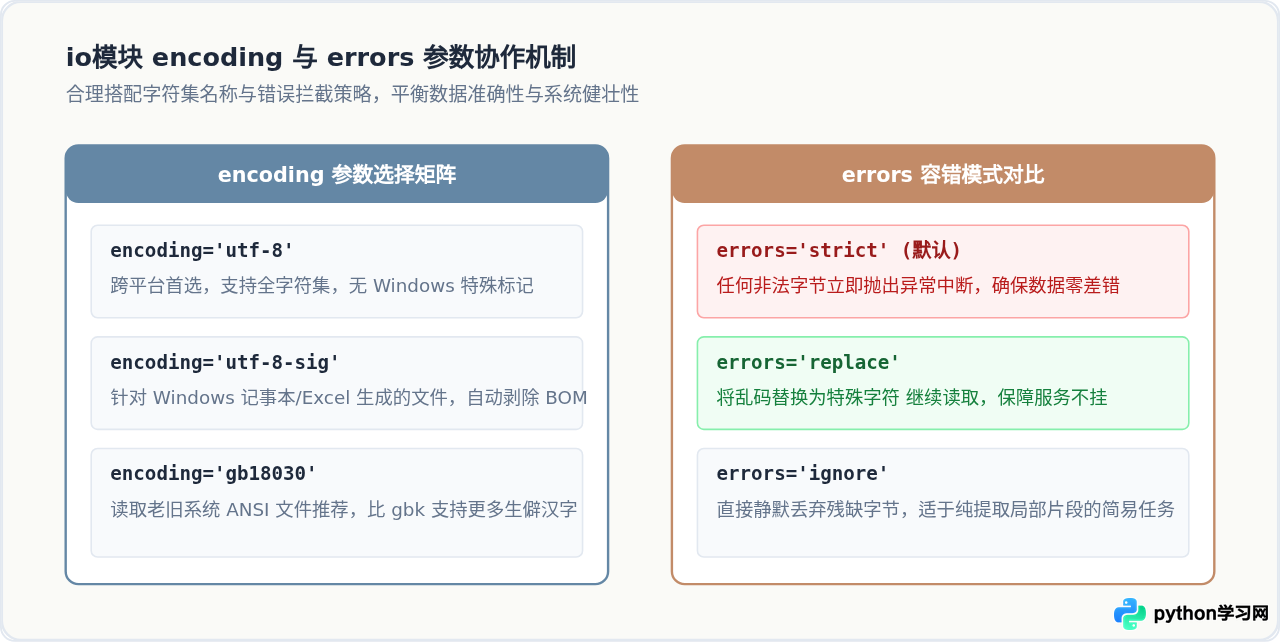
四、动态检测未知文件编码的实用技巧
在批量处理用户上传的数据、或者采集不可控网络接口产出的离线文件时,往往无法预先得知真实编码。若盲目尝试编码,可能导致业务逻辑因漏判而崩溃。
对此,标准解决思路是:以二进制模式('rb')读取前几个字节或前数千字节样本,利用概率统计模型进行快速探测,确认后再开启文本解码。在 Python 生态中,通常使用 charset_normalizer(现代标准库推荐)或 chardet 完成探测。
# 自动化检测未知文本编码的完整范式
import charset_normalizer

def read_file_safely(file_path):
    # 步骤一:先以二进制读取前 10KB 样本进行编码猜测
    with open(file_path, "rb") as raw_f:
        sample_bytes = raw_f.read(10240)

    # 步骤二:检测可能的编码格式
    detection = charset_normalizer.detect(sample_bytes)
    detected_encoding = detection.get("encoding") or "utf-8"

    print(f"探测到文件 [{file_path}] 编码格式为: {detected_encoding}")

    # 步骤三:使用探测出的真实编码重新打开
    with open(file_path, "r", encoding=detected_encoding, errors="replace") as text_f:
        return text_f.read()

# 示例调用
# text_data = read_file_safely("unknown_source_data.txt")
五、工程总结与速查清单
处理 Python 文件读取编码问题并不复杂,关键在于养成规范的代码书写习惯,摒弃“默认运行在自己电脑上没问题就不传参”的隐患写法。
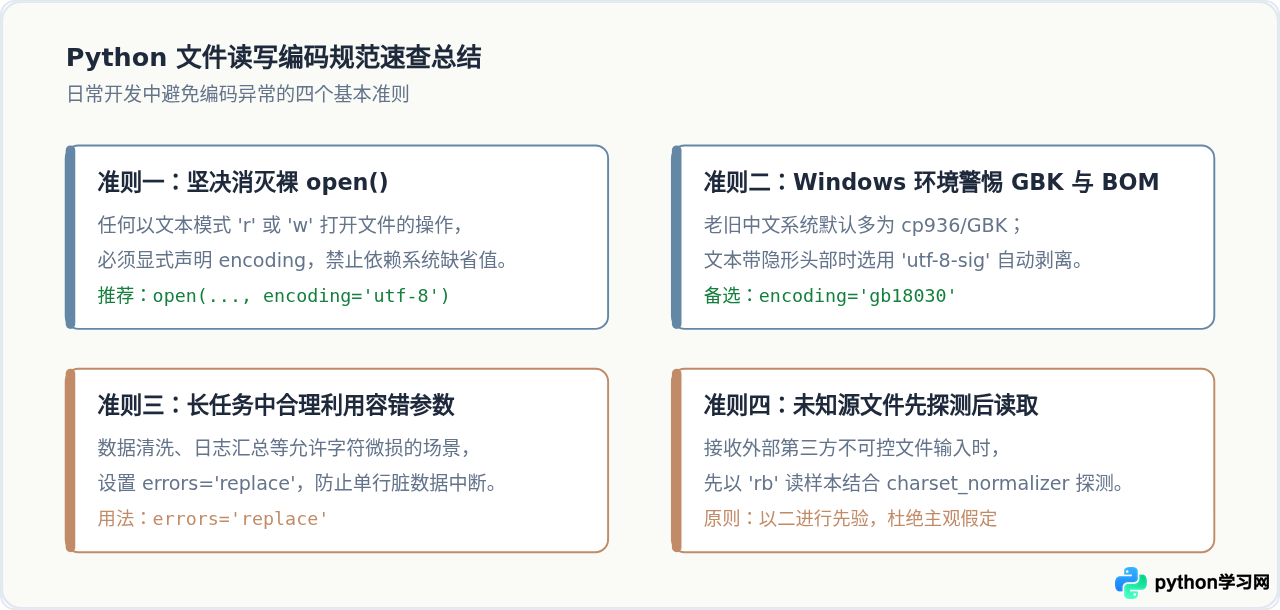
遵循以上规范,在编写文件 I/O 逻辑时形成显式声明 encoding 与必要时搭配 errors 的习惯,便可彻底解决跨平台与多源文件处理中的编码报错困扰。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









