

Python二分查找要求数据有序吗?线性查找对比
深入解析Python二分查找为何严格要求数据有序,演示在无序列表上二分查找出现的误杀与失效现象,并与线性查找在算法机制、执行效率及工程选型上展开系统对比。
在 Python 中实现或调用二分查找时,输入数据必须严格保持单调有序(升序或降序)。如果在一个无序列表上直接运行二分查找算法或调用标准库中的 bisect 模块,程序虽然通常不会直接报错崩溃,但其查找结果完全不可预测——即使目标元素确实存在于列表中,算法也极大概率返回“未找到”。相比之下,传统的线性查找虽然在单次查询效率上较低,但对数据的排列顺序没有任何要求。本文将深入剖析二分查找依赖有序性的数学逻辑,通过具体代码还原无序二分导致的严重故障,并系统对比两者的性能表现与工程选型策略。
一、二分查找的核心假设与有序性依赖
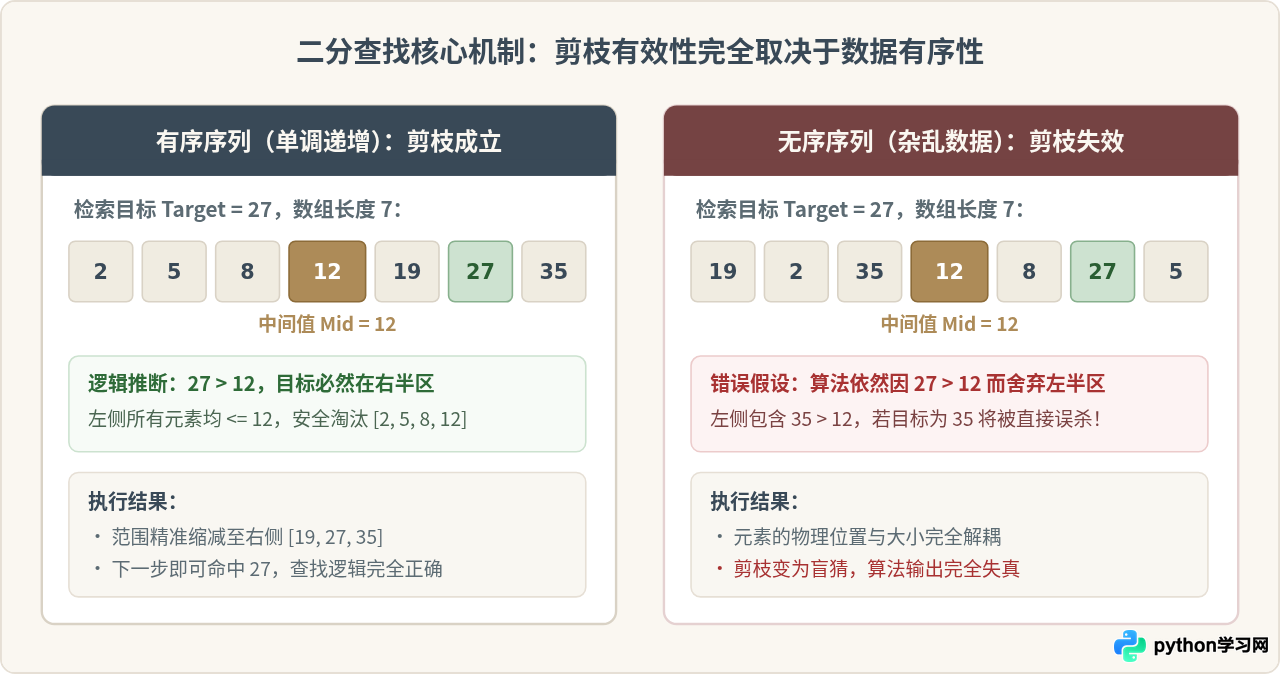
二分查找(Binary Search)之所以能够在每一步比对中直接剔除一半候选元素,完全建立在“数据具有单调性”这一定理之上。它的工作逻辑十分简单直接:
- 取当前搜索范围的正中央元素(Mid)与目标值(Target)进行比对。
- 如果
Target == Mid,查找成功直接返回。 - 如果
Target > Mid,算法认定包括 Mid 在内的左半区所有元素都必然小于等于 Mid,从而全部小于 Target。因此可以毫无悬念地将左半区全部舍弃,将搜索边界收缩到右半区。 - 如果
Target < Mid,同理将右半区全部安全舍弃。
这种高效的“区间减半”剪枝逻辑,本质是基于有序序列的传递性(若 a <= b 且 b < c,则 a < c)。一旦数据本身是杂乱无序的,上述推理链条就会在第一步彻底断裂:中间值左侧可能混杂着比它更大的数,右侧也可能混杂着比它更小的数。丢弃任何半区,都等同于在闭着眼睛随机丢弃可能包含目标元素的数据片段。
二、线性查找的原理与无序数据的包容性
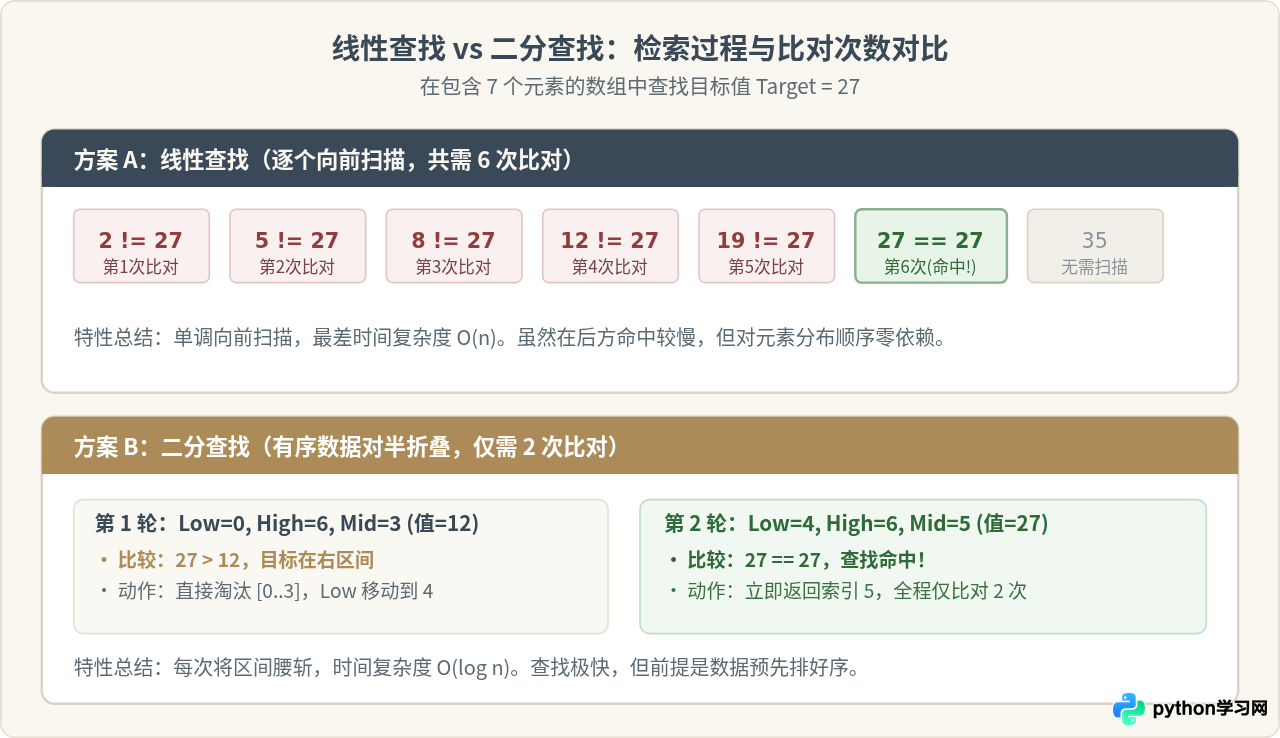
线性查找(Linear Search)是计算机科学中最基础的查找策略。其算法过程极为直观:从数据集合的第一个元素开始,依次向后逐项扫描比对,直到找到与目标相等的元素,或者扫描完最后一个元素宣告查找失败。
线性查找的关键优势在于零前提假设:
- 无需排序:无论元素如何颠倒分布,线性扫描都会无差别覆盖每一个位置,绝对不会遗漏任何一个候选值。
- 无需随机访问:不仅支持基于下标的
list,还可以应用于链表、生成器、文件迭代流以及无序集合。
在 Python 中,内置的 in 关键字和列表方法 list.index() 对普通列表的操作底层就是纯正的线性查找。示例如下:
# Python 线性查找示例
fruits = ["banana", "apple", "pear", "orange"]

# 1. 使用 in 运算符判定存在性(底层为从前到后的线性遍历)
has_apple = "apple" in fruits  # True

# 2. 使用 list.index 获取目标元素的下标
apple_idx = fruits.index("apple")  # 1

# 3. 自定义线性查找函数
def linear_search(arr, target):
    for idx, value in enumerate(arr):
        if value == target:
            return idx
    return -1
由于线性查找在最坏情况下需要比对列表中的全部 $n$ 个元素,其时间复杂度为固定的 $O(n)$。在数据规模较小或单次查询的场景下,线性查找的代码开销和内存负担往往是最轻的。
三、实验实录:在无序数据上强行二分的灾难后果
为了直观感受无序数据对二分查找的破坏,我们编写一段纯正的 Python 二分查找标准实现,并使用一个无序列表进行测试:
# 二分查找标准模板
def binary_search(arr, target):
    low = 0
    high = len(arr) - 1

    while low <= high:
        mid = (low + high) // 2
        if arr[mid] == target:
            return mid  # 找到目标,返回下标
        elif arr[mid] < target:
            low = mid + 1  # 判定目标在右半侧
        else:
            high = mid - 1  # 判定目标在左半侧

    return -1  # 未找到目标

# 测试用例:明显的无序列表
unsorted_list = [20, 5, 15, 30, 10]

# 尝试寻找元素 20(显然存在于索引 0)
result_index = binary_search(unsorted_list, 20)
print("查找元素 20 的结果索引:", result_index)
# 实际输出:查找元素 20 的结果索引: -1 (误判为不存在!)
为什么会出现 -1?执行步骤复盘:
在初始状态下,low=0, high=4,计算得出 mid=2,对应元素为 arr[2] = 15。我们要找的目标是 20。由于 20 > 15,算法武断地认为“所有大于 15 的元素都在右侧”,于是执行 low = mid + 1 = 3。这一操作直接将左半区 [20, 5, 15] 全部剔除!而真正的目标 20 恰恰就在索引 0 处。接下来的第二轮迭代中,算法只能在 [30, 10] 里苦苦寻觅,最后因为找不到而返回 -1。
同理,Python 标准库中自带的 bisect 模块(基于 C 语言加速实现,专用于有序序列的二分定位)在遇到无序序列时,同样不会报错,但会产生诡异的逻辑错位:
import bisect

unsorted_data = [50, 10, 40, 20, 30]

# 在无序数组中二分定位 20 的插入位置
idx = bisect.bisect_left(unsorted_data, 20)
print("bisect_left 返回索引:", idx)
# 输出: 0。但实际在索引 0 处是 50,如果依据此位置进行切片或插入,整个数据逻辑彻底混乱。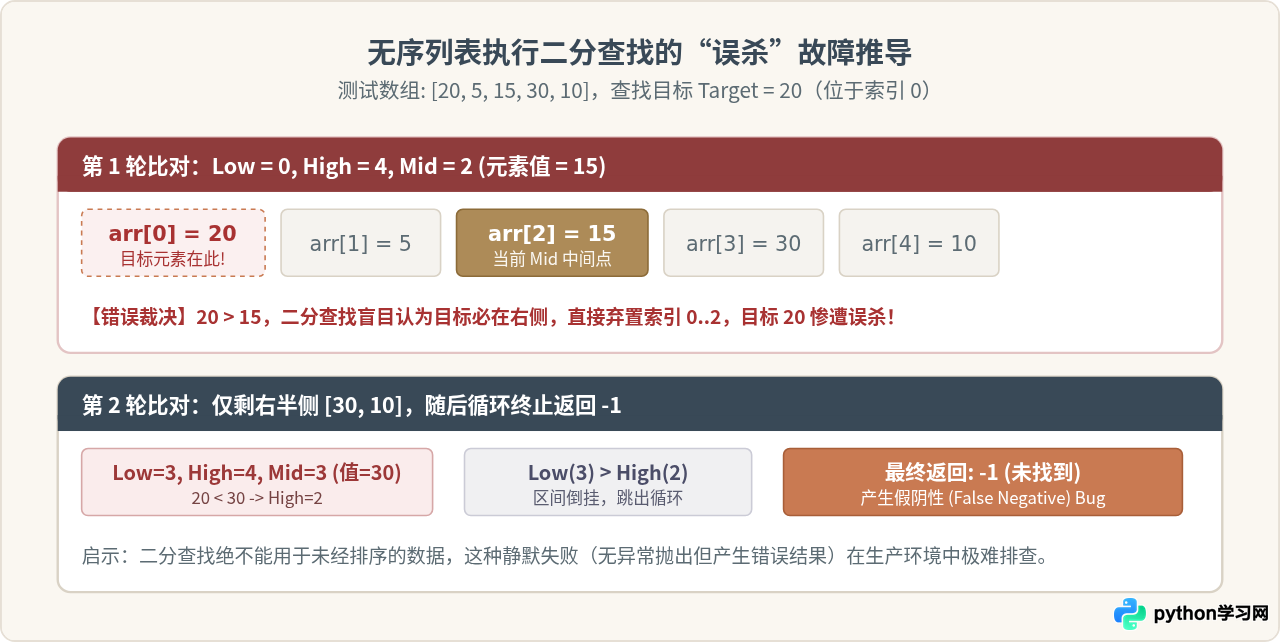
四、全面对比:二分查找 vs 线性查找
在了解了两者对数据有序性的要求后,我们需要从算法复杂度、硬件缓存友好度及前置成本三个维度进行全面对比:
| 对比维度 | 线性查找 (Linear Search) | 二分查找 (Binary Search) |
|---|---|---|
| 数据有序性要求 | 无任何要求,支持任意散乱分布 | 严格要求单调有序(递增或递减) |
| 最好时间复杂度 | $O(1)$(首个元素即命中) | $O(1)$(正中央元素即命中) |
| 平均时间复杂度 | $O(n)$ | $O(\log n)$ |
| 最坏时间复杂度 | $O(n)$ | $O(\log n)$ |
| 空间复杂度 | $O(1)$ 辅助空间 | $O(1)$ 迭代实现 / $O(\log n)$ 递归调用栈 |
| 数据结构支持 | 列表、元组、链表、生成器、流式文件 | 要求支持 $O(1)$ 随机访问(如 Python list) |
| 前置准备成本 | $0$(拿到数据即可直接查找) | 若无序,需先付出 $O(n \log n)$ 排序代价 |
关键转折点:“先排序再二分”一定划算吗?
许多初学者容易产生一个认知误区:“既然二分查找是 $O(\log n)$,那我遇到无序列表时,先对它调用 arr.sort(),然后再用二分查找,岂不是比线性查找更快?”
这个推论在数学上往往是不成立的。我们来计算总体时间成本:
- Python
sort()使用的是 Timsort 算法,其最佳时间复杂度为 $O(n)$,平均和最坏时间复杂度为 $O(n \log n)$。 - 直接线性查找的成本是:$O(n)$。
- “先排序再二分查找”的成本是:$O(n \log n) + O(\log n) \approx O(n \log n)$。
显然,在只查找一次的情况下,$O(n \log n)$ 远大于 $O(n)$。例如一个长度为 1,000,000 的列表,线性查找最多扫描 1,000,000 次;而排序需要进行大约 20,000,000 次比对与移动!因此,如果是单次或低频查找,直接使用线性查找是速度最快、消耗资源最少的选择。
只有当这组数据是相对静态的,并且后续需要进行大量的查询(设查询次数为 $k$),满足 $k \cdot O(\log n) + O(n \log n) < k \cdot O(n)$,即 $k > \frac{n \log n}{n - \log n} \approx \log n$ 时,预先排序的总体优势才会显现。
五、Python 实际开发中的查找选型决策
在真实的 Python 工程中,面对查找需求,我们不应只在“线性查找”与“二分查找”之间纠结,更应将 Python 强大的内建数据结构(如字典和集合)纳入考量。具体决策链路如下:
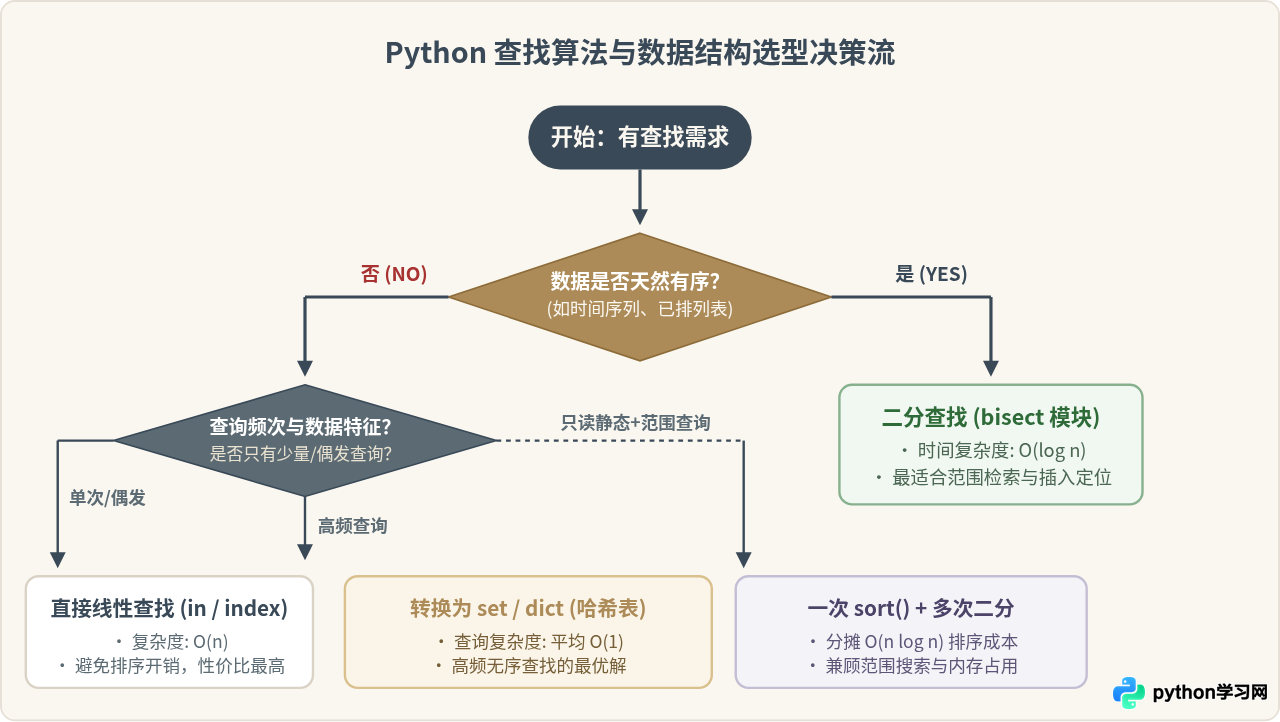
实战场景落地建议:
- 列表数据已排序,需要快速检索:直接使用标准库
bisect.bisect_left(arr, x)。它是经过优化的 C 扩展,性能极高。 - 列表是无序的,且只需查询 1~2 次:使用
item in my_list进行线性查找。绝对不要为了二分而先去排序。 - 无序数据,但后续有数万次查询:如果只需判断“是否存在”或“按 Key 取值”,立即使用
lookup_set = set(my_list)或lookup_dict = {x: i for i, x in enumerate(my_list)}。建立哈希表只需 $O(n)$ 时间,后续每次查询仅需 $O(1)$,在速度和内存平衡上远胜于排序后再二分。 - 需要维护动态有序序列:如果需要在不断插入新元素的同时保持顺序,可以使用
bisect.insort(arr, x),但需注意在 Python 列表中插入元素的底层内存搬移开销是 $O(n)$。
六、总结与避坑清单
回答标题的核心提问:是的,Python 二分查找严格要求数据必须单调有序。这一要求不是 Python 语言或特定库的限制,而是二分查找算法剪枝成立的数学前提。
在日常编码中,请牢记以下三条黄金准则:
- 防假阴性:绝不在未经验证或未经排序的列表上调用二分查找或
bisect模块,避免引发静默查找失败的顽固 Bug。 - 知晓代价:无序数据单次查找首选线性查找(
in操作);切莫画蛇添足地执行“先排序再二分”,那会把 $O(n)$ 的任务恶化为 $O(n \log n)$。 - 活用哈希:高频查找请优先选择
set或dict,在绝大多数 Python 实际业务中,哈希表是比二分查找更直接、更高效的通用解法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









