

使用enumerate和zip优化Python循环代码的写法
深入讲解如何使用 Python 内置的 enumerate 与 zip 函数优化循环结构,告别繁琐的 range(len()) 与下标访问,掌握优雅、高效的多序列迭代与索引处理技巧。
在 Python 代码审查与日常重构中,大量繁杂的 for i in range(len(items)) 和手动自增计数器往往是代码冗长、易出越界 bug 的根源。本文将深入解析内置函数 enumerate 与 zip 的底层运行逻辑、解包语法及进阶技巧,展示如何写出兼具可读性与执行效率的 Pythonic 循环结构。
一、传统下标遍历的痛点与 range(len(...)) 的局限
很多具有 C、Java 或 JavaScript 背景的初学者进入 Python 时,通常习惯于通过数组下标来操作集合中的数据。例如在需要获取元素位置或同步操作多个列表时,常常写出类似如下的代码:
# 传统但不够 Pythonic 的写法
fruits = ["apple", "banana", "cherry"]
for i in range(len(fruits)):
    item = fruits[i]
print(f"Index {i}: {item}")Index 0: apple
Index 1: banana
Index 2: cherry
这种写法虽然能够正常完成任务,但在实际工程中存在若干显著弊端:
- 冗长且增加认知负荷:读者必须在视线上先经过
len()计算长度、range()构建范围,再到循环体内部的fruits[i]索引访问,步骤分散。 - 下标越界与维护风险:当循环内部涉及多个列表交叉引用或条件删除时,手工下标极易引发
IndexError。 - 无法直接支持不可随机访问的集合:若目标对象是生成器、文件迭代器、集合(
set)或字典视图,它们并不支持len()或随机下标切片,range(len(...))将直接抛出TypeError。
Python 的设计哲学强调直接迭代对象本身。当确实需要行号、索引或多个容器联动时,enumerate 和 zip 就是官方提供的专门解法。
二、使用 enumerate 优雅处理“索引+元素”
enumerate(iterable, start=0) 接收一个可迭代对象,并返回一个生成连续计数与对象元组的枚举迭代器。在每次循环迭代时,它直接产出 (index, item) 结构,允许在 for 语句头部直接完成元组解包。
# 优化后的写法:使用 enumerate
fruits = ["apple", "banana", "cherry"]
for idx, fruit in enumerate(fruits):
print(f"序号 {idx}: {fruit}")序号 0: apple
序号 1: banana
序号 2: cherry
灵活指定起始计数位置
许多业务场景(如生成报表行号、打印用户菜单、记录行号)要求从 1 或特定基数开始编号。传统写法往往被迫写成 i + 1,这在复杂代码段中很容易遗漏。enumerate 提供了具名参数 start,可以天然解决此问题:
# 设置 start=1,省去手动加一
for line_no, fruit in enumerate(fruits, start=1):
    print(f"第 {line_no} 行:{fruit}")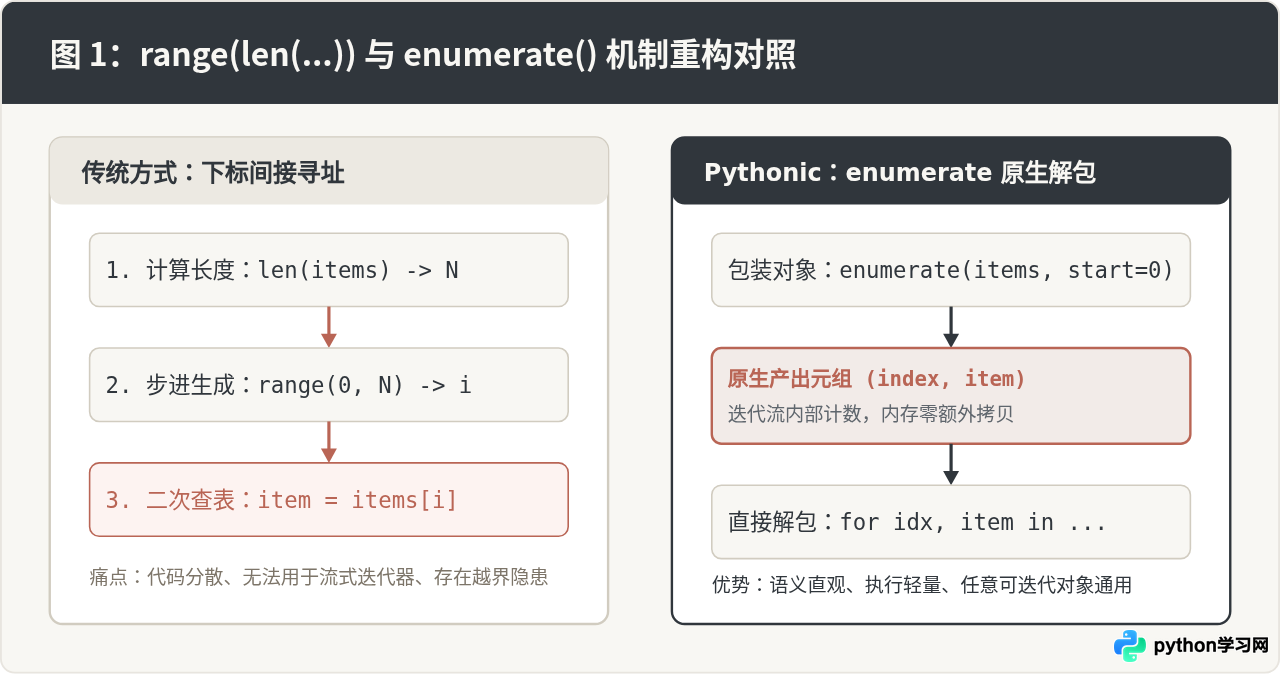
三、使用 zip 同步遍历多个可迭代对象
当需要同时处理两个或多个平行的列表(例如姓名与对应得分、键与值、输入与预期输出)时,传统写法常依赖公共索引:
# 传统方式遍历多列表
names = ["Alice", "Bob", "Charlie"]
scores = [92, 88, 95]

for i in range(len(names)):
    print(f"{names[i]} 的得分为 {scores[i]}")
如果两个列表的长度由于数据脏污或动态变动而不一致,这种写法要么抛出 IndexError,要么遗漏尾部数据。使用 zip(*iterables) 可以将多个容器的元素像拉链一样横向啮合,每次产出一个包含各容器对应位置元素的元组。
# 优化写法:使用 zip 同步迭代
names = ["Alice", "Bob", "Charlie"]
scores = [92, 88, 95]

for name, score in zip(names, scores):
print(f"{name} 的得分为 {score}")Alice 的得分为 92
Bob 的得分为 88
Charlie 的得分为 95
不等长容器的处理:截断原则与 strict 校验
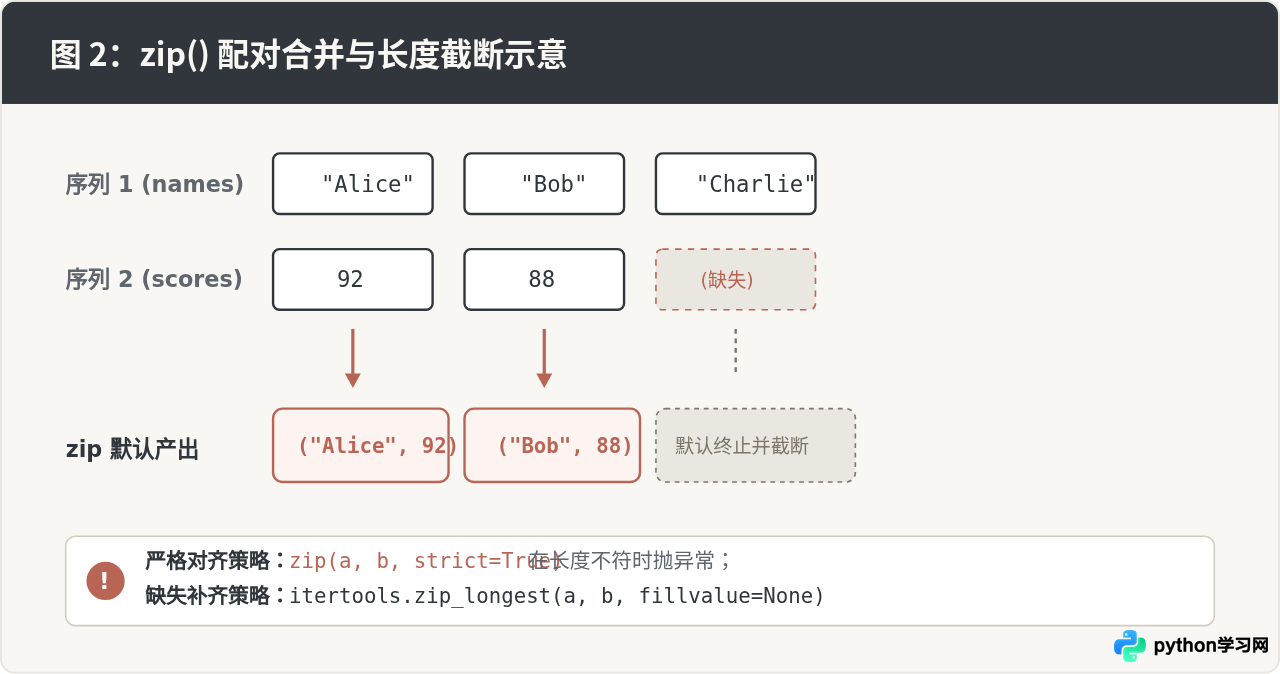
默认情况下,zip 采取最短截断原则:一旦其中某一个输入迭代器耗尽,遍历即刻终止,多余的元素会被无声忽略。这在很多场景下是安全且符合预期的,但在数据清洗或强对齐业务中可能隐藏静默数据丢失的 Bug。
Python 3.10 引入了 strict=True 参数。当传入的序列长度不同时,会立即抛出 ValueError,极大提升了排错效率:
# Python 3.10+ strict 模式示例
users = ["Alice", "Bob"]
roles = ["Admin", "User", "Guest"]

# 会主动引发 ValueError: zip() argument 2 is longer than argument 1
for u, r in zip(users, roles, strict=True):
    pass
若需求是保留最长序列并对短序列进行空位补充,可改用标准库 itertools.zip_longest:
from itertools import zip_longest

names = ["Alice", "Bob"]
scores = [95, 87, 100]

for name, score in zip_longest(names, scores, fillvalue="缺考"):
print(f"{name}: {score}")Alice: 95
Bob: 87
None: 100
四、进阶组合:enumerate 与 zip 联动解构
在工程开发中,常常遇到既需要同时遍历多个序列,又需要对每一轮遍历赋予行号或进度计数的需求。例如读取两份对照数据并向日志打印行号。
很多开发者会在此处退化回 range(len(...)),或者在 for item1, item2 in zip(...) 前面手动初始化一个计数器 count = 0 并在末尾 count += 1。这完全没有必要,因为 enumerate 与 zip 可以直接无缝嵌套组合。
# 优秀范式:enumerate 与 zip 组合使用
names = ["Alice", "Bob", "Charlie"]
scores = [95, 87, 98]
departments = ["研发部", "设计部", "市场部"]

for idx, (name, score, dept) in enumerate(zip(names, scores, departments), start=1):
print(f"[{idx}] 员工: {name:<8} 部门: {dept:<6} 成绩: {score}")[1] 员工: Alice 部门: 研发部 成绩: 95
[2] 员工: Bob 部门: 设计部 成绩: 87
[3] 员工: Charlie 部门: 市场部 成绩: 98
关键注意事项:嵌套元组解包的括号不可省略
在书写 for idx, (name, score) in enumerate(zip(names, scores)): 时,必须用小括号将 (name, score) 括起来。因为 enumerate 产出的是一个二元元组 (index, element),而这里的 element 本身是 zip 产出的元组。如果写成:
# 常见错误写法:缺少内部括号
for idx, name, score in enumerate(zip(names, scores)):
    pass
# 抛出异常:ValueError: not enough values to unpack (expected 3, got 2)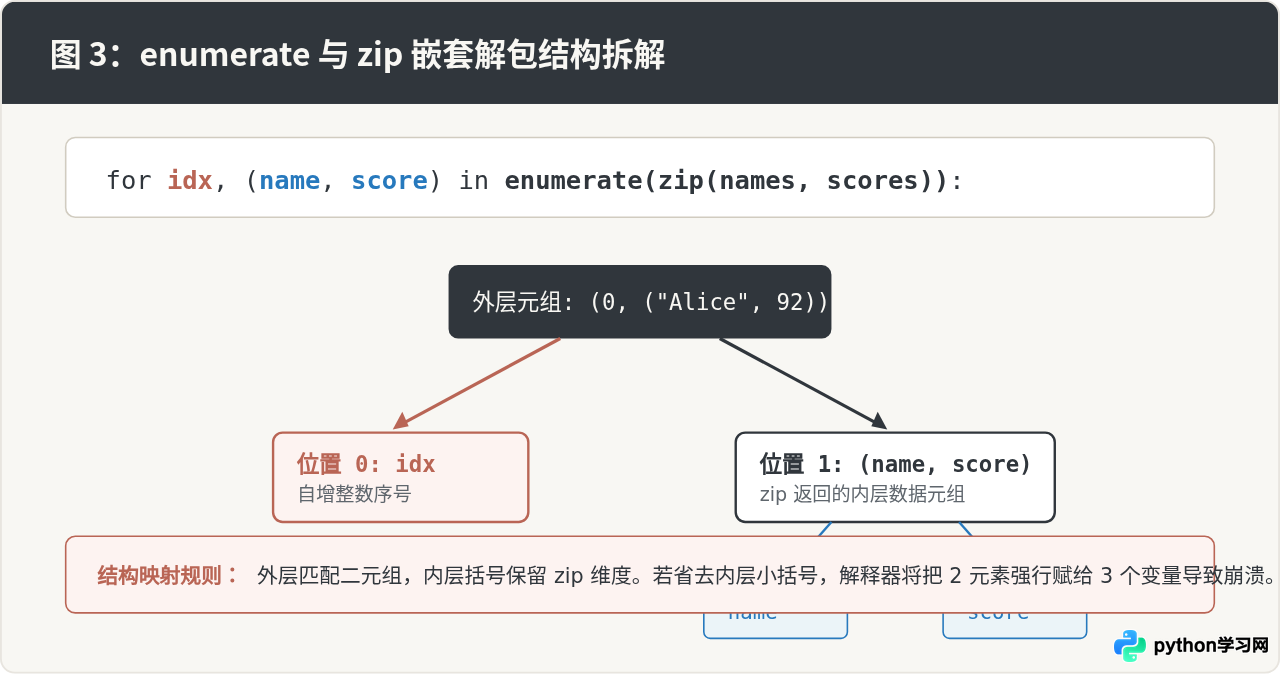
五、边界条件与避坑指南
尽管 enumerate 和 zip 能够显著提升代码质量,但在以下特殊场景中需要保持警惕:
1. 迭代器一次性耗尽问题
enumerate 和 zip 在 Python 3 中均返回惰性求值的迭代器(Iterator),而非列表(List)。这意味着它们消耗常数级别的内存(O(1) 空间复杂度),适合处理千兆级别的大文件或数据库流。但也由于这一特性,它们只能被完整遍历一次:
# 陷阱:迭代器耗尽后无法重复读取
pairs = zip(["a", "b"], [1, 2])
for item in pairs:
    pass

# 第二次遍历将什么都不会输出
for item in pairs:
print(item) # 无任何输出!如果业务逻辑需要多次回溯遍历,请显式转换为列表:pairs_list = list(zip(a, b))。
2. 解包星号运算符完成“逆操作”(Unzip)
由于 zip 的参数是 *iterables,通过结合序列解包运算符 *,可以极其优雅地实现数据的矩阵转置或反向解绑:
# 逆向分离数据
record_pairs = [("Alice", 90), ("Bob", 85), ("Charlie", 95)]
names, scores = zip(*record_pairs)

print(names)   # ('Alice', 'Bob', 'Charlie')
print(scores)  # (90, 85, 95)
六、循环写法选型与总结
优化 Python 循环代码的核心原则不是盲目套用高级函数,而是根据迭代维度和状态需求选择表达最直观的写法。以下决策图与对照表总结了不同场景下的最佳写法:
| 业务场景 | 推荐写法 | 避免写法 | 主要优势 |
|---|---|---|---|
| 仅遍历单个列表元素 | for item in items: |
for i in range(len(items)): |
最简语法,直观且零查表开销 |
| 需要元素及其行号/序号 | for idx, item in enumerate(items, start=1): |
手工 count = 1; count += 1 |
计数与遍历原子化绑定,防止漏加 |
| 两个或多个序列并排迭代 | for a, b in zip(list_a, list_b): |
for i in range(len(list_a)): b = list_b[i] |
告别复杂下标,自动同步前进 |
| 多序列遍历且带行号记录 | for i, (a, b) in enumerate(zip(a, b)): |
下标法多层嵌套 | 层次清晰,解包精确 |
| 不等长序列需要缺省填充 | itertools.zip_longest(a, b, fillvalue=v) |
手写 while 循环与长度判断 | 标准库原生支持,边界保护稳健 |
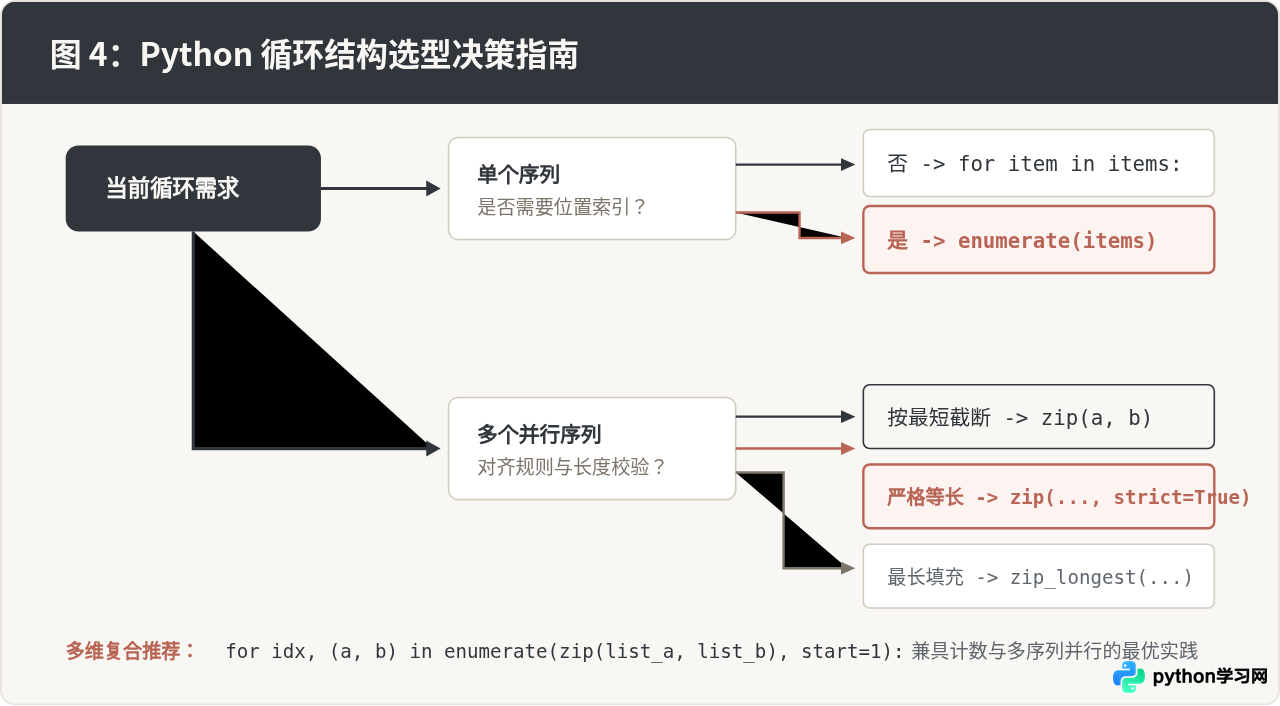
总结:彻底告别 range(len(...)) 是迈向地道 Python 编程的关键一步。熟练使用 enumerate 与 zip 及其配套的解包语法,不仅能够消除多余的临时变量和潜在越界异常,更能直接体现代码的意图与业务逻辑,使程序更加健壮、易于维护。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









