

Python为什么适合人工智能:语法简洁与开发效率的优势
深入解析Python为何成为人工智能领域的首选语言。聚焦接近数学的简洁语法、极速的实验原型迭代机制,以及上层Python调度与底层C/CUDA加速的双层异构架构。
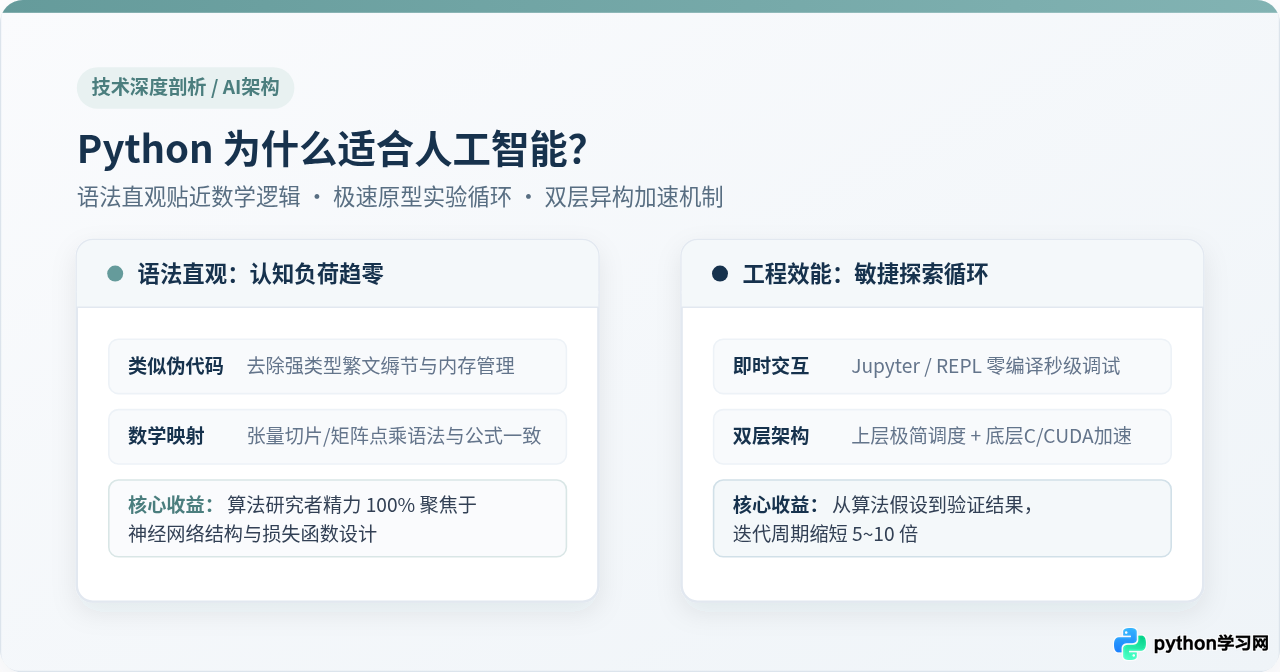
一、语法简洁性:消除数学逻辑与代码实现的心智鸿沟
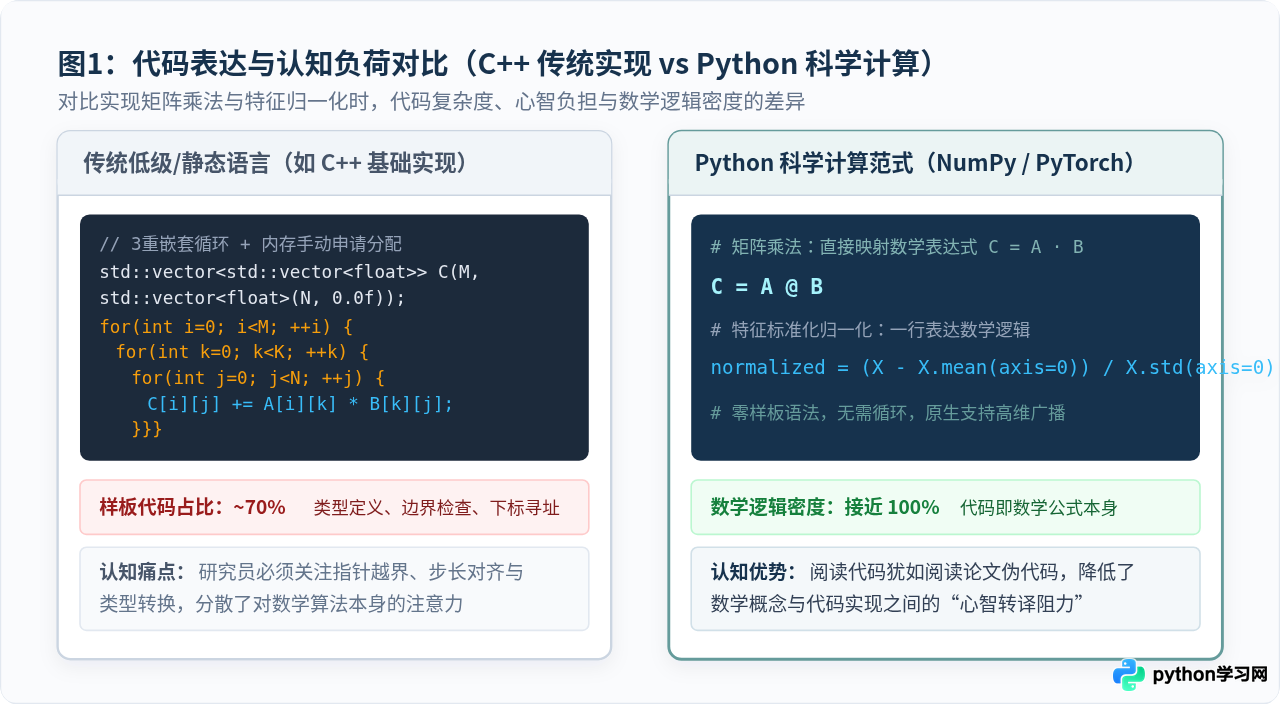
人工智能的本质是应用数学算法在数据上的工程实现。无论是反向传播、自注意力计算,还是特征矩阵的降维投影,算法工程师日常思考的都是向量空间映射、偏导数链式法则与张量变形。如果一门编程语言要求开发者在实现一个简单矩阵乘法时,先手写三层嵌套循环、声明迭代器边界、显式进行内存对齐和指针管理,开发者的思维就会被底层细节反复打断。
Python 最显著的特点之一是其接近自然语言与伪代码的表达方式。它不需要分号结尾、省略了大括号层级、采用了直观的缩进语法,并且具备强大的内置数据结构与高阶操作符。这种“极简心智阻力”的语言特质,在处理数学运算时产生了质的飞跃。
1. 数学符号的原生映射:以矩阵乘法为例
在传统的静态系统语言中,即使是一个简单的加权特征计算,也往往需要十几行代码完成容器声明、内存分配与多维遍历;而在现代 Python 科学计算栈中,代码几乎就是数学公式的一对一转写:
import torch

# 模拟批量样本特征 X 与模型权重 W
X = torch.randn(32, 128)     # Batch=32, Dim=128
W = torch.randn(128, 64)     # 输出维数=64
b = torch.zeros(64)

# 仅需单行操作:矩阵相乘、广播偏置并经过非线性激活
output = torch.relu(X @ W + b)

# 特征切片与标准化:直接切片语法,无冗余循环
normalized = (output - output.mean(dim=0)) / (output.std(dim=0) + 1e-6)
上述代码中的 @ 运算符直接代表了线性代数中的矩阵点乘,output.mean(dim=0) 则直接对应于统计维度的均值缩减。开发者在阅读和编写这些代码时,大脑中加载的是线性代数与概率论图景,而无需在脑中模拟 CPU 缓存行命中、内存越界防范或虚函数表解析。
2. 动态类型与切片语法对数据探索的赋能
在 AI 模型开发前期,数据科学家面对的往往是维度复杂、缺失值多样的原始数据集。Python 的动态类型系统与 NumPy 式切片(如 tensor[:, :5, ::2])允许开发者在不需要预先为每个中间状态编写复杂类结构的前提下,快速变换数据张量形态。这种极度灵活的表达自由度,使算法验证的心理门槛降到了最低。
二、开发效率优势:AI 探索本质是高频试错与敏捷迭代
理解 Python 为何统治 AI 的关键,在于分清软件工程确定性开发与AI 算法经验性探索的根本差别:
- 常规软件开发:需求相对明确(如电商下单、用户认证),代码写好后逻辑基本固化,重点在于边界健壮性、架构规范与长期维护成本。
- 人工智能研发:极度依赖假设、试错与超参数调整。往往需要尝试 50 种网络结构、数十种损失函数组合以及不同的学习率调度策略,其中 90% 的构想在经过数轮训练后会被证明无效并直接舍弃。
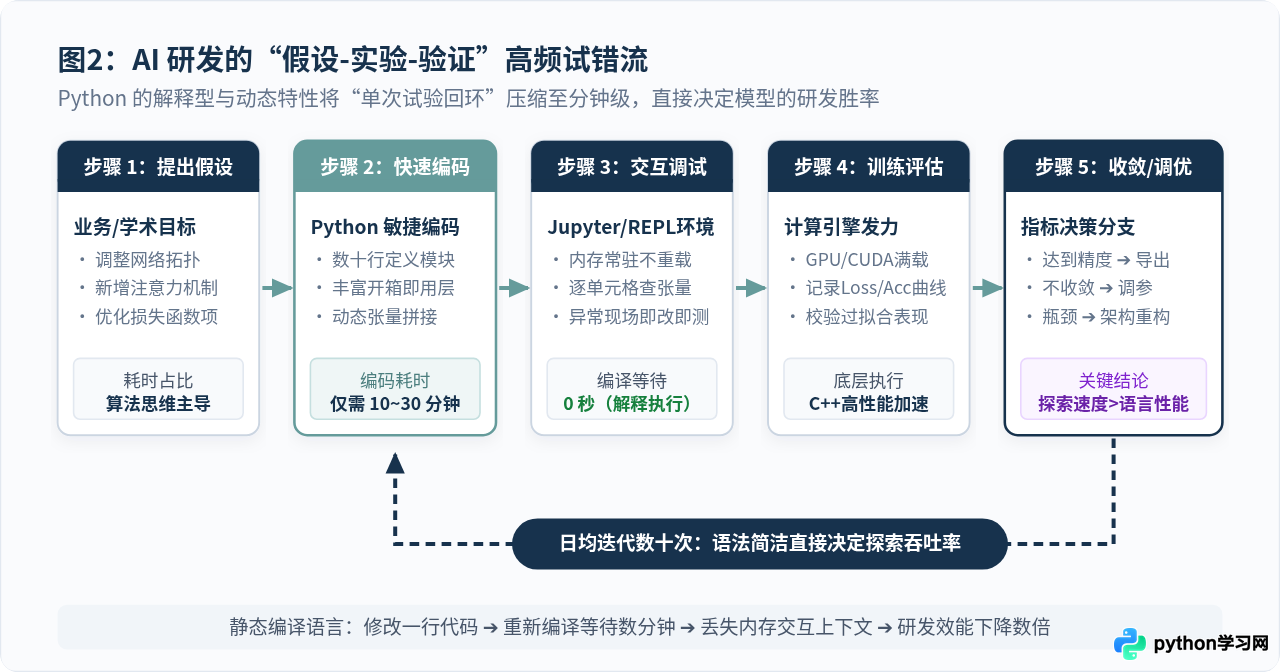
在这种高频证伪的工作模式下,代码的撰写速度和单次实验周期的长短,直接决定了一个团队的科研产出与工程上限。如果每次微调网络层数或修改注意力头维度,都需要经历数分钟的代码静态重编译和类型校验,开发者的探索链条就会被切碎,试错吞吐率将大打折扣。
交互式计算范式:REPL 与 Jupyter Notebook 的生态垄断
Python 完美支持交互式编程(Read-Eval-Print Loop)。借助 Jupyter Lab / Notebook,算法开发者可以把模型训练流程切分为独立单元格:
- 数据常驻内存:几十 GB 的清洗后数据集仅需加载一次,常驻系统内存中,无需在调试下游模型时反复读取磁盘。
- 即时探针检查:在任意代码执行点,均可直接打印当前张量的
.shape、梯度范数.grad.norm()或绘制分布直方图,排查梯度消失或爆炸。 - 就地热修复:发现损失函数设计缺陷时,仅需就地修改对应单元格并重新运行,历史变量和已训练权重完好无损。
三、双层异构架构:打破“解释型语言太慢”的性能伪命题
初学者常常产生一个合理疑虑:“Python 作为动态解释型语言,存在全局解释器锁(GIL)且逐行解释字节码,运行速度比 C/C++ 慢数十倍甚至数百倍,为什么算力要求最高的人工智能反而偏偏选择 Python?”
答案在于现代 AI 框架普遍采用的“胶水语言 + 双层异构执行体系”架构设计。Python 在深度学习系统中并不直接负责密集浮点数运算,它扮演的是“指挥官与任务调度员”的角色。
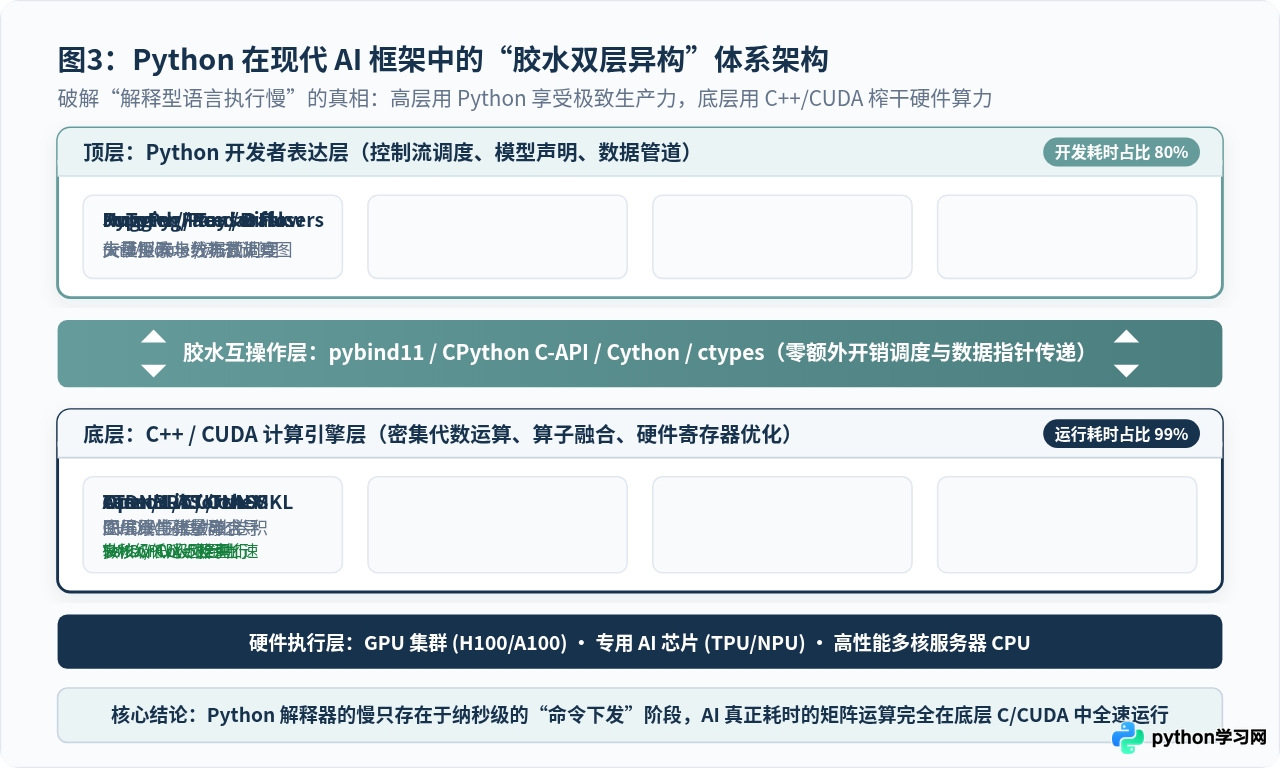
1. 控制流与数据流的彻底解耦
在 PyTorch 或 TensorFlow 中,当你写下一行卷积层代码 conv(x) 时,Python 解释器所做的只是将张量元信息和指针作为参数,通过 C-API 压入底层的调度队列。真正的运算被瞬间分发给了底层由 C++ 编写的执行引擎(例如 PyTorch 底层的 LibTorch / ATen 库)。
底层引擎紧接着会调用高度优化的底层矩阵计算硬件库:
- GPU 加速:直接调用 NVIDIA 官方手写汇编级优化的
cuDNN和CUTLASS,充分利用 Tensor Core 专用硬件加速器。 - CPU 向量化:直接调用
Intel oneMKL或OpenBLAS,激活现代 CPU 的 AVX-512 与 AMX 向量扩展指令集。
2. 99% 与 1% 的时间分配法则
在典型的神经网络训练步骤中:
- Python 解释器构建计算图与调用底层函数的时间仅耗费 微秒(µs)级(占总时间不到 1%);
- 底层的 GPU/CUDA 核心执行数十亿次浮点矩阵乘加运算耗费 毫秒(ms)至秒级(占总时间 99% 以上)。
此时,无论将上层的调度代码改写为 C++、Rust 还是汇编,对总体训练耗时的影响都在微秒量级,整体执行吞吐几乎完全不受影响。开发者获得了 Python 无与伦比的编写速度,同时享有了 C/C++ 贴近物理极限的硬件性能。
四、全生命周期效能:从数据管道到生产落地的生态网络
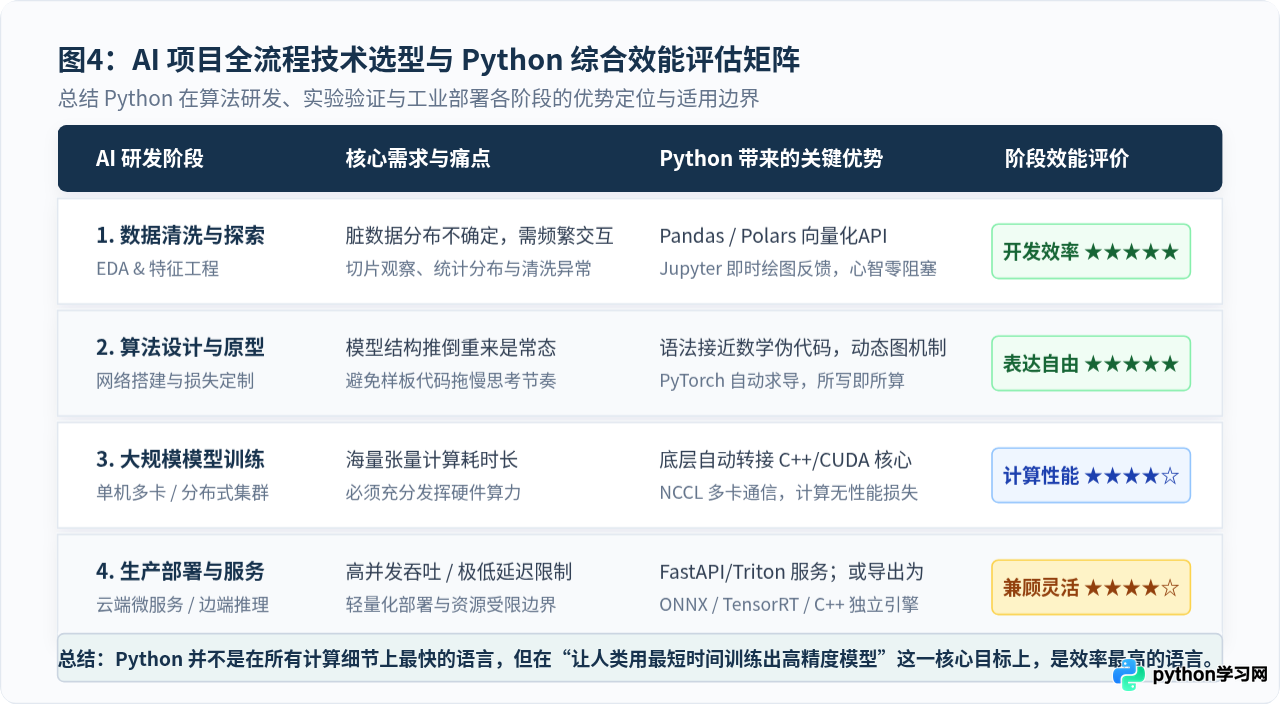
语法简洁和开发效率不仅体现在编写模型本身,更贯穿在 AI 研发的完整工作流中。一个真实的 AI 项目往往涉及四个核心阶段,而 Python 在每一个阶段都拥有无缝对接的标准工具链:
| 工程阶段 | 常用 Python 生态工具 | 传统替代方案痛点 | Python 带来的开发效能增益 |
|---|---|---|---|
| 1. 数据采集与清洗 | Requests, BeautifulReport, Pandas, Polars | Java/C++ 文本解析繁琐,JSON 处理样板冗长 | 几行代码搞定文本清洗与异常值过滤,快速落地预处理脚本 |
| 2. 模型设计与实验 | PyTorch, TensorFlow, HuggingFace, timm | 自研或冷门语言算子库缺失,无法直接复现最新论文 | ArXiv 最新顶级论文开源代码 98% 采用 PyTorch,即下即用 |
| 3. 训练监控与超参优化 | TensorBoard, WandB, Optuna, Ray Tune | 缺乏可视化图表,调参任务需手动编写分布式调度 | 一键集成训练曲线看板与贝叶斯自动化超参数寻优 |
| 4. 模型导出与推理服务 | ONNX, TensorRT-LLM, FastAPI, vLLM | 服务化接口臃肿,跨平台移植需重写网络解析逻辑 | 支持直接导出为硬件无关的 ONNX 格式,兼顾云端并发服务 |
客观边界与工程建议:何时需要跳出纯 Python?
尽管 Python 在算法研发与原型验证中处于统治地位,但在工业工程实践中,仍需根据落地场景明确其适用边界:
ONNX 或 TensorRT 引擎,使用 C++ 或 Rust 编写高性能推理服务容器,规避 GIL 和解释器垃圾回收带来的延迟波动。2. 嵌入式与物联网设备:微控制器(MCU)受限于内存与运行库体积,应使用
TFLite Micro 或 Edge Impulse 等纯 C/C++ 运行环境进行模型前向推理。
五、总结与核心启示
回顾“Python 为什么适合人工智能”这一命题,本质是计算机科学在“人本效率”与“机器效率”之间寻找最优解的必然演化:
在算力稀缺的早期时代,人类工程师不得不屈就机器,用冗长生涩的汇编与 C 代码换取每条指令的极致吞吐;而在以矩阵乘法和海量数据驱动的现代人工智能时代,算力由 GPU/TPU 等专用硬件承担,算法探索的瓶颈彻底转移到了研究员的思维与假设验证速度上。
Python 凭借其极简清晰的语法结构,抹平了算法思想转化为可执行代码的心智损耗;更通过成熟的异构胶水架构,将底层的重型算力无缝打包给开发者。这种“让人类专注思考、让底层全速运转”的协同范式,正是 Python 在人工智能浪潮中无可替代的核心优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









