

pip和conda有什么区别?Python数据科学库安装工具选择
深入对比 pip 与 conda 的核心差异,从底层二进制依赖、跨语言分发、虚拟环境机制到数据科学库选型决策,提供规范的操作流程与防坑指南。
假设你刚刚在一台崭新的工作站上着手搭建一个机器学习开发环境,当打开某个开源深度学习项目的主页时,会发现安装说明中往往并列给出了两种不同的命令:pip install torch torchvision 与 conda install pytorch torchvision -c pytorch。此时不少开发者会产生困惑:这两个工具到底有什么不同?为什么有的数据科学家坚持使用 conda,而许多 Web 开发者或运维工程师却更倾向于 pip?
核心结论在于:pip 是 Python 官方钦定的标准包管理器,专注于 Python 单一语言生态内的包分发与 Wheel 安装,环境管理需要结合 venv 或 virtualenv 完成;而 conda 是一个跨语言的通用包与环境管理系统,它将 Python 解释器、底层非 Python 科学计算库(如 Intel MKL、OpenBLAS、CUDA 运行时)以及上层 Python 库一并作为预编译二进制文件打包管理。在数据科学和高性能数值计算场景中,conda 能够解决烦琐的底层 C/C++/Fortran 动态链接库与硬件加速依赖,而 pip 则在轻量级服务构建、容器化分发以及获取 PyPI 最新库时具有显著优势。
一、深入本质:pip 与 conda 的三个核心维度差异
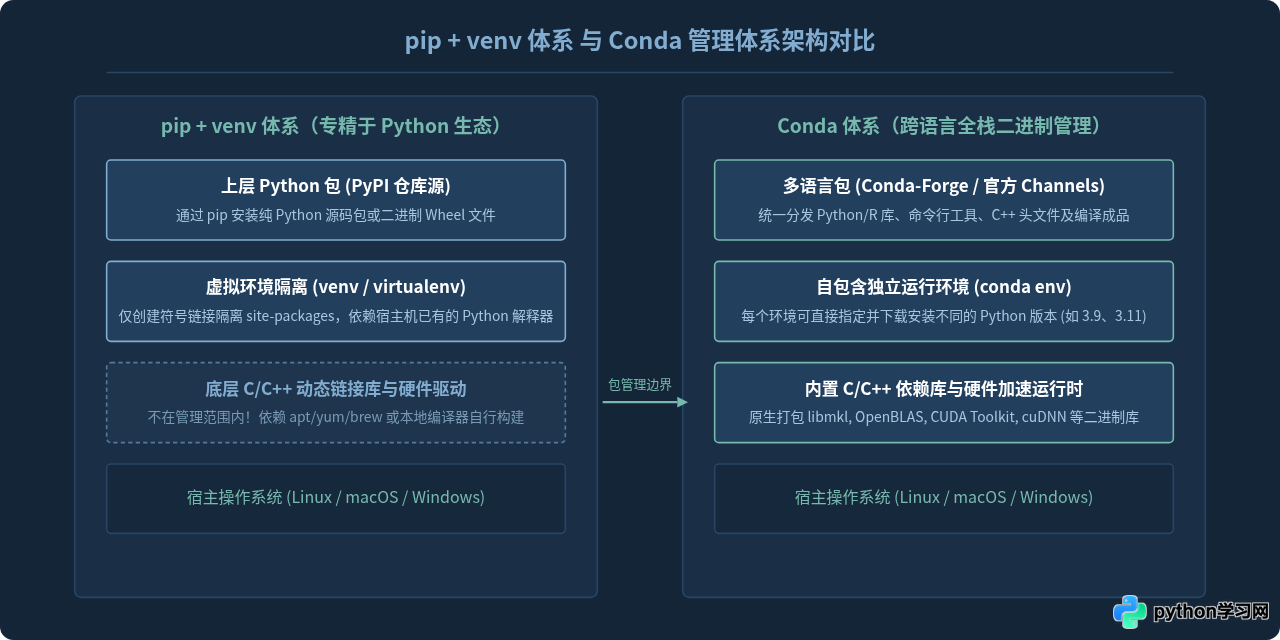
要理清两者的分歧,不能仅停留在“安装命令不同”的表象,而需要从软件工程体系中的依赖包范畴、环境隔离机制以及中心分发仓库三个关键维度进行解构。
1. 管理范畴:单语言包 vs 跨语言二进制生态
pip 是从 Python Enhancement Proposal (PEP) 规范中演化而来的官方包管理工具,其使命非常明确:安装和维护来自 PyPI 的 Python 软件组件。尽管现代 pip 大多采用 .whl(Wheel)这种预编译打包格式,可以在一定程度上内置部分 C 扩展模块,但对于复杂的外部 C/C++ 共享库(例如系统底层的 GLIBC 版本、CUDA 编译套件、高性能代数运算库 MKL),pip 本身并不具备跨层级解析与安装的能力。一旦本地环境缺少对应的系统级依赖,使用 pip 安装带有源码扩展的库时,控制台就会抛出诸如 fatal error: gcc failed with exit status 1 这类让初学者十分头痛的编译错误。
相比之下,conda 从诞生之初就是一个语言无关的通用二进制包管理器。对于 conda 而言,Python 解释器本身仅仅是其众多可管理软件包中的一个组件。当你执行安装命令时,conda 能够同时下载包含科学计算所需的 C/C++ 动态链接库、底层编译器运行时以及对应的 Python 绑定。这意味着即便你的系统没有预装任何 C++ 编译器或 NVIDIA 驱动开发套件,conda 也能在独立环境中为你还原一个完整且立即可用的二进制执行环境。
2. 环境隔离机制:软链接重定向 vs 完整沙箱分发
在使用 pip 时,为了避免不同项目之间的库版本相互污染,开发者通常会先使用 Python 自带的 venv 模块创建一个虚拟环境:
# 创建基于系统现有 Python 3.10 的虚拟环境
python3.10 -m venv my_project_env

# 激活虚拟环境
source my_project_env/bin/activate
venv 的工作原理相对精巧:它在指定目录下创建了一组指向宿主系统 Python 可执行文件的符号链接,并改变了 sys.path 的搜索路径,使得 pip install 安装的文件被写入到当前目录的 site-packages 中。然而,venv 无法独立切换 Python 解释器的大版本。如果你的操作系统只安装了 Python 3.10,你就无法通过 venv 直接凭空派生出一个 Python 3.8 的运行环境,除非事先在宿主机上手动编译或借助系统包管理器安装 Python 3.8。
而 conda 的环境管理(conda env)是完全解耦的。在 conda 中创建一个新环境,可以任意指定所需的 Python 版本:
# conda 会从仓库下载指定版本的独立 Python 二进制文件及其全部关联基础依赖
conda create -n dslab_env python=3.9 -y

# 激活独立沙箱环境
conda activate dslab_env
每一个 conda 环境都是一个自洽的沙箱体系,里面拥有独立的解释器二进制文件、标准库、第三方库以及系统动态链接库,切换时完全无需干预宿主系统的环境配置。
3. 仓库源与包兼容性哲学
pip 对应的上游源是 PyPI (Python Package Index)。PyPI 几乎是全球所有开源 Python 项目发布代码的首选平台,其包更新速度极快、数量最为庞大。只要开发者发布了新版本,用户立刻就能通过 pip 拉取。然而,PyPI 上的包是由成千上万个独立开发者各自维护上传的,包与包之间虽然有元数据声明,但在底层 C 扩展级别的兼容性上缺乏中央统一调度与编译验证。
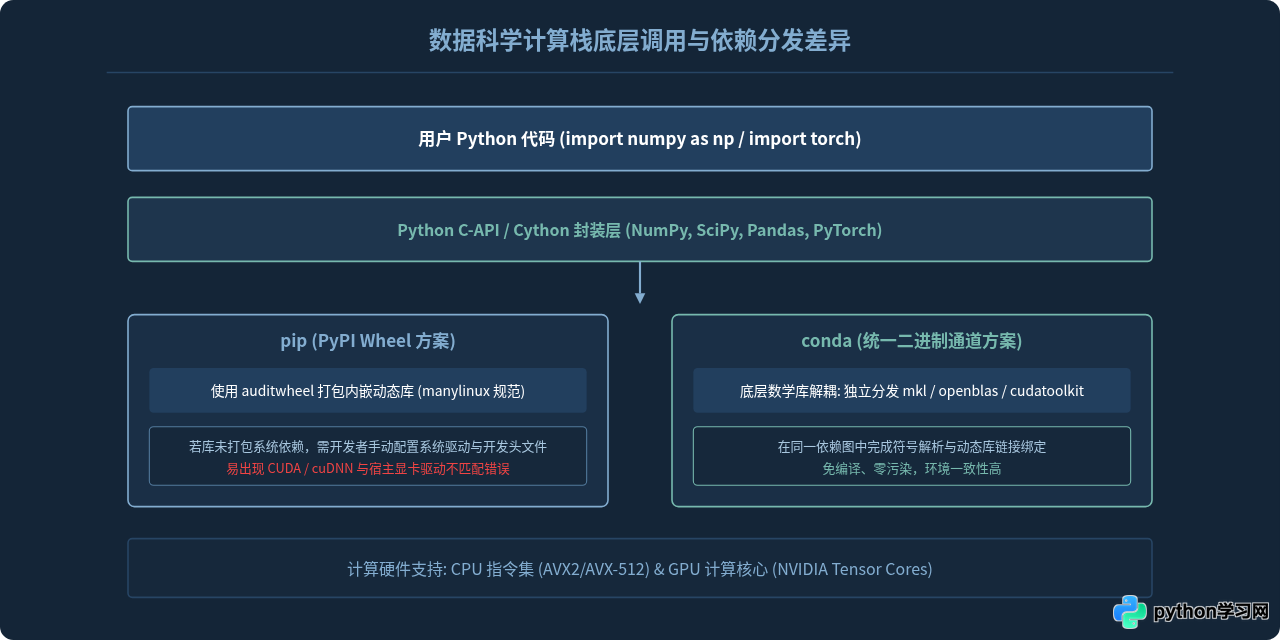
conda 对应的主要仓库源是 Anaconda 官方源 以及由社区主导的 conda-forge。conda-forge 拥有极其严苛的自动化持续集成(CI)编译流水线。所有纳入该源的二进制软件包都会在相同的基准依赖树下统一编译。例如,NumPy、SciPy 和 PyTorch 会被统一基于特定版本的 OpenBLAS 或 MKL 进行符号链接测试,极大地降低了“上层 Python 库版本兼容,但底层动态链接库符号冲突引发段错误 (Segmentation Fault)”的概率。
二、核心特性横向对比一览
为了让不同场景下的参数选择一目了然,下表列出了 pip 与 conda 在各维度的关键属性对比:
| 对比维度 | pip | conda |
|---|---|---|
| 本质属性 | Python 官方语言级包管理器 | 多语言通用二进制包与环境管理器 |
| 管理对象 | 仅限 Python 库(Wheel、源码包) | Python 包、C/C++ 动态库、Python 解释器、CLI 工具 |
| 环境隔离能力 | 自身无隔离机制,需搭配 venv |
内置完整的独立沙箱环境管理系统 |
| Python 版本切换 | 不能独立切换(依赖已安装的解释器) | 原生支持在任意环境一键安装任意 Python 版本 |
| 底层依赖解决 | 依赖系统已安装的动态库或预编译 Wheel | 统一编译并打包底层数学库(MKL、CUDA 等) |
| 上游核心仓库 | PyPI(包量极丰富,更新最前沿) | Anaconda 官方源、conda-forge 社区源 |
| 安装包体积与开销 | 极度轻量,环境体积小,启动快 | 基础环境相对偏重,依赖解析耗时较长 |
| 典型优势领域 | Web 开发、Docker 镜像构建、轻量工具 | 科学计算、深度学习实验、多版本 Python 研究 |
三、数据科学场景下的工具选择决策树
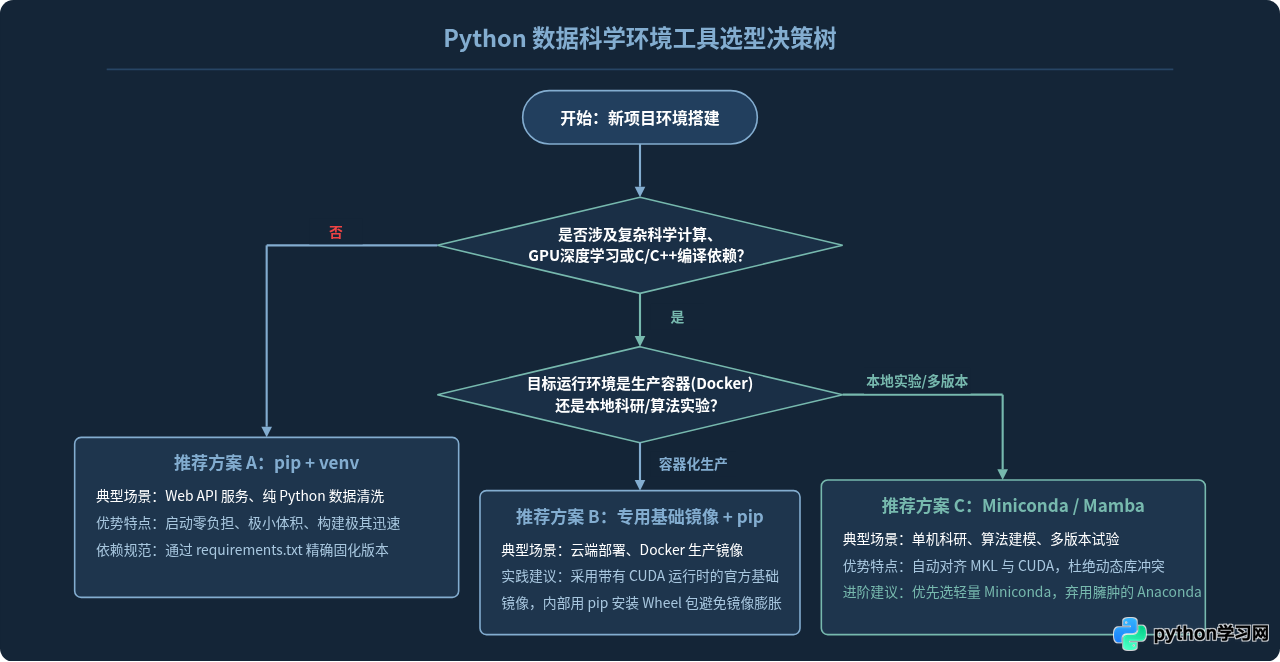
在了解了上述底层差异后,面对具体的项目与部署目标,我们应当如何做出明确、合理的工具选型?可以依据以下决策逻辑进行判断:
场景 1:本地算法研究与科研实验(优先选择 Miniconda)
如果你在个人笔记本、实验室工作站或云端 GPU 实例上进行探索性算法开发,需要频繁切换 Python 版本(例如一个项目需要 Python 3.8 运行旧模型,另一个需要 Python 3.11 体验新特性),并且高度依赖 NumPy、SciPy、PyTorch、JupyterLab 等庞大数据科学套件,Miniconda 是最优解。它避免了完整版 Anaconda 预装数百个冗余包的臃肿,同时保留了 conda 强大的跨语言二进制对齐能力,让你免于在本地手动编译 OpenBLAS 或折腾 NVIDIA 驱动开发套件。
场景 2:微服务集成与云原生 Docker 容器部署(优先选择 pip + venv)
当你的模型完成训练,需要封装为 FastAPI 或 Flask 微服务并打包进 Docker 镜像交付生产时,体积与构建速度成为了核心指标。一个包含 Miniconda 的镜像往往动辄 1GB 以上,而基于轻量官方 Python 镜像(如 python:3.10-slim)搭配 pip install --no-cache-dir 能够将镜像体积压缩到几百兆以内。生产环境的基础镜像已经由容器规范锁定了底层 Linux 运行时,此时利用 pip 安装标准的 Wheel 包既高效又易于通过 CI/CD 流水线做缓存加速。
四、操作步骤:Conda 与 pip 规范工作流及防坑指南
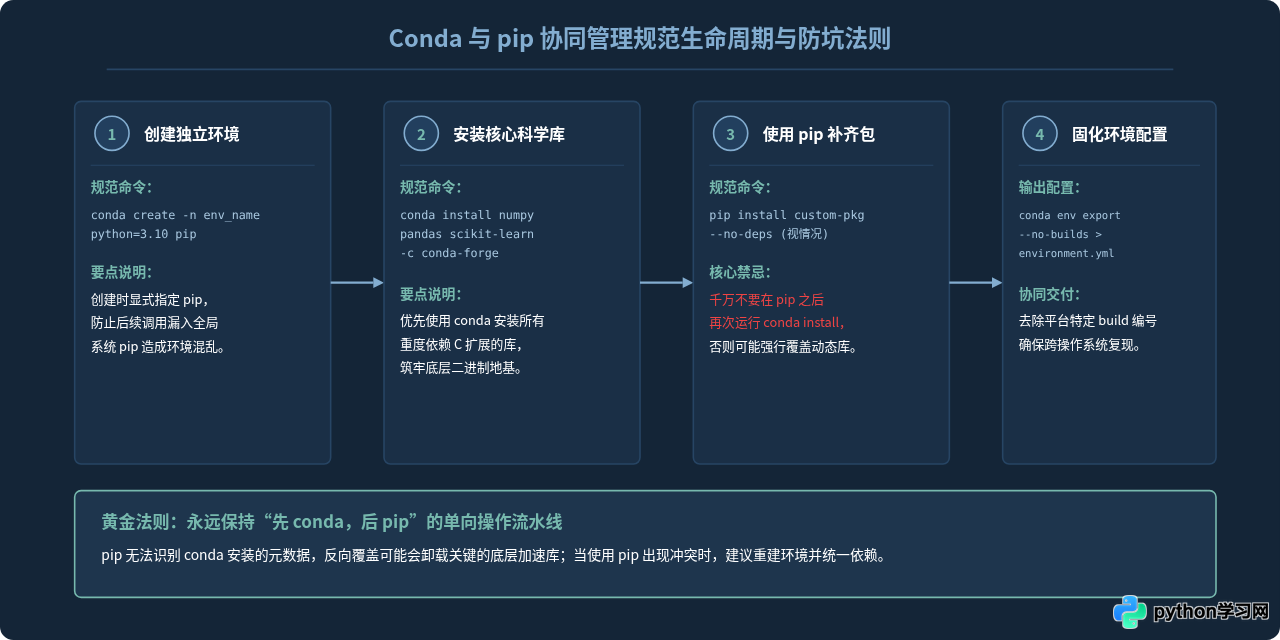
在实际工程中,完全非黑即白的场景并不多见,最常见的情况是在同一个数据科学项目中使用 conda 创建底层环境,但又需要使用 pip 安装某些仅存在于 PyPI 上的冷门学术库。掌握规范的协同操作步骤至关重要。
步骤 1:规范创建并激活 Conda 环境
很多开发者在创建 conda 环境时容易忽略一个小细节——没有在参数中显式包含 pip。如果在环境内没有独立的 pip 二进制文件,直接执行 pip install 可能会默认调用操作系统的全局 pip,导致包被安装到了宿主系统,极易破坏环境隔离。
# 显式指定 python 版本与该沙箱自带的 pip
conda create -n ai_research python=3.10 pip -y

# 激活该环境
conda activate ai_research

# 验证当前调用的 pip 是否确实位于该环境路径内
which pip
# 示例输出:确认位于目标 conda 环境的 bin 目录下
/home/developer/miniconda3/envs/ai_research/bin/pip步骤 2:使用 conda 优先安装核心数据科学库
为了充分利用预编译二进制一致性的优势,推荐优先通过 conda-forge 镜像频道安装 NumPy、Pandas、SciPy、Matplotlib、Scikit-Learn 等关键库:
# 推荐统一指定 conda-forge 频道
conda install -c conda-forge numpy pandas scipy scikit-learn matplotlib jupyterlab -y
步骤 3:在特定需求下使用 pip 安装补充库
当项目需要某些前沿论文的代码库、企业内部私有包(Git 仓库形式)或者尚未被 conda-forge 索引的小众库时,再在当前激活的环境中调用 pip:
# 在确保步骤 2 全部完成后,再使用 pip 补充安装
pip install flash-attn --no-build-isolationpip install 之后,又执行了 conda install,conda 的求解器(SAT solver)会试图重新计算整张依赖拓扑图,这可能会把刚才由 pip 安装的包依赖的某些底层共享库强制降级或替换,导致 Python 解释器在运行时遭遇不可预测的动态库符号冲突。因此,请务必遵守“先装全 conda 包,最后再用 pip 补齐”的纪律。
步骤 4:环境导出与团队可重现性交付
在数据科学团队协作中,将环境配置写入版本控制系统是不可或缺的步骤。使用 conda env export 时,如果不加任何过滤,会把当前操作系统专有的构建标签(Build String)一起导出,导致在 Linux 上导出的文件在 macOS 或 Windows 上无法重建。规范做法是去除构建标签:
# 导出跨平台兼容的环境定义文件
conda env export --no-builds > environment.yml
导出的 environment.yml 内容结构非常清晰,不仅涵盖了 conda 下载的包,还会自动将当前环境内通过 pip 安装的包单独列在末尾:
name: ai_research
channels:
  - conda-forge
  - defaults
dependencies:
  - python=3.10
  - numpy=1.24.3
  - pandas=2.0.2
  - scikit-learn=1.2.2
  - pip:
    - flash-attn==2.0.4
其他团队成员拿到该配置文件后,只需一行命令即可在异构开发机上还原出高度一致的开发环境:
# 根据配置文件一键还原完整环境
conda env create -f environment.yml
五、总结:如何选择最适合你的工具栈
回顾全文,pip 与 conda 并非水火不容的替代品,而是针对不同应用场景设计的互补工具。总结选择法则如下:
- 如果你主要从事机器学习、深度学习、数据挖掘或数值仿真:毫无疑问,选择 Miniconda 作为基础包与环境管理工具。它能在本地一站式搞定复杂的 BLAS、LAPACK、CUDA 与 C++ 依赖绑定,极大降低环境配置成本。
- 如果你从事 Web 开发、自动化脚本编写,或是构建云原生 Docker 容器:坚持使用 pip + venv。它的标准性、极简性与极快的安装速度是微服务与敏捷交付的首选。
- 在混合开发场景中:牢记单向工作流,把 conda 作为底座系统,先用 conda 构建好 Python 解释器与重度科学库,最后用 pip 安装边缘专用包,并结合
environment.yml完成可靠的版本固化。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









