

Python random.seed()用法:怎么设置随机数种子
详细介绍 Python random.seed() 的基础语法、参数设置、复现随机数的执行流程与底层原理,并通过完整代码示例解析种子生命周期、常见避坑点与跨库协同实践。
在 Python 中,通过调用内置模块的 random.seed(a) 函数可以为伪随机数生成器指定一个固定的起始值(即“随机数种子”)。只要传入的种子值相同,并且运行在相同的算法实现下,后续调用 random.random()、random.randint() 或 random.shuffle() 所产生的数据序列就会完全一致。这项机制的核心价值在于“让随机行为变得可重现”,广泛应用于算法单元测试、科学计算、机器学习实验复现以及教学演示场景。
一、为什么需要随机数种子:伪随机数生成原理
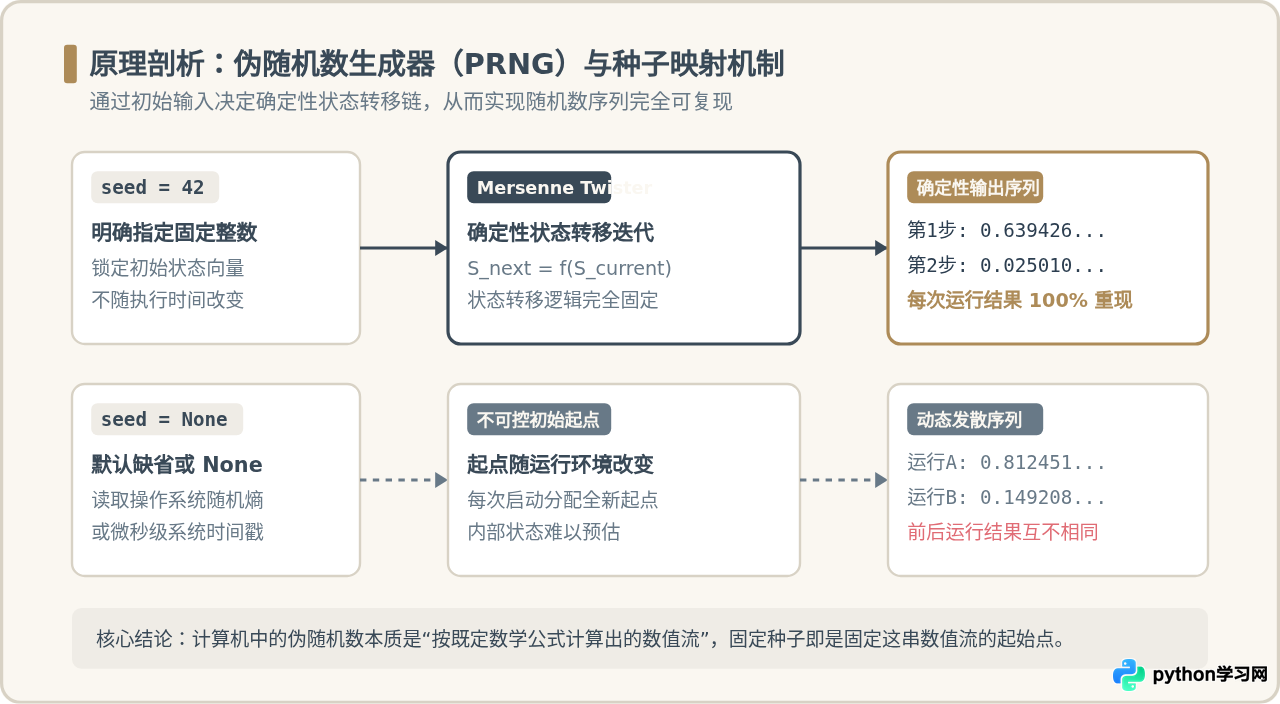
计算机本身无法在没有物理随机源(如环境噪声、辐射计数)的情况下凭空创造真正的绝对随机数。Python 标准库的 random 模块使用的是经典的梅森旋转算法(Mersenne Twister),这是一种确定性的伪随机数生成器(Pseudo-Random Number Generator, 简称 PRNG)。
PRNG 的本质是一个内部状态转移函数:它从一个初始状态出发,经过固定的数学运算推导出一个数字,并将内部状态推进到下一步。如果把这个过程比作播放一张预先刻录好的黑胶唱片,那么“随机数种子(Seed)”就相当于将唱针精确放置到指定音轨的起始标记。只要起点相同,后面播放出来的音符顺序就必然完全一致。
二、random.seed() 的函数语法与参数解析
在 Python 标准库中,random.seed() 函数签名如下:
random.seed(a=None, version=2)该函数包含两个参数,具体含义与规则如下:
| 参数 | 允许类型 | 默认值 | 作用与行为说明 |
|---|---|---|---|
a |
int, float, str, bytes 或 None |
None |
种子本体。若为 None,Python 会优先从操作系统读取随机熵源(如 /dev/urandom),若不可用则采用当前系统时间;若为具体数值或对象,则基于该对象计算初始状态。 |
version |
int (1 或 2) |
2 |
哈希与转换算法版本。Python 3.2 起默认使用版本 2,会将 str、bytes 等对象使用 SHA-512 进行哈希转换;版本 1 仅用于兼容旧版本 Python 的字符串处理逻辑。常规场景保持默认 2 即可。 |
日常开发中最推荐直接传入一个非负整数作为种子(例如 random.seed(42) 或 random.seed(2026))。整数直接作为内部算法的位填充基准,不经过额外的哈希运算,跨平台、跨版本的稳定性最高。
三、设置与验证随机数种子的标准步骤
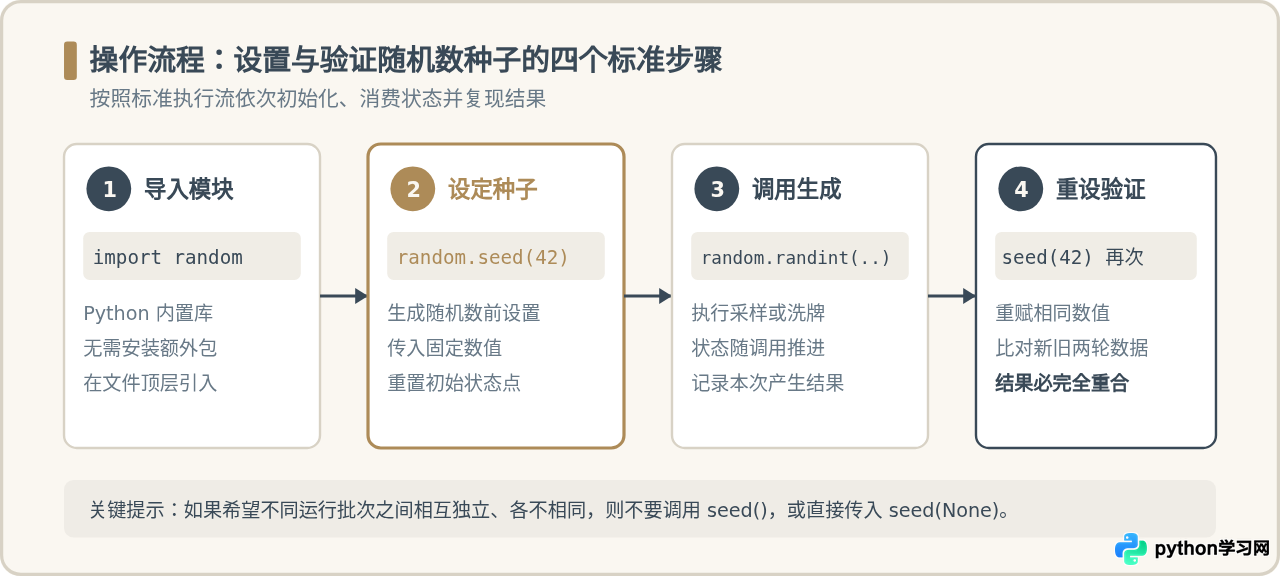
正确使用 random.seed() 需要遵循清晰的调用顺序:必须在实际生成任何随机数之前设定种子。以下是完整的四个执行步骤:
代码演示:验证种子的可复现性
下面通过完整的 Python 代码验证:设置种子后连续生成 3 个随机整数,随后再次设定相同种子,观察生成的随机整数是否完全一致。
import random

# 第一轮测试:设置种子 42 并生成随机数
print("--- 第一轮测试 ---")
random.seed(42)
first_batch = [random.randint(1, 100) for _ in range(3)]
print(f"生成的随机数: {first_batch}")

# 第二轮测试:重新设置相同的种子 42
print("\n--- 第二轮测试(相同种子) ---")
random.seed(42)
second_batch = [random.randint(1, 100) for _ in range(3)]
print(f"生成的随机数: {second_batch}")

# 第三轮测试:切换不同的种子 99
print("\n--- 第三轮测试(不同种子) ---")
random.seed(99)
third_batch = [random.randint(1, 100) for _ in range(3)]
print(f"生成的随机数: {third_batch}")
示例输出:
--- 第一轮测试 ---
生成的随机数: [82, 15, 4]

--- 第二轮测试(相同种子) ---
生成的随机数: [82, 15, 4]

--- 第三轮测试(不同种子) ---
生成的随机数: [27, 43, 62]
从输出可以看到,第一轮与第二轮虽然是独立执行的循环,但由于在执行前均将种子重置为 42,最终生成的列表均为 [82, 15, 4]。而一旦将种子改为 99,输出立刻切换为另一组全新的序列。
四、种子作用域与生命周期:常见误区解析
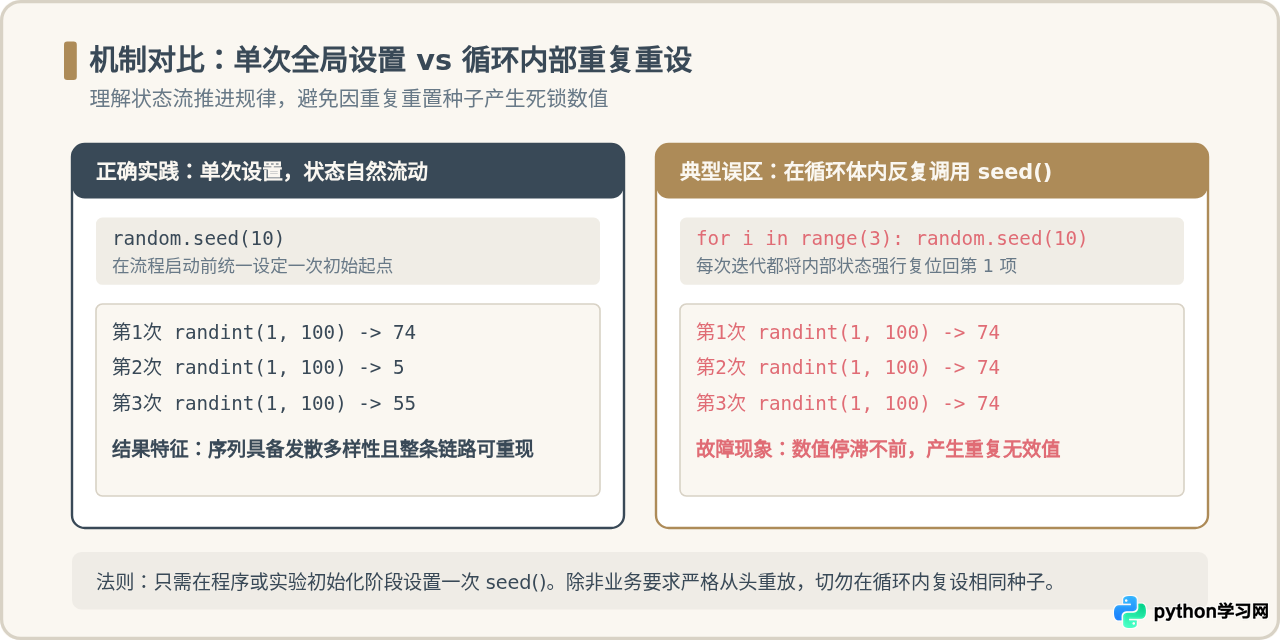
很多初学者在使用 random.seed() 时,容易对其作用范围产生误解,最常见的错误就是“以为每次取随机数都要设一次种子”或者“在循环内部反复重设种子”。
实际上,random.seed() 修改的是 random 模块全局单例生成器的状态。一旦设定种子,后续所有对 random 方法的调用都会在这个确定的序列上依次向前消耗状态。并不是“只对紧跟着的那一行代码生效”,也不是“每个函数都需要单独初始化”。
五、实用案例:在抽样与数据打乱中复现结果
random.seed() 不仅作用于数值生成函数(如 randint、uniform),同样完全控制序列操作函数(如 shuffle 洗牌、sample 无放回抽样、choice 随机选择)。
案例:数据集划分与乱序洗牌复现
在数据处理中,经常需要对样本列表打乱顺序。为了保证他人运行代码时能得到完全相同的训练样本,必须在 shuffle 前设定种子:
import random

fruits = ["苹果", "香蕉", "橙子", "葡萄", "西瓜", "芒果"]

# 设定种子后打乱列表
random.seed(123)
shuffled_fruits_1 = fruits.copy()
random.shuffle(shuffled_fruits_1)
print(f"第一遍打乱结果: {shuffled_fruits_1}")

# 重新设定相同的种子
random.seed(123)
shuffled_fruits_2 = fruits.copy()
random.shuffle(shuffled_fruits_2)
print(f"第二遍打乱结果: {shuffled_fruits_2}")
示例输出:
第一遍打乱结果: ['葡萄', '香蕉', '芒果', '橙子', '西瓜', '苹果']
第二遍打乱结果: ['葡萄', '香蕉', '芒果', '橙子', '西瓜', '苹果']
两遍洗牌得到的元素排列完全吻合。这证明了无论是数值抽取还是数据结构重排,种子机制都具备确定性的控制力。
六、注意事项与避坑指南
在实际生产与科研环境中,使用 random.seed() 时有三项必须明确的边界条件:
1. 安全警告:严禁用于加密与敏感凭证生成
random 模块所使用的梅森旋转算法(Mersenne Twister)完全公开透明,并且具备可预测性。一旦攻击者收集到一定数量的连续随机数输出(大约 624 个 32 位整数),就可以逆向推导出内部的所有状态向量,从而预知之后生成的所有随机数。因此:
- 禁止场景:生成用户密码、重置 Token、会话 Session ID、API 密钥、电子签名随机数。
- 推荐替代:对于一切安全和鉴权相关的场景,必须使用 Python 内置的
secrets模块(如secrets.token_hex()),该模块直接接入操作系统底层的安全加密随机源,不可预测且不支持人为指定弱种子。
2. 多库协同:第三方科学计算库的独立性
这是数据科学初学者最容易踩中的陷阱:调用 random.seed() 只会影响 Python 自带的 random 模块,不会对第三方科学计算库产生任何效果。
- NumPy 拥有独立的随机状态,必须通过
numpy.random.seed(42)进行设定; - PyTorch 拥有独立的 CPU/GPU 随机引擎,必须通过
torch.manual_seed(42)设定; - 如果在同一个项目中混合使用了多个库,必须分别显式设置,才能确保整体计算链路完全可复现。
# 跨库联合设定种子的标准写法示例
import random
import numpy as np
import torch

GLOBAL_SEED = 42

def set_global_seed(seed=GLOBAL_SEED):
    random.seed(seed)                 # 锁定 Python 内置模块
    np.random.seed(seed)              # 锁定 NumPy 模块
    torch.manual_seed(seed)           # 锁定 PyTorch CPU
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(seed) # 锁定 PyTorch 所有 GPU
3. 多线程与并发环境
Python 的内置 random 模块是全局共享实例。在多线程环境中,多个线程同时调用 random.randint() 等方法时,虽然线程安全(由于底层 GIL 锁和内部线程锁),但各线程调用的交错顺序是不确定的。这种交错会导致每次运行虽然总状态推移数相同,但每个线程分到的具体数字发生漂移。如果需要在多线程中严格保证复现性,应为每个线程独立实例化独立的 random.Random(seed) 对象。
七、总结
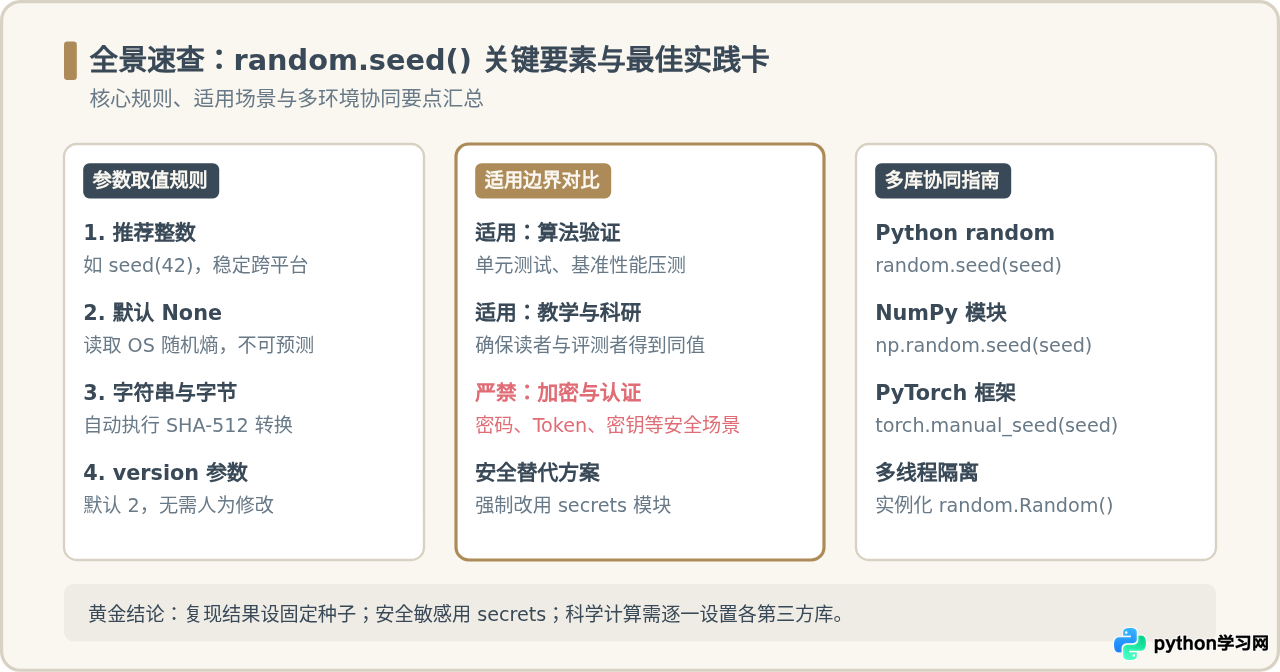
设置 Python 随机数种子的操作极为直接:只需在调用任何随机函数前执行 random.seed(42) 即可。理解其背后的伪随机数生成器原理,能够帮助开发者在日常编码中规避“循环内重复设置种子”以及“误将伪随机库用于密码安全”这两大核心误区。在涉及 NumPy、PyTorch 等外部科学计算库的项目中,牢记为每个库显式设定独立种子,即可实现端到端完整计算结果的确定性复现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









