

Python字典怎么避免KeyError?安全获取值的几种方法
深入讲解在Python中防范字典KeyError异常的5种核心安全取值方法,包含dict.get()、in成员检查、try-except、setdefault与defaultdict的场景对比、嵌套字典解析与选型建议。
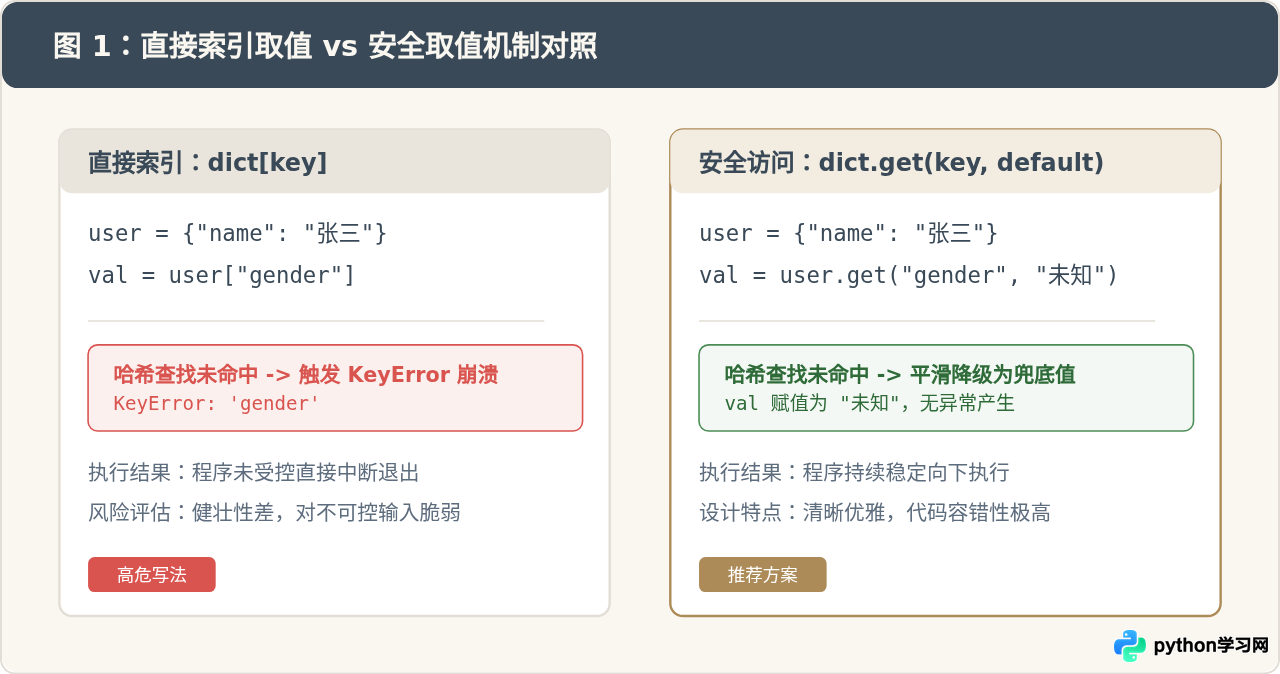
dict[key] 访问字典时,若目标键不存在,解释器会立即抛出 KeyError 并中断程序执行。解决这一问题的核心思路是在取值时建立防御机制:优先选用内置的 dict.get() 方法平滑降级,在需要显式逻辑分支时采用 in 预检,在追求高频极致性能时使用 try...except,而在需要就地写入或分组计数时搭配 setdefault() 或 collections.defaultdict。
一、KeyError 抛出的本质原因与防范必要性
Python 字典的底层是基于高效的哈希表(Hash Table)实现的。当执行 dict[key] 表达式时,解释器首先计算键对象的哈希值并查找对应的散列表插槽。如果该哈希键在字典中未找到匹配项,Python 内部机制没有合理的推测机制去赋予默认值,因此会触发显式的 KeyError 异常。
在实际工程开发中,字典数据常常来自外部接口返回的 JSON、数据库动态查询结果或用户提交的表单配置。这些外部数据存在字段缺失、格式演进或选填属性为空的不确定性。若毫无防御地逐层使用索引取值,任何单个字段的缺失都会导致脚本或服务端进程崩溃。
二、日常首选:dict.get() 方法与缺省兜底
在绝大多数仅需读取值的场景中,dict.get() 是最推荐、最直观的写法。它的签名非常简洁:dict.get(key, default=None)。若键存在,返回对应的值;若键不存在,则返回指定的 default 参数(未指定时返回 None)。
# 基础用法示例
user_profile = {
    "name": "李四",
    "role": "editor"
}

# 1. 不指定默认值:找不到键返回 None
city = user_profile.get("city")
print(city)  # 示例输出:None

# 2. 指定明确的默认值:找不到键返回回退值
score = user_profile.get("score", 0)
status = user_profile.get("status", "pending")
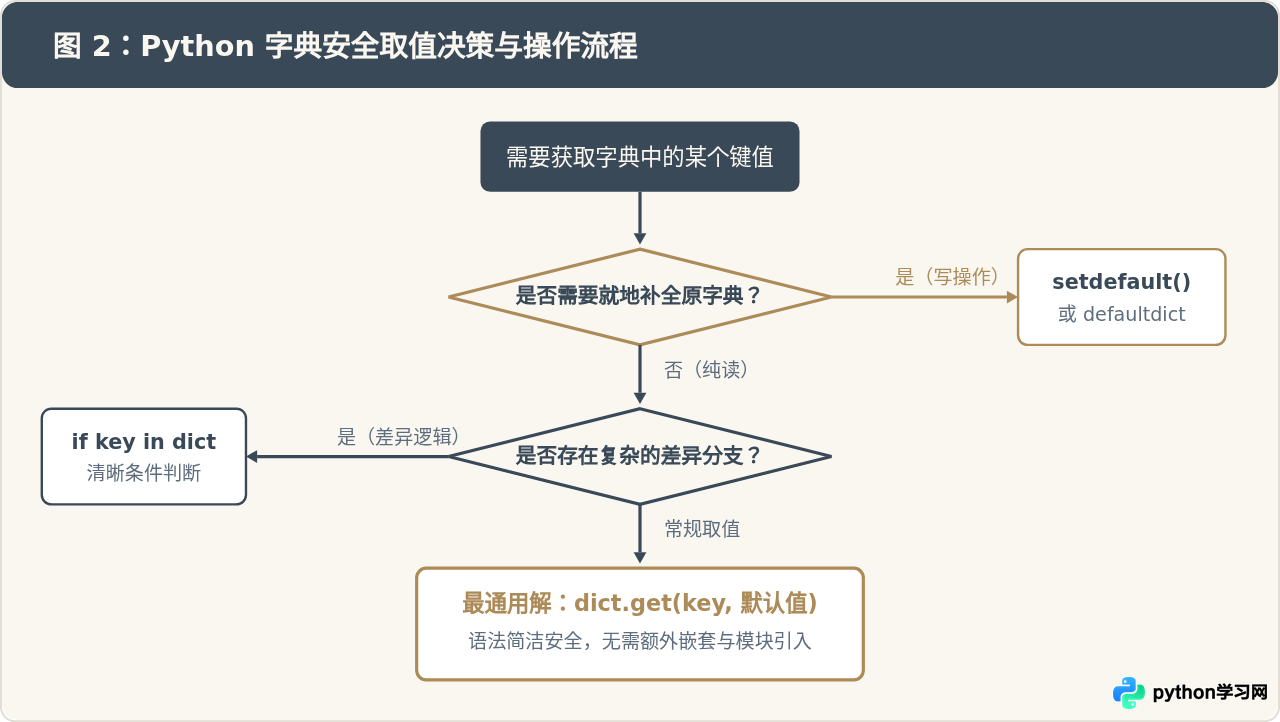
print(f"得分: {score}, 状态: {status}") # 示例输出:得分: 0, 状态: pendingdict.get(key) 得到 None 存在两种可能:一是字典里根本没有这个键;二是字典里确实有这个键,但其本身存储的值就是 None。如果你需要严格区分“键不存在”还是“键存在但值为 None”,单纯调用 get() 无法分辨,此时应结合下面的 in 关键字进行判定。
三、明确分支:使用 in 关键字做成员前置检查
如果业务逻辑要求在“键存在”和“键不存在”时走完全不同的处理流水线,使用 Python 的 in 运算符是最清晰的做法。这种前置检查风格在编程思想中被称为 LBYL(Look Before You Leap,先看后跳)。
config = {
    "debug_mode": True,
    "max_connections": 100
}

# 使用 in 关键字进行键存在性校验
if "max_connections" in config:
    limit = config["max_connections"]
    print(f"应用自定义连接数限制: {limit}")
else:
    limit = 50
    print(f"使用系统默认连接数: {limit}")

# 精确区分“键存在但为None”的场景
payload = {"token": None}
if "token" in payload:
    print("token 字段已被提供(即使值为 None 也符合协议)")
使用 in 运算符检索字典键的时间复杂度是平均 O(1),效率非常高。当后续代码既需要读值又需要根据键是否存在触发其他旁路动作时,in 的语义表现力极佳。
四、性能与哲学:try...except 异常捕获机制
Python 倡导 EAFP(Easier to Ask for Forgiveness than Permission,求原谅比求许可更容易)的编程哲学。在核心高频执行路径中,如果我们预期 99% 的情况下键都是存在的,前置 in 检查会导致两次哈希表查找(一次判断存在,一次提取值)。此时,直接用 try...except KeyError 是运行速度更快且符合 Python 习惯的方案。
cache_data = {f"session_{i}": f"token_{i}" for i in range(1000)}

def fetch_session_token(session_id):
    try:
        # 大概率直接命中,只消耗单次哈希查找
        return cache_data[session_id]
    except KeyError:
        # 仅在未命中异常时捕获并降级
        return "guest_anonymous"

token = fetch_session_token("session_888")
missing_token = fetch_session_token("session_invalid")
print(token)          # 示例输出:token_888
print(missing_token)  # 示例输出:guest_anonymous
在 CPython 解释器中,现代版本的 try 块在无异常发生时开销几乎为零。但在异常确实高频发生的场景下,构造 Traceback 与异常处理的代价会显著高于条件判断,因此该方式适用于“键缺失是罕见例外”的场景。
五、读写一体:就地初始化与 defaultdict 进阶方案
除被动读取外,开发中还经常遇到“键如果不存在,不仅要返回一个初始容器(如空列表或空字典),还要将该初始容器写入字典以供后续修改追加”的场景。此时,常规的 dict.get() 无法胜任,因为 get() 永远不会修改原字典。
1. dict.setdefault():按需原地初始化
dict.setdefault(key, default) 会检查键是否存在。若存在,直接返回当前值;若不存在,则将 key: default 插入原字典并返回 default。
# 统计分组示例:学生选课数据聚合
course_students = {}

def enroll(course, student_name):
    # 如果 course 键不存在,立即插入 course: [],并返回该列表对象
    # 如果存在,则直接返回已有列表
    course_students.setdefault(course, []).append(student_name)

enroll("数学", "张三")
enroll("数学", "李四")
enroll("物理", "王五")

print(course_students)
# 示例输出:{'数学': ['张三', '李四'], '物理': ['王五']}
2. collections.defaultdict:批量容器聚合首选
如果整个数据处理流程都建立在聚合、词频统计或图结构构建上,频繁写 setdefault() 显得较为冗余。标准库 collections 提供的 defaultdict 支持在初始化时传入一个工厂函数(如 list、int、set),任何未声明的键在被访问时都会由工厂函数自动生成初始值并存入字典。
from collections import defaultdict

# 统计词频:int 默认生成 0
word_counts = defaultdict(int)
words = ["apple", "banana", "apple", "orange", "banana", "apple"]

for w in words:
    word_counts[w] += 1  # 遇到新词自动初始化为 0,随后 +1,绝不会抛出 KeyError

print(dict(word_counts))
# 示例输出:{'apple': 3, 'banana': 2, 'orange': 1}
六、深度防御:多层嵌套字典的安全解析技巧
在消费复杂的 API 响应时,字典往往是多层嵌套的(例如 response['data']['user']['settings']['theme'])。很多初学者误以为使用链式 get() 就能高枕无忧,例如写成:response.get('data').get('user').get('settings')。这种写法潜藏着巨大隐患:如果 'data' 字段不存在,第一个 get() 返回 None,接下来对 None 调用 .get() 会抛出更具迷惑性的 AttributeError: 'NoneType' object has no attribute 'get'。
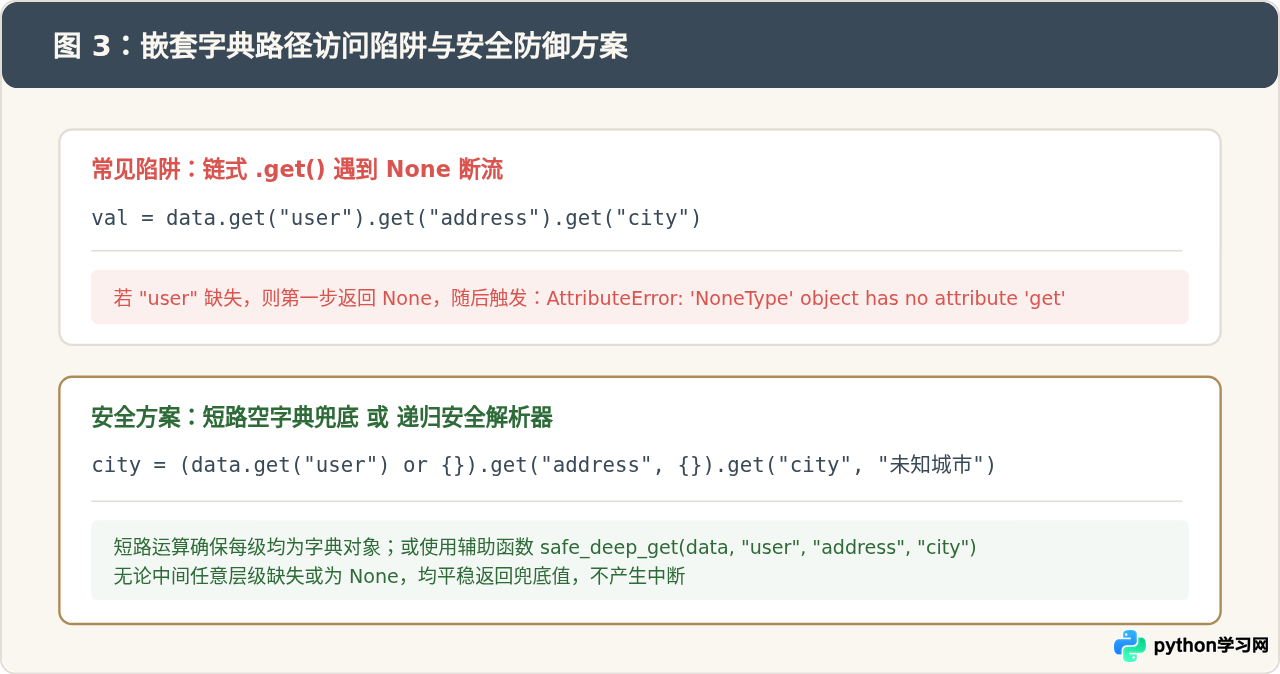
为了优雅处理深层嵌套,推荐编写轻量的通用辅助函数,利用 isinstance 或循环逐步深入:
def deep_get(dictionary, keys, default=None):
    """安全递归获取多层嵌套字典值的实用函数"""
    current = dictionary
    for k in keys:
        if isinstance(current, dict):
            current = current.get(k)
        else:
            return default
    return current if current is not None else default

# 实战测试
api_response = {
    "status": 200,
    "data": {
        "user": {
            "nickname": "极客小张"
            # 注意:此处没有 address 字段
        }
    }
}

city = deep_get(api_response, ["data", "user", "address", "city"], default="未登记")
print(city)  # 示例输出:未登记
七、总结:5种安全取值方法的对比与选型指南
为便于在工程开发中快速决策,下表与图示汇总了本文介绍的 5 种处理方式在核心特性、副作用及典型适用场景上的对比差异:
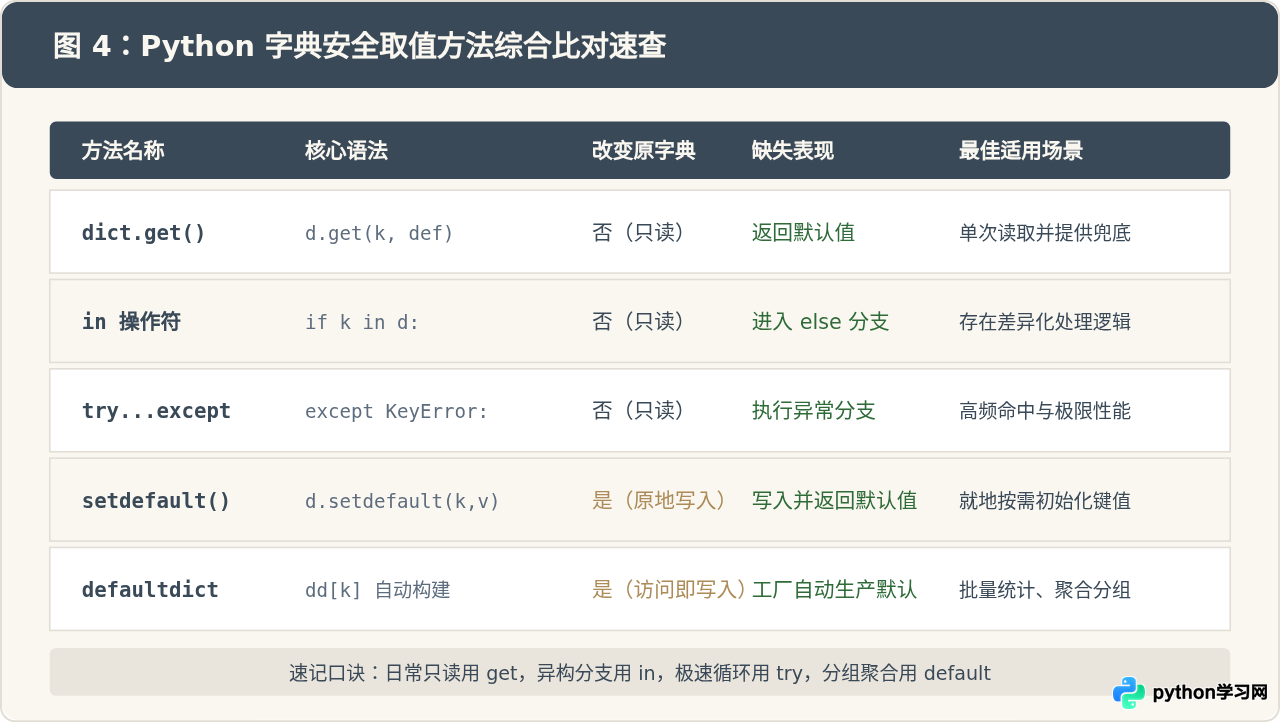
掌握这 5 种方法并根据代码意图合理搭配,不仅能够从根源上消除令人困扰的 KeyError,还能显著提高 Python 程序的健壮性与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









