

Python中怎么设置随机数种子:random.seed()用法与效果验证
详细讲解Python中random.seed()的设置方法、伪随机数生成器底层运作原理、标准可复现性效果验证流程,以及局部实例与多模块隔离的最佳实践。
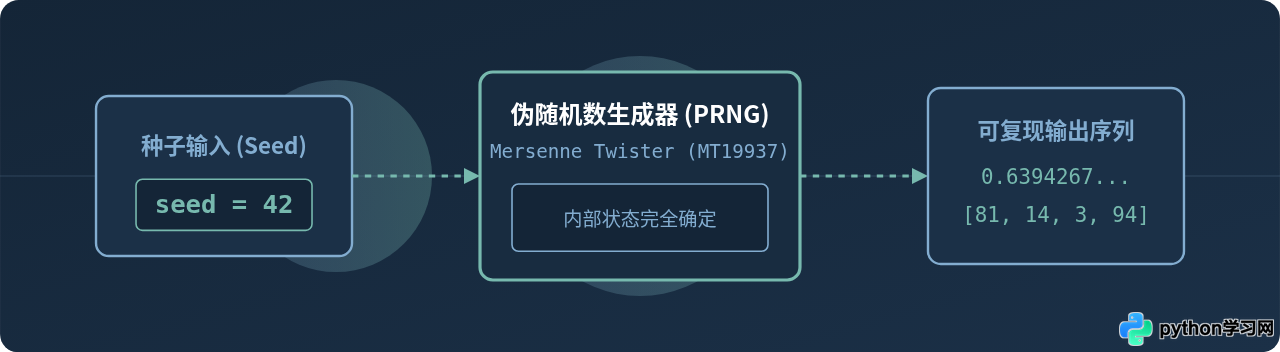
在进行算法调试、单元测试或数据模拟时,如果不做约束,程序每次执行生成的随机数序列都不相同,导致难以定位 Bug 或比对实验数据。在 Python 中消除这种不确定性的标准做法,是在调用任何随机函数之前,使用标准库的 random.seed(x) 设置随机数种子。只要给定的种子值保持一致,Python 就能保证在相同环境下按固定顺序产出完全相同、可逐一复现的随机数序列。
一、random.seed() 的作用机制与原理
计算机生成的随机数绝大多数并非自然界物理意义上的“真随机数”,而是通过数学递推公式算出来的“伪随机数”(Pseudo-Random Number)。Python 标准库中的 random 模块默认使用的是经典的 Mersenne Twister(梅森旋转算法,MT19937)。
梅森旋转算法在内部维护着一个包含数百个整数的状态向量。每当你调用一次诸如 random.randint()、random.random() 或 random.choice() 的函数时,算法就会以当前内部状态为输入,按照严格确定的数学变换更新状态向量,并从中映射提取出一个看似无规律的数值。
所谓随机数种子(Seed),就是用来初始化这个内部状态向量的初始数据值。两种不同的种子配置会带来截然相反的行为:
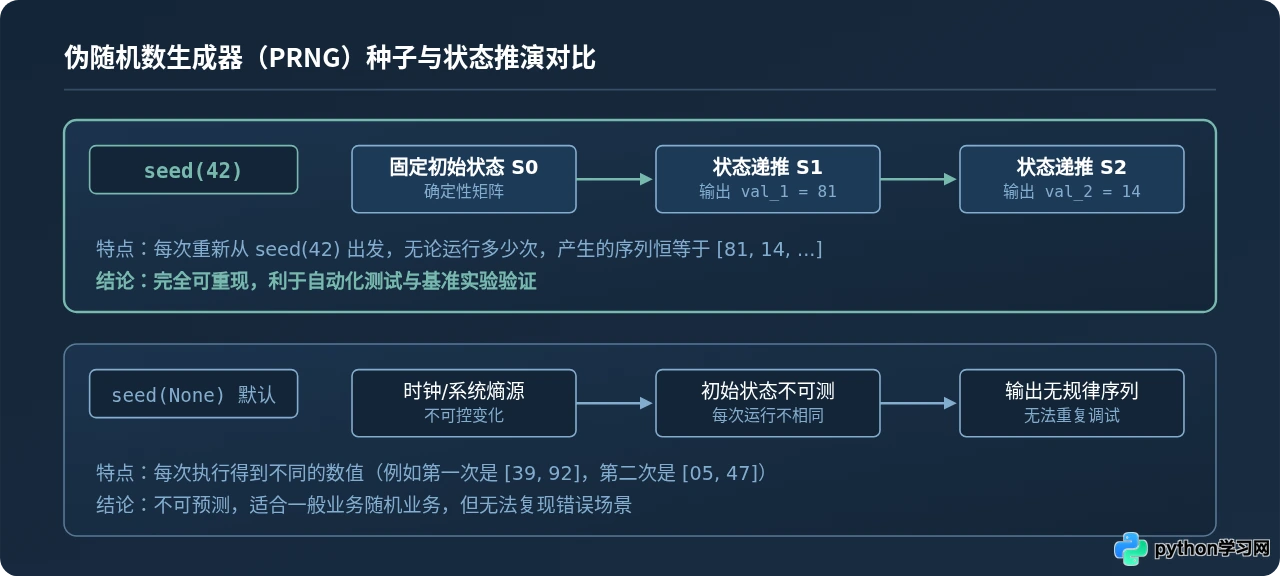
- 不指定种子(或传入 None):Python 会在首次使用随机模块时,读取操作系统内核提供的熵源(如
/dev/urandom)或当前微秒级系统时钟来计算种子。由于每次启动程序时时钟和系统熵都在改变,因此每次生成的随机序列都不一样。 - 显式指定固定种子(如
random.seed(42)):算法的状态向量被强制重置为与该数值对应的特定初始矩阵。由于后续的状态递推逻辑是完全固定的数学公式,接下来的每一次取值顺序、每次生成的数值都必然 100% 一致。
二、random.seed() 的基本语法与用法
在 Python 中使用 random.seed() 非常轻量,不需要安装任何第三方包,直接引入内置的 random 即可。
1. 函数签名与参数规范
random.seed(a=None, version=2)| 参数名 | 支持类型 | 行为说明 |
|---|---|---|
a |
int, str, bytes, bytearray 或 None |
种子数据源。若为 None,则使用系统时间或系统熵源;若为整数(如 42),直接用作状态初始值;若为字符串或字节,会先经过哈希转换成大整数。 |
version |
int(默认为 2) |
算法转换版本。版本 2 会对 str、bytes 等类型使用 SHA-512 处理以生成更长跨度的伪随机种子;版本 1 仅用于兼容旧版 Python 的历史行为。通常保持默认的 2 即可。 |
2. 调用位置与规范
调用 random.seed() 的位置至关重要:必须在任何需要被控制的随机数生成代码运行之前执行。一旦调用,它会立即覆盖当前的生成器状态。如果在循环内部每次都重复设定同一个种子,会导致每次循环抽取到的都是“序列第一项”,反而失去了随机散列的意义。
import random

# 推荐做法:在脚本初始化或需要固定序列的起点设定一次
random.seed(2026)

# 后续按需调用各类随机方法
print("浮点随机数:", random.random())
print("区间整数:", random.randint(1, 100))
print("序列抽样:", random.choice(["Node-A", "Node-B", "Node-C"]))三、核心步骤与效果验证:标准测试流程
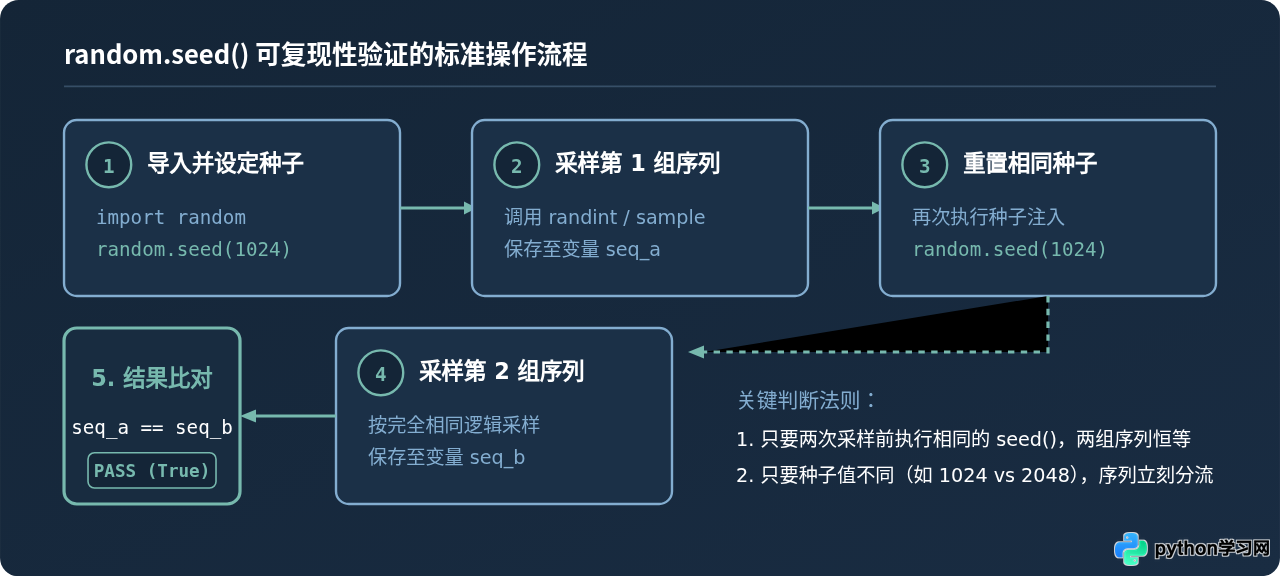
为了真正验证 random.seed() 的效果,我们需要设计一个清晰的闭环验证流程:设置种子、记录生成序列、重置回该种子、再次生成序列,最后通过程序自动化断言证明两组数据完全吻合。
可直接运行的完整验证代码
下面是一段可直接保存并执行的 Python 脚本,涵盖了整数、浮点数、列表打乱(shuffle)等多类型随机行为的全面对比验证:
import random

def generate_random_dataset():
    """按固定顺序调用多种随机操作,返回数据快照"""
    integers = [random.randint(10, 99) for _ in range(5)]
    floats = [round(random.random(), 4) for _ in range(3)]

    deck = ["A", "B", "C", "D", "E"]
    random.shuffle(deck)

    choice = random.choice(["Red", "Green", "Blue", "Yellow"])
    return {
        "integers": integers,
        "floats": floats,
        "deck": deck,
        "choice": choice
    }

print("=== 第一阶段:使用种子 42 生成数据 ===")
random.seed(42)
result_run1 = generate_random_dataset()
print("Run 1 结果:", result_run1)

print("\n=== 第二阶段:不重置种子,继续生成数据 ===")
result_run2 = generate_random_dataset()
print("Run 2 结果:", result_run2)

print("\n=== 第三阶段:重新注入种子 42,再次生成数据 ===")
random.seed(42)
result_run3 = generate_random_dataset()
print("Run 3 结果:", result_run3)

print("\n=== 第四阶段:注入不同种子 999 生成数据 ===")
random.seed(999)
result_run4 = generate_random_dataset()
print("Run 4 结果:", result_run4)

# 自动化断言验证
assert result_run1 == result_run3, "验证失败:相同种子必须生成完全相同的数据!"
assert result_run1 != result_run2, "验证确认:未重置种子时状态向前推进,数据应不相同。"
assert result_run1 != result_run4, "验证确认:不同种子生成的数据应不相同。"

print("\n[VERIFICATION SUCCESS] 所有断言均通过,random.seed() 效果验证无误!")四、常见误区与深层机制
在工程项目中运用随机数种子时,以下几个认知偏差容易导致可复现性失效或程序逻辑出现隐蔽故障:
误区一:误以为 random.seed() 每次只管“下一个随机数”
有些开发者在代码中每生成一个随机数就调用一次 random.seed(1),例如在列表推导式或循环体内重复执行:
# 错误示例:错误地重复重置种子
data = []
for _ in range(5):
    random.seed(42)  # 每次都重置回起点!
    data.append(random.randint(1, 100))

print("错误做法输出:", data)因为每次循环开始都把内部状态强行拨回起点,所以每次 randint 获取的都是序列的第一项(81)。正确的理解是:种子决定的是一整条递推序列,只需在序列起始处设定一次即可。
误区二:全局状态污染与多模块干扰
random.seed() 作用的是 Python 进程内的全局单例。如果你的项目包含多个第三方库或后台线程,其他模块中执行的随机操作会悄悄推进全局状态;反之,你在某个函数内执行 random.seed() 也会扰乱其他业务的随机行为。
工程推荐解决方案:使用独立的 random.Random 实例。通过实例化独立对象,可以构建互不干扰的独立沙箱空间:
import random

# 创建相互隔离的独立伪随机数生成器实例
worker_a = random.Random(42)
worker_b = random.Random(42)

# worker_a 的采样推进完全不影响 worker_b
val_a1 = worker_a.randint(1, 100)
val_a2 = worker_a.randint(1, 100)

val_b1 = worker_b.randint(1, 100)

print(f"worker_a 连续抽取: {val_a1}, {val_a2}")
print(f"worker_b 首次抽取: {val_b1}")
assert val_a1 == val_b1, "两独立实例在初始种子相同时,首次抽取必然一致"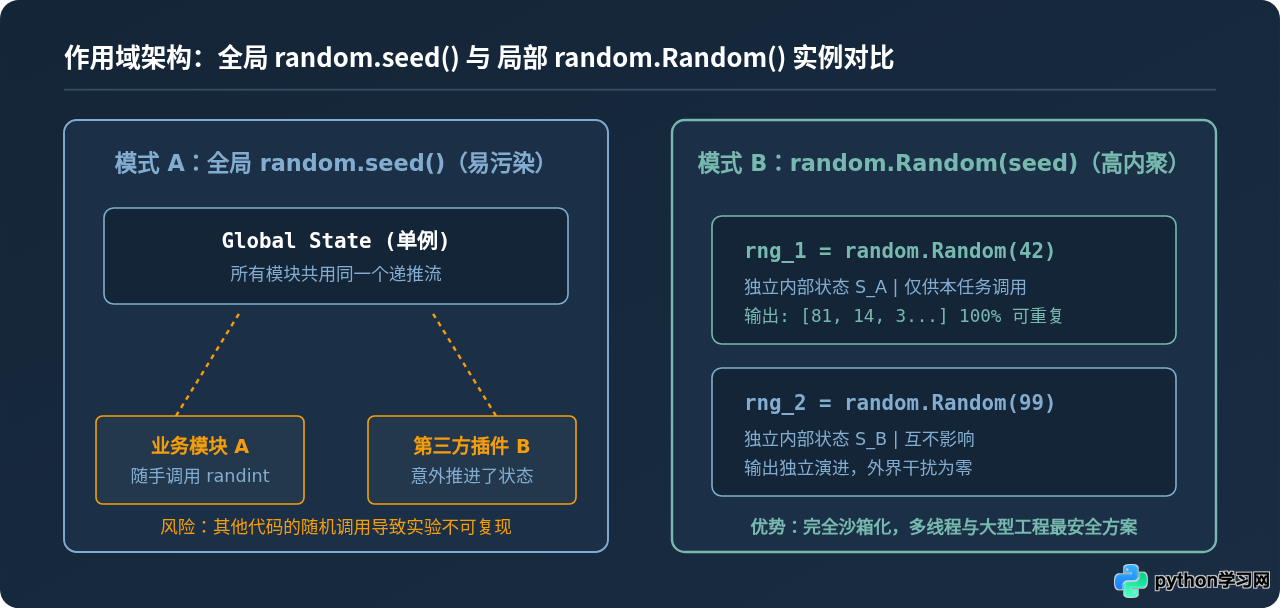
误区三:以为 random.seed() 能同步控制 NumPy / PyTorch
在数据科学与机器学习项目中,很多初学者在开头写了 random.seed(42),却发现 numpy.random 或 torch.randn 仍然每次变动。这是因为 Python 标准库 random、第三方库 numpy 和 torch 各自拥有一套独立的 C/C++ 伪随机底层实现,内存状态互相独立。
若需要完整的多库可复现环境,必须同时分别注入种子:
import random
import os

def set_global_determinism(seed=42):
    """同时锁定多组件随机源的工程规范函数"""
    # 1. Python 原生内置
    random.seed(seed)

    # 2. Python 散列种子(防止字典与集合遍历顺序在不同次进程启动中产生差异)
    os.environ['PYTHONHASHSEED'] = str(seed)

    # 3. 如果项目中引入了 NumPy,需同步设置:
    try:
        import numpy as np
        np.random.seed(seed)
    except ImportError:
        pass

    # 4. 如果项目中引入了 PyTorch,需同步设置:
    try:
        import torch
        torch.manual_seed(seed)
        if torch.cuda.is_available():
            torch.cuda.manual_seed_all(seed)
    except ImportError:
        pass

# 在程序入口第一时间调用
set_global_determinism(42)random.seed() 生成的序列严格属于伪随机,绝对不能用于密码、生成 Token、私钥或安全敏感凭据。因为攻击者只要收集到少数几个连续输出,即可反推整个梅森旋转算法的 624 个内部状态,从而预测后续所有输出。在安全领域必须使用 Python 内置的 secrets 模块(如 secrets.token_hex()),该模块直接调用操作系统的密码学安全随机源(CSPRNG)。
五、工程实践规范与总结
在日常开发与科研场景中,合理使用 random.seed() 需要遵循清晰的工程决策准则:
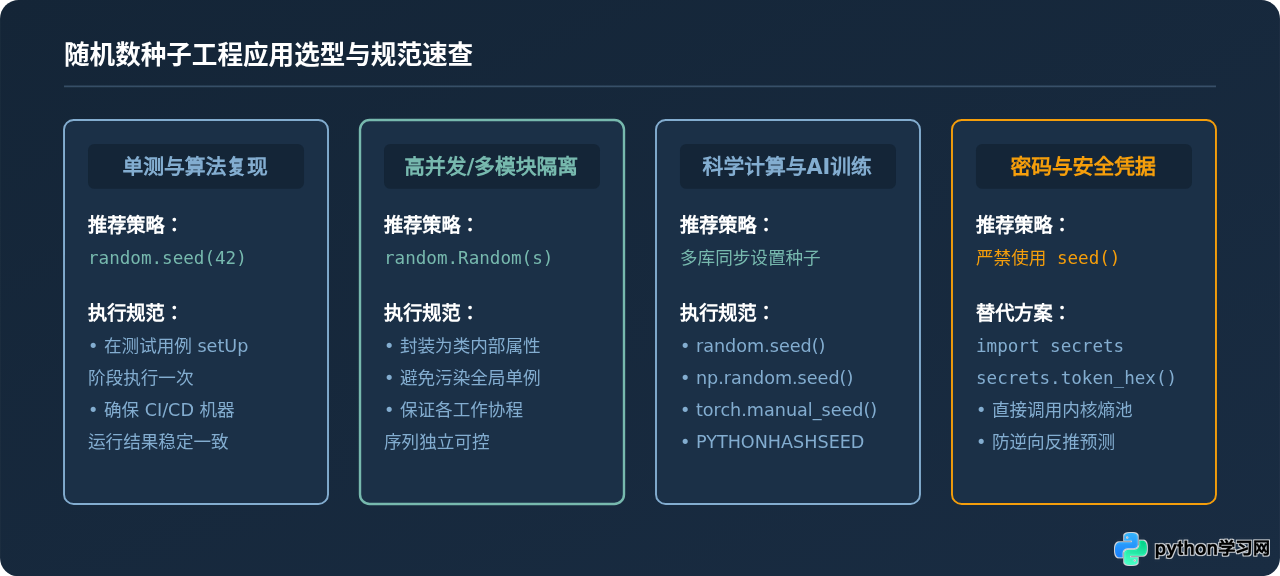
总结要点清单
- 操作极简:只需调用
random.seed(x)即可完成初始化,种子类型通常推荐使用清晰的整数(如固定基准数字 42)。 - 影响全局序列:种子不是单次过滤,而是锁定了接下来一整串随机状态演进。只要在执行采样序列前调用一次即可,切勿在循环体内重复重置。
- 严格可验证:通过保存采样快照、重置同种子再次采样、比对二者等值(
assert seq_1 == seq_2),可在任何测试套件中自动化确认其复现有效性。 - 复杂工程使用独立对象:多线程或大模块协作中,优先使用
rng = random.Random(seed)实现状态隔离沙箱,防止全局污染。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









