

Python爬虫用什么框架?Scrapy、Requests与Selenium选型指南
针对Python网络爬虫在实际开发中的框架选型问题,深入对比Requests、Scrapy与Selenium的技术定位、性能表现、反爬应对与工程维护成本,提供清晰的决策路径与实战建议。
一、三类工具的技术本质与定位差异
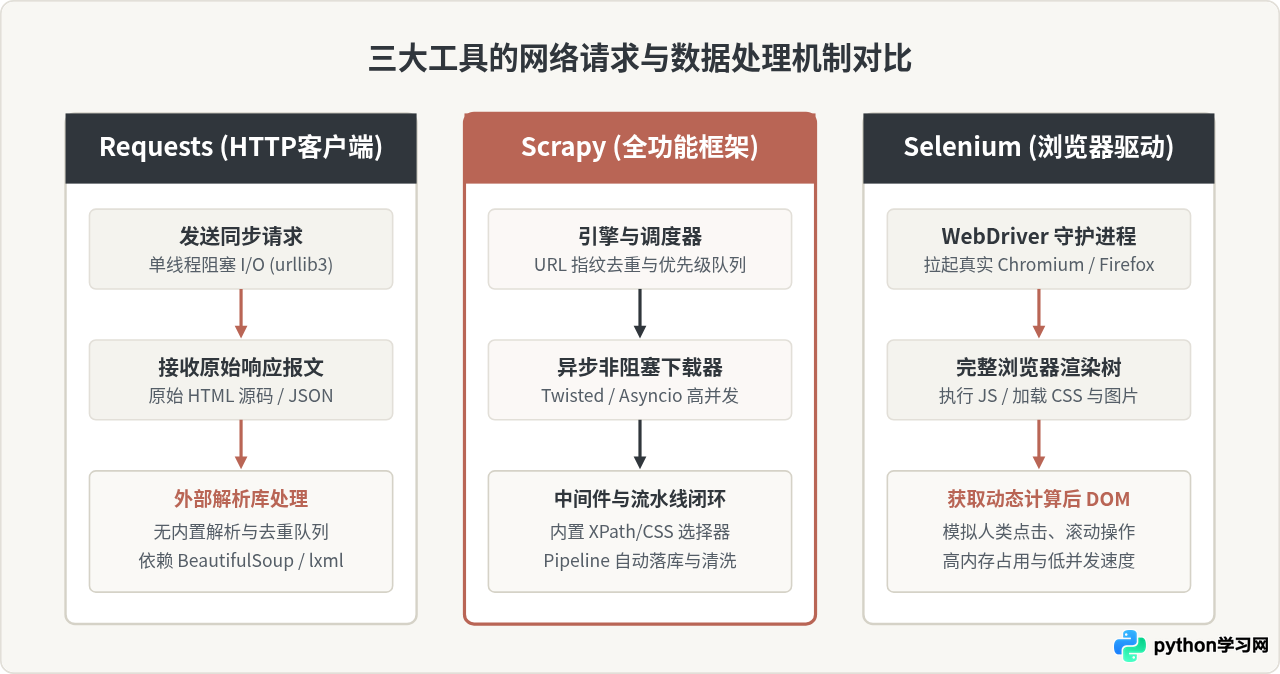
初学者容易将 Requests、Scrapy 和 Selenium 放在同一维度去比较,但事实上它们处于爬虫技术栈中完全不同的层级:Requests 是轻量级的 HTTP 协议客户端,Scrapy 是完备的异步爬虫工程框架,而 Selenium 则是用于驱动实际浏览器的自动化测试工具。理解这种根本属性的差异,是做出正确技术选型的第一步。
1. Requests:极简而直接的 HTTP 工具
Requests 的核心价值在于零心智负担。它将底层的 socket 通信与复杂的 HTTP 规范封装为最符合人类直觉的 API。当你要抓取的数据可以通过简单的 GET 或 POST 请求直接拿到,或者目标网站提供标准的 JSON 接口时,编写一个基于 Requests 的脚本通常只需十几行代码,几分钟内即可完成部署并获取结果。
但必须清楚,Requests 本身不具备任何网页解析能力,也不管理调度。这意味着:URL 去重需要你自己用 set 或 Redis 维护;解析 HTML 需要配合 BeautifulSoup4、lxml 或 Parsel;失败重试、IP 轮询、并发线程池都需要开发者手动编写代码胶水。如果任务规模扩大,自己用 Requests 搭建出来的“爬虫系统”往往容易在异常处理和并发控制上漏洞百出。
2. Scrapy:工业级数据管道与事件驱动架构
Scrapy 是一个遵循严格工程规范的重量级爬虫框架。它基于 Twisted 异步事件驱动模型,拥有完整的组件解耦设计。在 Scrapy 中,数据采集被标准化为“产生请求(Spider) → 调度去重(Scheduler) → 异步下载(Downloader) → 字段提取(Selector) → 数据清洗与持久化(Item Pipeline)”的流水线。
Scrapy 的优势在于吞吐量与工程鲁棒性。在单机常规硬件上,Scrapy 能够轻松维持每秒数百个请求的高并发吞吐,内置的布隆过滤或指纹去重机制可以保证抓取几百万个页面不发生内存膨胀。然而,它的缺点同样明显:学习曲线陡峭,对新手而言项目结构复杂;由于完全基于异步回调,传统的单步断点调试不如同步脚本直观;此外,面对强依赖浏览器运行时的前端交互,Scrapy 原生无法直接执行 JavaScript。
3. Selenium:真实浏览器环境的终极兜底
Selenium 的初衷是端到端 Web 自动化测试,它通过 WebDriver 协议向真实的浏览器(如 Chrome、Firefox)发送命令。对于爬虫而言,Selenium 的最大杀手锏是:只要能在屏幕浏览器上看到的内容,它就能完整读取。
当目标网页应用了极其复杂的前端混淆算法、动态计算请求签名,或者大量使用 WebSocket 与单页应用(SPA)渲染,逆向分析 API 的成本可能需要耗费数天甚至数周。此时,使用 Selenium 可以直接绕过前端逆向环节,由浏览器内核完成 JavaScript 执行和 DOM 挂载,开发者直接提取最终的渲染结果。但这种便利是有昂贵代价的:一个无头 Chrome 实例至少占用 100MB~300MB 内存,渲染完整的页面还需要加载 CSS、字体及图片资源,单次页面请求耗时通常在 2~10 秒之间,并发吞吐量比纯 HTTP 请求低两个数量级以上,且极易被反爬系统通过 navigator.webdriver 特征指纹识别并封禁。
二、深入 Scrapy:事件循环与内部组件流转
很多开发者在面临中大型项目时犹豫要不要采用 Scrapy。要理解 Scrapy 为什么能以极低的资源占用支撑起数十倍于 Requests 的吞吐量,必须透视其内部的数据流转架构:
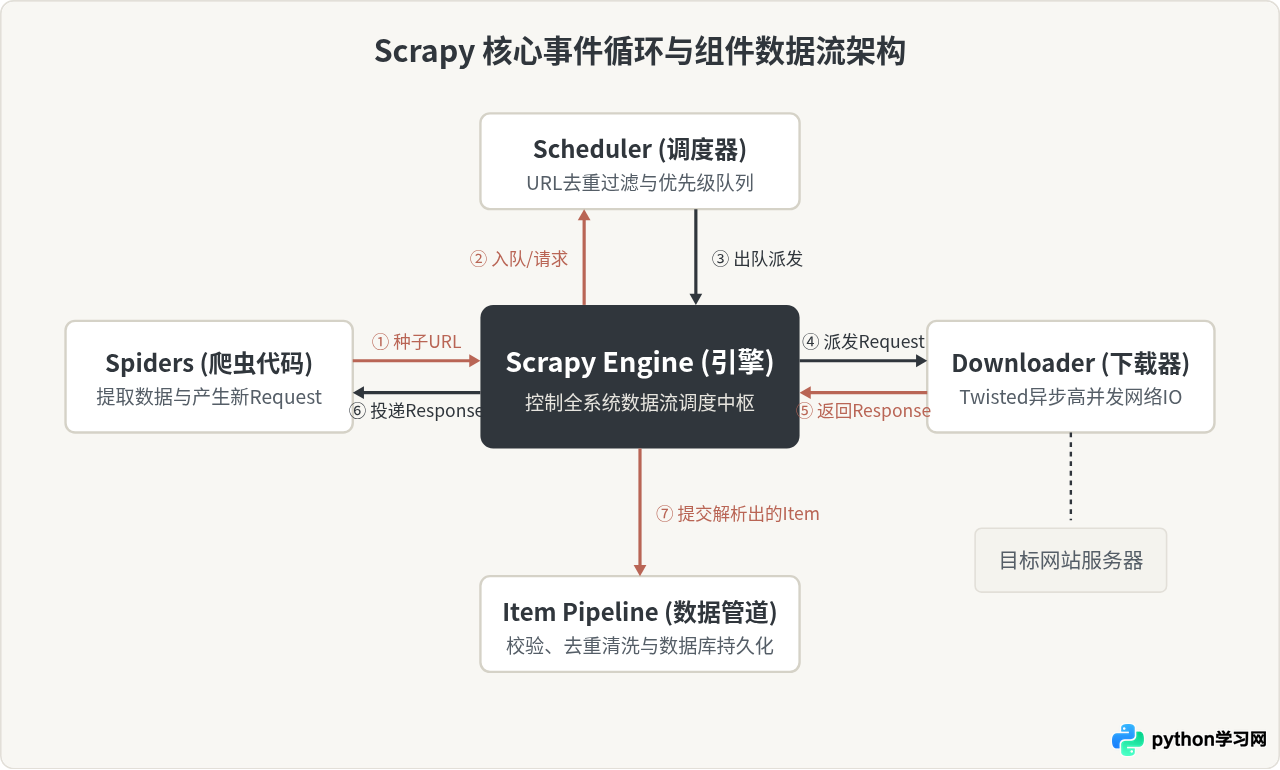
在 Scrapy 的工作流中:
- 爬虫初次启动,从
start_requests产生初始种子 URL 并送入引擎。 - 引擎将请求转交给调度器,调度器通过计算指纹去重并放入优先级优先队列。
- 调度器根据设置的下载延迟与并发限制,将下一个待抓取的 Request 弹还给引擎。
- 引擎通过 Downloader Middleware(在此可集中注入代理 IP、伪造 User-Agent 或处理 Cookie)把请求发送给下载器。
- 下载器在 Twisted 事件循环内以非阻塞形式与远程服务器完成通信,将获取到的
Response回传给引擎。 - 引擎通过 Spider Middleware 将响应喂入爬虫的解析回调函数(如
parse)。 - 爬虫回调提取出两种产物:新的爬取请求(如详情页或下一页,回流至第 1 步)以及结构化数据(
Item),后者被引擎送入 Item Pipeline 完成数据清洗、校验和最终入库(如写入 MySQL、MongoDB 或 Elasticsearch)。
三、核心维度横向对比
为了直观评估不同方案的技术特征,我们从并发模型、渲染能力、学习与维护开销、反爬应对及典型应用规模五个维度进行系统对照:
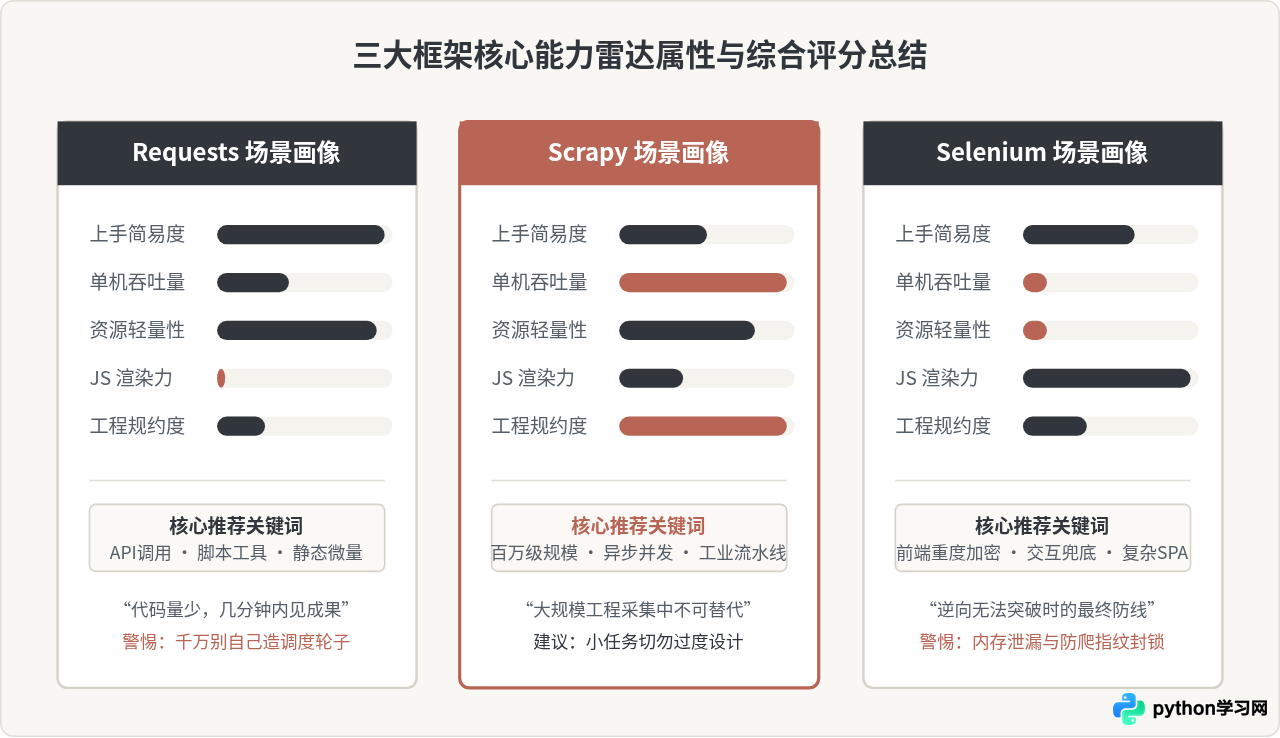
| 比较维度 | Requests (+ bs4/lxml) | Scrapy | Selenium (WebDriver) |
|---|---|---|---|
| 并发与请求模型 | 同步阻塞 I/O,需手动配置 concurrent.futures 或多进程扩充并发 |
原生基于 Twisted/asyncio 的非阻塞异步事件循环,单进程可承载数百并发 | 多进程启动无头浏览器实例,单实例占用高,并发受限于机器 CPU 与内存 |
| JavaScript 渲染 | 不支持,仅能获取服务端直接返回的静态 HTML 或 JSON 数据 | 原生不支持;但可通过 scrapy-playwright 或 Splash 插件扩展渲染 |
完整支持,直接驱动 Chromium/Firefox 渲染引擎执行所有客户端 JS 脚本 |
| 开发与上手成本 | 极低。几乎零样板代码,单文件脚本即可运行,调试非常直观 | 中等偏高。需熟悉命令行工具、配置项、中间件钩子与异步回调范式 | 中等。API 类似前端 DOM 操作,直观但需要处理元素显式等待与超时异常 |
| 单机吞吐与资源开销 | 轻量,单请求耗费内存微弱,吞吐量主要受网络延迟和线程切换限制 | 极高吞吐,单机轻松实现万级页面/分钟,内存占用小且支持流式处理 | 极重,单实例通常占用 150MB~400MB 内存,每分钟抓取量通常在几十到上百页 |
| 反爬应对特性 | 轻量灵活,适合快速构造自定义 Header、Session 复用与代理配置 | 生态完备,中间件支持批量代理池、随机 UA、自动限速(AutoThrottle) | 容易产生 cdc_ 等自动化指纹特征,易被 Cloudflare / Akamai 专项拦截 |
| 最佳适用场景 | 万级以内轻量爬虫、监控报警、分析清晰的公开 JSON API 调用 | 十万至千万级全站采集、行业垂直数据聚合、工业级长期巡检与增量更新 | 高防加密动态网站、复杂滑块验证码绕过、需要登录态人机交互验证的兜底场景 |
四、选型决策操作路径:5 步确定技术栈
面对一个具体的数据采集任务,不要凭主观喜好立即开始写代码,而应当按照标准化的决策树依次进行环境与目标分析:
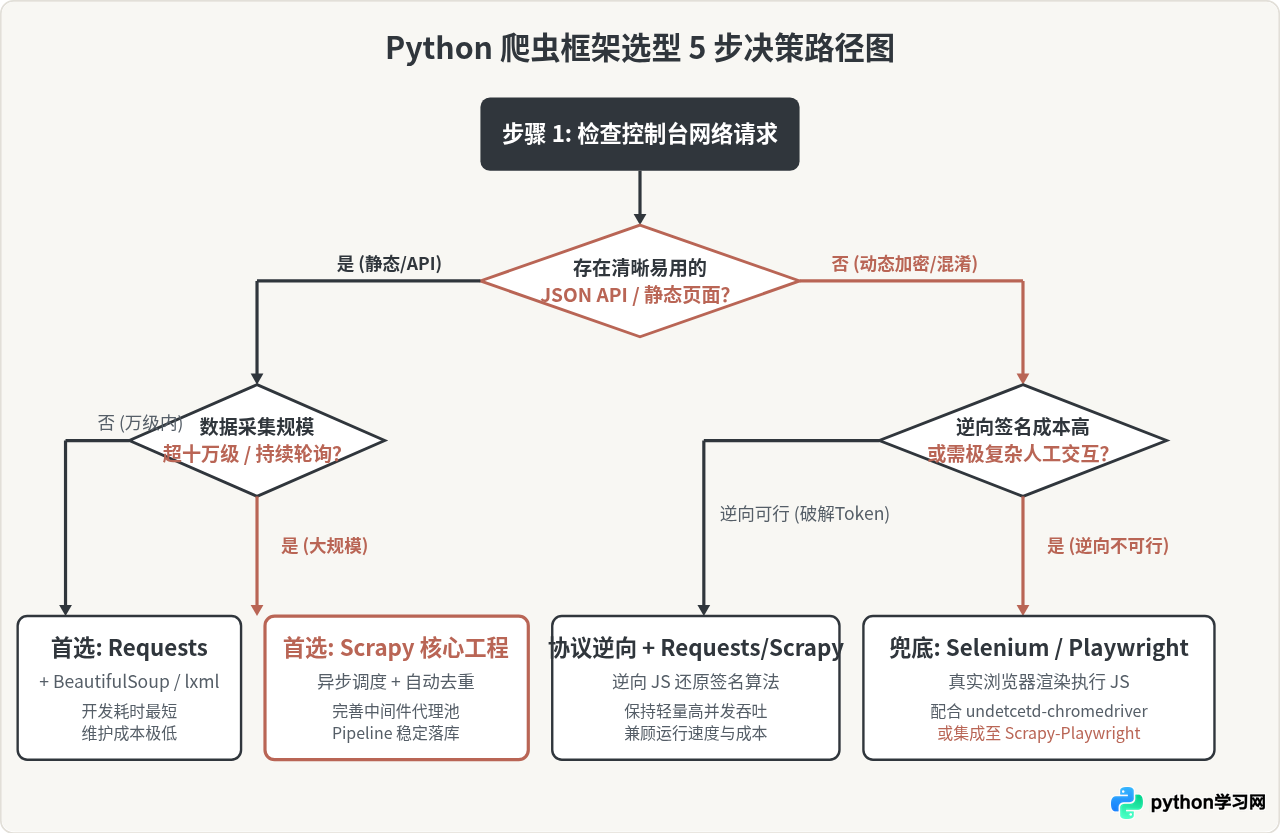
步骤一:审查网络面板(Network Tab)寻找纯净 API
在打开浏览器开发者工具的 Network 面板并刷新页面后,优先过滤 Fetch/XHR 类型的请求。很多看似结构复杂的网页,其真实数据其实是由异步接口返回的标准 JSON。如果找到了该接口且参数中没有动态变化的混淆签名(如时间戳+哈希盐值),那么直接调用该接口是最高效的途径。此时直接选择 Requests。
步骤二:确认数据是否存在于服务端初始 HTML 中
在浏览器中右键点击“查看网页源代码”(View Page Source,注意不是 Elements 检查元素)。如果在源码中能够直接搜索到目标数据,说明该网页属于传统服务端渲染(SSR)。对于此类页面,纯 HTTP 请求配合 HTML 解析库即可完全搞定,根本无需启动笨重的浏览器自动化工具。
步骤三:测算预期的抓取规模与生命周期
技术选型必须考虑 ROI(投入产出比):
- 临时性/一次性采集(几百至两三万条):即便网页需要分页,使用 Requests 搭配 Python 自带的
concurrent.futures.ThreadPoolExecutor也能在几分钟内写完跑完。 - 长期周期性监控或数百万级全网采集:必须立刻转向 Scrapy。因为大规模采集必然会遭遇断点续爬、动态重试、死链剔除、IP 被封后的自动退避等复杂现实问题,自研脚本在这些工程细节上的维护成本会呈指数级上升。
步骤四:评估反爬阻力与逆向成本
如果数据由客户端前端渲染,且 API 请求头中携带了由混淆 JS 动态生成的 Token(如 _signature、x-s 等):
- 如果团队中有熟悉 JavaScript 逆向和 AST 解混淆的成员,逆向出加密逻辑后继续使用纯 HTTP(Requests 或 Scrapy)是最佳解法,其抓取速度和服务器开销均远优于浏览器方案。
- 如果加密代码经过高强度 Control Flow Flattening(控制流平坦化)且有时限要求,逆向成本大于硬件成本时,应果断采用 Selenium 或 Playwright 进行渲染截取。
步骤五:评估混合架构的可行性
选型并不意味着非此即彼。现代大型数据采集系统中,行业成熟做法是以 Scrapy 作为骨干中枢,局部接入无头浏览器。例如通过 scrapy-playwright 扩展库,可以让 95% 的静态页面走 Scrapy 原生异步纯请求,仅在特定需要动态加载或滑块验证的几步操作中挂载浏览器页面,兼顾系统吞吐量与复杂场景的通过率。
五、典型实战代码与操作规范
1. Requests 健壮抓取范式
使用 Requests 时,切忌直接调用裸露的 requests.get()。规范的做法是使用 requests.Session() 维持连接池与 Cookie,并挂载 HTTPAdapter 实现自动超时重试:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
from bs4 import BeautifulSoup

def create_robust_session():
    session = requests.Session()
    # 配置指数退避重试机制
    retries = Retry(
        total=3,
        backoff_factor=1,
        status_forcelist=[500, 502, 503, 504],
        allowed_methods=["GET", "POST"]
    )
    adapter = HTTPAdapter(max_retries=retries)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    })
    return session

def fetch_article_titles(url):
    session = create_robust_session()
    try:
        response = session.get(url, timeout=10)
        response.raise_for_status()
        # 指定 lxml 解析器保证解析速度与容错率
        soup = BeautifulSoup(response.text, "lxml")
        titles = [node.get_text(strip=True) for node in soup.select("h2.entry-title")]
        return titles
    except requests.RequestException as err:
        print(f"请求发生异常: {err}")
return []必须显式设置 timeout。在未指定 timeout 的情况下,Requests 会默认无限期挂起等待底层 socket 响应,一旦目标服务器静默断开或发生死锁,你的整个爬虫程序就会彻底永久停滞。
2. Scrapy 标准化工程范式
在 Scrapy 项目中,代码按职责划分在不同模块内。以下是一个典型的 Spider 解析逻辑:
import scrapy

class BlogSpider(scrapy.Spider):
    name = "tech_blog"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/articles"]

    custom_settings = {
        "CONCURRENT_REQUESTS": 16,
        "DOWNLOAD_DELAY": 0.5,
        "AUTOTHROTTLE_ENABLED": True,
        "ITEM_PIPELINES": {
            "myproject.pipelines.MongoPersistencePipeline": 300,
        }
    }

    def parse(self, response):
        # 使用 CSS 选择器抽取文章列表卡片
        for card in response.css("div.post-card"):
            yield {
                "title": card.css("h2 a::text").get(),
                "url": response.urljoin(card.css("h2 a::attr(href)").get()),
                "date": card.css("span.post-date::text").get(),
            }

        # 提取下一页链接并自动递归
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page is not None:
            yield response.follow(next_page, callback=self.parse)
执行该爬虫时,直接在工程根目录下执行终端命令即可:
# 启动爬虫并将提取结果直接流式导出为 JSONL 文件
scrapy crawl tech_blog -o articles.jsonl
3. Selenium 无头驱动与隐式反检测
针对必须要使用浏览器加载渲染的场景,必须正确关闭自动化检测标记,并使用显式等待(Explicit Wait)代替死板的 time.sleep():
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

def create_headless_driver():
    options = Options()
    options.add_argument("--headless=new")  # 使用现代 Chromium 无头模式
    options.add_argument("--disable-gpu")
    options.add_argument("--window-size=1920,1080")
    # 规避基础自动化特征检测
    options.add_argument("--disable-blink-features=AutomationControlled")
    options.add_experimental_option("excludeSwitches", ["enable-automation"])
    options.add_experimental_option("useAutomationExtension", False)

    driver = webdriver.Chrome(options=options)
    # 修改 JavaScript 原型链隐藏 webdriver 标志
    driver.execute_cdp_cmd("Page.addScriptToEvaluateOnNewDocument", {
        "source": "Object.defineProperty(navigator, 'webdriver', {get: () => undefined})"
    })
    return driver

def scrape_dynamic_page(url):
    driver = create_headless_driver()
    try:
        driver.get(url)
        # 显式等待指定内容挂载完成,最长等待 15 秒
        element = WebDriverWait(driver, 15).until(
            EC.presence_of_element_located((By.CSS_SELECTOR, "div.dynamic-rendered-content"))
        )
        print("页面动态内容渲染完成:", element.text)
        return driver.page_source
    finally:
        # 确保无论发生何种异常,都必须显式退出销毁浏览器进程
driver.quit()在编写 Selenium 爬虫时,务必将 driver.quit() 放入 finally 块中。如果仅依靠程序自然退出或简单调用 driver.close(),当程序遇到异常崩溃时,后台往往会残留大量僵尸 chromedriver 与 chrome 进程,几天之内就能耗尽服务器的全部可用内存与句柄数。
六、常见选型误区与总结建议
在日常爬虫系统设计中,经常能见到以下几种典型的误区,在确定方案前应当认真对照排查:
- 误区一:一遇到 JS 渲染页面就立刻启动 Selenium。 现代前端架构(Vue、React 等)大多采用前后端分离,前端执行 JS 的实质其实是向后端 API 发送 Ajax 请求并渲染返回的 JSON。很多时候只要打开 Network 抓包,就能找到那个纯净且没有校验的 API 接口,用 Requests 一秒钟能抓几十次,而开着浏览器一分钟只能抓几次。
- 误区二:在 Scrapy 里滥用全局变量与同步阻塞库。 Scrapy 底层是单线程异步 Reactor。如果你在 Spider 或 Pipeline 里调用了
time.sleep()、同步的requests.get()或没有使用连接池的同步 SQL 查询,会直接阻塞整个事件循环,导致其他几十个并发请求全部卡死。 - 误区三:给微型任务搭建 Scrapy 全家桶。 如果仅仅是抓取学校教务处的一个通知列表或者某站点两页的静态表格,建立完整的 Scrapy 项目结构、配置 items、pipelines 和 settings 反而会带来过多的样板代码负担。此时单文件的 Requests 脚本是绝对最优解。
总括而言:写小脚本、抓单接口,用 Requests;做全站采集、建数据仓库,用 Scrapy;遭遇复杂反爬加密、必须模仿真实用户鼠标行为,用 Selenium / Playwright。 紧扣目标页面的实际数据源特性,以最小的工程复杂度完成数据采集,才是成熟工程师的选型准则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









